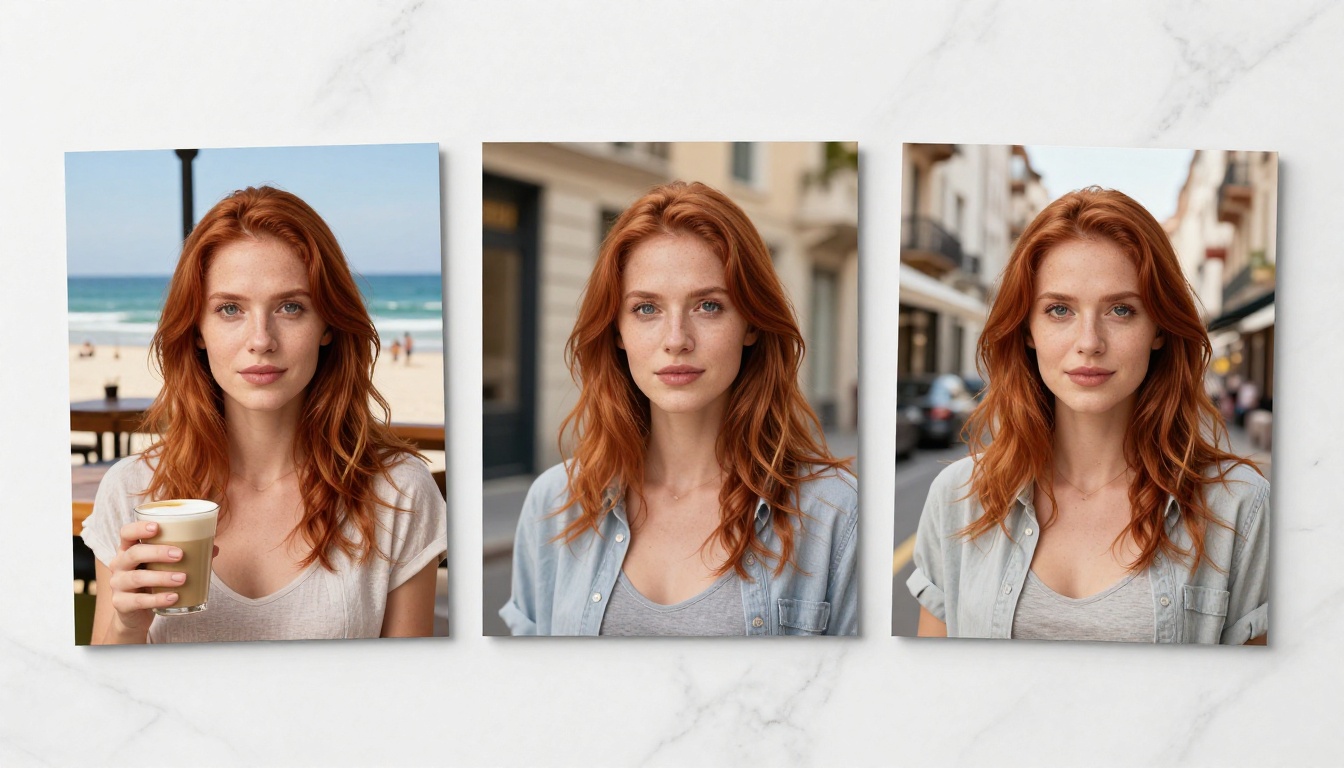
कैरेक्टर कंसिस्टेंसी शायद AI इमेज जनरेशन में सबसे ज़्यादा माँगा जाने वाला फ़ीचर है, और सबसे आम तौर पर टूटा हुआ वादा भी। आप अपना वर्कफ़्लो सेट करते हैं, एक के बाद एक इमेज जनरेट करते हैं, और तीसरे-चौथे सीन के बीच कहीं आपके कैरेक्टर का चेहरा बदलने लगता है। आँखों का रंग अलग, नाक अलग, जबड़ा किसी और का। अगर OpenArt पर आप इसी दीवार से टकराते रहे हैं, तो आप सही जगह पर हैं।
आपका कैरेक्टर क्यों बदलता रहता है
मूल समस्या का आपके प्रॉम्प्ट से कोई लेना-देना नहीं है। यह आर्किटेक्चर की समस्या है।
चेहरा बदलने की समस्या
ज़्यादातर AI इमेज जनरेटर हर जनरेशन पर आपके टेक्स्ट प्रॉम्प्ट को नए सिरे से समझकर काम करते हैं। भले ही आप दस अलग-अलग प्रॉम्प्ट में एक ही कैरेक्टर का हर डिटेल एक जैसा लिखें, मॉडल हर रिक्वेस्ट को अलग मानता है। उसे तीन रिक्वेस्ट पहले बनाए गए चेहरे की कोई याद नहीं रहती। नतीजा यह होता है कि कैरेक्टर इमेज-दर-इमेज एक धुंधली पारिवारिक समानता रखता है, लेकिन जब आप उन्हें साथ रखकर देखते हैं तो कंसिस्टेंसी की परीक्षा में बार-बार फ़ेल हो जाता है।
विज़ुअल नॉवेल, वेबटून, ब्रांड कैरेक्टर या सोशल मीडिया पर्सोना बनाने वाले क्रिएटर्स के लिए यह ख़ास तौर पर तकलीफ़देह है। जब चेहरा बदलता है, तो इमर्शन टूट जाता है। साथ ही दर्शकों का भरोसा भी टूटता है, क्योंकि उन्हें तुरंत पता चल जाता है कि "वही कैरेक्टर" अलग-अलग पैनल या पोस्ट में हल्का-सा बदला हुआ दिख रहा है।
OpenArt की LoRA सीमाएँ
OpenArt LoRA सपोर्ट देता है, जो सैद्धांतिक रूप से इस समस्या का हल है। लेकिन व्यवहार में OpenArt पर LoRA ट्रेन करने के लिए कुछ ख़ास शर्तें चाहिए ताकि नतीजे एक जैसे आएँ: साफ़ रेफ़रेंस इमेज, सही डेटासेट टैगिंग, और ट्रेनिंग पैरामीटर की वह समझ जिसे ज़्यादातर यूज़र विकसित करने का समय नहीं निकाल पाते। प्लेटफ़ॉर्म का कम्युनिटी LoRA इकोसिस्टम भी बिखर गया है। सैकड़ों मॉडल हैं, और आप किस बेस मॉडल और सेटिंग्स के साथ उन्हें जोड़ते हैं, उसके हिसाब से नतीजे बेहद अलग-अलग आते हैं।
इससे भी गहरी समस्या यह है कि अच्छी तरह ट्रेन किया गया LoRA भी अतिरिक्त पोज़ कंट्रोल और रेफ़रेंस एंकरिंग के बिना मल्टी-सीन कैरेक्टर कंसिस्टेंसी को पूरी तरह हल नहीं करता। आपके पास बढ़िया LoRA हो सकता है, फिर भी जब सीन जटिल होता है तो चेहरा बदल सकता है।
💡 असली समस्या: कैरेक्टर कंसिस्टेंसी के लिए या तो समर्पित आर्किटेक्चर चाहिए (रेफ़रेंस-इमेज कंडिशनिंग), या स्ट्रक्चरल गाइडेंस के साथ सावधानी से ट्रेन किया गया LoRA। अकेला सामान्य टेक्स्ट-टू-इमेज जनरेशन इसे हल नहीं कर सकता।
असली विकल्प की पहचान
खुद को OpenArt का विकल्प कहने वाला हर प्लेटफ़ॉर्म नहीं, बल्कि कुछ ही कैरेक्टर कंसिस्टेंसी की समस्या सच में हल करते हैं। ज़्यादातर बस ज़्यादा मॉडल या साफ़-सुथरा इंटरफ़ेस देते हैं। यहाँ वे बातें हैं जो सच में मायने रखती हैं।
स्टाइल एंकरिंग बनाम कैरेक्टर एंकरिंग
स्टाइल एंकरिंग विज़ुअल एस्थेटिक को एक जैसा रखती है: वही कलर पैलेट, वही लाइटिंग स्टाइल, वही आर्टिस्टिक दिशा। इसे हासिल करना अपेक्षाकृत आसान है। कैरेक्टर एंकरिंग कठिन समस्या है। इसका मतलब है बहुत अलग-अलग सीन और पोज़ में वही चेहरा, वही अनुपात, वही पहचान वाले फ़ीचर, वही ख़ास आँख का आकार और होंठों की असममितता।
कैरेक्टर एंकरिंग के लिए प्लेटफ़ॉर्म को ख़ास टूल चाहिए: रेफ़रेंस-इमेज कंडिशनिंग, मल्टी-इमेज फ़्यूज़न, या ऐसे समर्पित कैरेक्टर मॉडल जो मुख्य लक्ष्य के रूप में कंसिस्टेंसी पर ट्रेन किए गए हों। इन टूल्स के बिना आप बस ऊँची क्वालिटी के स्तर पर वही समस्या झेल रहे हैं।
स्पीड बनाम क्वालिटी का समझौता
कुछ मॉडल स्पीड को प्राथमिकता देते हैं और तेज़ अनुमान बनाते हैं जो अलग से देखने पर काफ़ी ठीक लगते हैं। दूसरे धीमा इनफ़रेंस चलाते हैं, लेकिन ऐसी सटीकता से फ़ीचर लॉक करते हैं जो साथ-साथ तुलना में भी टिकती है। कैरेक्टर कंसिस्टेंसी के काम में स्पीड दूसरे नंबर पर आती है। तीन सेकंड की वह जनरेशन जो बदल जाती है, उस बीस सेकंड की जनरेशन से कम क़ीमती है जो आपके कैरेक्टर का चेहरा हर ज़रूरी सीन में एकदम सटीक रखती है।
| विशेषता | OpenArt | PicassoIA |
|---|
| कैरेक्टर के लिए समर्पित मॉडल | सीमित | हाँ (Ideogram Character, Image 01) |
| मल्टी-रेफ़रेंस फ़्यूज़न | नहीं | हाँ (Multi Image Kontext Max) |
| LoRA ट्रेनिंग | हाँ (जटिल सेटअप) | हाँ (P Image Trainer, सरल किया गया) |
| पोर्ट्रेट सीरीज़ जनरेशन | नहीं | हाँ (Portrait Series) |
| ControlNet स्ट्रक्चर कंट्रोल | सीमित | हाँ (RealVisXL Multi Controlnet) |
कैरेक्टर कंसिस्टेंसी के लिए बने मॉडल
PicassoIA पर 183+ टेक्स्ट-टू-इमेज मॉडल चलते हैं। ज़्यादातर सामान्य-उद्देश्य वाले हैं। लेकिन उनमें एक ख़ास उपसमूह कैरेक्टर कंसिस्टेंसी की समस्या को ध्यान में रखकर बनाया गया है, और यही वे मॉडल हैं जिन्हें जानना उपयोगी है।
Ideogram Character
Ideogram Character प्लेटफ़ॉर्म पर सबसे सीधा हल है। यह आपके कैरेक्टर की रेफ़रेंस इमेज लेता है और उसे हर आगे की जनरेशन के लिए कंडिशनिंग एंकर की तरह इस्तेमाल करता है। चेहरा इसलिए नहीं बदलता क्योंकि मॉडल आर्किटेक्चर के स्तर पर रेफ़रेंस को संरक्षित रखने के लिए बाध्य है। उसे किसी अलग सीन, अलग आउटफ़िट या बिल्कुल अलग लाइटिंग में वही चेहरा दें, और वह सभी में मुख्य पहचान बनाए रखता है।
यह वह मॉडल है जिसका OpenArt में कोई साफ़ समकक्ष नहीं है।
Minimax का Image 01
Image 01 ख़ास तौर पर कंसिस्टेंट कैरेक्टर इमेज बनाने के लिए बनाया गया था। जहाँ ज़्यादातर मॉडल मल्टी-सीन कैरेक्टर वर्क में नाकाम होते हैं, Image 01 को कंसिस्टेंसी को मुख्य लक्ष्य के रूप में ट्रेन किया गया था, बाद में सोची गई बात की तरह नहीं। यह मानव सब्जेक्ट्स पर ख़ास तौर पर अच्छा काम करता है और अलग-अलग लाइटिंग स्थितियों को संभालता है, बिना चेहरे के फ़ीचर को किसी दूसरी दिशा में बहने दिए।
Flux Redux Dev
Flux Redux Dev एक अलग तरीका अपनाता है। टेक्स्ट प्रॉम्प्ट से जनरेशन चलाने के बजाय यह एक रेफ़रेंस इमेज लेता है और उसके स्ट्रक्चर्ड वेरिएशन बनाता है, मॉडल आर्किटेक्चर के स्तर पर मुख्य विज़ुअल पहचान को बचाते हुए। कैरेक्टर वर्क के लिए इसका मतलब है कि आप एक मानक रेफ़रेंस इमेज तय करते हैं और कैरेक्टर को विज़ुअली लॉक रखते हुए सीन वेरिएशन जनरेट करते हैं। तेज़ साथी मॉडल Flux Redux Schnell आपको अंतिम जनरेशन तय करने से पहले तेज़ी से प्रयोग करने देता है।
Portrait Series
Portrait Series एक ख़ास तौर पर बनाई गई एप्लिकेशन है, जो एक ही रेफ़रेंस फ़ोटो लेकर कंसिस्टेंट पोर्ट्रेट की सीरीज़ बनाती है। अलग बैकग्राउंड, अलग पोज़, अलग मूड। कैरेक्टर बिल्कुल एक जैसा रहता है। सोशल मीडिया कंटेंट, कैरेक्टर शीट और विज़ुअल स्टोरीटेलिंग के लिए यह आदर्श है, जहाँ आपको हर इमेज में अलग से कंसिस्टेंसी संभाले बिना एक ही व्यक्ति चाहिए।
PicassoIA पर Ideogram Character कैसे इस्तेमाल करें
चूँकि Ideogram Character कैरेक्टर कंसिस्टेंसी के सवाल का सबसे सीधा जवाब है, इसलिए यहाँ बताया गया है कि इसे ठीक-ठीक कैसे इस्तेमाल करें।
चरण 1: अपना रेफ़रेंस अपलोड करें
PicassoIA पर Ideogram Character पर जाएँ। इस मॉडल को आपके कैरेक्टर की कम से कम एक रेफ़रेंस इमेज चाहिए। सबसे अच्छे नतीजों के लिए इनका उपयोग करें:
- एक साफ़ फ़्रंटल पोर्ट्रेट जिसमें न्यूट्रल एक्सप्रेशन और अच्छी, समान लाइटिंग हो
- उच्च रिज़ॉल्यूशन (सबसे छोटी साइड पर कम से कम 512 पिक्सल)
- कोई भारी फ़िल्टर या स्टाइलाइज़ेशन नहीं जो मॉडल की फ़ीचर एक्सट्रैक्शन को भ्रमित कर सकें
थोड़े अलग कोणों से ली गई दो या तीन रेफ़रेंस इमेज असामान्य पोज़ में कंसिस्टेंसी को काफ़ी बेहतर बनाती हैं। मॉडल इस रेफ़रेंस सेट का उपयोग आपके कैरेक्टर के चेहरे की ज्यामिति का आंतरिक प्रतिनिधित्व बनाने में करता है, जो सीन बदलने पर भी टिका रहता है।
चरण 2: अपना कैरेक्टर प्रॉम्प्ट लिखें
आपका टेक्स्ट प्रॉम्प्ट कैरेक्टर को नहीं, सीन को वर्णित करता है। चूँकि Ideogram Character आपकी रेफ़रेंस इमेज पर कंडिशन होता है, इसलिए आपका प्रॉम्प्ट माहौल, लाइटिंग और एक्शन को संभालता है:
- मज़बूत प्रॉम्प्ट: "रात में टोक्यो के एक कन्वीनियंस स्टोर में खड़ी, ऊपर से फ़्लोरेसेंट लाइटिंग, उसके पीछे काँच के दरवाज़ों से बारिश दिखती हुई, कैज़ुअल स्ट्रीट आउटफ़िट"
- कमज़ोर प्रॉम्प्ट: "टोक्यो में हरी आँखों वाली सुंदर भूरे बालों की महिला"
दूसरा उदाहरण रेफ़रेंस इमेज से टकराता है। कैरेक्टर की शारीरिक दिखावट संभालने का काम मॉडल पर छोड़ें। बाकी सब कुछ नियंत्रित करने के लिए अपने प्रॉम्प्ट का उपयोग करें।
चरण 3: जनरेट करें और सुधारें
अपनी पहली जनरेशन चलाएँ। चेहरे को सीधे अपनी रेफ़रेंस इमेज से मिलाकर देखें। अगर मॉडल बदल गया है, तो यह समायोजित करके देखें:
- रेफ़रेंस वेट बढ़ाएँ अगर मॉडल आपको वह पैरामीटर देता है
- सीन प्रॉम्प्ट सरल करें ताकि रेफ़रेंस के साथ सिमैंटिक टकराव कम हो
- साफ़ लाइटिंग और तेज़ फ़ीचर डेफ़िनिशन वाली बेहतर रेफ़रेंस इमेज इस्तेमाल करें
आम तौर पर तीन से पाँच प्रयास कैरेक्टर को भरोसेमंद तरीके से लॉक कर देते हैं। जब कोई जनरेशन पसंद आ जाए, तो उसे अगले बैच के सीन के लिए नई इनपुट रेफ़रेंस के रूप में इस्तेमाल करें।
💡 प्रो टिप: कन्फ़र्म्ड-कंसिस्टेंट कैरेक्टर जनरेशन की एक निजी लाइब्रेरी बनाएँ। जैसे-जैसे लाइब्रेरी बढ़ती है, आपके पास आगे के सीन को एंकर करने के लिए ज़्यादा मज़बूत और ज़्यादा विविध रेफ़रेंस होते हैं, और समय के साथ आपकी कंसिस्टेंसी और बेहतर होती जाती है।
LoRA ट्रेनिंग सब कुछ बदल देती है
अगर आपको पचास या सौ इमेज में पूरी तरह एक जैसा कैरेक्टर चाहिए, तो समर्पित मॉडल ट्रेनिंग वह रास्ता है जो ड्रिफ़्ट को पूरी तरह ख़त्म कर देता है।
LoRA असल में क्या करता है
LoRA (Low-Rank Adaptation) ट्रेन किए गए वेट्स का एक छोटा सेट है, जो किसी ख़ास कॉन्सेप्ट के लिए बेस मॉडल के व्यवहार को बदलता है। जब आप अपने ख़ास कैरेक्टर पर LoRA ट्रेन करते हैं, तो आप मॉडल को उस कैरेक्टर को एक नाम वाले कॉन्सेप्ट के रूप में पहचानना सिखा रहे होते हैं, ठीक वैसे जैसे उसे पहले से पता है कि "Labrador retriever" या "Victorian conservatory" कैसा दिखता है। ट्रेनिंग के बाद आप एक ही ट्रिगर वर्ड से अपने कैरेक्टर को किसी भी सीन में जनरेट कर सकते हैं, बिना रेफ़रेंस इमेज के और बिना ड्रिफ़्ट के।
प्रॉम्प्ट-आधारित या रेफ़रेंस-आधारित तरीकों से फ़र्क बुनियादी है। आप हर बार कैरेक्टर का वर्णन नहीं कर रहे होते या हर बार रेफ़रेंस पर कंडिशन नहीं कर रहे होते। आप एक ऐसे कॉन्सेप्ट को बुला रहे होते हैं जिसे मॉडल ने स्थायी रूप से आत्मसात कर लिया है।
PicassoIA पर अपने कैरेक्टर का LoRA ट्रेन करना
P Image Trainer LoRA ट्रेनिंग को लोकल GPU हार्डवेयर या गहरी तकनीकी जानकारी के बिना सुलभ बनाता है। पूरी प्रक्रिया PicassoIA के इंफ़्रास्ट्रक्चर पर चलती है:
- अलग-अलग कोणों और लाइटिंग स्थितियों से अपने कैरेक्टर की 10 से 20 रेफ़रेंस इमेज इकट्ठा करें
- P Image Trainer पर अपलोड करें और एक अनोखा ट्रिगर वर्ड तय करें (जैसे, "auroracharacter")
- ट्रेनिंग स्टेप सेट करें (कैरेक्टर LoRA के लिए 800 से 1200 स्टेप भरोसेमंद रूप से काम करते हैं)
- ट्रेनिंग चलाएँ (प्लेटफ़ॉर्म पर आम तौर पर 15 से 30 मिनट लगते हैं)
- अपने ट्रिगर वर्ड को विविध सीन वर्णनों के साथ जोड़कर आउटपुट जाँचें
ट्रेनिंग के बाद तेज़ जनरेशन के लिए Flux Schnell LoRA के साथ अपना LoRA इस्तेमाल करें, या सबसे ऊँची क्वालिटी के आउटपुट के लिए Flux Pro Finetuned। जब आपको प्रिंट-क्वालिटी रिज़ॉल्यूशन चाहिए, तो Flux 1.1 Pro Ultra Finetuned 4MP परिणाम देता है। अपने कैरेक्टर LoRA के साथ पोज़ कंट्रोल के लिए, RealVisXL v3 Multi Controlnet LoRA अधिकतम सटीकता के लिए ControlNet स्ट्रक्चरल गाइडेंस को LoRA कैरेक्टर कंडिशनिंग के साथ जोड़ता है।
नतीजों की तुलना: OpenArt बनाम PicassoIA
अंतर सबसे साफ़ तब दिखता है जब आप एक ही सेशन में बहुत अलग-अलग सीन में एक ही कैरेक्टर को परखते हैं।
आउटपुट क्वालिटी की साथ-साथ तुलना
OpenArt पर कैफ़े में बनाया गया कैरेक्टर और फिर बीच पर दोबारा जनरेट किया गया कैरेक्टर आम तौर पर मोटे लक्षण साझा करता है, लेकिन ख़ास डिटेल्स में विफल होता है: आँखों का रंग एक शेड बदल जाता है, नाक का पुल प्रोफ़ाइल में बदल जाता है, बालों की बनावट अलग हो जाती है, जबड़ा नरम या तीखा हो जाता है, वह भी उन तरीकों से जो आपने प्रॉम्प्ट में माँगे ही नहीं थे। ये गलतियाँ अलग से देखने पर मामूली लगती हैं। लेकिन क्रम में रखने पर वे विज़ुअल स्टोरीटेलिंग को नष्ट कर देती हैं।
PicassoIA पर Ideogram Character या ट्रेन किए गए LoRA के साथ, अलग-अलग सीन में वही कैरेक्टर ख़ास डिटेल्स बनाए रखता है: चेहरे की झाइयों का सटीक वितरण, ऊपरी होंठ के कप (cupid's bow) का ख़ास आकार, आइरिस का सटीक रंग, पलकों के बैठने का ख़ास तरीका। यह सिर्फ़ मिलता-जुलता नहीं है। यह एक अलग जगह पर वही व्यक्ति है।
वर्कफ़्लो की स्पीड
व्यावहारिक तुलना में भी संरचित प्लेटफ़ॉर्म आगे है। OpenArt पर लगभग सटीक कंसिस्टेंसी पाने के लिए भी एक उपयुक्त कम्युनिटी LoRA ढूँढना पड़ता है, कई बेस मॉडल जोड़ियाँ आज़मानी पड़ती हैं, स्ट्रेंथ सेटिंग्स समायोजित करनी पड़ती हैं, और कुछ काम का मिलने से पहले दर्जनों जनरेशन से गुज़रना पड़ता है। यह धीमा और अनिश्चित है।
PicassoIA पर आप या तो Image 01 जैसा समर्पित मॉडल इस्तेमाल करते हैं और तुरंत भरोसेमंद नतीजे पाते हैं, या P Image Trainer से एक बार LoRA ट्रेन करते हैं और उसके बाद हर सीन के लिए बिना अतिरिक्त सेटअप के हमेशा कंसिस्टेंट जनरेशन पाते हैं।
हर बार कंसिस्टेंट कैरेक्टर के लिए टिप्स
सही मॉडल होने पर भी, आपके वर्कफ़्लो के छोटे फ़ैसले कैरेक्टर कंसिस्टेंसी पर बड़ा असर डालते हैं।
रेफ़रेंस इमेज चुनाव
आपकी कंसिस्टेंसी की क्वालिटी आपके रेफ़रेंस की क्वालिटी तय करती है। ख़राब रेफ़रेंस इमेज ख़राब कंसिस्टेंसी देती हैं, आप चाहे जो भी मॉडल इस्तेमाल करें। मॉडल सिर्फ़ वही एंकर कर सकता है जो वह साफ़ देख पाता है।
मज़बूत रेफ़रेंस की पहचान:
- मोशन ब्लर के बिना चेहरे पर तीखा फ़ोकस
- न्यूट्रल या सॉफ़्ट डायरेक्शनल लाइटिंग जो चेहरे की संरचना साफ़ दिखाए
- कम से कम भारी छाया जो पहचान वाले फ़ीचर्स को ढकें
- फ़्रंटल या लगभग फ़्रंटल कोण, जिसमें दोनों आँखें पूरी तरह दिखें
- प्राकृतिक एक्सप्रेशन (अतिरंजित एक्सप्रेशन अनुपात बिगाड़ते हैं और फ़ीचर एक्सट्रैक्शन को भ्रमित करते हैं)
किससे बचें:
- भारी फ़िल्टर जो त्वचा के रंग और फ़ीचर कंट्रास्ट बदल देते हैं
- भारी मेकअप जो चेहरे की मूल संरचना बदल देता है
- बैकलिट या सिल्हूट इमेज जिनमें चेहरे का डिटेल खो जाता है
- बहुत कम रिज़ॉल्यूशन वाली इमेज जिनमें अलग-अलग फ़ीचर साफ़ परिभाषित नहीं होते
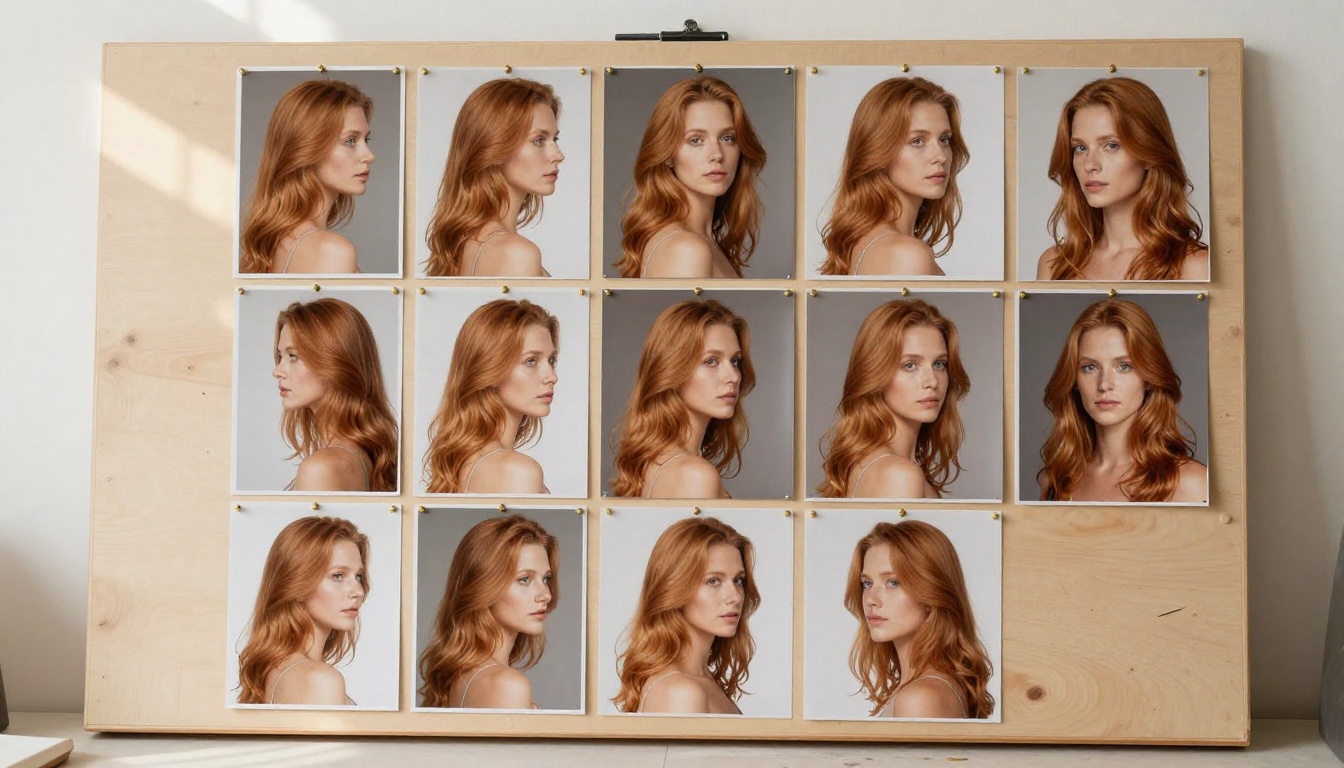
कंसिस्टेंसी के लिए प्रॉम्प्ट इंजीनियरिंग
आपके सीन प्रॉम्प्ट में कैरेक्टर की शारीरिक दिखावट को छोड़कर सब कुछ वर्णित होना चाहिए। चेहरा रेफ़रेंस इमेज या LoRA को संभालने दें। आपका प्रॉम्प्ट इन्हें संभालता है:
- स्थान और दिन का समय: "रोमन रूफ़टॉप टेरेस, गोल्डन आवर, रोम"
- आउटफ़िट: "सफ़ेद लिनन ब्लेज़र, टेलर्ड गहरे रंग की ट्राउज़र, सादा सोने का हार"
- एक्शन और मुद्रा: "फ़ोन स्क्रीन देखकर हँसते हुए, धूप से गर्म ईंट की दीवार से टिकी हुई"
- लाइटिंग: "डूबते सूरज से गर्म बैकलाइट, दाईं ओर से सॉफ़्ट प्रैक्टिकल फ़िल"
- कैमरा कोण और दूरी: "मीडियम शॉट, हल्का लो एंगल, 85mm लेंस"
रेफ़रेंस इमेज के साथ टेक्स्ट में कैरेक्टर के चेहरे का जितना ज़्यादा वर्णन करेंगे, उतना ज़्यादा टकराव बढ़ेगा। टेक्स्ट वर्णन और रेफ़रेंस इमेज एक-दूसरे को खींचते हैं, और मॉडल दोनों के बीच समझौता करता है। रेफ़रेंस पर भरोसा करें। सीन को दिशा दें।
जटिल सीन के लिए मल्टी-इमेज फ़्यूज़न
जब एक रेफ़रेंस काफ़ी नहीं होता, तब Multi Image Kontext Max और Multi Image Kontext Pro आपको कई रेफ़रेंस इमेज को एक सुसंगत जनरेशन में मिलाने देते हैं। यह उन सीन के लिए ख़ास तौर पर उपयोगी है जिनमें कई कंसिस्टेंट कैरेक्टर हों, या किसी ख़ास कैरेक्टर के चेहरे को किसी ख़ास आउटफ़िट या माहौल के रेफ़रेंस के साथ मिलाना हो।
Gen4 Image by Runway इसे और आगे ले जाता है, कई रेफ़रेंस इनपुट को पूरी तरह नए सीन में बदलकर, साथ ही हर तत्व की विज़ुअल पहचान को बनाए रखते हुए।
अपने कंसिस्टेंट कैरेक्टर बनाना शुरू करें
कैरेक्टर कंसिस्टेंसी कभी एक प्रीमियम क्षमता थी, ऐसी चीज़ जो समर्पित पाइपलाइन और हफ़्तों तक कस्टम मॉडल ट्रेनिंग करने वाले टेक्निकल आर्टिस्ट्स वाले एनिमेशन स्टूडियो के लिए आरक्षित थी। वह फ़ासला अब कम हो चुका है।
Ideogram Character सबसे तेज़ शुरुआती बिंदु है। रेफ़रेंस इमेज अपलोड करें, अपना सीन बताएँ, जनरेट करें। कोई ट्रेनिंग नहीं चाहिए, कोई जटिल सेटअप नहीं, कोई गहरी तकनीकी जानकारी नहीं। Image 01 उसी क्षेत्र को एक पूरक आर्किटेक्चर के साथ कवर करता है, जिससे जब पहला विकल्प किसी ख़ास सीन प्रकार के लिए सुधार माँगे, तो आपके पास भरोसेमंद दूसरा विकल्प होता है।
लंबी परियोजनाओं के लिए, जहाँ आपको पचास या सौ सीन में एक कैरेक्टर चाहिए, P Image Trainer से LoRA ट्रेन करें। एक ट्रेनिंग सेशन, स्थायी कंसिस्टेंसी, कोई ड्रिफ़्ट नहीं। अपनी परियोजना के आउटपुट फ़ॉर्मेट के हिसाब से इसे Flux Pro Finetuned या AI Avatars के साथ जोड़ें।
औज़ार मौजूद हैं। कैरेक्टर को गढ़ना अब आपके हाथ में है।