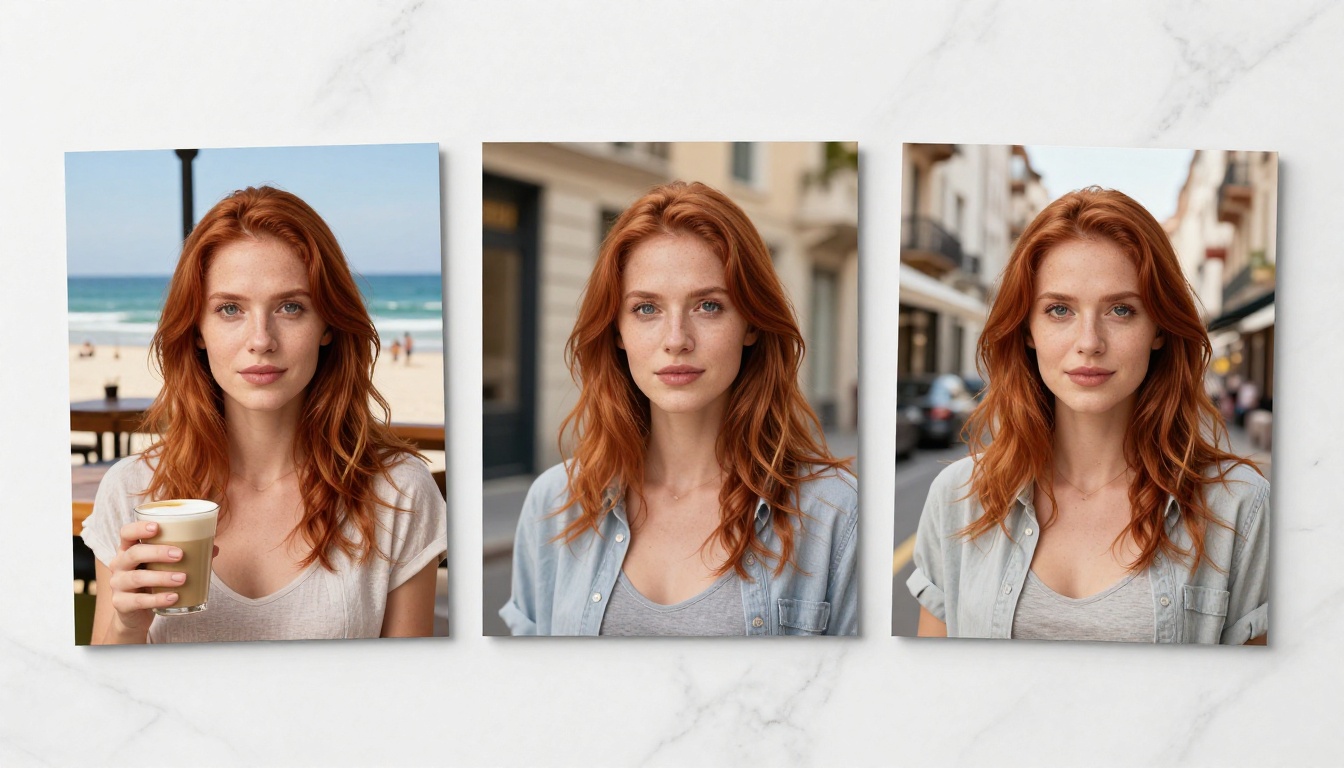
A consistência de personagem é provavelmente o recurso mais pedido na geração de imagens por IA e a promessa mais quebrada. Você configura seu fluxo de trabalho, gera imagem após imagem e, em algum ponto entre a terceira e a quarta cena, o rosto do seu personagem começa a mudar. Cor de olho errada. Nariz diferente. Uma linha de mandíbula que pertence a outra pessoa. Se você já bateu nesse muro no OpenArt, está no lugar certo.
Por que seu personagem continua mudando
O problema central não tem nada a ver com seus prompts. Ele é arquitetural.
O problema da deriva do rosto
A maioria dos geradores de imagem por IA funciona interpretando seu prompt de texto do zero a cada geração. Mesmo que você descreva o mesmo personagem com detalhes idênticos em dez prompts diferentes, o modelo trata cada pedido de forma independente. Ele não tem memória do rosto que gerou três pedidos antes. O resultado é um personagem que compartilha uma vaga semelhança de família entre as imagens, mas que falha no teste de consistência quando você os coloca lado a lado.
Isso se torna especialmente doloroso para quem cria novelas visuais, webtoons, personagens de marca ou personas para redes sociais. Quando a deriva do rosto acontece, ela quebra a imersão. Também quebra a confiança do seu público, que percebe de imediato quando "o mesmo personagem" parece sutilmente diferente de um quadro para outro ou de uma postagem para outra.
As limitações de LoRA do OpenArt
O OpenArt oferece suporte a LoRA, o que, em teoria, aborda esse problema. Mas, na prática, treinar um LoRA no OpenArt exige um conjunto específico de condições para gerar resultados consistentes: imagens de referência limpas, marcação adequada do conjunto de dados e um entendimento dos parâmetros de treinamento que a maioria dos usuários não tem tempo de desenvolver. O ecossistema comunitário de LoRA da plataforma também ficou fragmentado, com centenas de modelos produzindo resultados muito inconsistentes, dependendo do modelo base e das configurações com que você os combina.
O problema mais profundo é que até um LoRA bem treinado não resolve totalmente a consistência de personagem em várias cenas sem controle adicional de pose e ancoragem de referência. Você pode ter um ótimo LoRA e ainda assim ver a deriva do rosto quando a cena fica complexa.
💡 O ponto central: a consistência de personagem exige ou uma arquitetura dedicada (condicionamento por imagem de referência) ou um LoRA cuidadosamente treinado combinado com orientação estrutural. A geração comum de texto para imagem, sozinha, não resolve isso.
O que separa uma alternativa de verdade
Nem toda plataforma que se apresenta como alternativa ao OpenArt de fato enfrenta o problema da consistência de personagem. A maioria oferece apenas mais modelos ou uma interface mais limpa. Veja o que realmente importa.
Ancoragem de estilo ou ancoragem de personagem
A ancoragem de estilo mantém a estética visual consistente: mesma paleta de cores, mesmo estilo de iluminação, mesma direção artística. É relativamente fácil de alcançar. A ancoragem de personagem é o problema mais difícil. Ela significa o mesmo rosto, as mesmas proporções, os mesmos traços distintivos, o mesmo formato específico de olho e a mesma assimetria nos lábios, em cenas e poses muito diferentes.
Uma plataforma precisa de ferramentas específicas para a ancoragem de personagem: condicionamento por imagem de referência, fusão de múltiplas imagens ou modelos de personagem dedicados, treinados com a consistência como objetivo principal. Sem essas ferramentas, você está enfrentando o mesmo problema, só que em um nível de qualidade mais alto.
Contrapartidas entre velocidade e qualidade
Alguns modelos priorizam a velocidade e produzem aproximações rápidas que parecem bastante boas isoladamente. Outros executam uma inferência mais lenta, mas travam os traços com uma precisão que se sustenta na comparação lado a lado. Para trabalhar com consistência de personagem, a velocidade é secundária. Uma geração de três segundos que derrapa vale menos do que uma geração de vinte segundos que trava o rosto do seu personagem com perfeição em cada cena de que você precisa.
| Recurso | OpenArt | PicassoIA |
|---|
| Modelos de personagem dedicados | Limitado | Sim (Ideogram Character, Image 01) |
| Fusão de múltiplas referências | Não | Sim (Multi Image Kontext Max) |
| Treinamento de LoRA | Sim (configuração complexa) | Sim (P Image Trainer, simplificado) |
| Geração de séries de retratos | Não | Sim (Portrait Series) |
| Controle de estrutura com ControlNet | Limitado | Sim (RealVisXL Multi Controlnet) |
Os modelos criados para a consistência de personagem
O PicassoIA roda mais de 183 modelos de texto para imagem. A maioria é de uso geral. Mas um subconjunto específico foi criado em torno do problema da consistência de personagem, e estes são os que vale conhecer.
Ideogram Character
O Ideogram Character é a solução mais direta da plataforma. Ele aceita uma imagem de referência do seu personagem e a usa como âncora de condicionamento em cada geração seguinte. O rosto não deriva porque o modelo é arquitetonicamente restringido a preservar a referência. Dê a ele o mesmo rosto em outra cena, outra roupa ou uma condição de iluminação muito diferente, e ele mantém a identidade central em todas elas.
Este é o modelo para o qual o OpenArt não tem um equivalente limpo.
Image 01 da Minimax
O Image 01 foi criado especificamente para gerar imagens consistentes de personagens. Onde a maioria dos modelos falha em trabalhos de personagem em várias cenas, o Image 01 foi treinado com a consistência como objetivo principal, e não como um detalhe posterior. Ele se sai especialmente bem com sujeitos humanos e lida com condições de iluminação variadas sem deixar os traços do rosto derivarem para outro lugar.
Flux Redux Dev
O Flux Redux Dev adota uma abordagem diferente. Em vez de um prompt de texto conduzindo a geração, ele recebe uma imagem de referência e cria variações estruturadas dela, preservando a identidade visual central no nível da arquitetura do modelo. Para trabalhos com personagens, isso significa que você estabelece uma imagem de referência canônica e gera variações de cena mantendo o personagem visualmente travado. O modelo companheiro mais rápido, o Flux Redux Schnell, permite iterar rapidamente antes de partir para as gerações finais.
Portrait Series
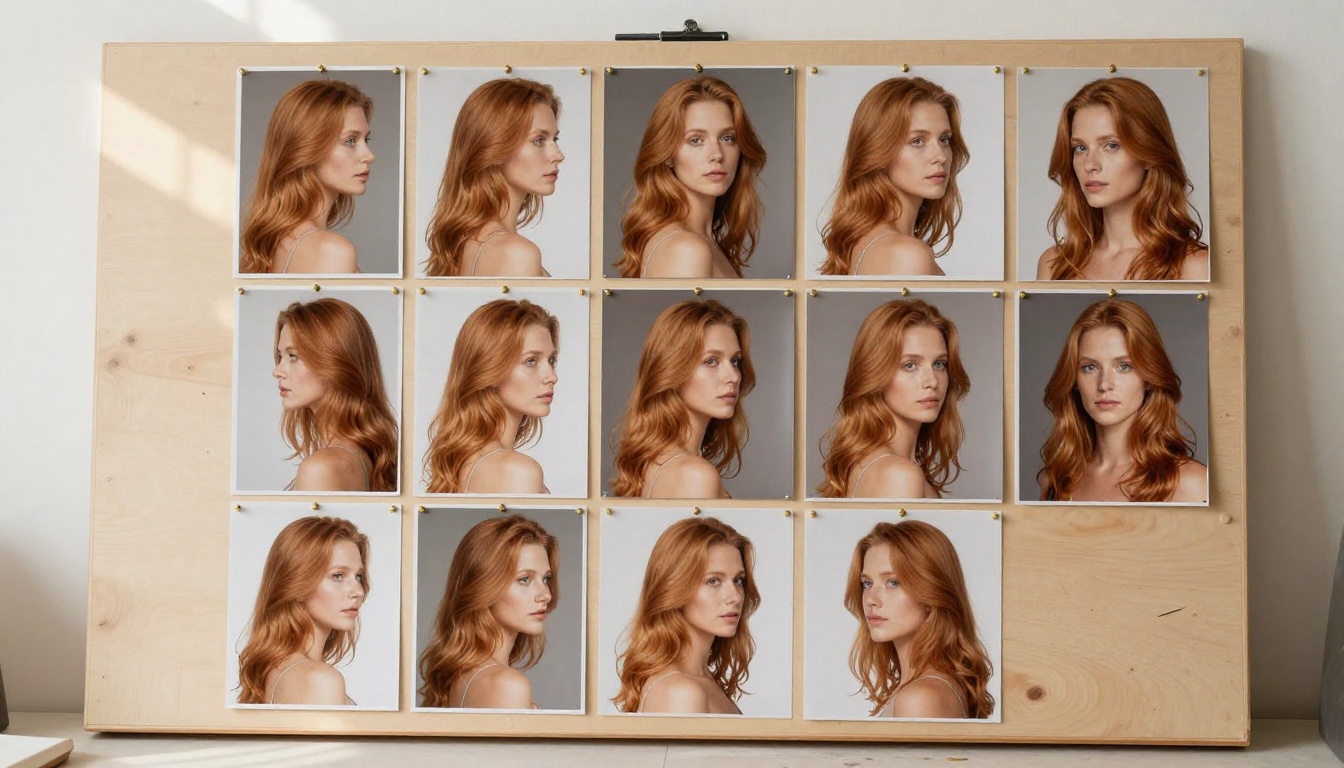
O Portrait Series é uma aplicação criada com um propósito específico, que recebe uma única fotografia de referência e gera uma série de retratos consistentes. Fundos diferentes, poses diferentes, humores diferentes. O personagem permanece idêntico. Isso é ideal para conteúdo de redes sociais, folhas de personagem e narrativas visuais em que você precisa da mesma pessoa em muitas imagens sem gerenciar manualmente a consistência de cada uma.
Como usar o Ideogram Character no PicassoIA
Como o Ideogram Character é a resposta mais direta para a questão da consistência de personagem, veja exatamente como usá-lo.
Passo 1: envie sua referência
Acesse o Ideogram Character no PicassoIA. O modelo exige pelo menos uma imagem de referência do seu personagem. Para melhores resultados, use:
- Um retrato frontal limpo, com expressão neutra e iluminação boa e uniforme
- Alta resolução (pelo menos 512 pixels no lado mais curto)
- Nenhum filtro pesado nem estilização que possa confundir a extração de traços do modelo
Duas ou três imagens de referência de ângulos ligeiramente diferentes melhoram muito a consistência em poses incomuns. O modelo usa o conjunto de referências para construir uma representação interna da geometria do rosto do seu personagem que se sustenta com as mudanças de cena.
Passo 2: escreva o prompt do personagem
Seu prompt de texto descreve a cena, não o personagem. Como o Ideogram Character condiciona com base na sua imagem de referência, seu prompt cuida do ambiente, da iluminação e da ação:
- Prompt forte: "De pé em uma loja de conveniência de Tóquio à noite, luz fluorescente vinda do teto, uma chuva leve visível pelas portas de vidro atrás dela, roupa casual de rua"
- Prompt fraco: "Mulher bonita de cabelo castanho-avermelhado e olhos verdes em Tóquio"
O segundo exemplo briga com a imagem de referência. Confie no modelo para cuidar da aparência física do personagem. Use seu prompt para controlar todo o resto.
Passo 3: gere e itere
Faça sua primeira geração. Compare o rosto diretamente com sua imagem de referência. Se o modelo tiver derivado, tente ajustar:
- Aumente o peso da referência se o modelo oferecer esse parâmetro
- Simplifique o prompt da cena para reduzir o conflito semântico com a referência
- Troque por uma imagem de referência mais forte, com iluminação mais limpa e definição de traços mais nítida
De três a cinco iterações costumam travar o personagem de forma confiável. Quando encontrar uma geração que você aprove, use-a como nova entrada de referência para o próximo lote de cenas.
💡 Dica de especialista: monte uma biblioteca pessoal de gerações de personagem já confirmadas como consistentes. À medida que a biblioteca cresce, você tem referências mais fortes e variadas para ancorar cenas futuras, e sua consistência se acumula com o tempo.
Treinar um LoRA muda tudo
Se você precisa de consistência absoluta de personagem em cinquenta ou cem imagens, o treinamento de um modelo dedicado é o caminho que elimina a deriva por completo.
O que um LoRA realmente faz
Um LoRA (Low-Rank Adaptation) é um pequeno conjunto de pesos treinados que modifica o comportamento de um modelo base para um conceito específico. Quando você treina um LoRA com o seu personagem, ensina o modelo a reconhecer esse personagem como um conceito nomeado, do mesmo jeito que ele já sabe como é um "labrador retriever" ou uma "estufa vitoriana". Depois de treinado, você gera seu personagem em qualquer cena usando uma única palavra-gatilho, sem imagem de referência e sem deriva.
A diferença em relação às abordagens baseadas em prompt ou em referência é fundamental. Você não está descrevendo o personagem nem condicionando em uma referência a cada vez. Você está invocando um conceito que o modelo internalizou de forma permanente.
Treinando o LoRA do seu personagem no PicassoIA
O P Image Trainer torna o treinamento de LoRA acessível, sem exigir hardware local de GPU nem conhecimento técnico profundo. Todo o processo roda na infraestrutura do PicassoIA:
- Reúna de 10 a 20 imagens de referência do seu personagem, em ângulos e condições de iluminação variados
- Envie para o P Image Trainer e atribua uma palavra-gatilho única (por exemplo, "auroracharacter")
- Defina os passos de treinamento (de 800 a 1.200 passos funcionam de forma confiável para LoRAs de personagem)
- Execute o treinamento (normalmente de 15 a 30 minutos na plataforma)
- Teste a saída usando sua palavra-gatilho combinada com descrições de cena variadas
Depois do treinamento, use seu LoRA com o Flux Schnell LoRA para uma geração rápida ou com o Flux Pro Finetuned para a maior qualidade de saída. Quando precisar de resolução para impressão, o Flux 1.1 Pro Ultra Finetuned entrega resultados de 4MP. Para controle de pose junto com o LoRA do seu personagem, o RealVisXL v3 Multi Controlnet LoRA combina a orientação estrutural do ControlNet com o condicionamento de personagem por LoRA para máxima precisão.
Comparando resultados: OpenArt ou PicassoIA
A diferença de saída fica mais visível quando você testa o mesmo personagem em cenas muito diferentes na mesma sessão.
Qualidade de saída lado a lado
No OpenArt, um personagem gerado em um café e depois regenerado em uma praia normalmente compartilha características gerais, mas falha nos detalhes específicos: a cor dos olhos muda um tom, a ponte do nariz se altera no perfil, a textura do cabelo ganha outra qualidade, a mandíbula suaviza ou se afia de maneiras que você não pediu no prompt. Esses erros parecem triviais isoladamente. Eles destroem a narrativa visual quando aparecem em sequência.
No PicassoIA, com o Ideogram Character ou um LoRA treinado, o mesmo personagem em cenas diferentes mantém os detalhes específicos: a distribuição exata das sardas, o formato particular do arco do lábio superior, a cor precisa da íris, o jeito específico como as pálpebras se encaixam. Não é apenas parecido. É a mesma pessoa em outro lugar.
Velocidade do fluxo de trabalho
A comparação prática também favorece as plataformas estruturadas. No OpenArt, obter até uma consistência aproximada exige encontrar um LoRA comunitário compatível, testar vários pareamentos de modelo base, ajustar as configurações de intensidade e iterar por dezenas de gerações antes de chegar a algo utilizável. É lento e incerto.
No PicassoIA, você pode usar um modelo criado para isso, como o Image 01, e obter resultados confiáveis de imediato, ou treinar um LoRA com o P Image Trainer uma vez e gerar de forma consistente para sempre, sem nenhuma configuração adicional por cena.
Dicas para personagens consistentes sempre
Mesmo com os modelos certos, pequenas decisões no seu fluxo de trabalho afetam muito a consistência de personagem.
Seleção da imagem de referência
A qualidade da sua referência determina a qualidade da sua consistência. Referências ruins produzem consistência ruim, não importa qual modelo você use. O modelo só consegue ancorar aquilo que consegue ver com clareza.
O que faz uma referência forte:
- Foco nítido no rosto, sem nenhum desfoque de movimento
- Iluminação neutra ou suave e direcional, que revele claramente a estrutura do rosto
- Sombras pesadas mínimas que escondam os traços distintivos
- Ângulo frontal ou quase frontal, com os dois olhos totalmente visíveis
- Expressão natural (expressões extremas distorcem as proporções e confundem a extração de traços)
O que evitar:
- Filtros pesados que alterem o tom da pele e o contraste dos traços
- Maquiagem carregada que mude a estrutura subjacente do rosto
- Imagens em contraluz ou em silhueta, nas quais o detalhe facial se perde
- Imagens de resolução muito baixa, nas quais os traços individuais não ficam bem definidos
Engenharia de prompt para consistência
Seus prompts de cena devem descrever tudo, exceto a aparência física do personagem. Deixe a imagem de referência ou o LoRA cuidar do rosto. Seu prompt cuida de:
- Local e hora do dia: "terraço no telhado, hora dourada, Roma"
- Roupa: "blazer de linho branco, calça escura bem cortada, colar dourado simples"
- Ação e postura: "rindo para a tela do celular, encostada em uma parede de tijolos aquecida pelo sol"
- Iluminação: "contraluz quente do sol se pondo, preenchimento suave e prático vindo da direita"
- Ângulo e distância da câmera: "plano médio, leve contra-plongée, lente de 85mm"
Quanto mais você tenta descrever o rosto do personagem em texto junto com uma imagem de referência, mais conflito você introduz. A descrição em texto e a imagem de referência puxam em direções opostas, e o modelo faz um meio-termo entre elas. Confie na referência. Dirija a cena.
Fusão de múltiplas imagens para cenas complexas
Quando uma única referência não basta, o Multi Image Kontext Max e o Multi Image Kontext Pro permitem combinar várias imagens de referência em uma única geração coerente. Isso é especialmente útil para cenas que exigem vários personagens consistentes ou para combinar o rosto de um personagem específico com uma roupa ou um ambiente de referência específico.
O Gen4 Image da Runway avança nisso ao transformar várias entradas de referência em cenas totalmente novas, preservando a identidade visual de cada elemento.
Comece a criar seus próprios personagens consistentes
A consistência de personagem já foi um recurso de elite, reservado a estúdios de animação com pipelines dedicados e artistas técnicos que passavam semanas no treinamento de modelos personalizados. Essa lacuna foi fechada.
O Ideogram Character é o ponto de entrada mais rápido. Envie uma imagem de referência, descreva sua cena e gere. Sem treinamento, sem configuração complexa, sem conhecimento técnico profundo. O Image 01 cobre o mesmo território com uma arquitetura complementar, oferecendo uma segunda opção confiável quando a primeira precisa de ajustes para um tipo específico de cena.
Para projetos de longo prazo em que você precisa de um personagem em cinquenta ou cem cenas, treine um LoRA com o P Image Trainer. Uma sessão de treinamento, consistência permanente, sem deriva. Combine-o com o Flux Pro Finetuned ou com os AI Avatars, dependendo do formato de saída que seu projeto exige.
As ferramentas estão aí. O personagem é seu para construir.