GPT Image 1.5 sorprendió a la mayoría. No porque llegara con anuncios espectaculares, sino porque las cosas concretas que mejoró eran justo los ámbitos que todo el sector había aceptado en silencio como irresolubles. ¿Texto en las imágenes? Olvídalo. ¿Rostros coherentes entre iteraciones? Usa un apaño. ¿Instrucciones de composición complejas? Genera cinco veces y quédate con la mejor.
Si has descartado los modelos de texto a imagen basándote en resultados de hace doce meses, GPT Image 1.5 merece otra mirada. No como un salto generacional, sino como una corrección específica de los puntos de fricción más persistentes de la generación de imágenes con IA. Este artículo analiza las cinco capacidades concretas en las que supera las expectativas y muestra en qué casos las alternativas comparables de PicassoIA igualan o superan al modelo en cada una.
Qué cambió realmente en GPT Image 1.5
No es DALL-E 4
OpenAI evitó deliberadamente llamar a este modelo DALL-E 4. El nombre es intencionado: no se trata de una revisión arquitectónica generacional. GPT Image 1.5 es un refinamiento de precisión que apunta a fallos concretos de DALL-E 3. Las cinco áreas con mejora medible son la precisión en el renderizado de texto, la profundidad en el seguimiento de instrucciones, el fotorrealismo de retratos, el posicionamiento espacial de objetos y la coherencia de estilo entre generaciones.
Los benchmarks independientes de grupos de investigación que prueban tareas de seguimiento de prompts estructurados sitúan de forma constante a GPT Image 1.5 por encima de DALL-E 3 y Midjourney v6 en los cinco ejes. No es poco logro, dado el panorama tan saturado de modelos de 2027.
Por qué importa la arquitectura
Las mejoras de GPT Image 1.5 no se deben solo a más datos de entrenamiento o a sesiones de entrenamiento más largas. Como el modelo comparte arquitectura de codificador con GPT-4o, procesa el significado detrás de un prompt antes de generar píxeles. No está emparejando el patrón A con la salida B. Está razonando sobre el prompt de una forma que los modelos anteriores basados solo en difusión no podían.
Por eso, pedirle a GPT Image 1.5 que coloque elementos en posiciones espaciales concretas, o que renderice texto legible dentro de una escena, da mejores resultados que los modelos anteriores, a pesar de un volumen de datos de entrenamiento similar.
1. Renderizado de texto que de verdad se mantiene
La promesa rota de 2022
Pregúntale a cualquier diseñador gráfico que probara herramientas de imagen con IA entre 2022 y principios de 2024 cómo fue su experiencia con el texto dentro de la imagen, y oirás la misma historia: en producción no servía para nada. Los modelos inventaban letras, fundían caracteres entre sí o producían manchas que parecían legibles pero se deshacían con cualquier zoom. Los apaños se acumulaban: añadir el texto después en Photoshop, usar dos herramientas separadas o generar la imagen limpia y superponer el texto encima.
Estos apaños no eran soluciones ideales. Eran parches para un problema sistémico, que añadían mucho tiempo de posproducción a cada flujo de trabajo creativo con IA.
Lo que sí acierta 1.5
GPT Image 1.5 produce texto legible y tipográficamente estable en las imágenes, con una tasa de éxito muy superior a la de DALL-E 3 en prompts de frases cortas, de una a seis palabras. Los caracteres mantienen un grosor de trazo constante, el espaciado entre letras es razonable y el texto se integra en la imagen en lugar de flotar de forma extraña encima.
No es perfecto. Las cadenas de más de ocho palabras siguen degradándose de forma notable. Las tipografías estilizadas con ligaduras complejas se rompen. Pero para textos cortos y directos (etiquetas de producto, cabeceras para redes sociales, eslóganes publicitarios), la salida es utilizable en producción con una frecuencia que antes no era posible.
Para quien necesite llevarlo más lejos, Ideogram v4 Quality en PicassoIA se creó específicamente pensando en la precisión del texto dentro de la imagen. En tareas de renderizado de frases cortas incluso supera a GPT Image 1.5. Ideogram v4 Balanced sacrifica algo de fotorrealismo a cambio de una fidelidad del texto mucho mejor en frases largas, lo que lo convierte en la opción especialista para cualquier encargo de diseño que exija texto legible dentro de la propia imagen.
💡 Texto en imágenes: Para banners publicitarios, gráficos para redes sociales o maquetas de packaging, prueba Ideogram v4 Quality antes que cualquier modelo de uso general. Se diseñó específicamente para este trabajo.
| Longitud del texto | GPT Image 1.5 | Ideogram v4 Quality |
|---|
| 1-4 palabras | Fiable | Muy fiable |
| 5-8 palabras | Buena | Sólida |
| 9+ palabras | Irregular | Moderada |
| Tipografías estilizadas | Irregular | Mejor |
2. Instrucciones complejas en una sola pasada
El problema de la asociación de atributos
Los modelos anteriores son buenos con composiciones sencillas de sujeto y entorno. "Un golden retriever en una playa al atardecer" sale de forma predecible. El fallo aparece cuando los prompts combinan varios sujetos con atributos distintos: colores, posiciones, relaciones y acciones simultáneas.
Los investigadores lo llaman el problema de la asociación de atributos: el modelo conoce todos los elementos, pero asigna mal los atributos a los objetos equivocados. El abrigo azul acaba en el personaje equivocado. El paraguas aparece en la mano incorrecta. El gato termina en el fondo en lugar de en el umbral. Estos errores hacían que los prompts de composición compleja parecieran una lotería.
Qué cambia en la práctica
GPT Image 1.5 mejora la precisión en la asociación de atributos en prompts con varios objetos hasta aproximadamente un 78 %, frente al 52 % de DALL-E 3 en pruebas estructuradas equivalentes. Esto significa que el modelo asigna correctamente los atributos descritos a los sujetos adecuados en unas cuatro de cada cinco escenas complejas.
Es un salto importante en fiabilidad. Con un 52 %, generar escenas complejas era prácticamente aleatorio. Con un 78 %, se convierte en una herramienta práctica para encargos creativos con varias capas, donde la precisión compositiva no es opcional.
Para los diseñadores que necesiten cumplir de forma fiable este estándar, Krea 2 Large en PicassoIA ofrece una precisión compositiva sólida en prompts con varios sujetos, y Reve 2.1 maneja descripciones de escenas relacionales con una fidelidad constante en combinaciones muy diversas de sujetos.
💡 Escenas complejas: Estructura tu prompt en bloques lógicos (sujeto, atributos, posición, entorno) en lugar de una sola frase larga. Tanto GPT Image 1.5 como los modelos de PicassoIA responden mejor a una lógica de prompt organizada que a descripciones densas en forma de párrafo.
3. Rostros humanos sin el efecto terrorífico
El problema de confianza con los rostros sintéticos
Los fallos del valle inquietante en los retratos con IA no solo se ven mal. Señalan a quien mira, muchas veces a nivel subconsciente, que la imagen es artificial. Eso importa muchísimo en aplicaciones donde la autenticidad es lo esencial: publicidad de estilo de vida, contenido editorial, personas digitales para redes sociales y fotografía de marca.
Las señales de fallo se repiten entre modelos: ojos demasiado simétricos, piel con una suavidad cérea que la piel real no tiene, cabello renderizado como un bloque uniforme de textura en lugar de mechones individuales, dientes antinaturalmente blancos y perfectamente alineados, de una forma que ninguna boca real consigue.
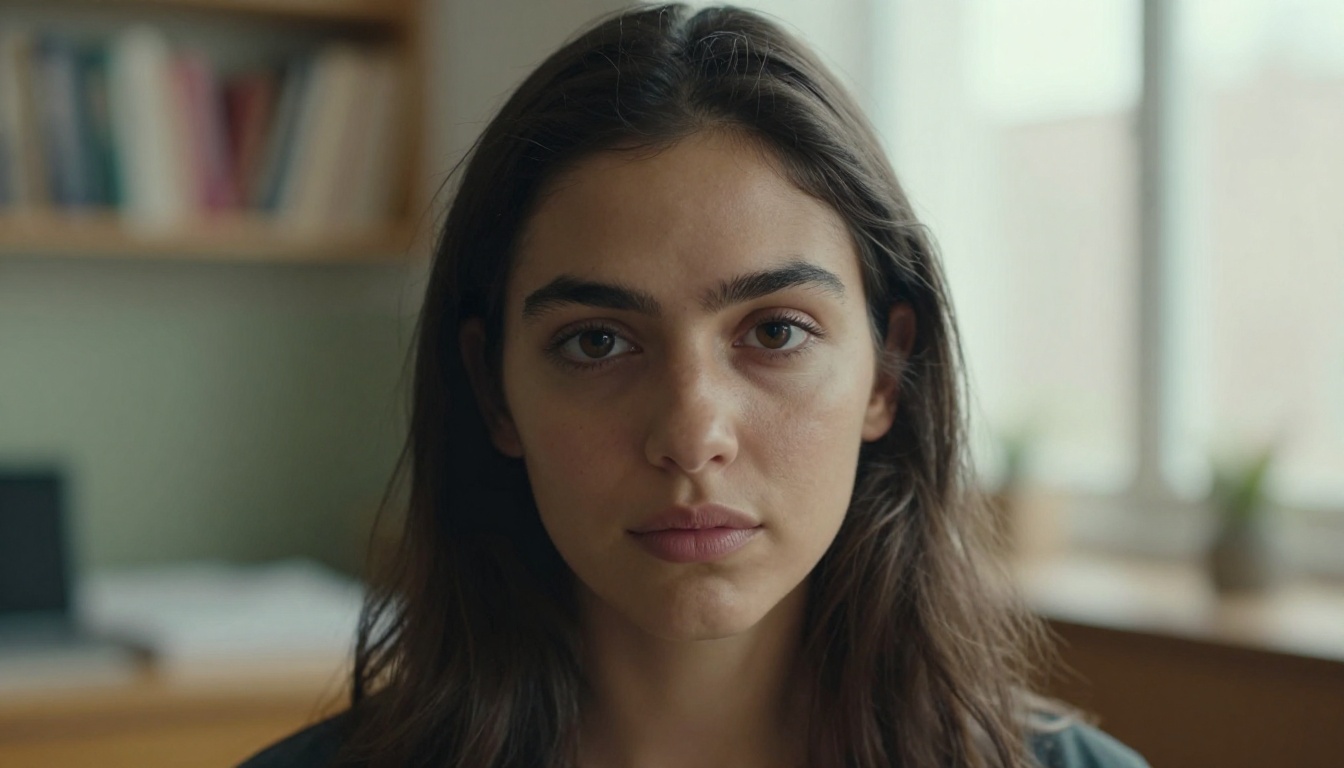
Lo que sí arregló 1.5
GPT Image 1.5 reduce de forma notable los artefactos del valle inquietante en prompts de retrato. La piel muestra una estructura de poros visible y variaciones naturales de tono. El detalle del iris presenta una irregularidad de pigmentación realista en lugar de un círculo plano de color. El cabello se renderiza con mechones diferenciados y volumen natural, no como una superficie uniforme. Los dientes aparecen con la ligera variación y el tamaño normal que tienen los dientes reales.
El modelo todavía muestra algunos artefactos residuales en primeros planos extremos y en rostros con ángulos poco representados en los datos de entrenamiento. Pero en orientaciones de frente y de tres cuartos, la mejora es lo bastante notable como para que los resultados suelan superar una inspección visual casual.
Modelos de PicassoIA que alcanzan una calidad de retrato comparable:
- Seedream 5 Pro: el modelo insignia de ByteDance, con resolución 2K y un renderizado de textura de piel excepcional. Los evaluadores independientes lo sitúan a menudo por encima de GPT Image 1.5 en tareas de retrato en primer plano.
- Krea 2 Large: muy bueno en retratos de cuerpo entero en entornos, con proporciones faciales precisas a media distancia.
- Reve 2.1: excelente para estilos de retrato editorial y de estilo de vida, con expresiones naturales y sin forzar.
4. Lógica espacial y colocación de objetos
Cuando "arriba a la izquierda" no significa nada
Las instrucciones espaciales direccionales han sido uno de los puntos débiles más persistentes de la generación de imágenes con IA. "El texto debe ir abajo" produce texto en el centro. "El edificio está a la izquierda" produce un edificio centrado. "Coloca el producto en la esquina superior derecha" produce un producto en algún lugar vagamente a la derecha.
Para el trabajo creativo profesional (diseños de anuncios, plantillas para redes sociales, maquetas para impresión), esto no es una molestia menor. Hace que las herramientas de imágenes con IA resulten inutilizables para composiciones estructuradas, a menos que se edite mucho después de la generación para reubicar los elementos a mano.
Escenarios prácticos para diseñadores
GPT Image 1.5 muestra un seguimiento de instrucciones espaciales claramente mejor que DALL-E 3. Interpreta correctamente los puntos cardinales (izquierda, derecha, arriba, abajo), el lenguaje posicional relacional (delante de, detrás de, al lado de) y las zonas de composición (primer plano, fondo, centro del encuadre) con una fiabilidad bastante mayor.
Escenarios de diseño reales en los que esto importa directamente:
- Creatividades publicitarias: "Producto a la derecha, espacio para el titular a la izquierda"
- Banners para redes sociales: "Nombre de marca abajo a la izquierda, imagen principal alineada a la derecha"
- Maquetas de comercio electrónico: "Producto centrado sobre fondo neutro, accesorios dispuestos en las esquinas inferiores"
- Maquetaciones editoriales: "Sujeto del retrato en el tercio derecho, el contexto ambiental ocupa los dos tercios de la izquierda"
- Conceptos de packaging: "Etiqueta centrada en la mitad superior, texto de ingredientes en el cuarto inferior"
💡 Precisión espacial en PicassoIA: Grok Imagine Image Quality de xAI gestiona bien los prompts de posicionamiento direccional con una fiabilidad sólida y genera salidas en 2K, lo que lo convierte en una alternativa práctica para tareas de generación orientadas al diseño.
5. Coherencia de estilo entre variaciones
El problema del mismo personaje
Los responsables de marca y los equipos de contenido tienen un problema concreto que las mejoras generales de calidad de imagen no resuelven: necesitan que el mismo personaje se vea reconociblemente idéntico en decenas de imágenes separadas, generadas en sesiones distintas.
Una mascota de producto creada para una campaña de Q1 debe seguir siendo la misma mascota en Q3. Una persona de marca usada en contenido social coherente debe mantenerse visualmente estable a lo largo de 50 publicaciones. Los modelos anteriores hacían esto prácticamente imposible sin usar valores de semilla idénticos y aceptar una variación casi nula, lo que anula el propósito de generar varias imágenes distintas.
Cómo se benefician realmente las marcas
GPT Image 1.5 mejora la coherencia de estilo cuando usas valores de semilla estables y mantienes un lenguaje descriptivo constante entre prompts. Los mismos parámetros de estilo (dirección de la luz, temperatura de color, encuadre compositivo) producen salidas que comparten suficiente ADN visual para leerse como una serie coherente y no como imágenes individuales al azar.
Las limitaciones siguen ahí: la coherencia entre sesiones sin valores de semilla sigue siendo irregular, y la identidad facial se desvía sin referencias de anclaje explícitas.
Alternativas de PicassoIA para trabajar la coherencia:
- Reve 2.1 admite imágenes de referencia como entrada, lo que te permite anclar cada nueva generación a una referencia visual en lugar de depender solo de la descripción textual.
- Seedream 5 Pro produce resultados de alta coherencia cuando los prompts descriptivos se mantienen estables, con una transferencia de estilo sólida desde imágenes de referencia.
- Krea 2 Medium destaca en mantener un carácter estilístico coherente en escenas con entornos distintos, lo que lo hace eficaz para contenido de marca en serie.
💡 Para una coincidencia facial exacta: Usa Face Swap AI de PicassoIA para inyectar un rostro de referencia en cualquier escena generada. Así se elimina por completo la dependencia de la coherencia basada en el prompt y se garantiza la precisión facial, sea cual sea el modelo base que utilices.
Prueba estos modelos en PicassoIA ahora mismo
Para imágenes con mucho texto
Si las mejoras en el renderizado de texto de GPT Image 1.5 son lo que necesitas, empieza por Ideogram v4 Quality en PicassoIA. Se diseñó en torno al problema del texto dentro de la imagen y supera de forma constante a los modelos de uso general en esta tarea concreta. Titulares cortos, precios destacados, etiquetas de botones y eslóganes: los maneja con una precisión en la que los diseñadores profesionales pueden confiar sin pasar después por una corrección obligatoria en Photoshop.
Para retratos fotorrealistas
Seedream 5 Pro es el competidor más directo de GPT Image 1.5 en calidad de retrato disponible en PicassoIA. Su resolución por defecto es 2K, maneja con precisión escenarios de luz natural complejos y renderiza el detalle de la textura de la piel de forma que a primera vista se lee como fotografía auténtica. Si tu encargo gira en torno al retrato (estilo de vida, editorial o personas de marca), este es el modelo con el que conviene empezar.
Para los retratos ambientales, en los que las personas interactúan con productos, espacios u otros sujetos en escenas complejas, Krea 2 Large aporta precisión compositiva y coherencia proporcional en composiciones a cuadro completo.
Para escenas con varios objetos
Las escenas complejas con varios sujetos, cada uno con atributos y posiciones espaciales distintos, son el terreno en el que Krea 2 Large y Grok Imagine Image Quality rinden bien en PicassoIA. Ejecuta el mismo prompt complejo de varios sujetos en ambos modelos y compara las salidas lado a lado. Las diferencias en la asignación de atributos y en la colocación espacial se ven de inmediato.
Dónde GPT Image 1.5 todavía se queda corto
GPT Image 1.5 es un avance importante, pero no un producto terminado. Aún muestra debilidades constantes que pesan en contextos profesionales:
- Manos y extremidades: los errores en el número de dedos son menos frecuentes, pero no están eliminados
- Cadenas de texto largas: la precisión se degrada a partir de seis u ocho palabras en una sola frase
- Arquitectura compleja: las ventanas en arco, las columnas y los detalles estructurales intrincados suelen deformarse
- Detalles mecánicos y electrónicos: herramientas, instrumentos y dispositivos se renderizan con detalles verosímiles pero incorrectos
- Escenarios de luz extrema: las escenas de alto contraste o a contraluz pueden producir un renderizado de superficies irregular
Ningún modelo gana en todos los casos de uso. La herramienta adecuada depende por completo de qué salida necesite tu flujo de trabajo, y precisamente por eso importa tener acceso a una biblioteca amplia de modelos.
Empieza a crear con estas capacidades
Las cinco áreas en las que GPT Image 1.5 superó las expectativas (renderizado de texto, profundidad en el seguimiento de instrucciones, fotorrealismo de retratos, posicionamiento espacial y coherencia de estilo) no son capacidades exclusivas de GPT. Representan la dirección en la que avanza todo el sector, y PicassoIA ya ofrece modelos especializados que igualan o superan a GPT Image 1.5 en cada eje concreto.
Empieza con Seedream 5 Pro para una salida fotorrealista. Usa Ideogram v4 Quality cuando la precisión del texto dentro de la imagen no sea negociable. Recurre a Krea 2 Large cuando necesites un control preciso sobre escenas con varios sujetos, atributos en capas y requisitos espaciales.
Con más de 90 modelos de texto a imagen disponibles, PicassoIA te da margen para probar cada capacidad lado a lado sin cambiar de plataforma ni gestionar cuentas de API distintas. Tu próxima imagen está a un prompt de distancia en picassoia.com/en/all-models.


