GPT Image 1.5 a pris la plupart des gens au dépourvu. Non pas parce qu’il est arrivé avec des annonces spectaculaires, mais parce que les points précis qu’il a améliorés étaient exactement ceux que tout le domaine avait discrètement considérés comme insolubles. Du texte dans les images ? On oublie. Des visages cohérents d’une itération à l’autre ? On contourne le problème. Des consignes de composition complexes ? On génère cinq fois et on garde le meilleur résultat.
Si vous avez écarté les modèles texte vers image sur la base de résultats vieux de douze mois, GPT Image 1.5 mérite un second regard, non pas comme une percée générationnelle, mais comme une correction ciblée des points de friction les plus tenaces de la génération d’images par IA. Cet article détaille les cinq capacités précises où il dépasse les attentes, et montre où des alternatives comparables sur PicassoIA égalent ou surpassent ce modèle sur chacune d’elles.
Ce que GPT Image 1.5 a réellement changé
Pas DALL-E 4
OpenAI a délibérément évité de nommer ce modèle DALL-E 4. Ce choix est intentionnel : il ne s’agit pas d’une refonte architecturale générationnelle. GPT Image 1.5 est un affinage de précision qui cible des défaillances spécifiques de DALL-E 3. Les cinq domaines où il montre une amélioration mesurable sont la précision du rendu de texte, la profondeur du suivi d’instructions, le photoréalisme des portraits, le placement spatial des objets et la cohérence du style d’une génération à l’autre.
Des benchmarks indépendants menés par des groupes de recherche qui testent le suivi de prompts structurés placent systématiquement GPT Image 1.5 au-dessus de DALL-E 3 et de Midjourney v6 sur les cinq axes. Ce n’est pas un petit accomplissement, étant donné l’encombrement du paysage des modèles en 2027.
Pourquoi l’architecture compte ici
Les progrès de GPT Image 1.5 ne résultent pas uniquement de davantage de données d’entraînement ou de cycles d’entraînement plus longs. Comme le modèle partage son architecture d’encodeur avec GPT-4o, il traite le sens du prompt avant de générer les pixels. Il ne fait pas correspondre le motif A à la sortie B. Il raisonne sur le prompt d’une manière que les modèles antérieurs, fondés uniquement sur la diffusion, ne permettaient pas.
C’est pourquoi, lorsqu’on demande à GPT Image 1.5 de placer des éléments à des positions spatiales précises, ou de faire apparaître du texte lisible dans une scène, les résultats sont meilleurs que ceux des modèles précédents, malgré un volume de données d’entraînement comparable.
1. Un rendu de texte qui tient vraiment
La promesse non tenue de 2022
Demandez à n’importe quel graphiste ayant testé des outils d’image par IA entre 2022 et début 2024 de décrire son expérience de génération de texte dans l’image, et vous entendrez la même histoire : c’était inutilisable en production. Les modèles hallucinaient des lettres, fusionnaient les caractères entre eux, ou produisaient des taches d’apparence lisible qui se défaisaient au moindre zoom. Les contournements se multipliaient : ajouter le texte dans Photoshop après coup, utiliser deux outils distincts, générer une image propre et superposer le texte par-dessus.
Ces contournements n’étaient pas des solutions idéales. Il s’agissait de rustines posées sur un problème systémique, qui ajoutaient un temps de post-traitement considérable à chaque flux de travail créatif assisté par IA.
Ce que la version 1.5 réussit
GPT Image 1.5 produit du texte lisible et typographiquement stable dans les images, avec un taux de réussite nettement supérieur à celui de DALL-E 3 sur des phrases courtes d’un à six mots. Les caractères conservent une épaisseur de trait constante, l’espacement des lettres est raisonnable, et le texte s’intègre à l’image au lieu de flotter maladroitement par-dessus.
Ce n’est pas parfait. Les chaînes de plus de huit mots se dégradent encore nettement. Les polices stylisées aux ligatures complexes se désagrègent. Mais pour un texte court et direct (légendes de produits, en-têtes de réseaux sociaux, accroches publicitaires), le résultat est utilisable en production à un taux qui n’était pas atteignable auparavant.
Pour aller plus loin, Ideogram v4 Quality sur PicassoIA a été conçu spécifiquement pour la précision du texte dans l’image. Il obtient des scores encore plus élevés que GPT Image 1.5 sur les tâches de rendu de phrases courtes. Ideogram v4 Balanced sacrifie une partie du photoréalisme pour une fidélité du texte nettement meilleure sur les phrases plus longues, ce qui en fait le choix spécialisé pour tout brief de design exigeant un texte lisible à l’intérieur même de l’image.
💡 Texte dans les images : pour les bannières publicitaires, les visuels de réseaux sociaux ou les maquettes d’emballages de produits, testez Ideogram v4 Quality avant tout modèle généraliste. Il a été conçu spécifiquement pour cette tâche.
| Longueur du texte | GPT Image 1.5 | Ideogram v4 Quality |
|---|
| 1 à 4 mots | Fiable | Très fiable |
| 5 à 8 mots | Bon | Solide |
| 9 mots et plus | Irrégulier | Moyen |
| Polices stylisées | Irrégulier | Meilleur |
2. Des consignes complexes traitées en une seule passe
Le problème de l’attribution des attributs
Les modèles antérieurs sont performants sur les compositions simples sujet-environnement. « Un golden retriever sur une plage au coucher du soleil » donne un résultat prévisible. La défaillance apparaît lorsque les prompts superposent plusieurs sujets dotés d’attributs distincts : couleurs, positions, relations et actions simultanées.
Les chercheurs appellent cela le problème de l’attribution des attributs : le modèle connaît tous les éléments, mais attribue mal les caractéristiques aux mauvais objets. Le manteau bleu se retrouve sur le mauvais personnage. Le parapluie se retrouve dans la mauvaise main. Le chat finit en arrière-plan au lieu du seuil de la porte. Ces erreurs faisaient des prompts de composition complexes une véritable loterie.
Ce qui change en pratique
GPT Image 1.5 fait passer la précision de l’attribution des attributs sur les prompts multi-objets à environ 78 %, contre 52 % pour DALL-E 3 sur des tests structurés équivalents. Concrètement, le modèle attribue correctement les caractéristiques décrites aux bons sujets dans environ quatre scènes complexes sur cinq.
C’est un bond significatif en matière de fiabilité. À 52 %, générer des scènes complexes relevait pratiquement du hasard. À 78 %, cela devient un outil concret pour des briefs créatifs à plusieurs couches, où la précision de la composition n’est pas facultative.
Pour les designers qui doivent atteindre ce niveau de manière fiable, Krea 2 Large sur PicassoIA offre une bonne précision de composition sur les prompts multi-sujets, et Reve 2.1 gère les descriptions de scènes relationnelles avec une fidélité constante, quelle que soit la combinaison de sujets.
💡 Scènes complexes : structurez votre prompt en groupes logiques (sujet, attributs, position, environnement) plutôt qu’en une seule phrase interminable. GPT Image 1.5 comme les modèles de PicassoIA répondent mieux à une logique de prompt organisée qu’à des descriptions denses en forme de paragraphe.
3. Des visages humains sans l’effet d’étrangeté
Le problème de confiance avec les visages de synthèse
Les échecs de la vallée de l’étrange dans les portraits générés par IA ne font pas que paraître mal. Ils signalent aux spectateurs, souvent à un niveau subconscient, que l’image est artificielle. Cela compte énormément pour les applications où l’authenticité est essentielle : publicité lifestyle, contenus éditoriaux, personas sur les réseaux sociaux et photographie de marque.
Les marqueurs d’échec sont constants d’un modèle à l’autre : des yeux trop symétriques, une peau d’une douceur cireuse que la vraie peau n’a pas, des cheveux rendus comme une texture uniforme plutôt que mèche par mèche, des dents anormalement blanches et parfaitement alignées, comme aucune bouche réelle ne l’est.
Ce que la version 1.5 a réellement corrigé
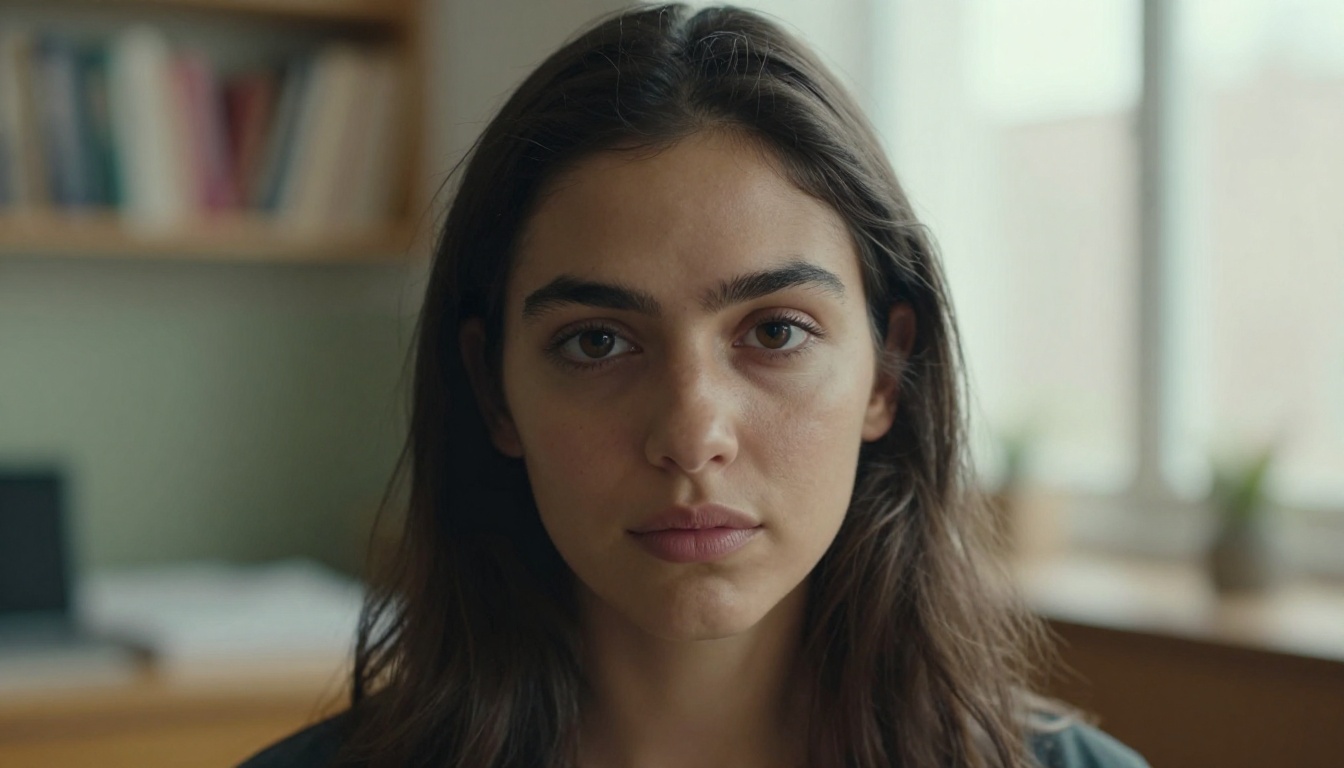
GPT Image 1.5 réduit nettement les artefacts de la vallée de l’étrange sur les prompts de portrait. La peau présente une structure de pores visible et des variations naturelles de ton. Le détail de l’iris montre une irrégularité de pigmentation réaliste, et non un simple disque de couleur uniforme. Les cheveux se différencient mèche par mèche, avec un volume naturel, et non comme une surface uniforme. Les dents présentent la légère variation de taille et de forme que possèdent les vraies dents.
Le modèle montre encore quelques artefacts résiduels sur les gros plans extrêmes et les visages sous des angles peu représentés dans les données d’entraînement. Mais pour les orientations de face et de trois quarts, l’amélioration est suffisamment nette pour que les résultats passent régulièrement un contrôle visuel rapide.
Modèles PicassoIA qui atteignent une qualité de portrait comparable :
- Seedream 5 Pro : le modèle phare de ByteDance en 2K, avec un rendu de texture de peau exceptionnel, souvent mieux classé que GPT Image 1.5 sur les portraits en gros plan par les évaluateurs indépendants.
- Krea 2 Large : performant sur les portraits environnementaux en pied, avec des proportions faciales précises à mi-distance.
- Reve 2.1 : excellent pour les styles de portrait éditoriaux et lifestyle, avec des expressions naturelles et sans contrainte.
4. Logique spatiale et placement des objets
Quand « en haut à gauche » ne veut rien dire
Les consignes spatiales directionnelles ont longtemps été l’un des points faibles les plus tenaces de la génération d’images par IA. « Le texte doit être en bas » produit un texte au milieu. « Le bâtiment se trouve sur le côté gauche » produit un bâtiment centré. « Placez le produit dans le coin supérieur droit » produit un produit quelque part vaguement à droite.
Pour le travail créatif professionnel (mises en page publicitaires, modèles pour les réseaux sociaux, maquettes d’impression), ce n’est pas un simple désagrément mineur. Cela rend les outils d’images par IA inutilisables pour les compositions structurées, sauf à retoucher beaucoup après la génération pour repositionner les éléments à la main.
Scénarios pratiques pour les designers
GPT Image 1.5 montre un suivi des consignes spatiales nettement meilleur que DALL-E 3. Il interprète correctement les directions cardinales (gauche, droite, haut, bas), le langage de position relationnel (devant, derrière, à côté de) et les zones de composition (premier plan, arrière-plan, centre du cadre) avec une fiabilité sensiblement supérieure.
Scénarios concrets de design où cela compte directement :
- Créatifs publicitaires : « Produit à droite, espace pour le texte à gauche pour l’accroche »
- Bannières pour réseaux sociaux : « Nom de marque en bas à gauche, image principale alignée à droite »
- Maquettes e-commerce : « Produit centré sur fond neutre, accessoires disposés dans les coins inférieurs »
- Mises en page éditoriales : « Sujet portrait dans le tiers droit, le contexte environnemental occupe les deux tiers gauches »
- Concepts d’emballage : « Étiquette centrée dans la moitié supérieure, texte des ingrédients dans le quart inférieur »
💡 Précision spatiale sur PicassoIA : Grok Imagine Image Quality de xAI gère les prompts de positionnement directionnel avec une fiabilité solide et produit des images en 2K, ce qui en fait une alternative pratique pour les générations orientées design.
5. Cohérence du style entre les variations
Le problème du même personnage
Les responsables de marque et les équipes de contenu ont un problème précis que les améliorations générales de la qualité d’image ne résolvent pas : ils ont besoin que le même personnage reste reconnaissable d’une image à l’autre, sur des dizaines d’images distinctes générées dans des sessions séparées.
Une mascotte de produit créée pour une campagne Q1 doit toujours ressembler à la même mascotte au Q3. Un personnage utilisé pour des contenus cohérents pour les réseaux sociaux doit rester visuellement stable sur 50 publications. Les modèles précédents rendaient cela pratiquement impossible sans utiliser des valeurs de seed identiques et accepter une variation quasi nulle, ce qui va à l’encontre de l’objectif de générer plusieurs images distinctes.
Comment les marques en profitent réellement
GPT Image 1.5 améliore la cohérence du style lorsque vous utilisez des valeurs de seed stables et que vous conservez un langage descriptif constant d’un prompt à l’autre. Les mêmes paramètres de style (direction de la lumière, température de couleur, cadrage) produisent des résultats qui partagent suffisamment d’ADN visuel pour se lire comme une série cohérente plutôt que comme des images individuelles aléatoires.
Les limites demeurent : la cohérence entre sessions sans valeurs de seed reste peu fiable, et l’identité faciale dérive sans références d’ancrage explicites.
Alternatives PicassoIA pour les travaux de cohérence :
- Reve 2.1 accepte des images de référence en entrée, ce qui vous permet d’ancrer chaque nouvelle génération à une référence visuelle plutôt que de vous fier uniquement à une description textuelle.
- Seedream 5 Pro produit un résultat très cohérent lorsque les prompts descriptifs restent stables, avec un transfert de style solide à partir d’images de référence.
- Krea 2 Medium excelle à maintenir un caractère stylistique cohérent d’une scène à l’autre dans des décors différents, ce qui le rend efficace pour les contenus de marque sérialisés.
💡 Pour une correspondance faciale exacte : utilisez Face Swap AI de PicassoIA pour injecter un visage de référence dans n’importe quelle scène générée. Cela supprime totalement la dépendance à la cohérence par le prompt et garantit la précision du visage, quel que soit le modèle de base utilisé.
Essayez ces modèles sur PicassoIA dès maintenant
Pour les images riches en texte
Si les progrès du rendu de texte de GPT Image 1.5 répondent à vos besoins, commencez par Ideogram v4 Quality sur PicassoIA. Il a été conçu autour du problème du texte dans l’image et surpasse régulièrement les modèles généralistes sur cette tâche précise. Titres courts, prix, libellés de boutons et accroches : il les traite avec un niveau de précision sur lequel les designers professionnels peuvent compter, sans passage de correction obligatoire dans Photoshop.
Pour les portraits photoréalistes
Seedream 5 Pro est le concurrent le plus direct de GPT Image 1.5 sur la qualité des portraits disponible sur PicassoIA. Il utilise par défaut une résolution 2K, gère avec précision les scénarios d’éclairage naturel complexes et rend la texture de la peau avec un détail individuel qui donne, à première vue, une impression de photographie authentique. Si votre brief est centré sur le portrait (lifestyle, éditorial ou persona de marque), c’est le modèle par lequel commencer.
Pour les portraits environnementaux où des personnes interagissent avec des produits, des espaces ou d’autres sujets dans des scènes complexes, Krea 2 Large apporte une précision de composition et une cohérence des proportions dans les cadrages larges.
Pour les scènes multi-objets
Les scènes complexes avec plusieurs sujets, chacun doté d’attributs et de positions spatiales distincts, sont le terrain où Krea 2 Large et Grok Imagine Image Quality se distinguent sur PicassoIA. Lancez le même prompt multi-sujets complexe sur les deux modèles et comparez les résultats côte à côte. Les écarts dans l’attribution des attributs et dans le placement spatial apparaissent immédiatement.
Les limites de GPT Image 1.5
GPT Image 1.5 représente un progrès notable, mais ce n’est pas un produit fini. Il présente encore des faiblesses régulières qui comptent dans un contexte professionnel :
- Mains et extrémités : les erreurs de nombre de doigts sont moins fréquentes, mais pas éliminées
- Longues chaînes de texte : la précision se dégrade au-delà de six à huit mots dans une même phrase
- Architecture complexe : les fenêtres en arc, les colonnes et les détails structurels fins se déforment souvent
- Éléments mécaniques et électroniques : les outils, instruments et appareils sont rendus avec des détails plausibles mais incorrects
- Éclairages extrêmes : les scènes à fort contraste ou en contre-jour peuvent produire un rendu de surface incohérent
Aucun modèle unique ne l’emporte dans tous les cas d’usage. Le bon outil dépend entièrement du résultat précis que votre flux de travail exige, et c’est précisément pour cela qu’un large catalogue de modèles est utile.
Commencez à créer avec ces capacités
Les cinq domaines où GPT Image 1.5 a dépassé les attentes (rendu de texte, profondeur du suivi d’instructions, photoréalisme des portraits, positionnement spatial et cohérence du style) ne sont pas des capacités réservées à GPT. Elles représentent la direction que suit l’ensemble du domaine, et PicassoIA propose déjà des modèles spécialisés qui égalent ou dépassent GPT Image 1.5 sur chacun de ces axes.
Commencez par Seedream 5 Pro pour un rendu photoréaliste. Utilisez Ideogram v4 Quality lorsque la précision du texte dans l’image n’est pas négociable. Tournez-vous vers Krea 2 Large lorsque vous avez besoin d’un contrôle précis sur des scènes multi-sujets aux attributs et contraintes spatiales superposés.
Avec plus de 90 modèles texte vers image disponibles, PicassoIA vous offre la marge nécessaire pour tester chaque capacité côte à côte, sans changer de plateforme ni gérer des comptes API séparés. Votre prochaine image n’est qu’à un prompt, sur picassoia.com/en/all-models.


