O GPT Image 1.5 pegou a maioria das pessoas de surpresa. Não porque chegou com anúncios dramáticos, mas porque as coisas específicas que ele melhorou eram exatamente as áreas que todo o campo tinha aceitado silenciosamente como insolúveis. Texto em imagens? Deixe de lado. Rostos consistentes entre iterações? Use uma solução alternativa. Instruções composicionais complexas? Gere cinco vezes e escolha a melhor.
Se você vinha descartando modelos de texto para imagem com base em resultados de doze meses atrás, o GPT Image 1.5 merece uma segunda olhada. Não como um avanço de nova geração, mas como uma correção pontual nos pontos de atrito mais persistentes da geração de imagens por IA. Este artigo analisa as cinco capacidades específicas em que ele supera as expectativas e mostra onde alternativas comparáveis no PicassoIA igualam ou superam o modelo em cada uma delas.
O que o GPT Image 1.5 realmente mudou
Não é o DALL-E 4
A OpenAI evitou deliberadamente chamar este modelo de DALL-E 4. O nome é intencional: esta não é uma reformulação arquitetural de nova geração. O GPT Image 1.5 é um refinamento de precisão voltado para falhas específicas do DALL-E 3. As cinco áreas em que ele mostra melhora mensurável são a precisão na renderização de texto, a profundidade no seguimento de instruções, o fotorrealismo de retratos, o posicionamento espacial de objetos e a consistência de estilo entre gerações.
Benchmarks independentes de grupos de pesquisa que testam tarefas estruturadas de seguimento de prompts colocam o GPT Image 1.5 consistentemente acima do DALL-E 3 e do Midjourney v6 nos cinco eixos. Não é uma conquista pequena, considerando o cenário lotado de modelos de 2027.
Por que a arquitetura importa aqui
As melhorias do GPT Image 1.5 não resultam apenas de mais dados de treinamento ou de execuções de treinamento mais longas. Como o modelo compartilha a arquitetura de encoder com o GPT-4o, ele processa o significado por trás de um prompt antes de gerar pixels. Ele não está apenas associando o padrão A à saída B. Está raciocinando sobre o prompt de uma maneira que os modelos anteriores, baseados apenas em difusão, não conseguiam.
É por isso que pedir ao GPT Image 1.5 para posicionar elementos em locais espaciais específicos, ou para renderizar texto legível dentro de uma cena, produz resultados melhores do que os modelos anteriores, apesar de volumes de dados de treinamento semelhantes.
1. Renderização de texto que realmente funciona
A promessa não cumprida de 2022
Pergunte a qualquer designer gráfico que testou ferramentas de imagem por IA entre 2022 e o início de 2024 como foi sua experiência com geração de texto em imagens, e você ouvirá a mesma história: não servia para produção. Os modelos alucinavam letras, juntavam caracteres uns nos outros ou produziam borrões que pareciam legíveis, mas se desfaziam com qualquer zoom. Os contornos se acumulavam: adicionar o texto depois no Photoshop, usar duas ferramentas separadas, gerar a imagem limpa e sobrepor o texto por cima.
Esses contornos não eram soluções ideais. Eram remendos para um problema sistêmico, acrescentando um tempo considerável de pós-processamento a cada fluxo de trabalho criativo assistido por IA.
O que a versão 1.5 acerta
O GPT Image 1.5 produz texto legível e tipograficamente estável em imagens, com uma taxa de sucesso bem acima do DALL-E 3 em prompts com frases curtas, de uma a seis palavras. Os caracteres mantêm espessura de traço consistente, o espaçamento entre letras é razoável e o texto se integra à imagem, em vez de flutuar de forma estranha por cima dela.
Não é perfeito. Sequências com mais de oito palavras ainda se degradam bastante. Fontes estilizadas com ligaduras complexas se quebram. Mas, para textos curtos e diretos, como textos de destaque de produtos, cabeçalhos para redes sociais e chamadas de anúncios, o resultado é utilizável em produção numa taxa que antes não era possível.
Para quem precisa ir além, o Ideogram v4 Quality no PicassoIA foi criado especificamente para precisão de texto em imagens. Ele fica ainda acima do GPT Image 1.5 em tarefas de renderização de frases curtas. O Ideogram v4 Balanced troca um pouco de fotorrealismo por uma fidelidade de texto muito melhor em frases mais longas, o que o torna a escolha especializada para qualquer briefing de design que exija texto legível dentro da própria imagem.
💡 Texto em imagens: Para banners de anúncios, gráficos de redes sociais ou maquetes de embalagens de produtos, teste o Ideogram v4 Quality antes de qualquer modelo de uso geral. Ele foi feito especificamente para esse trabalho.
| Tamanho do texto | GPT Image 1.5 | Ideogram v4 Quality |
|---|
| 1-4 palavras | Confiável | Muito confiável |
| 5-8 palavras | Bom | Forte |
| 9+ palavras | Inconsistente | Moderado |
| Fontes estilizadas | Inconsistente | Melhor |
2. Instruções complexas em uma única passagem
O problema da vinculação de atributos
Os modelos anteriores são fortes em composições simples de sujeito e ambiente. "Um golden retriever numa praia ao pôr do sol" funciona de forma previsível. A falha aparece quando os prompts combinam vários sujeitos com atributos distintos: cores, posições, relações e ações simultâneas.
Os pesquisadores chamam isso de problema da vinculação de atributos: o modelo conhece todos os elementos, mas atribui os atributos aos objetos errados. O casaco azul vai para o personagem errado. O guarda-chuva aparece na mão errada. O gato acaba no fundo em vez de na soleira da porta. Esses erros faziam dos prompts compositivos complexos uma loteria.
O que muda na prática
O GPT Image 1.5 melhora a precisão de vinculação de atributos em prompts com vários objetos para aproximadamente 78%, contra 52% do DALL-E 3 em testes estruturados equivalentes. Isso significa que o modelo atribui corretamente as características descritas aos sujeitos certos em cerca de quatro entre cinco cenas complexas.
É um salto significativo em confiabilidade. Com 52%, gerar cenas complexas era basicamente aleatório. Com 78%, vira uma ferramenta prática para briefings criativos em camadas, nos quais a precisão composicional não é opcional.
Para designers que precisam atingir esse padrão de forma confiável, o Krea 2 Large no PicassoIA oferece forte precisão composicional em prompts com vários sujeitos, e o Reve 2.1 lida com descrições de cenas relacionais com fidelidade consistente em diversas combinações de sujeitos.
💡 Cenas complexas: Organize seu prompt em grupos lógicos (sujeito, atributos, posição, ambiente), em vez de uma frase única e longa. Tanto o GPT Image 1.5 quanto os modelos do PicassoIA respondem melhor a uma lógica de prompt organizada do que a descrições densas em formato de parágrafo.
3. Rostos humanos sem o horror
O problema de confiança com rostos sintéticos
As falhas do vale da estranheza em retratos por IA não apenas ficam ruins. Elas sinalizam para o espectador, muitas vezes em um nível subconsciente, que a imagem é artificial. Isso importa enormemente em aplicações nas quais a autenticidade é o ponto central: publicidade de estilo de vida, conteúdo editorial, personas em redes sociais e fotografia de marca.
Os marcadores de falha são consistentes entre os modelos: olhos simétricos demais, pele com uma suavidade cerosa que a pele real não tem, cabelo renderizado como um bloco de textura uniforme em vez de fios individuais, dentes excessivamente brancos e perfeitamente alinhados, de um jeito que nenhuma boca real alcança.
O que a versão 1.5 realmente corrigiu
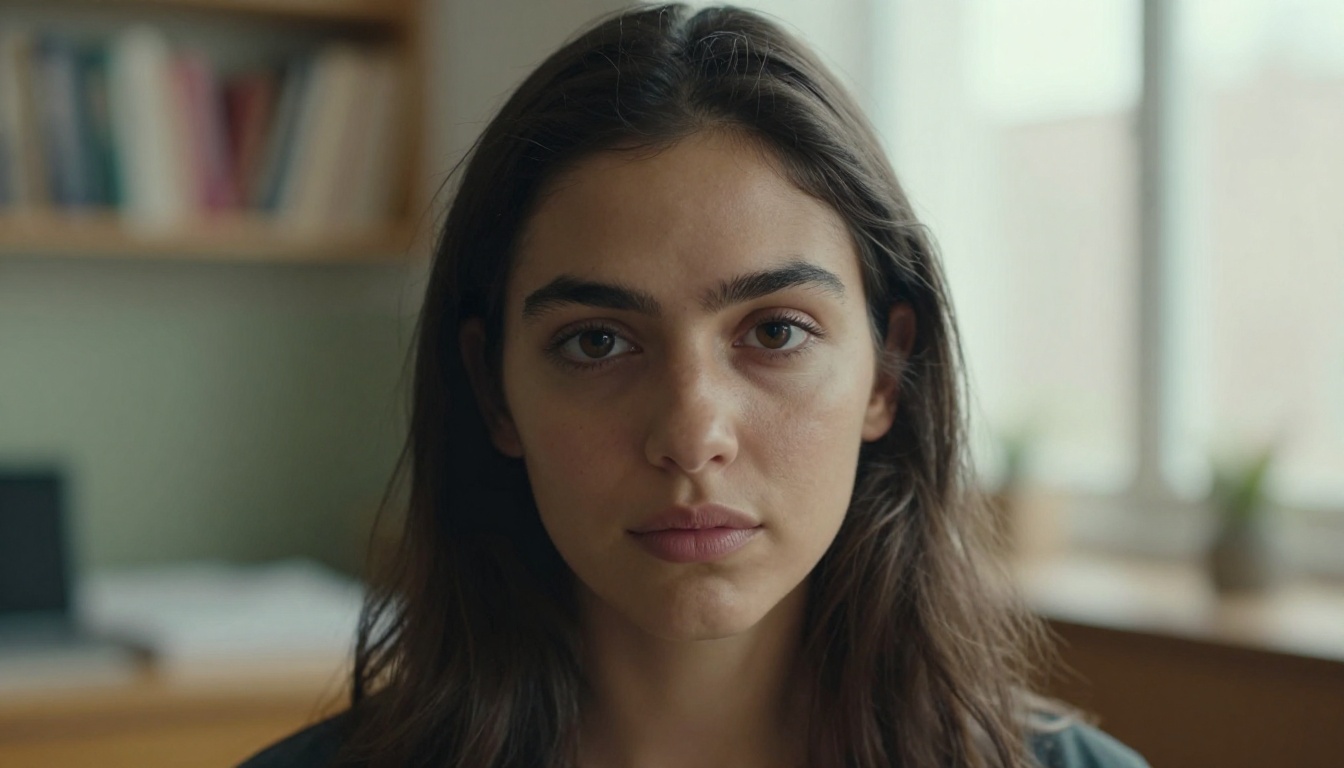
O GPT Image 1.5 reduz significativamente os artefatos do vale da estranheza em prompts de retrato. A pele é renderizada com estrutura de poros visível e variação natural de tom. Os detalhes da íris mostram irregularidade de pigmentação realista, em vez de um círculo de cor chapado. O cabelo tem diferenciação de fios individuais e volume natural, não uma superfície uniforme. Os dentes aparecem com a pequena variação e o tamanho normal que os dentes reais têm.
O modelo ainda apresenta alguns artefatos residuais em close-ups extremos e em rostos em ângulos pouco representados nos dados de treinamento. Mas, para orientações de retrato de frente e de três quartos, a melhora é grande o suficiente para que os resultados passem rotineiramente numa inspeção visual casual.
Modelos do PicassoIA que alcançam qualidade de retrato comparável:
- Seedream 5 Pro: o carro-chefe da ByteDance em 2K, com renderização excepcional de textura da pele, frequentemente avaliado acima do GPT Image 1.5 em tarefas de retrato em close por avaliadores independentes.
- Krea 2 Large: forte em retratos ambientais de corpo inteiro, com proporções faciais precisas em distância média.
- Reve 2.1: excelente para estilos editoriais e de retrato de estilo de vida, com expressões naturais e espontâneas.
4. Lógica espacial e posicionamento de objetos
Quando "canto superior esquerdo" não significa nada
As instruções espaciais direcionais têm sido um dos pontos fracos mais persistentes da geração de imagens por IA. "O texto deve estar embaixo" produz texto no meio. "O prédio está do lado esquerdo" produz um prédio centralizado. "Coloque o produto no canto superior direito" produz um produto em algum lugar vagamente à direita.
Para o trabalho criativo profissional (layouts de anúncios, templates de redes sociais, mockups para impressão), isso não é um incômodo menor. Torna as ferramentas de imagem com IA inutilizáveis para composições estruturadas sem uma edição significativa após a geração para reposicionar os elementos manualmente.
Cenários práticos para designers
O GPT Image 1.5 mostra um seguimento de instruções espaciais nitidamente melhor do que o DALL-E 3. Ele interpreta corretamente direções cardeais (esquerda, direita, topo, base), linguagem posicional relacional (na frente de, atrás de, ao lado de) e zonas de composição (primeiro plano, fundo, centro do quadro) com confiabilidade bem maior.
Cenários reais de design em que isso importa diretamente:
- Criativos de anúncio: "Produto à direita, espaço para o texto à esquerda para a chamada principal"
- Banners para redes sociais: "Nome da marca no canto inferior esquerdo, imagem principal alinhada à direita"
- Maquetes de e-commerce: "Produto centralizado sobre fundo neutro, acessórios dispostos nos cantos inferiores"
- Layouts editoriais: "Sujeito do retrato no terço direito, contexto ambiental preenche os dois terços da esquerda"
- Conceitos de embalagem: "Rótulo centralizado na metade superior, texto dos ingredientes no quarto inferior"
💡 Precisão espacial no PicassoIA: O Grok Imagine Image Quality da xAI lida com prompts de posicionamento direcional com boa confiabilidade e gera saídas em 2K, o que o torna uma alternativa prática para tarefas de geração voltadas a design.
5. Consistência de estilo entre variações
O problema do mesmo personagem
Gestores de marca e equipes de conteúdo têm um problema específico que as melhorias gerais de qualidade de imagem não resolvem: precisam que o mesmo personagem continue reconhecivelmente idêntico em dezenas de imagens separadas, geradas em sessões diferentes.
Uma mascote de produto criada para uma campanha do Q1 precisa continuar parecendo a mesma mascote no Q3. Uma persona usada em conteúdo consistente para redes sociais precisa manter a estabilidade visual ao longo de 50 publicações. Os modelos anteriores tornavam isso praticamente impossível sem usar os mesmos valores de seed e aceitar uma variação quase nula, o que anula o objetivo de gerar várias imagens distintas.
Como as marcas realmente se beneficiam
O GPT Image 1.5 melhora a consistência de estilo quando você usa valores de seed estáveis e mantém uma linguagem descritiva consistente entre os prompts. Os mesmos parâmetros de estilo, como direção da luz, temperatura de cor e enquadramento composicional, produzem resultados que compartilham DNA visual suficiente para parecer uma série coerente, e não imagens individuais aleatórias.
As limitações permanecem: a consistência entre sessões sem valores de seed continua pouco confiável, e a identidade facial se desvia sem referências de ancoragem explícitas.
Alternativas do PicassoIA para trabalho de consistência:
- O Reve 2.1 aceita imagens de referência como entrada, permitindo ancorar cada nova geração em uma referência visual, e não apenas na descrição textual.
- O Seedream 5 Pro produz resultados de alta consistência quando as descrições dos prompts permanecem estáveis, com forte transferência de estilo a partir de imagens de referência.
- O Krea 2 Medium se destaca em manter um personagem de estilo consistente em cenas com ambientes diferentes, o que o torna eficaz para conteúdo de marca em série.
💡 Para correspondência facial exata: Use o Face Swap AI do PicassoIA para inserir um rosto de referência em qualquer cena gerada. Isso elimina a dependência da consistência baseada em prompt e garante a precisão facial, independentemente do modelo base que você estiver usando.
Teste estes modelos no PicassoIA agora mesmo
Para imagens com muito texto
Se as melhorias de renderização de texto do GPT Image 1.5 são o que você precisa, comece com o Ideogram v4 Quality no PicassoIA. Ele foi arquitetado em torno do problema de texto em imagens e supera de forma consistente os modelos de uso geral nessa tarefa específica. Manchetes curtas, destaques de preço, rótulos de botões e chamadas: ele lida com tudo isso com um nível de precisão em que designers profissionais podem confiar, sem uma etapa obrigatória de correção no Photoshop depois.
Para retratos fotorrealistas
O Seedream 5 Pro é o concorrente mais direto do GPT Image 1.5 em qualidade de retrato disponível no PicassoIA. Ele usa 2K como resolução padrão, lida com cenários complexos de luz natural com precisão e renderiza a textura da pele com detalhes individuais que facilmente parecem fotografia autêntica num primeiro olhar. Se o seu briefing for centrado em retratos, seja de estilo de vida, editorial ou de persona de marca, este é o modelo para começar.
Para retratos ambientais em que pessoas interagem com produtos, espaços ou outros sujeitos em cenas complexas, o Krea 2 Large traz precisão composicional e consistência de proporções para composições de quadro inteiro.
Para cenas com vários objetos
Cenas complexas com vários sujeitos, cada um com atributos e posições espaciais distintos, são onde o Krea 2 Large e o Grok Imagine Image Quality têm bom desempenho no PicassoIA. Execute o mesmo prompt complexo com vários sujeitos nos dois modelos e compare os resultados lado a lado. As diferenças na precisão da atribuição de atributos e no posicionamento espacial ficam imediatamente visíveis.
Onde o GPT Image 1.5 ainda deixa a desejar
O GPT Image 1.5 é um avanço significativo, não um produto acabado. Ele ainda apresenta fraquezas consistentes que importam em contextos profissionais:
- Mãos e extremidades: Erros na contagem de dedos são menos comuns, mas não foram eliminados
- Sequências longas de texto: A precisão cai depois de seis a oito palavras em uma única frase
- Arquitetura complexa: Janelas em arco, colunas e detalhes estruturais intrincados costumam se deformar
- Especificidades mecânicas e eletrônicas: Ferramentas, instrumentos e dispositivos aparecem com detalhes plausíveis, mas incorretos
- Cenários de iluminação extrema: Cenas de alto contraste ou contraluz podem produzir renderização de superfície inconsistente
Nenhum modelo único vence em todos os casos de uso. A ferramenta certa depende totalmente de qual resultado específico o seu fluxo de trabalho exige, e é exatamente por isso que o acesso a uma biblioteca ampla de modelos importa.
As cinco áreas em que o GPT Image 1.5 superou as expectativas (renderização de texto, profundidade no seguimento de instruções, fotorrealismo de retratos, posicionamento espacial e consistência de estilo) não são capacidades exclusivas do GPT. Elas representam a direção para a qual todo o campo está caminhando, e o PicassoIA já oferece modelos especializados que igualam ou superam o GPT Image 1.5 em cada eixo específico.
Comece com o Seedream 5 Pro para resultados fotorrealistas. Use o Ideogram v4 Quality quando a precisão do texto dentro da imagem for inegociável. Recorra ao Krea 2 Large quando você precisar de controle preciso sobre cenas com vários sujeitos, atributos em camadas e exigências espaciais.
Com mais de 90 modelos de texto para imagem disponíveis, o PicassoIA oferece a variedade para testar cada capacidade lado a lado, sem trocar de plataforma nem gerenciar contas de API separadas. Sua próxima imagem está a um prompt de distância em picassoia.com/en/all-models.


