GPT Image 1.5 ने ज़्यादातर लोगों को अचानक चौंका दिया। ऐसा इसलिए नहीं कि इसकी घोषणाएँ नाटकीय थीं, बल्कि इसलिए कि जिन चीज़ों में इसने सुधार किया, वे ठीक वही क्षेत्र थे जिन्हें पूरा फ़ील्ड चुपचाप असंभव मान चुका था। इमेज में टेक्स्ट? उसे छोड़ दीजिए। बार-बार बनने वाले चेहरों में एकरूपता? कोई तरकीब अपनाइए। जटिल कंपोज़िशन वाले निर्देश? पाँच बार जनरेट कीजिए और सबसे अच्छा चुन लीजिए।
अगर आप बारह महीने पहले के नतीजों के आधार पर टेक्स्ट-टू-इमेज मॉडलों को खारिज कर चुके हैं, तो GPT Image 1.5 पर दोबारा नज़र डालना सार्थक है। इसे किसी पीढ़ी-बदलने वाली सफलता के रूप में नहीं, बल्कि AI इमेज जनरेशन की सबसे लगातार बनी रहने वाली दिक्कतों में एक लक्षित सुधार के रूप में देखें। यह लेख उन पाँच खास क्षमताओं को समझाता है जहाँ यह उम्मीदों से आगे निकलता है, और दिखाता है कि PicassoIA पर तुलनीय विकल्प हर एक में कहाँ बराबरी करते हैं या उससे आगे निकल जाते हैं।
GPT Image 1.5 ने असल में क्या बदला
DALL-E 4 नहीं
OpenAI ने जानबूझकर इस मॉडल का नाम DALL-E 4 नहीं रखा। यह नामकरण सोच-समझकर किया गया है: यह कोई पीढ़ी-बदलने वाला आर्किटेक्चरल बदलाव नहीं है। GPT Image 1.5, DALL-E 3 की विशेष खामियों को निशाना बनाने वाला एक सटीक सुधार है। जिन पाँच क्षेत्रों में इसमें मापने योग्य सुधार दिखता है, वे हैं टेक्स्ट रेंडरिंग की सटीकता, निर्देश-पालन की गहराई, पोर्ट्रेट का फ़ोटोरियलिज़्म, वस्तुओं की स्थानिक स्थिति, और इमेज-दर-इमेज स्टाइल की एकरूपता।
संरचित प्रॉम्प्ट-पालन वाले कार्यों का परीक्षण करने वाले शोध समूहों के स्वतंत्र बेंचमार्क लगातार दिखाते हैं कि GPT Image 1.5 इन सभी पाँचों पैमानों पर DALL-E 3 और Midjourney v6 से ऊपर है। 2027 के भीड़भाड़ वाले मॉडल परिदृश्य को देखते हुए यह कोई छोटी उपलब्धि नहीं है।
आर्किटेक्चर क्यों मायने रखता है
GPT Image 1.5 के सुधार केवल ज़्यादा ट्रेनिंग डेटा या लंबी ट्रेनिंग का नतीजा नहीं हैं। चूँकि इसका एन्कोडर आर्किटेक्चर GPT-4o के साथ साझा है, यह पिक्सेल जनरेट करने से पहले प्रॉम्प्ट के पीछे के अर्थ को समझता है। यह पैटर्न A को आउटपुट B से नहीं मिलाता। यह प्रॉम्प्ट के बारे में उस तरह से तर्क करता है जैसा पहले के केवल-डिफ्यूज़न मॉडल नहीं कर पाते थे।
इसी वजह से, GPT Image 1.5 से किसी दृश्य में वस्तुओं को खास स्थानों पर रखने को कहें, या किसी सीन के भीतर पढ़ने योग्य टेक्स्ट बनवाएँ, तो नतीजे पिछले मॉडलों से बेहतर आते हैं, जबकि ट्रेनिंग डेटा की मात्रा लगभग समान है।
1. ऐसी टेक्स्ट रेंडरिंग जो सचमुच टिकती है
2022 का टूटा वादा
2022 से 2024 की शुरुआत के बीच AI इमेज टूल आज़माने वाले किसी भी ग्राफ़िक डिज़ाइनर से पूछिए कि इमेज में टेक्स्ट बनाने का अनुभव कैसा रहा, तो आपको एक ही कहानी सुनने को मिलेगी: प्रोडक्शन में यह बेकार था। मॉडल अक्षरों में हैलुसिनेशन करते थे, अक्षर एक-दूसरे में मिल जाते थे, या ऐसे धुंधले धब्बे बनते थे जो ज़रा-सा ज़ूम करने पर बिखर जाते थे। तरकीबों की भरमार हो गई: बाद में Photoshop में टेक्स्ट जोड़ना, दो अलग टूल इस्तेमाल करना, या साफ़ इमेज जनरेट करके ऊपर से कॉपी को कंपोज़ करना।
ये तरकीबें आदर्श हल नहीं थीं। ये एक व्यवस्थागत समस्या पर लगाए गए पैबंद थे, जो हर AI-सहायता वाले क्रिएटिव वर्कफ़्लो में काफ़ी पोस्ट-प्रोसेसिंग समय जोड़ते थे।
1.5 में क्या सही हुआ
GPT Image 1.5 एक से छह शब्दों वाले छोटे वाक्यांश प्रॉम्प्ट पर DALL-E 3 से काफ़ी बेहतर सफलता दर के साथ पढ़ने योग्य, टाइपोग्राफ़ी के लिहाज़ से स्थिर टेक्स्ट बनाता है। अक्षरों की स्ट्रोक मोटाई एक जैसी रहती है, अक्षरों के बीच की दूरी ठीक होती है, और टेक्स्ट इमेज में घुलता-मिलता है, न कि उस पर अटपटे ढंग से तैरता है।
यह परफ़ेक्ट नहीं है। आठ शब्दों से लंबी पंक्तियाँ अब भी काफ़ी बिगड़ती हैं। जटिल लिगेचर वाले स्टाइलाइज़्ड फ़ॉन्ट भी टूट जाते हैं। लेकिन छोटी, सीधी कॉपी के लिए, जैसे प्रोडक्ट कॉलआउट, सोशल हेडर या विज्ञापन टैगलाइन, आउटपुट उस दर पर प्रोडक्शन के लायक होता है जो पहले संभव नहीं था।
जो इसे आगे ले जाना चाहते हैं, उनके लिए PicassoIA पर Ideogram v4 Quality खास तौर पर इमेज में टेक्स्ट की सटीकता के लिए बनाया गया था। छोटे वाक्यांशों की रेंडरिंग पर यह GPT Image 1.5 से भी ऊँचा बेंचमार्क देता है। Ideogram v4 Balanced लंबे वाक्यांशों पर टेक्स्ट की शुद्धता को कहीं बेहतर बनाने के लिए फ़ोटोरियलिज़्म में कुछ कमी स्वीकार करता है, जिससे यह उन डिज़ाइन ब्रीफ़ के लिए विशेषज्ञ विकल्प बन जाता है जिनमें इमेज के भीतर पढ़ने योग्य कॉपी ज़रूरी है।
💡 इमेज में टेक्स्ट: विज्ञापन बैनर, सोशल मीडिया ग्राफ़िक्स या प्रोडक्ट पैकेजिंग मॉकअप के लिए किसी भी सामान्य-उद्देश्य मॉडल से पहले Ideogram v4 Quality आज़माएँ। यह इसी काम के लिए खास तौर पर बना है।
| टेक्स्ट की लंबाई | GPT Image 1.5 | Ideogram v4 Quality |
|---|
| 1-4 शब्द | भरोसेमंद | बहुत भरोसेमंद |
| 5-8 शब्द | अच्छा | मज़बूत |
| 9+ शब्द | असंगत | मध्यम |
| स्टाइलाइज़्ड फ़ॉन्ट | असंगत | बेहतर |
2. एक ही पास में जटिल निर्देश
एट्रिब्यूट बाइंडिंग की समस्या
पहले के मॉडल सरल सब्जेक्ट-परिवेश कंपोज़िशन में मज़बूत थे। "सूर्यास्त के समय समुद्र तट पर एक गोल्डन रिट्रीवर" अनुमान के मुताबिक़ काम करता है। समस्या तब आती है जब प्रॉम्प्ट में कई सब्जेक्ट अलग-अलग एट्रिब्यूट के साथ परतों में आते हैं: रंग, स्थितियाँ, आपसी रिश्ते और एक साथ होने वाली क्रियाएँ।
रिसर्चर इसे एट्रिब्यूट बाइंडिंग समस्या कहते हैं: मॉडल को सभी तत्वों की जानकारी होती है, लेकिन वह एट्रिब्यूट गलत वस्तुओं को सौंप देता है। नीला कोट गलत किरदार पर चला जाता है। छतरी गलत हाथ में दिखती है। बिल्ली दरवाज़े की सीढ़ी के बजाय पृष्ठभूमि में चली जाती है। इन गलतियों ने जटिल कंपोज़िशन वाले प्रॉम्प्ट को लॉटरी जैसा बना दिया था।
व्यवहार में क्या बदलता है
GPT Image 1.5 मल्टी-ऑब्जेक्ट प्रॉम्प्ट पर एट्रिब्यूट बाइंडिंग सटीकता को लगभग 78% तक सुधारता है, जबकि समान संरचित परीक्षणों पर DALL-E 3 के लिए यह 52% है। इसका मतलब है कि मॉडल जटिल दृश्यों में लगभग पाँच में से चार बार वर्णित एट्रिब्यूट सही सब्जेक्ट को सौंपता है।
यह विश्वसनीयता में एक अहम छलांग है। 52% पर जटिल दृश्य बनाना लगभग रैंडम था। 78% पर यह उन परतदार क्रिएटिव ब्रीफ़ के लिए व्यावहारिक टूल बन जाता है, जहाँ कंपोज़िशन की सटीकता वैकल्पिक नहीं है।
जो डिज़ाइनर इस मानक को भरोसे से हासिल करना चाहते हैं, उनके लिए PicassoIA पर Krea 2 Large मल्टी-सब्जेक्ट प्रॉम्प्ट पर मज़बूत कंपोज़िशनल सटीकता देता है, और Reve 2.1 विविध सब्जेक्ट संयोजनों में रिलेशनल सीन विवरणों को लगातार अच्छी फ़िडेलिटी के साथ संभालता है।
💡 जटिल दृश्य: अपने प्रॉम्प्ट को एक लंबे वाक्य के बजाय तार्किक समूहों में बाँटें: सब्जेक्ट, एट्रिब्यूट, स्थिति, परिवेश। GPT Image 1.5 और PicassoIA के मॉडल, दोनों, घने पैराग्राफ़-शैली के विवरणों के बजाय व्यवस्थित प्रॉम्प्ट लॉजिक पर बेहतर प्रतिक्रिया देते हैं।
3. बिना डरावने हुए मानव चेहरे
सिंथेटिक चेहरों की भरोसे की समस्या
AI पोर्ट्रेट में अनकैनी वैली की खामियाँ केवल बुरी नहीं लगतीं। वे दर्शकों को, अक्सर अवचेतन स्तर पर, संकेत देती हैं कि इमेज कृत्रिम है। यह उन इस्तेमालों में बेहद मायने रखता है जहाँ प्रामाणिकता ही मुख्य बात है: लाइफ़स्टाइल विज्ञापन, एडिटोरियल कंटेंट, सोशल मीडिया पर्सोना और ब्रांड फ़ोटोग्राफ़ी।
विफलता के संकेत मॉडलों में एक जैसे दिखते हैं: बहुत ज़्यादा सममित आँखें, ऐसी मोमी चिकनाई वाली त्वचा जो असली त्वचा में नहीं होती, ऐसे बाल जो अलग-अलग तंतुओं के बजाय एक समान टेक्सचर ब्लॉक की तरह दिखते हैं, और ऐसे दाँत जो अस्वाभाविक रूप से सफ़ेद और इतने परफ़ेक्ट रूप से सीधे हैं जितने कोई असली मुँह नहीं होता।
1.5 ने असल में क्या ठीक किया
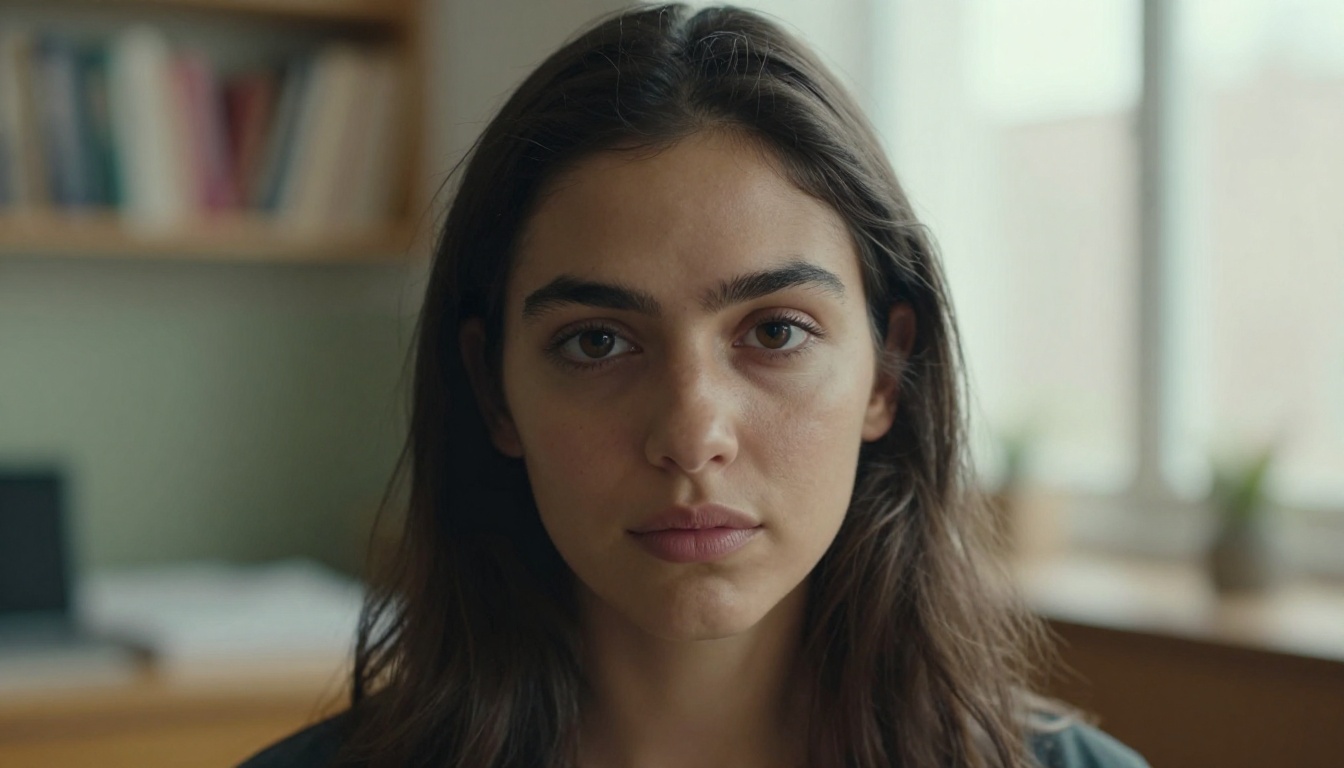
GPT Image 1.5 पोर्ट्रेट प्रॉम्प्ट पर अनकैनी वैली की खामियों को काफ़ी कम करता है। त्वचा में दिखने वाली रोमछिद्र संरचना और प्राकृतिक रंग-भिन्नता आती है। आईरिस में एक समान रंग के गोले के बजाय वास्तविक पिगमेंटेशन की अनियमितता दिखती है। बाल अलग-अलग तंतुओं और प्राकृतिक आयतन के साथ आते हैं, न कि एक समान सतह की तरह। दाँत असली दाँतों जैसी हल्की भिन्नता और सामान्य आकार के साथ दिखते हैं।
मॉडल अब भी बहुत करीबी क्लोज़-अप में और ऐसे कोणों वाले चेहरों पर कुछ बची हुई खामियाँ दिखाता है, जो ट्रेनिंग डेटा में कम दिखे थे। लेकिन सीधे और तीन-चौथाई पोर्ट्रेट दिशाओं के लिए सुधार इतना बड़ा है कि आउटपुट आम तौर पर सामान्य दृश्य जाँच में खरे उतरते हैं।
PicassoIA के मॉडल जो तुलनीय पोर्ट्रेट गुणवत्ता तक पहुँचते हैं:
- Seedream 5 Pro: ByteDance का फ़्लैगशिप, 2K रिज़ॉल्यूशन पर उत्कृष्ट त्वचा टेक्सचर रेंडरिंग के साथ, जिसे स्वतंत्र मूल्यांकनकर्ता क्लोज़-अप पोर्ट्रेट कार्यों पर अक्सर GPT Image 1.5 से ऊपर रेट करते हैं।
- Krea 2 Large: मध्यम दूरी पर सटीक चेहरे के अनुपात वाले पूर्ण-शरीर पर्यावरणीय पोर्ट्रेट में मज़बूत।
- Reve 2.1: स्वाभाविक, बिना बनावटी भावों वाले एडिटोरियल और लाइफ़स्टाइल पोर्ट्रेट शैलियों के लिए बेहतरीन।
4. स्थानिक तर्क और वस्तु की स्थिति
जब "ऊपर-बाएँ" का कोई मतलब नहीं रहता
दिशात्मक स्थानिक निर्देश AI इमेज जनरेशन की सबसे लगातार कमज़ोरियों में रहे हैं। "टेक्स्ट नीचे होना चाहिए" बीच में टेक्स्ट बना देता है। "इमारत बाईं ओर है" केंद्र में इमारत बना देता है। "प्रोडक्ट को ऊपर-दाएँ कोने में रखें" से प्रोडक्ट कहीं दाईं ओर, पर अस्पष्ट रूप से बनता है।
पेशेवर क्रिएटिव काम में, जैसे विज्ञापन लेआउट, सोशल टेम्पलेट और प्रिंट मॉकअप, यह कोई छोटी परेशानी नहीं है। इसकी वजह से स्ट्रक्चर्ड कंपोज़िशन के लिए AI इमेज टूल्स तब तक इस्तेमाल लायक नहीं रहते, जब तक जनरेशन के बाद एलिमेंट्स को हाथ से दोबारा सही जगह रखने के लिए काफ़ी एडिटिंग न की जाए।
डिज़ाइनरों के लिए व्यावहारिक परिदृश्य
GPT Image 1.5 DALL-E 3 की तुलना में स्थानिक निर्देशों का पालन काफ़ी बेहतर दिखाता है। यह मुख्य दिशाएँ (बाएँ, दाएँ, ऊपर, नीचे), संबंध-सूचक स्थितियाँ (सामने, पीछे, बगल में) और कंपोज़िशन क्षेत्र (अग्रभूमि, पृष्ठभूमि, केंद्र फ़्रेम) कहीं ज़्यादा विश्वसनीयता के साथ समझता है।
वास्तविक डिज़ाइन परिदृश्य जहाँ यह सीधे मायने रखता है:
- विज्ञापन क्रिएटिव: "प्रोडक्ट दाईं ओर, हेडलाइन ओवरले के लिए बाईं ओर कॉपी स्पेस"
- सोशल बैनर: "ब्रांड नाम नीचे-बाएँ, हीरो इमेज दाईं ओर संरेखित"
- ई-कॉमर्स मॉकअप: "न्यूट्रल बैकग्राउंड पर प्रोडक्ट केंद्र में, एक्सेसरीज़ नीचे के कोनों में व्यवस्थित"
- एडिटोरियल लेआउट: "पोर्ट्रेट सब्जेक्ट दाएँ तिहाई में, पर्यावरणीय संदर्भ बाएँ दो-तिहाई भाग भरता है"
- पैकेजिंग कॉन्सेप्ट: "लेबल ऊपरी आधे भाग में केंद्रित, सामग्री का टेक्स्ट निचले चौथाई भाग में"
💡 PicassoIA पर स्थानिक सटीकता: xAI की Grok Imagine Image Quality दिशात्मक स्थिति वाले प्रॉम्प्ट को ठोस विश्वसनीयता से संभालती है और 2K रिज़ॉल्यूशन पर आउटपुट देती है, जिससे यह डिज़ाइन-उन्मुख जनरेशन कार्यों के लिए व्यावहारिक विकल्प बनती है।
5. विभिन्न वेरिएशन में स्टाइल की एकरूपता
वही किरदार वाली समस्या
ब्रांड मैनेजरों और कंटेंट टीमों की एक खास समस्या है जिसे सामान्य इमेज गुणवत्ता के सुधार हल नहीं करते: उन्हें एक ही किरदार को अलग-अलग सत्रों में बनी दर्जनों अलग इमेज में पहचानने लायक एक जैसा दिखाना होता है।
Q1 अभियान के लिए बनाया गया प्रोडक्ट मैस्कॉट Q3 में भी वही मैस्कॉट दिखना चाहिए। लगातार सोशल कंटेंट के लिए इस्तेमाल होने वाला पर्सोना 50 पोस्ट में दृश्य रूप से स्थिर रहना चाहिए। पिछले मॉडलों में यह लगभग असंभव था, जब तक आप एक जैसे सीड वैल्यू इस्तेमाल करें और लगभग शून्य वेरिएशन स्वीकार करें, जो कई अलग इमेज बनाने के उद्देश्य को ही खत्म कर देता है।
ब्रांड्स को असल में कैसे फ़ायदा होता है
GPT Image 1.5 स्थिर सीड वैल्यू इस्तेमाल करने और प्रॉम्प्ट में लगातार वर्णनात्मक भाषा रखने पर स्टाइल की एकरूपता सुधारता है। एक जैसे स्टाइल पैरामीटर, जैसे रोशनी की दिशा, रंग का तापमान और कंपोज़िशन का फ़्रेमिंग, ऐसे आउटपुट देते हैं जिनमें इतनी साझा दृश्य पहचान होती है कि वे अलग-अलग रैंडम इमेज के बजाय एक सुसंगत सीरीज़ जैसे दिखते हैं।
सीमाएँ बनी हुई हैं: बिना सीड वैल्यू के सत्रों के बीच एकरूपता अब भी भरोसेमंद नहीं है, और स्पष्ट एंकर संदर्भों के बिना चेहरे की पहचान बदलती रहती है।
एकरूपता के काम के लिए PicassoIA के विकल्प:
- Reve 2.1 रेफ़रेंस इमेज इनपुट सपोर्ट करता है, जिससे आप हर नई जनरेशन को सिर्फ़ टेक्स्ट विवरण के बजाय एक विज़ुअल रेफ़रेंस से जोड़ सकते हैं।
- Seedream 5 Pro स्थिर वर्णनात्मक प्रॉम्प्ट रहने पर उच्च-एकरूपता वाला आउटपुट देता है, और रेफ़रेंस इमेज से मज़बूत स्टाइल ट्रांसफ़र के साथ।
- Krea 2 Medium अलग-अलग सेटिंग वाले दृश्यों में लगातार स्टाइलिस्टिक किरदार बनाए रखने में उत्कृष्ट है, जिससे यह सीरियलाइज़्ड ब्रांड कंटेंट के लिए कारगर है।
💡 सटीक चेहरा मिलाने के लिए: PicassoIA के Face Swap AI का इस्तेमाल करके किसी भी जनरेट किए गए दृश्य में रेफ़रेंस चेहरा डालें। इससे प्रॉम्प्ट-आधारित एकरूपता पर निर्भरता पूरी तरह खत्म हो जाती है, और आप जो भी बेस मॉडल इस्तेमाल करें, चेहरे की सटीकता पक्की रहती है।
अभी PicassoIA पर ये मॉडल आज़माएँ
टेक्स्ट-भारी इमेज के लिए
अगर GPT Image 1.5 के टेक्स्ट-रेंडरिंग सुधार आपकी ज़रूरत हैं, तो PicassoIA पर Ideogram v4 Quality से शुरू करें। इसे इमेज-में-टेक्स्ट समस्या को ध्यान में रखकर बनाया गया था और यह इस खास काम पर सामान्य-उद्देश्य मॉडलों से लगातार बेहतर प्रदर्शन करता है। छोटी हेडलाइन, प्राइस कॉलआउट, बटन लेबल और टैगलाइन: यह उन्हें ऐसी सटीकता से संभालता है कि प्रोडक्शन डिज़ाइनर बाद में अनिवार्य Photoshop सुधार के बिना भी उस पर भरोसा कर सकें।
फ़ोटोरियलिस्टिक पोर्ट्रेट के लिए
Seedream 5 Pro PicassoIA पर पोर्ट्रेट गुणवत्ता में GPT Image 1.5 का सबसे सीधा प्रतिस्पर्धी है। यह डिफ़ॉल्ट रूप से 2K रिज़ॉल्यूशन देता है, जटिल प्राकृतिक रोशनी वाले दृश्यों को सटीकता से संभालता है, और त्वचा के टेक्सचर को ऐसी बारीकी से रेंडर करता है जो पहली नज़र में भरोसेमंद फ़ोटोग्राफ़ी जैसा लगता है। अगर आपका ब्रीफ़ पोर्ट्रेट-केंद्रित है, जैसे लाइफ़स्टाइल, एडिटोरियल या ब्रांड पर्सोना काम, तो इसी मॉडल से शुरू करें।
उन पर्यावरणीय पोर्ट्रेट के लिए जहाँ लोग प्रोडक्ट, स्थानों या जटिल दृश्यों में दूसरे सब्जेक्ट्स के साथ बातचीत करते हैं, Krea 2 Large पूर्ण-फ़्रेम कंपोज़िशन में कंपोज़िशनल सटीकता और अनुपात की एकरूपता लाता है।
मल्टी-ऑब्जेक्ट दृश्यों के लिए
ऐसे जटिल दृश्य, जिनमें कई सब्जेक्ट हों और हर एक के अलग एट्रिब्यूट व स्थानिक स्थितियाँ हों, वहीं Krea 2 Large और Grok Imagine Image Quality PicassoIA पर अच्छा प्रदर्शन करते हैं। एक ही जटिल मल्टी-सब्जेक्ट प्रॉम्प्ट दोनों मॉडलों पर चलाएँ और आउटपुट साथ-साथ तुलना करें। एट्रिब्यूट असाइनमेंट की सटीकता और स्थानिक स्थिति का फ़र्क तुरंत दिख जाएगा।
GPT Image 1.5 अब भी कहाँ कमज़ोर है
GPT Image 1.5 एक बड़ा कदम है, पूरा हो चुका उत्पाद नहीं। इसमें अब भी कुछ लगातार कमज़ोरियाँ हैं जो पेशेवर संदर्भों में मायने रखती हैं:
- हाथ और अंग: उंगलियों की गिनती में गलतियाँ कम होती हैं, पर पूरी तरह खत्म नहीं हुई हैं
- लंबी टेक्स्ट पंक्तियाँ: एक वाक्यांश में छह से आठ शब्दों के बाद सटीकता गिरती है
- जटिल वास्तुकला: मेहराबदार खिड़कियाँ, स्तंभ और बारीक संरचनात्मक विवरण अक्सर विकृत हो जाते हैं
- यांत्रिक और इलेक्ट्रॉनिक विशेषताएँ: औज़ार, उपकरण और यंत्र ऐसे विवरणों के साथ रेंडर होते हैं जो सही लगते हैं पर गलत होते हैं
- अत्यधिक रोशनी वाले दृश्य: तेज़ कंट्रास्ट या बैकलिट दृश्य असंगत सतह रेंडरिंग पैदा कर सकते हैं
हर उपयोग-मामले में कोई एक मॉडल नहीं जीतता। सही टूल इस पर पूरी तरह निर्भर करता है कि आपके वर्कफ़्लो को कौन-सा खास आउटपुट चाहिए, और यही वजह है कि एक व्यापक मॉडल लाइब्रेरी तक पहुँच मायने रखती है।
इन क्षमताओं के साथ अभी बनाना शुरू करें
जिन पाँच क्षेत्रों में GPT Image 1.5 ने उम्मीदों से बेहतर प्रदर्शन किया, यानी टेक्स्ट रेंडरिंग, निर्देश-पालन की गहराई, पोर्ट्रेट का फ़ोटोरियलिज़्म, स्थानिक स्थिति और स्टाइल की एकरूपता, वे केवल GPT की खासियतें नहीं हैं। वे उस दिशा को दर्शाती हैं जिसमें पूरा फ़ील्ड आगे बढ़ रहा है, और PicassoIA पहले से ही ऐसे विशेष मॉडल देता है जो हर खास पैमाने पर GPT Image 1.5 की बराबरी करते हैं या उससे आगे निकल जाते हैं।
फ़ोटोरियलिस्टिक आउटपुट के लिए Seedream 5 Pro से शुरू करें। जब इमेज के भीतर टेक्स्ट की सटीकता ज़रूरी हो, तब Ideogram v4 Quality इस्तेमाल करें। जब आपको जटिल गुणों और स्थानिक ज़रूरतों वाले मल्टी-सब्जेक्ट दृश्यों पर सटीक नियंत्रण चाहिए, तब Krea 2 Large चुनें।
90 से अधिक टेक्स्ट-टू-इमेज मॉडल उपलब्ध होने के साथ, PicassoIA आपको बिना प्लेटफ़ॉर्म बदले और बिना अलग API अकाउंट संभाले हर खूबी को साथ-साथ आज़माने की सुविधा देता है। आपकी अगली इमेज बस एक प्रॉम्प्ट दूर है, picassoia.com/en/all-models पर।


