La misma foto que tomas en una cena puede, con el pipeline de IA adecuado, convertirse en una escena 3D completamente navegable. No es una interpretación artística de esa escena, sino una reconstrucción geométrica precisa en la que cada superficie tiene una profundidad medible, cada objeto ocupa un espacio tridimensional real y la luz sobre el mantel se corresponde con propiedades materiales reales. Lo que hace esto posible es la convergencia de tres enfoques distintos de IA, cada uno resuelve una parte diferente del problema geométrico y cada uno es mucho más capaz que lo que existía hace cinco años.
Qué hace realmente la IA de foto a 3D
Es geometría, no arte
Cuando se oye que la IA genera modelos 3D a partir de fotos, muchos imaginan algo artístico: un modelo entrenado con conjuntos de datos de arte 3D que produce algo que parece tridimensional. La realidad es más rigurosa. La IA de foto a 3D es, en esencia, un problema de recuperación de geometría. El sistema resuelve una pregunta: dado un conjunto de píxeles con valores de color conocidos, ¿qué disposición de superficies en el espacio tridimensional produciría exactamente esos colores vistos desde ese ángulo de cámara?
Esa pregunta es más difícil de lo que parece. La fotografía comprime tres dimensiones en dos. Toda la información espacial (qué objeto está más cerca, hacia qué ángulo mira una superficie, a qué distancia están realmente dos puntos) se reduce a una cuadrícula plana de píxeles. Recuperar la tercera dimensión a partir de ese registro comprimido es lo que hacen estos sistemas de IA, y la precisión que se puede lograr hoy es notable.
Los sistemas de foto a 3D más avanzados pueden reconstruir objetos con una precisión submilimétrica a partir de capturas de varias imágenes, y los métodos de una sola imagen ya producen geometría verosímil para categorías de objetos conocidas en las que no existe ninguna información de profundidad directa.
La profundidad es la pieza que falta
Todos los algoritmos de reconstrucción 3D comparten la misma tarea fundamental: recuperar la profundidad. Un píxel fotográfico normal te dice el color y la intensidad de luminancia. No te dice a qué distancia está ese punto de la cámara. La IA debe inferir esa dimensión que falta, bien mediante relaciones geométricas entre varias imágenes, bien mediante conocimientos visuales previos adquiridos a partir de un solo fotograma.
El método elegido depende de qué entradas están disponibles y de la precisión que necesite el resultado. Los métodos geométricos de varias imágenes son más precisos. Los métodos de una sola imagen son más rápidos y requieren menos esfuerzo de captura. Se usan ambos, a menudo combinados.
Las tres tecnologías que lo impulsan
Fotogrametría: sigue siendo el estándar de oro en precisión
La fotogrametría es anterior a la IA por décadas. El método es geométrico: tomas varias fotos del mismo objeto desde posiciones distintas, encuentras rasgos visuales coincidentes en esas fotos y usas las relaciones geométricas entre esas coincidencias para triangular la posición 3D de cada punto.
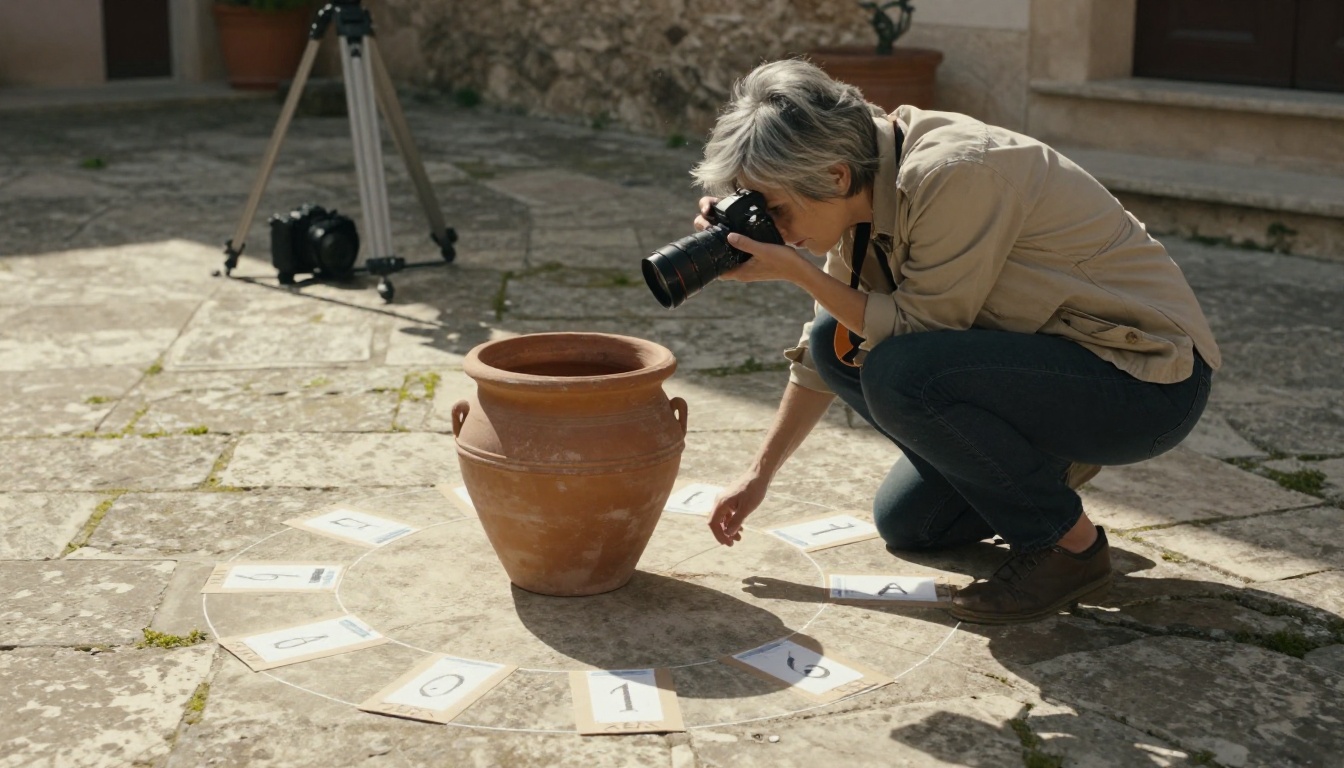
Lo que la IA moderna ha hecho con la fotogrametría es acelerarla y generalizarla. La fotogrametría tradicional requería una iluminación controlada, superficies limpias y con muchos detalles, y revisiones manuales de las coincidencias de rasgos. Los pipelines actuales asistidos por IA manejan objetos con texturas repetitivas, superficies reflectantes e iluminación irregular que habrían derrotado por completo a los métodos anteriores.
El pipeline principal funciona así:
- Extracción de rasgos: Las redes neuronales identifican puntos clave fiables en cada imagen (esquinas, bordes, parches de textura distintivos).
- Emparejamiento de rasgos: El sistema encuentra qué puntos clave de una imagen corresponden al mismo punto del mundo real en otra.
- Estructura a partir del movimiento (SfM): A partir de los rasgos emparejados, el algoritmo estima a la vez las posiciones de la cámara y las posiciones 3D de los puntos.
- Reconstrucción densa: La nube de puntos dispersa de SfM se completa con una estimación de profundidad densa en cada par de píxeles.
- Generación de malla: La nube de puntos densa se triangula en una superficie continua.
- Proyección de textura: Los colores de la foto original se proyectan de nuevo sobre la malla.
El resultado de una ejecución de fotogrametría bien hecha es una malla 3D texturizada que, para sujetos capturados correctamente, es visualmente indistinguible de un modelo escaneado físicamente.
La nube de puntos: la forma en bruto de la geometría
Antes de que exista una malla, existe una nube de puntos. Esta representación intermedia está en el centro de todos los métodos de reconstrucción de varias imágenes, no solo de la fotogrametría, y entenderla aclara cómo funciona el resto del pipeline.
Una nube de puntos es exactamente lo que suena: millones (a veces miles de millones) de posiciones de coordenadas 3D individuales, cada una con el valor de color observado en esa ubicación en las fotos de origen. El software de fotogrametría moderno genera de forma habitual nubes de puntos de entre 50 y 200 millones de puntos a partir de unos cientos de imágenes. Con esa densidad, la nube en sí tiene aspecto de objeto sólido al renderizarla, incluso antes de aplicar cualquier paso de mallado.
El paso de mallado convierte la nube desestructurada en una superficie conectada. Algoritmos como la reconstrucción de superficies de Poisson o el ball-pivoting ajustan una malla triangular continua a la distribución de puntos. La calidad de este paso determina lo bien que el modelo final maneja estructuras finas, bordes afilados y geometría cóncava.
Estimación de profundidad: 3D a partir de un solo fotograma
La fotogrametría necesita varias imágenes. La estimación de profundidad monocular funciona con una sola. Es la tecnología detrás de las apps del teléfono que aproximan la geometría de una habitación a partir de un solo fotograma de video, y se basa en patrones que el modelo ha absorbido al entrenarse con millones de pares imagen-profundidad.
Los modelos de IA entrenados con estos datos interiorizan señales visuales que indican de forma fiable las relaciones espaciales:
- Perspectiva atmosférica: La neblina aumenta con la distancia, desaturando y suavizando los objetos lejanos.
- Perspectiva lineal: Las líneas paralelas convergen hacia puntos de fuga a medida que aumenta la distancia.
- Oclusión: Los objetos que bloquean a otros ocupan un espacio más cercano.
- Tamaño familiar: Los objetos conocidos proporcionan referencias de escala implícitas.
- Gradiente de textura: La textura de la superficie parece más fina a mayor distancia.
- Desenfoque: Una profundidad de campo reducida mantiene más nítidos los objetos cercanos.
El resultado es un mapa de profundidad: una imagen en escala de grises en la que el brillo de cada píxel codifica la distancia estimada. El blanco intenso significa cerca, el negro profundo significa lejos. A partir de este mapa de profundidad se puede reconstruir una superficie 3D aproximada proyectando cada píxel hacia fuera desde la cámara a su distancia estimada.
La estimación de profundidad monocular produce profundidades relativas. El modelo puede decirte que el jarrón está más cerca que la estantería, pero no a qué distancia exacta está cada uno en unidades del mundo real. Para aplicaciones que requieren precisión métrica, las configuraciones de cámaras estéreo o los sensores de profundidad dedicados proporcionan el factor de escala de calibración necesario para convertir las estimaciones relativas en medidas absolutas.
Campos de radiancia neuronales: un tipo de representación diferente
NeRF, presentado en 2020, ofreció una respuesta fundamentalmente distinta al problema de foto a 3D. En lugar de reconstruir una malla y aplicar texturas, un NeRF entrena una red neuronal compacta que representa la propia escena como una función volumétrica continua.
Dado cualquier posición 3D y dirección de visión como entrada, la red devuelve el color y la densidad del espacio en esa ubicación. Para renderizar una vista, se lanzan rayos a través de los píxeles de una cámara virtual, se muestrea la red en muchos puntos a lo largo de cada rayo y se componen los resultados en un color de píxel. La red se entrena con las mismas entradas de varias imágenes que usa la fotogrametría, pero en lugar de extraer geometría explícita, absorbe una función implícita que puede reproducir las vistas de entrenamiento originales y generalizar a puntos de vista completamente nuevos.
La ventaja de calidad frente a la fotogrametría tradicional fue inmediata en ciertas áreas. Los NeRF manejan de forma natural:
- Reflejos especulares que cambian de aspecto según el ángulo de visión
- Materiales translúcidos como el cristal, los líquidos y el humo
- Estructuras finas como el cabello y el follaje, que derrotan a los algoritmos de mallado
- Apariencia coherente desde puntos de vista nuevos que no estaban en los datos de entrenamiento
La limitación original era el costo computacional. Los primeros modelos NeRF tardaban horas en entrenarse para una sola escena y segundos por fotograma en renderizarse. La comunidad investigadora ha reducido esta brecha de forma considerable desde entonces. Métodos como Instant-NGP redujeron el tiempo de entrenamiento a minutos. El 3D Gaussian Splatting (3DGS), presentado en 2023, logra un renderizado en tiempo real con alta calidad al representar las escenas como millones de gaussianas 3D orientadas en lugar de una red neuronal, lo que permite una vista previa interactiva en hardware de consumo.
Los patrones de captura que marcan la diferencia entre el éxito y el fracaso
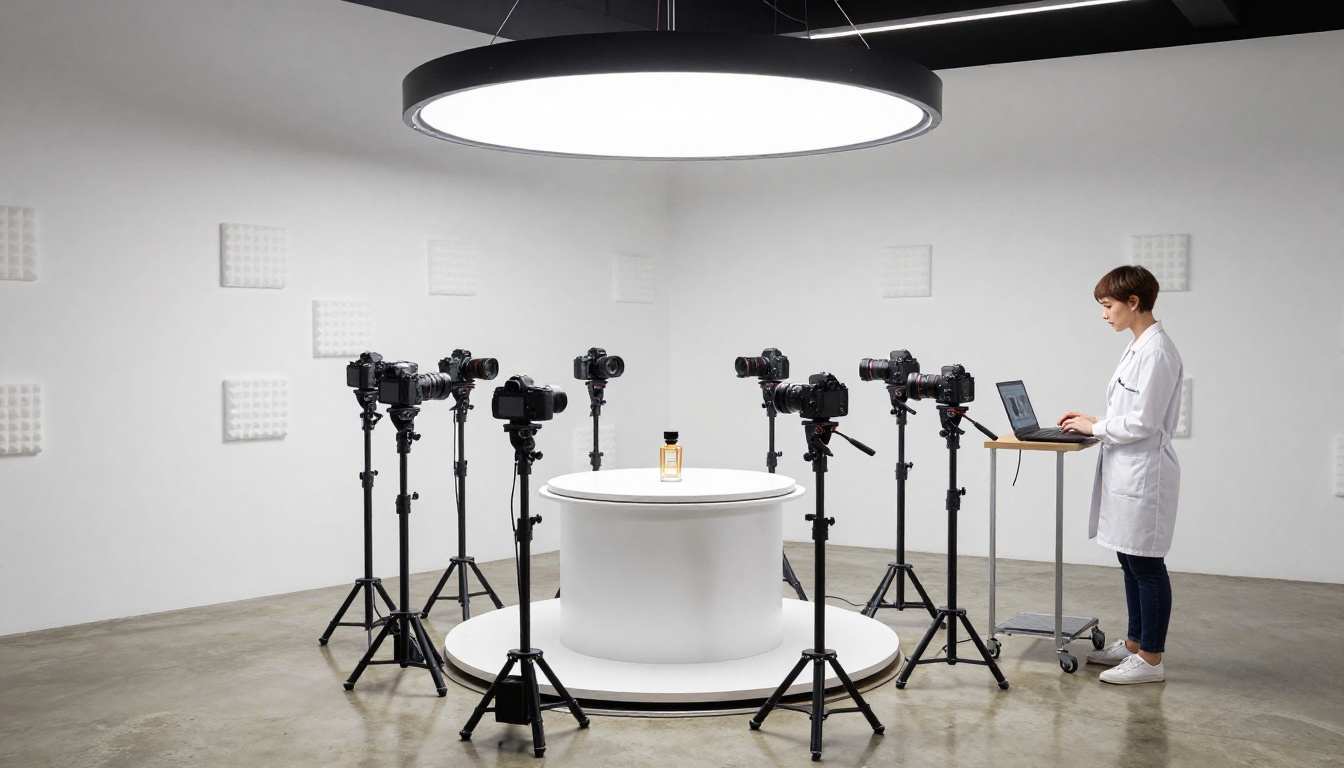
En los métodos de varias imágenes, la cobertura lo es todo
La calidad de cualquier reconstrucción de varias imágenes depende más de cómo se capturaron las imágenes que del algoritmo de reconstrucción que las procesa. Un algoritmo muy avanzado con una cobertura deficiente produce huecos y errores geométricos. Un algoritmo sólido con una cobertura completa y con solapamiento produce un resultado limpio.
| Elemento de captura | Estándar mínimo | Estándar profesional |
|---|
| Separación angular | Cada 20-30 grados | Cada 10-15 grados |
| Niveles verticales | 2 (horizontal + inclinación hacia arriba) | 3-4 (incluido el nadir con la cámara hacia abajo) |
| Solapamiento de imágenes | 60% entre imágenes adyacentes | 80% entre imágenes adyacentes |
| Iluminación | Constante, sin sombras duras | Nublado o estudio con luz difusa |
| Resolución | 12 MP | 24 MP como mínimo |
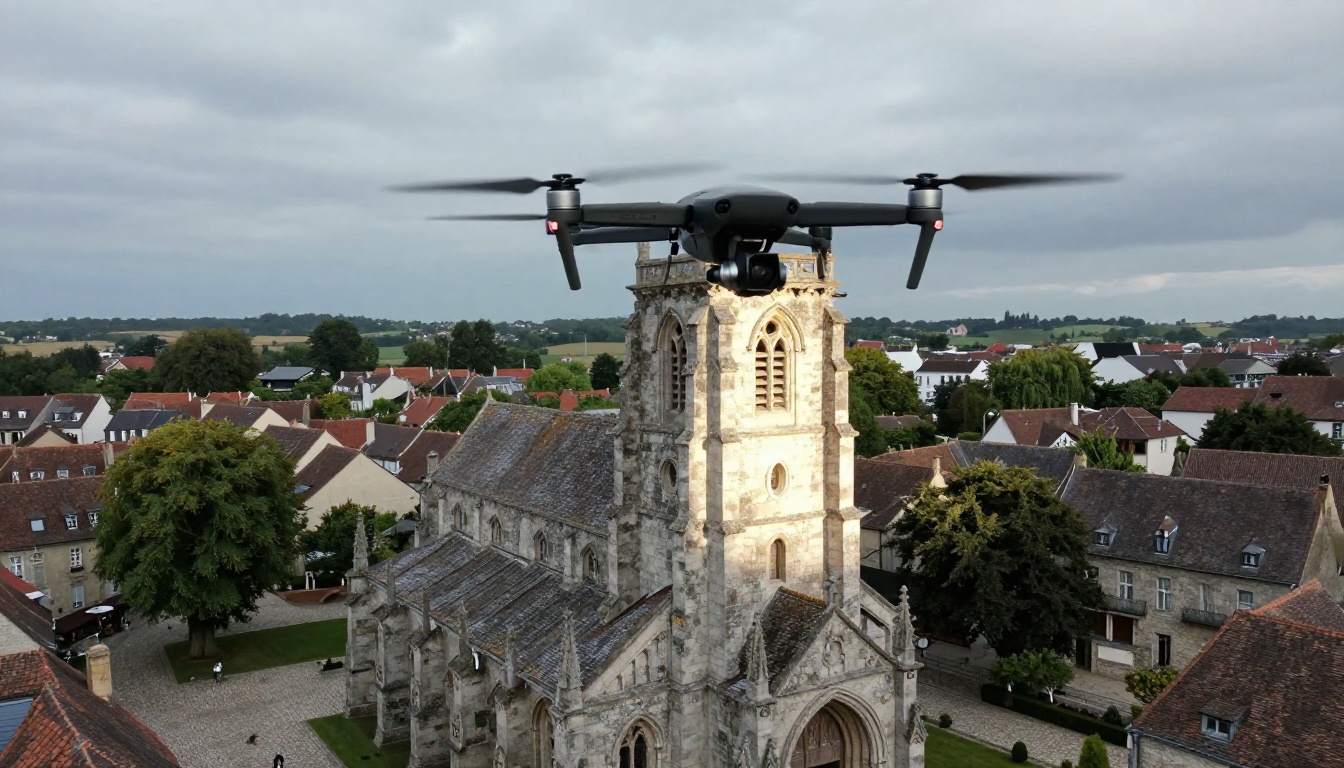
Para sujetos de gran escala (edificios, yacimientos arqueológicos, terreno), la fotogrametría con dron es el estándar actual de la industria. Un dron vuela siguiendo una cuadrícula programada y captura fotogramas solapados en cada punto de paso. El plan de vuelo está diseñado para que cada punto del sujeto aparezca en al menos tres o cuatro imágenes desde ángulos significativamente distintos, lo que da al algoritmo de reconstrucción suficientes restricciones geométricas para una triangulación precisa.
💡 Consejo de captura: El viento es una de las fuentes más comunes de error en la fotogrametría al aire libre. Incluso una ligera vibración de la cámara durante la captura introduce un desenfoque que altera el emparejamiento de rasgos. Dispara en condiciones de calma o usa una velocidad de obturación más rápida para congelar cualquier movimiento.
Sectores que ya lo usan a gran escala
Cirugía ortopédica e implantes personalizados
La imagen médica fue una de las primeras aplicaciones de gran valor, y hoy ha dejado muy atrás la fase experimental. Los cirujanos ortopédicos usan de forma habitual reconstrucciones 3D a partir de tomografías computarizadas para planificar las operaciones de sustitución articular, seleccionando y posicionando los implantes sobre un modelo digital de la anatomía real del paciente antes de la primera incisión.
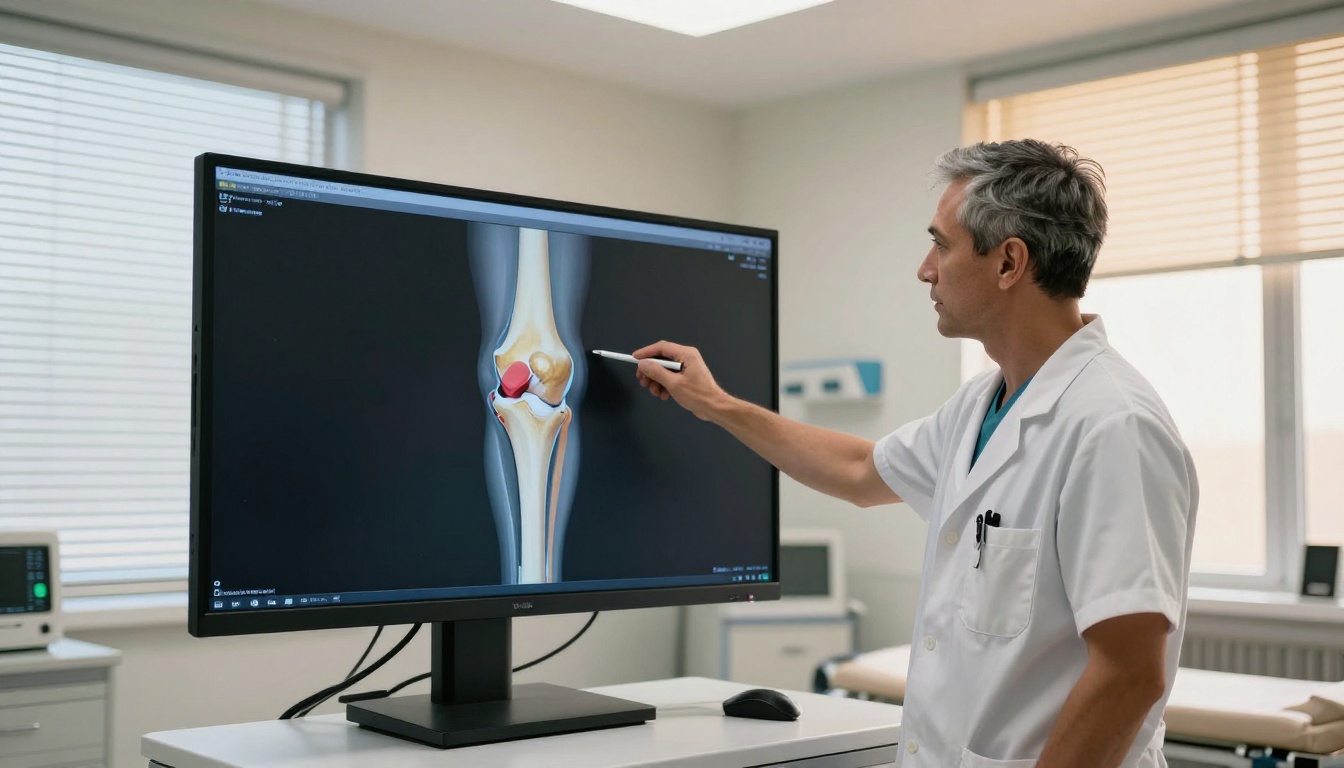
Los implantes personalizados diseñados a partir de la anatomía 3D específica del paciente representan una de las ventajas clínicas más claras. Una prótesis de cadera estándar de catálogo viene en una gama limitada de tallas. Una prótesis personalizada modelada a partir de la geometría real del hueso del paciente encaja con precisión, lo que reduce el tiempo quirúrgico y mejora la estabilidad a largo plazo. El modelo 3D que lo hace posible procede de una tomografía computarizada preoperatoria estándar procesada mediante un pipeline de segmentación y reconstrucción.
La evaluación de heridas es una aplicación más reciente que está ganando terreno en los entornos clínicos. Los escáneres de luz estructurada o las cámaras de profundidad acopladas a los teléfonos inteligentes estándar pueden generar modelos 3D precisos de la geometría de una herida, lo que ofrece a los clínicos mediciones longitudinales objetivas de sus dimensiones en lugar de depender de una estimación visual.
Arquitectura y documentación del patrimonio
Los arquitectos y los responsables de la conservación fueron de los primeros en adoptarlo, y sus casos de uso no han hecho más que ampliarse.
Para la renovación de edificios existentes, un levantamiento con dron produce un modelo 3D con una precisión de unos pocos centímetros, adecuado como base para planos de estado final. Lo que antes requería un costoso escaneado LIDAR (a menudo entre $5,000 y $50,000 por proyecto) hoy cuesta un vuelo de dron y unas pocas horas de procesamiento.
La documentación del patrimonio se beneficia de la naturaleza sin contacto del escaneado fotogramétrico. Los yacimientos arqueológicos frágiles, las esculturas dañadas y los detalles arquitectónicos en deterioro pueden capturarse en 3D con precisión y sin ningún contacto físico, lo que crea un registro digital permanente y una referencia para vigilar el deterioro futuro.
Los departamentos de urbanismo usan modelos urbanos 3D para el análisis de sombras, la evaluación de líneas de visión y la visualización del impacto de los desarrollos. Cuando se presenta una licencia de obra, el edificio propuesto se incorpora al modelo urbano 3D real, y los efectos sobre los vecinos y los espacios públicos se vuelven visibles de inmediato.
Videojuegos, cine y entornos en tiempo real
Los estudios de VFX y los equipos de desarrollo de videojuegos llevan años usando la fotogrametría para crear activos de alta fidelidad. Escanear accesorios físicos, rostros de actores y localizaciones de rodaje reales produce activos con un nivel de detalle fotográfico que la generación procedural o el modelado manual no pueden igualar a una velocidad de producción comparable.
💡 Por qué importa en los videojuegos: Un único escaneado fotogramétrico de un muro de piedra real produce un mapa de texturas con variaciones geológicas genuinas que ningún artista de materiales podría replicar a mano con un costo razonable. Esa especificidad es lo que separa los entornos fotorrealistas de los que solo aproximan la realidad.
El cambio de los últimos años está en quién puede hacer este trabajo. El software de fotogrametría de consumo ya convierte el metraje de un teléfono en activos de calidad de producción, lo que pone la creación de activos 3D fotorrealistas al alcance de desarrolladores independientes y pequeños estudios que antes no tenían el presupuesto para equipos de escaneado profesionales.
Comercio electrónico y realidad aumentada
El escaneado de productos se ha convertido en un flujo de trabajo comercial importante. Un único escaneado fotogramétrico de un producto físico genera un modelo 3D a partir del cual los equipos de marketing pueden generar, mediante programación y sin fotografía adicional, cualquier combinación de ángulos de cámara, condiciones de iluminación y entornos de contexto.
Las apps de previsualización de productos en realidad aumentada van un paso más allá. La app reconstruye la geometría básica de la habitación a partir del flujo de la cámara del teléfono, coloca el modelo del producto a la escala correcta y lo renderiza con una iluminación estimada a partir del entorno. Los compradores interactúan con el producto en su propio espacio antes de comprarlo. Los datos de devoluciones de grandes minoristas muestran con regularidad que las previsualizaciones de productos en realidad aumentada reducen las devoluciones de muebles y artículos para el hogar entre un 25 y un 40 por ciento.
Afina tus fotos de origen antes de la reconstrucción
💡 La calidad de cualquier reconstrucción está limitada por la calidad de las fotos de entrada. Las imágenes borrosas, comprimidas en JPEG o subexpuestas introducen errores de emparejamiento de rasgos que se acumulan a lo largo de todos los pasos posteriores del procesamiento.
La acción de preprocesado con más impacto es maximizar la nitidez y la resolución de la imagen. Las herramientas de escalado con IA restauran el detalle que la compresión o la ligera falta de nitidez de la cámara eliminaron, lo que da a los algoritmos de fotogrametría datos de puntos clave más fiables con los que trabajar.
Real ESRGAN está probado en pipelines de reconstrucción profesionales para restaurar el detalle fotográfico a partir de material de origen comprimido. Recupera la textura fina que descarta la compresión JPEG, lo que mejora directamente la precisión del emparejamiento de rasgos en los flujos de trabajo de fotogrametría.
Clarity Pro Upscaler añade una pasada de microenfoque de precisión que afila la definición de los bordes sin los artefactos de halo que produce la máscara de nitidez tradicional. Los bordes más nítidos se traducen directamente en una detección de rasgos más precisa.
Para los flujos de trabajo que requieren un aislamiento limpio del sujeto antes de la reconstrucción, Remove Background produce recortes sin artefactos que evitan que los píxeles del fondo interfieran en el paso de estimación de profundidad.
Cuando el objetivo es maximizar la resolución de salida una vez terminada la reconstrucción, Image Upscale by Topaz Labs permite ampliar hasta 6 veces conservando la estructura del grano fino, útil cuando las imágenes de origen se capturaron con equipos antiguos o en condiciones limitadas.
Lo que todavía da problemas a los sistemas actuales
A pesar del progreso significativo, ciertos tipos de escena desafían de forma fiable a los métodos actuales:
| Categoría del problema | Causa raíz | Soluciones actuales |
|---|
| Objetos transparentes y de cristal | La luz se curva al atravesarlos y no tienen textura superficial que emparejar | Escaneado de luz estructurada con polarización cruzada |
| Espejos y superficies reflectantes | Parecen contener geometría imposible | Tratarlos como regiones enmascaradas y reconstruir a partir del contexto circundante |
| Estructuras finas (cabello, alambre, follaje) | Cobertura de píxeles insuficiente para una triangulación precisa | Captura de alta resolución, conocimientos previos específicos por categoría |
| Superficies sin textura (paredes blancas, plástico liso) | No hay puntos clave detectables para el emparejamiento de rasgos | Proyectar patrones de luz estructurada sobre la superficie |
| Elementos dinámicos (personas en movimiento, objetos movidos por el viento) | Rompe la suposición de escena estática en la que se basan todos los métodos de varias imágenes | Separar primer plano y fondo, y reconstruirlos por separado |
El movimiento es, quizá, la restricción práctica más difícil. Todos los métodos de reconstrucción de varias imágenes suponen que la escena está quieta mientras se capturan las imágenes. Una persona que cambia el peso entre disparos, una hoja movida por el viento o una sombra que cambia de posición cuando pasan las nubes crean incoherencias geométricas que corrompen el resultado.
En los métodos de una sola imagen, la precisión está limitada por la distribución de los datos de entrenamiento. Los objetos o configuraciones con los que el modelo no ha trabajado lo suficiente durante el entrenamiento producen geometría poco plausible en las zonas ocultas, donde los conocimientos previos aprendidos deben sustituir a la evidencia geométrica real.
Empieza a crear con las herramientas de IA de PicassoIA
La reconstrucción de foto a 3D se sitúa en la intersección de la visión artificial, el aprendizaje automático y la geometría. Las barreras para usar esta tecnología están cayendo con rapidez, y sus aplicaciones abarcan desde las apps de consumo para el teléfono hasta los sistemas de planificación quirúrgica que se usan en hospitales de todo el mundo.
Si trabajas en cualquier proyecto en el que la calidad de la imagen determina la calidad del resultado, las herramientas de IA de PicassoIA te dan acceso directo a los mismos modelos de escalado y procesamiento de imagen en los que se apoyan los pipelines 3D profesionales. Escala y restaura tus fotos de origen antes de la reconstrucción, elimina los fondos para aislar mejor el sujeto o lleva la resolución de salida al límite con Topaz Image Upscale.
La tecnología está lista. Empieza con las imágenes que tienes y mira qué hace la IA con ellas.


