A mesma foto que você tira num jantar social poderia, com o pipeline de IA certo, virar uma cena 3D totalmente navegável. Não uma interpretação artística dessa cena, mas uma reconstrução geométrica precisa, em que cada superfície tem profundidade mensurável, cada objeto ocupa espaço tridimensional real e a luz sobre a toalha de mesa corresponde a propriedades reais de material. O que torna isso possível é a convergência de três abordagens distintas de IA, cada uma resolvendo uma parte diferente do problema geométrico, e todas muito mais capazes do que o que existia cinco anos atrás.
O que a IA de foto para 3D realmente faz
É geometria, não arte
Quando as pessoas ouvem que a IA gera modelos 3D a partir de fotos, muitas imaginam algo artístico: um modelo treinado em conjuntos de dados de arte 3D que produz algo que parece tridimensional. A realidade é mais rigorosa. A IA de foto para 3D é, em essência, um problema de recuperação de geometria. O sistema busca resolver uma única pergunta: dado um conjunto de pixels com valores de cor conhecidos, que arranjo de superfícies no espaço tridimensional produziria exatamente essas cores quando vistas a partir desse ângulo de câmera?
Essa pergunta é mais difícil do que parece. A fotografia comprime três dimensões em duas. Toda a informação espacial (qual objeto está mais perto, para que lado uma superfície está voltada, a que distância estão de fato dois pontos) se reduz a uma grade plana de pixels. Recuperar a terceira dimensão a partir desse registro comprimido é o que esses sistemas de IA fazem, e a precisão possível hoje é notável.
Os sistemas de foto para 3D mais avançados conseguem reconstruir objetos com precisão submilimétrica a partir de capturas com várias imagens, e os métodos de imagem única já produzem geometria plausível para categorias de objetos familiares, mesmo quando não há nenhuma informação de profundidade direta.
A profundidade é a peça que falta
Todo algoritmo de reconstrução 3D compartilha a mesma tarefa fundamental: recuperar a profundidade. Um pixel fotográfico comum informa a cor e a intensidade de luminância. Ele não informa a que distância aquele ponto está da câmera. A IA precisa inferir essa dimensão ausente, seja usando relações geométricas entre várias imagens, seja usando priors visuais absorvidos de um único quadro.
A escolha do método depende de quais entradas estão disponíveis e de quão precisa a saída precisa ser. Os métodos geométricos com várias imagens são mais precisos. Os métodos de imagem única são mais rápidos e exigem menos esforço de captura. Ambos são usados, muitas vezes em combinação.
As três tecnologias que impulsionam isso
Fotogrametria: ainda o padrão-ouro em precisão
A fotogrametria é anterior à IA em décadas. O método é geométrico: tire várias fotos do mesmo objeto de posições diferentes, encontre características visuais correspondentes entre essas fotos e use as relações geométricas entre essas correspondências para triangular a posição 3D de cada ponto.
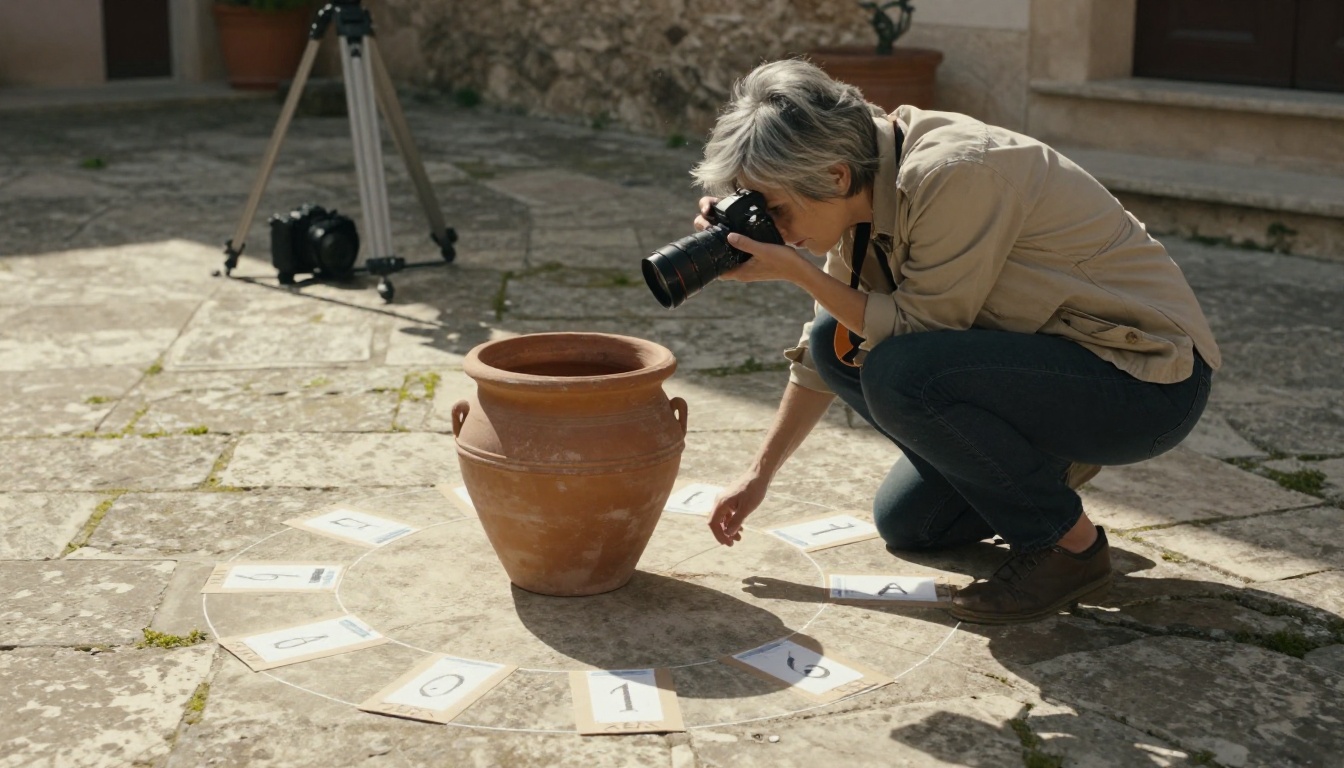
O que a IA moderna fez pela fotogrametria foi acelerá-la e generalizá-la. A fotogrametria tradicional exigia iluminação controlada, superfícies limpas e ricas em características, além de verificações manuais de qualidade nas correspondências. Os pipelines atuais assistidos por IA lidam com objetos de texturas repetitivas, superfícies reflexivas e iluminação irregular, situações que teriam derrotado completamente os métodos antigos.
O pipeline central funciona assim:
- Extração de características: Redes neurais identificam pontos-chave confiáveis em cada imagem (cantos, bordas, trechos de textura distintivos).
- Correspondência de características: O sistema descobre quais pontos-chave de uma imagem correspondem ao mesmo ponto do mundo real em outra.
- Structure from Motion (SfM): A partir das características correspondentes, o algoritmo estima simultaneamente as posições da câmera e as posições 3D dos pontos.
- Reconstrução densa: A nuvem de pontos esparsa do SfM é preenchida com estimativas de profundidade densas em cada par de pixels.
- Geração de malha: A nuvem de pontos densa é triangulada numa superfície contínua.
- Projeção de textura: As cores originais das fotos são projetadas de volta sobre a malha.
O resultado de uma execução bem feita de fotogrametria é uma malha 3D texturizada que, para objetos capturados corretamente, é visualmente indistinguível de um modelo escaneado fisicamente.
A nuvem de pontos: a forma bruta da geometria
Antes de existir uma malha, existe uma nuvem de pontos. Essa representação intermediária está no centro de todos os métodos de reconstrução com várias imagens, não só da fotogrametria, e entendê-la esclarece como o resto do pipeline funciona.
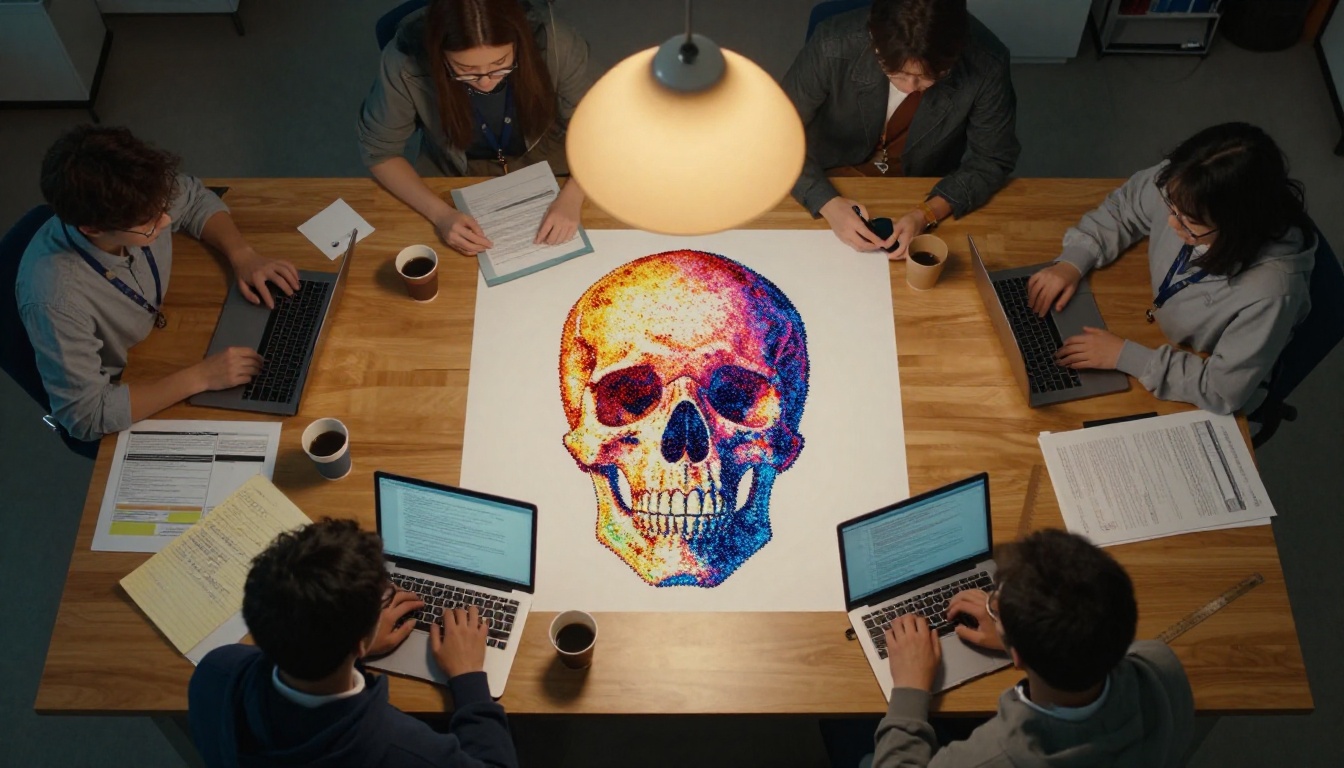
Uma nuvem de pontos é exatamente o que o nome diz: milhões (às vezes bilhões) de coordenadas 3D individuais, cada uma carregando a cor observada naquele local nas fotos de origem. Softwares modernos de fotogrametria geram rotineiramente nuvens com 50 a 200 milhões de pontos a partir de algumas centenas de imagens. Nessa densidade, a nuvem em si parece um objeto sólido quando renderizada, mesmo antes de qualquer etapa de malhagem.
A etapa de malhagem converte a nuvem não estruturada numa superfície conectada. Algoritmos como a reconstrução de superfície de Poisson ou o ball-pivoting ajustam uma malha triangular contínua à distribuição de pontos. A qualidade dessa etapa determina como o modelo final lida com estruturas finas, bordas vivas e geometria côncava.
Estimativa de profundidade: 3D a partir de um único quadro
A fotogrametria exige várias imagens. A estimativa de profundidade monocular funciona com apenas uma. É a tecnologia por trás dos aplicativos de celular que aproximam a geometria de um cômodo a partir de um único quadro de vídeo, e ela depende de padrões que o modelo absorveu ao treinar com milhões de pares imagem-profundidade.
Modelos de IA treinados com esses dados internalizam pistas visuais que indicam de forma confiável relações espaciais:
- Perspectiva atmosférica: A névoa aumenta com a distância, dessaturando e suavizando objetos distantes.
- Perspectiva linear: Linhas paralelas convergem para pontos de fuga à medida que a distância aumenta.
- Oclusão: Objetos que bloqueiam outros ficam numa posição mais próxima.
- Tamanho familiar: Objetos conhecidos fornecem referências de escala implícitas.
- Gradiente de textura: A textura da superfície aparece mais fina a distâncias maiores.
- Desfoque de profundidade: Uma profundidade de campo rasa mantém os objetos do primeiro plano mais nítidos.
A saída é um mapa de profundidade: uma imagem em tons de cinza em que o brilho do pixel codifica a distância estimada. Branco intenso significa perto, preto profundo significa longe. A partir desse mapa, uma superfície 3D aproximada pode ser reconstruída projetando cada pixel para fora da câmera na distância estimada.
A estimativa de profundidade monocular produz profundidades relativas. O modelo consegue dizer que o vaso está mais perto da estante, mas não exatamente a que distância cada um está em unidades do mundo real. Para aplicações que exigem precisão métrica, configurações de câmera estéreo ou sensores de profundidade dedicados fornecem o fator de escala de calibração necessário para converter estimativas relativas em medidas absolutas.
Campos de radiância neural: um tipo diferente de representação
O NeRF, apresentado em 2020, ofereceu uma resposta fundamentalmente diferente para o problema de foto para 3D. Em vez de reconstruir uma malha e aplicar texturas, um NeRF treina uma rede neural compacta para representar a própria cena como uma função volumétrica contínua.
Dado qualquer posição 3D e direção de visualização como entrada, a rede produz a cor e a densidade do espaço naquele local. Para renderizar uma vista, você lança raios pelos pixels de uma câmera virtual, amostra a rede em muitos pontos ao longo de cada raio e combina os resultados numa cor de pixel. A rede treina com as mesmas entradas de várias imagens usadas pela fotogrametria, mas, em vez de extrair geometria explícita, absorve uma função implícita que consegue reproduzir as vistas originais de treino e generalizar para pontos de vista totalmente novos.
A vantagem de qualidade sobre a fotogrametria tradicional foi imediata em certas áreas. Os NeRFs lidam naturalmente com:
- Reflexos especulares que mudam de aparência conforme o ângulo de visão
- Materiais translúcidos como vidro, líquidos e fumaça
- Estruturas finas como cabelo e folhagem, que derrotam os algoritmos de malhagem
- Aparência consistente em pontos de vista novos que não estavam nos dados de treino
A limitação original era o custo computacional. Os primeiros modelos NeRF levavam horas para treinar uma única cena e segundos por quadro para renderizar. A comunidade de pesquisa fechou essa lacuna de forma drástica desde então. Métodos como o Instant-NGP reduziram o tempo de treinamento para minutos. O 3D Gaussian Splatting (3DGS), apresentado em 2023, alcança renderização em tempo real com alta qualidade ao representar cenas como milhões de Gaussianas 3D orientadas, em vez de uma rede neural, o que permite uma prévia interativa em hardware de consumo.
Os padrões de captura que fazem ou desfazem os resultados
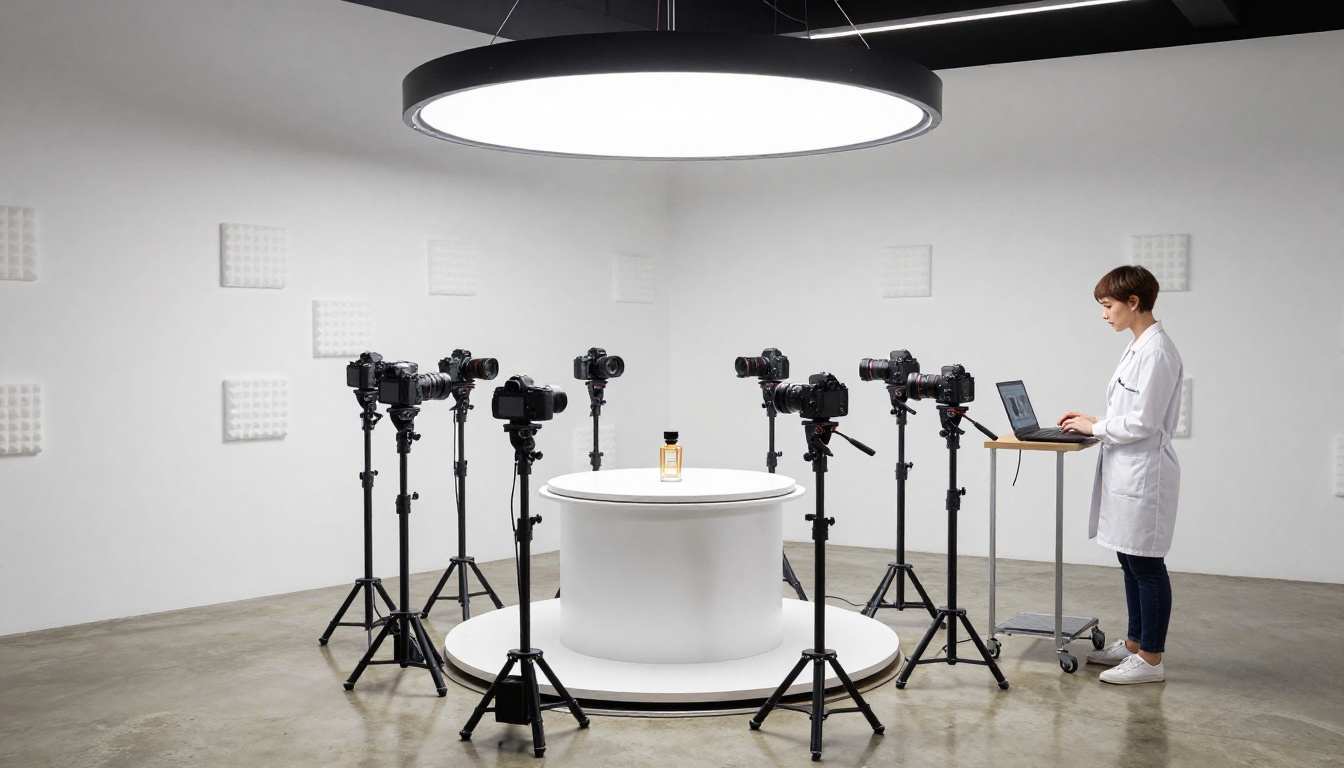
Nos métodos com várias imagens, a cobertura é tudo
A qualidade de qualquer reconstrução com várias imagens depende mais de como as imagens foram capturadas do que do algoritmo de reconstrução que as processa. Um algoritmo de ponta com cobertura ruim produz buracos e erros geométricos. Um algoritmo sólido com cobertura completa e sobreposta produz um resultado limpo.
| Elemento de captura | Padrão mínimo | Padrão profissional |
|---|
| Espaçamento angular | A cada 20-30 graus | A cada 10-15 graus |
| Níveis verticais | 2 (horizontal + inclinação para cima) | 3-4 (incluindo o nadir, voltado para baixo) |
| Sobreposição de imagens | 60% entre imagens adjacentes | 80% entre imagens adjacentes |
| Iluminação | Consistente, sem sombras duras | Nublado ou estúdio difuso |
| Resolução | 12 MP | No mínimo 24 MP |
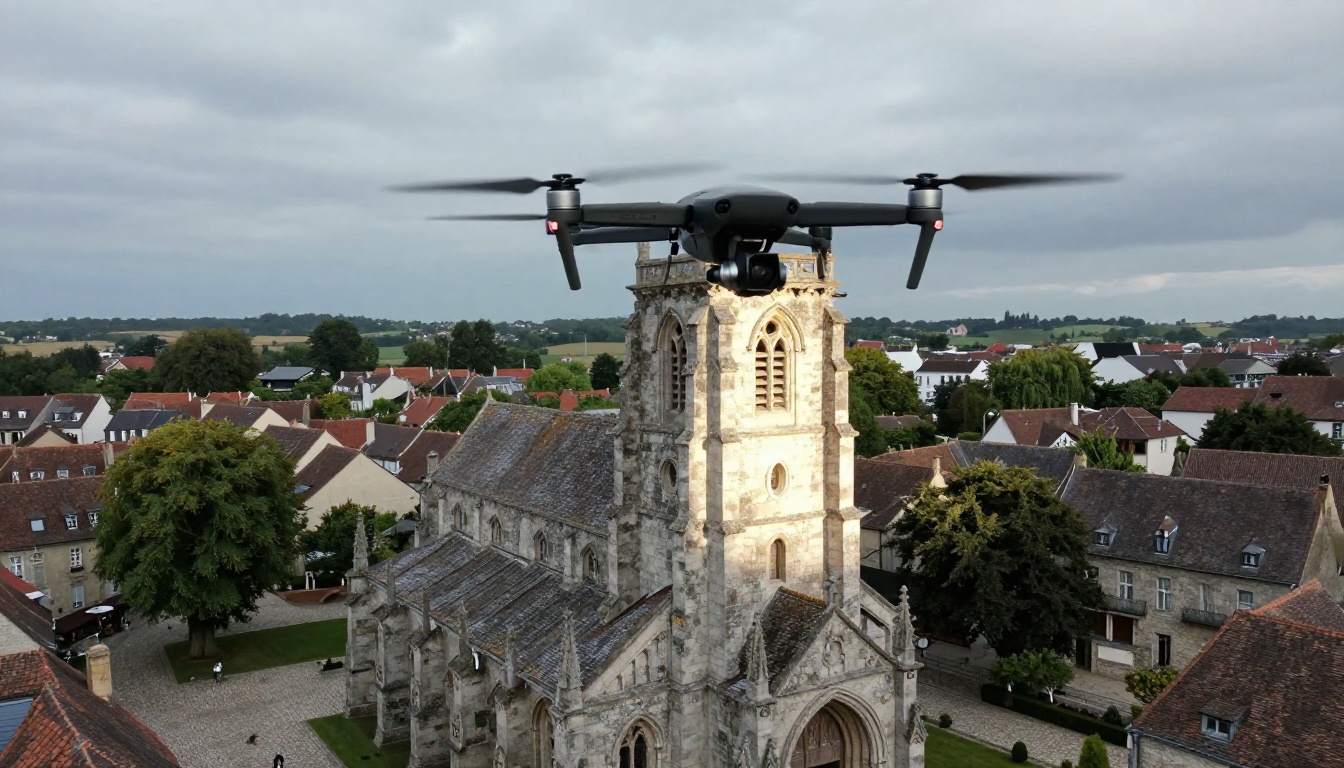
Para assuntos de grande escala (edifícios, sítios arqueológicos, terrenos), a fotogrametria com drone é atualmente o padrão da indústria. Um drone voa seguindo uma grade programada, capturando quadros sobrepostos em cada ponto de passagem. O plano de voo é desenhado para que cada ponto do assunto apareça em pelo menos três ou quatro imagens de ângulos significativamente diferentes, dando ao algoritmo de reconstrução restrições geométricas suficientes para uma triangulação precisa.
💡 Dica de captura: O vento é uma das fontes mais comuns de erro na fotogrametria ao ar livre. Até uma leve trepidação da câmera durante a captura introduz desfoque que atrapalha a correspondência de características. Fotografe em condições calmas ou use uma velocidade de obturação mais rápida para congelar qualquer movimento.
Setores que já usam isso em larga escala
Cirurgia ortopédica e implantes personalizados por paciente
A imagem médica foi uma das primeiras aplicações de alto valor, e já foi muito além do estágio experimental. Cirurgiões ortopédicos usam rotineiramente reconstruções 3D de tomografias para planejar substituições de articulações, escolhendo e posicionando implantes sobre um modelo digital da anatomia real do paciente antes da primeira incisão.
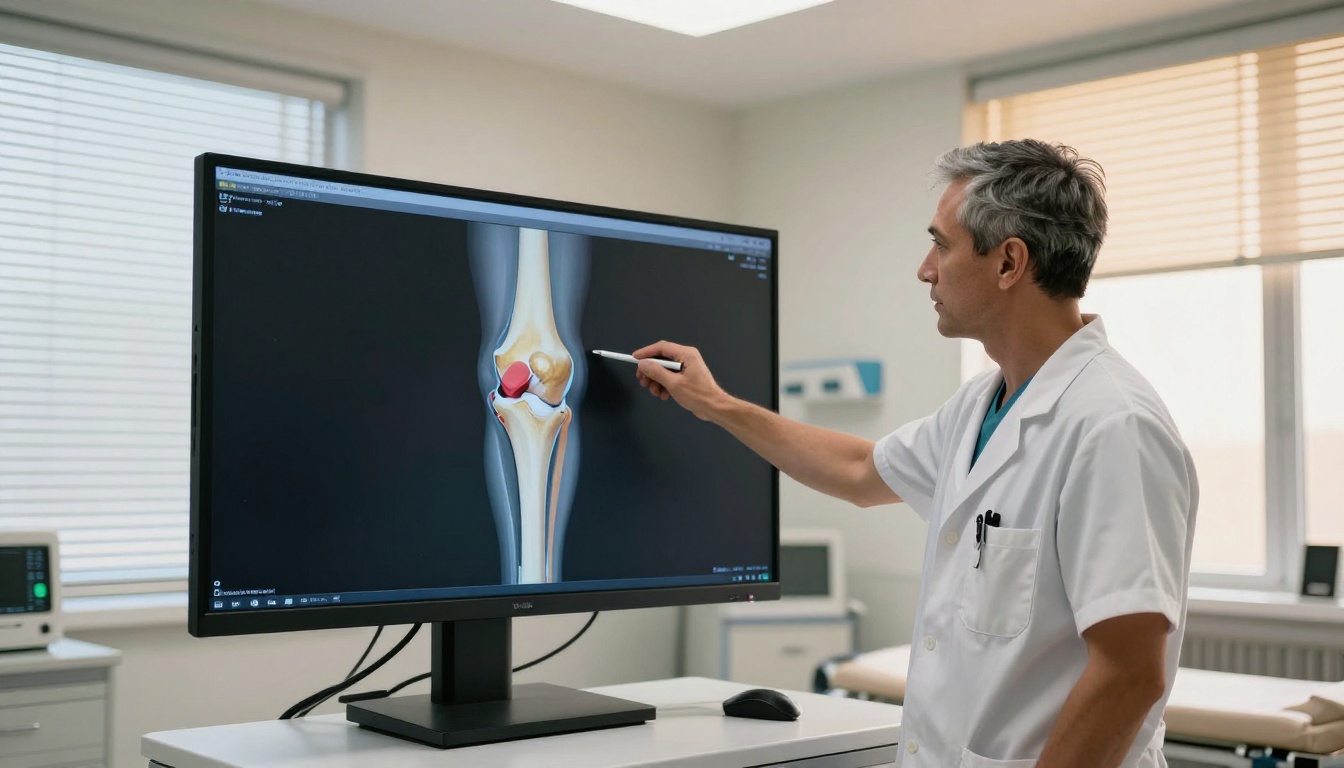
Os implantes personalizados, projetados a partir da anatomia 3D de cada paciente, representam um dos benefícios clínicos mais claros. Uma prótese de quadril padrão, de prateleira, vem em uma faixa limitada de tamanhos. Uma prótese personalizada, modelada a partir da geometria real do osso do paciente, se encaixa com precisão, reduzindo o tempo de operação e melhorando a estabilidade a longo prazo. O modelo 3D que possibilita isso vem de uma tomografia pré-operatória padrão processada por um pipeline de segmentação e reconstrução.
A avaliação de feridas é uma aplicação mais recente que ganha força em ambientes clínicos. Scanners de luz estruturada ou câmeras de profundidade acopladas a celulares comuns conseguem gerar modelos 3D precisos da geometria de feridas, dando aos clínicos medições longitudinais objetivas das dimensões da lesão, em vez de depender de estimativas visuais.
Documentação de arquitetura e patrimônio
Arquitetos e profissionais da preservação foram os primeiros a adotar, e seus casos de uso só se expandiram.
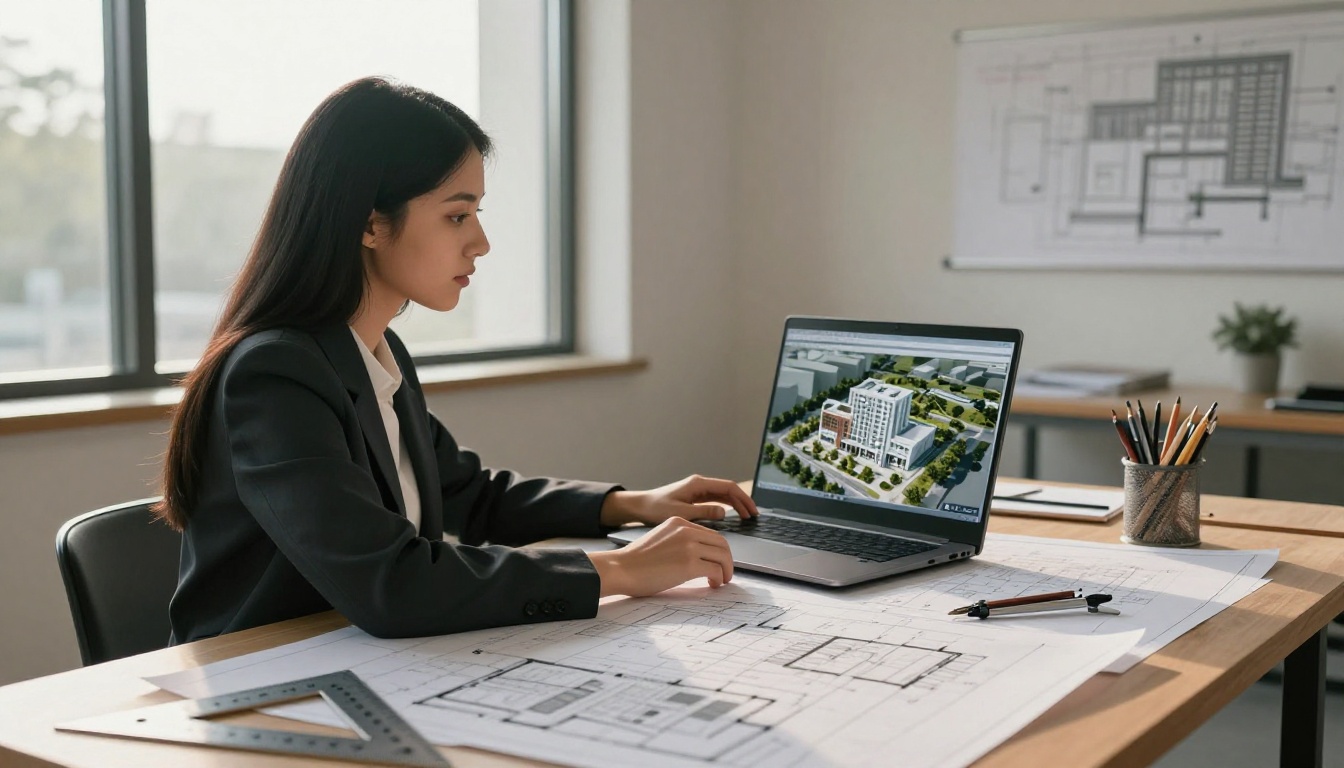
Para a reforma de edifícios existentes, um levantamento com drone produz um modelo 3D com precisão de poucos centímetros, adequado como base para desenhos as-built. O que antes exigia um escaneamento LIDAR caro (muitas vezes de US$ 5.000 a US$ 50.000 por projeto) hoje custa um voo de drone e algumas horas de processamento.
A documentação de patrimônio se beneficia da natureza sem contato do escaneamento fotogramétrico. Sítios arqueológicos frágeis, esculturas danificadas e detalhes arquitetônicos em deterioração podem ser capturados em 3D preciso sem nenhum contato físico, criando um registro digital permanente e uma base de referência para monitorar deteriorações futuras.
Departamentos de planejamento urbano usam modelos 3D de cidades para análise de sombras, avaliação de linhas de visada e visualização do impacto de empreendimentos. Quando uma licença de construção é protocolada, o edifício proposto entra no modelo 3D real da cidade, e os impactos sobre vizinhos e espaços públicos ficam imediatamente visíveis.
Jogos, cinema e ambientes em tempo real
Estúdios de VFX e equipes de desenvolvimento de jogos usam a fotogrametria para criar ativos de alta fidelidade há anos. Escanear adereços físicos, rostos de atores e locações reais de filmagem produz ativos com um nível de detalhe fotográfico que a geração procedural ou a escultura manual não conseguem igualar, na mesma velocidade de produção.
💡 Por que isso importa para jogos: Um único escaneamento fotogramétrico de um muro de pedra real produz um mapa de textura com variação geológica genuína, que nenhum artista de materiais conseguiria replicar com custo razoável à mão. Essa especificidade é o que separa ambientes fotorrealistas daqueles que apenas aproximam a realidade.
A mudança dos últimos anos está em quem pode fazer esse trabalho. Softwares de fotogrametria para o consumidor agora processam vídeos de celular e os transformam em ativos de qualidade de produção, tornando a criação de ativos 3D fotorrealistas acessível a desenvolvedores independentes e pequenos estúdios que antes não tinham orçamento para equipamentos profissionais de escaneamento.
E-commerce e realidade aumentada
O escaneamento de produtos se tornou um fluxo de trabalho comercial importante. Um único escaneamento fotogramétrico de um produto físico gera um modelo 3D a partir do qual as equipes de marketing podem criar qualquer combinação de ângulos de câmera, condições de iluminação e ambientes de contexto, de forma programática, sem fotografias adicionais.
Os aplicativos de prévia de produtos em realidade aumentada levam isso adiante. O app reconstrói a geometria básica do cômodo a partir do fluxo da câmera do celular, posiciona o modelo do produto na escala correta e o renderiza com uma iluminação estimada a partir do ambiente. Quem compra interage com o produto no próprio espaço antes de comprar. Dados de devolução de grandes varejistas mostram de forma consistente que as prévias de produtos em RA reduzem as devoluções de móveis e itens para casa em 25 a 40 por cento.
Aumente a nitidez das fotos de origem antes da reconstrução
💡 A qualidade de qualquer reconstrução tem um teto definido pela qualidade das fotos de entrada. Imagens borradas, com compressão JPEG ou subexpostas introduzem erros de correspondência de características que se acumulam em todas as etapas seguintes do processamento.
A ação de pré-processamento com maior impacto é maximizar a nitidez e a resolução da imagem. Ferramentas de upscaling por IA recuperam detalhes que a compressão ou a pequena falta de nitidez da câmera removeram, dando aos algoritmos de fotogrametria pontos-chave mais confiáveis para trabalhar.
Real ESRGAN é comprovado em pipelines profissionais de reconstrução para restaurar detalhes fotográficos a partir de material comprimido. Ele recupera a textura fina que a compressão JPEG descarta, o que melhora diretamente a precisão da correspondência de características em fluxos de fotogrametria.
Clarity Pro Upscaler adiciona uma etapa de micro-nitidez de precisão que realça a definição das bordas sem os artefatos de halo que a máscara de nitidez tradicional produz. Bordas mais nítidas se traduzem diretamente em uma detecção de características mais precisa.
Para fluxos que exigem isolamento limpo do assunto antes da reconstrução, a ferramenta Remove Background produz recortes sem artefatos, que impedem que os pixels do fundo interfiram na etapa de estimativa de profundidade.
Quando o objetivo é maximizar a resolução de saída depois que a reconstrução estiver concluída, o Image Upscale by Topaz Labs oferece ampliação de até 6x preservando a estrutura fina do grão, útil quando as imagens de origem foram capturadas em equipamentos mais antigos ou em condições limitadas.
O que ainda derruba os sistemas atuais
Apesar do progresso significativo, certos tipos de cena desafiam de forma consistente os métodos atuais:
| Categoria do problema | Causa raiz | Soluções atuais |
|---|
| Objetos transparentes e de vidro | A luz se curva ao atravessá-los, sem textura de superfície para correspondência | Escaneamento de luz estruturada com polarização cruzada |
| Espelhos e superfícies reflexivas | Parecem conter geometria impossível | Tratar como regiões mascaradas e reconstruir a partir do contexto ao redor |
| Estruturas finas (cabelo, fio, folhagem) | Cobertura de pixels insuficiente para uma triangulação precisa | Captura em alta resolução, priors específicos por categoria |
| Superfícies sem textura (paredes brancas, plástico liso) | Nenhum ponto-chave detectável para a correspondência de características | Projetar padrões de luz estruturada sobre a superfície |
| Elementos dinâmicos (pessoas em movimento, objetos levados pelo vento) | Quebra a premissa de cena estática em que todos os métodos com várias imagens se apoiam | Separar primeiro plano e fundo e reconstruí-los de forma independente |
O movimento é, possivelmente, a restrição prática mais difícil. Todo método de reconstrução com várias imagens presume que a cena fica estática enquanto as imagens são capturadas. Uma pessoa trocando o peso do corpo entre as fotos, uma folha movida pelo vento ou uma sombra que muda de posição conforme as nuvens passam criam inconsistências geométricas que corrompem o resultado.
Nos métodos de imagem única, a precisão é limitada pela distribuição dos dados de treino. Objetos ou configurações que o modelo não encontrou o suficiente durante o treinamento produzem geometria implausível em regiões ocultas, onde os priors aprendidos precisam substituir a evidência geométrica real.
A reconstrução de foto para 3D fica na interseção entre visão computacional, aprendizado de máquina e geometria. As barreiras para usar essa tecnologia estão caindo rapidamente, e as aplicações agora vão de aplicativos de celular para o consumidor a sistemas de planejamento cirúrgico usados em hospitais do mundo inteiro.
Se você trabalha em qualquer projeto em que a qualidade da imagem determina a qualidade do resultado, as ferramentas de IA da PicassoIA dão acesso direto aos mesmos modelos de upscaling e processamento de imagem nos quais os pipelines profissionais de 3D se apoiam. Aumente a resolução e restaure suas fotos de origem antes da reconstrução, remova fundos para um isolamento de assunto mais limpo ou leve a resolução de saída ao máximo com o Topaz Image Upscale.
A tecnologia está pronta. Comece com as imagens que você tem e veja o que a IA faz com elas.


