La photo que vous prenez lors d’un dîner entre amis pourrait, avec le bon pipeline d’IA, devenir une scène 3D entièrement navigable. Pas une interprétation artistique de cette scène, mais une reconstruction géométrique précise, où chaque surface a une profondeur mesurable, chaque objet occupe un véritable espace tridimensionnel, et la lumière sur la nappe correspond à des propriétés matérielles réelles. Ce qui rend cela possible, c’est la convergence de trois approches distinctes de l’IA, chacune résolvant une partie différente du problème géométrique, et chacune nettement plus performante que ce qui existait il y a cinq ans.
Ce que fait réellement l’IA de photo vers 3D
C’est de la géométrie, pas de l’art
Quand on entend que l’IA génère des modèles 3D à partir de photos, beaucoup imaginent quelque chose d’artistique : un modèle entraîné sur des jeux de données d’art 3D, qui produit une image donnant l’impression d’être tridimensionnelle. La réalité est plus rigoureuse. L’IA de photo vers 3D est fondamentalement un problème de récupération de géométrie. Le système résout une seule question : étant donné un ensemble de pixels aux valeurs de couleur connues, quelle disposition de surfaces dans l’espace tridimensionnel produirait exactement ces couleurs vues depuis cet angle de caméra ?
Cette question est plus difficile qu’il n’y paraît. La photographie ramène trois dimensions à deux. Toute l’information spatiale (quel objet est le plus proche, quelle orientation a une surface, à quelle distance se trouvent deux points) se réduit à une grille plate de pixels. Retrouver la troisième dimension à partir de cet enregistrement compressé, c’est précisément ce que font ces systèmes d’IA, et la précision actuelle est remarquable.
Les systèmes photo vers 3D les plus avancés peuvent reconstruire des objets avec une précision submillimétrique à partir de captures multi-images, et les méthodes à image unique produisent désormais une géométrie plausible pour les catégories d’objets familières, alors qu’aucune information de profondeur directe n’existe.
La profondeur est la pièce manquante
Tous les algorithmes de reconstruction 3D partagent la même tâche fondamentale : retrouver la profondeur. Un pixel photographique classique indique la couleur et l’intensité lumineuse. Il ne dit pas à quelle distance se trouve ce point de la caméra. L’IA doit déduire cette dimension manquante, soit à partir de relations géométriques entre plusieurs images, soit à partir d’a priori visuels acquis sur une seule image.
Le choix de la méthode dépend des entrées disponibles et du niveau de précision requis. Les méthodes géométriques multi-images sont plus précises. Les méthodes à image unique sont plus rapides et demandent moins d’effort de capture. Les deux sont utilisées, souvent en combinaison.
Les trois technologies à l’origine de cette évolution
La photogrammétrie : toujours la référence en matière de précision
La photogrammétrie est antérieure à l’IA de plusieurs décennies. La méthode est géométrique : on prend plusieurs photos du même objet depuis différentes positions, on repère des caractéristiques visuelles communes à ces photos, puis on utilise les relations géométriques entre ces correspondances pour trianguler la position 3D de chaque point.
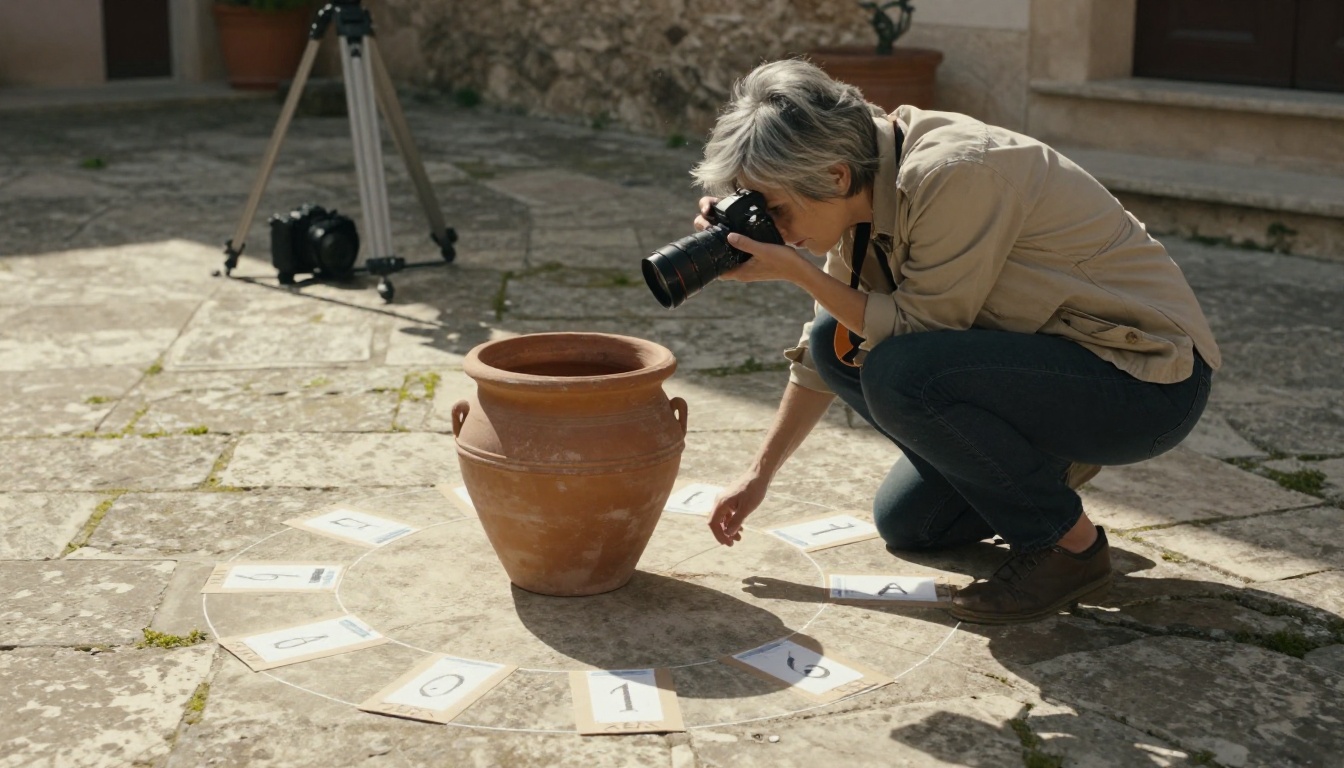
Ce que l’IA moderne a apporté à la photogrammétrie, c’est une accélération et une généralisation. La photogrammétrie traditionnelle exigeait un éclairage contrôlé, des surfaces nettes et riches en détails, et une vérification manuelle de la qualité des correspondances. Les pipelines actuels assistés par l’IA gèrent des objets aux textures répétitives, aux surfaces réfléchissantes et à l’éclairage irrégulier, cas qui auraient complètement mis en échec les anciennes méthodes.
Le pipeline principal se déroule ainsi :
- Extraction de caractéristiques : des réseaux de neurones identifient des points-clés fiables dans chaque image (coins, arêtes, zones de texture distinctives).
- Mise en correspondance : le système trouve quels points-clés d’une image correspondent au même point réel dans une autre.
- Structure from Motion (SfM) : à partir des caractéristiques appariées, l’algorithme estime simultanément les positions de la caméra et celles des points 3D.
- Reconstruction dense : le nuage de points épars issu du SfM est complété par une estimation de profondeur dense sur chaque paire de pixels.
- Génération du maillage : le nuage de points dense est triangulé en une surface continue.
- Projection de la texture : les couleurs des photos d’origine sont reprojetées sur le maillage.
Le résultat d’une photogrammétrie bien exécutée est un maillage 3D texturé qui, pour des sujets correctement capturés, est visuellement indiscernable d’un modèle issu d’un scan physique.
Le nuage de points : la forme brute de la géométrie
Avant qu’un maillage n’existe, il y a un nuage de points. Cette représentation intermédiaire est au cœur de toutes les méthodes de reconstruction multi-images, pas seulement de la photogrammétrie, et la comprendre éclaire le fonctionnement du reste du pipeline.
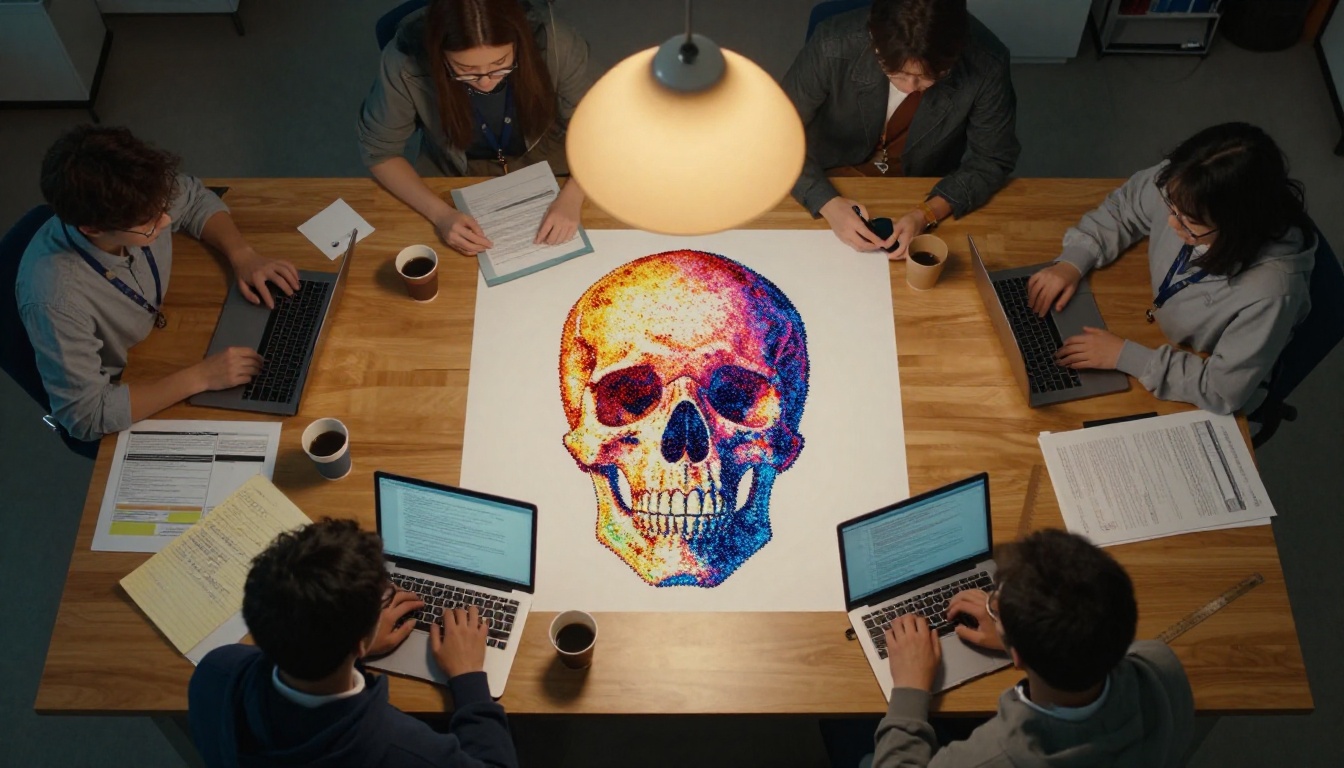
Un nuage de points correspond exactement à ce que son nom indique : des millions (parfois des milliards) de coordonnées 3D individuelles, chacune portant la couleur observée à cet endroit dans les photos sources. Les logiciels de photogrammétrie modernes génèrent couramment des nuages de 50 à 200 millions de points à partir de quelques centaines d’images. À cette densité, le nuage ressemble à un objet plein lorsqu’il est rendu, même avant toute étape de maillage.
L’étape de maillage transforme le nuage non structuré en une surface connectée. Des algorithmes comme la reconstruction de surface de Poisson ou le ball-pivoting ajustent un maillage triangulaire continu à la distribution des points. La qualité de cette étape détermine la façon dont le modèle final gère les structures fines, les arêtes vives et la géométrie concave.
L’estimation de profondeur : la 3D à partir d’une seule image
La photogrammétrie exige plusieurs images. L’estimation de profondeur monoculaire fonctionne avec une seule. C’est la technologie derrière les applications mobiles qui approximent la géométrie d’une pièce à partir d’une seule image vidéo, et elle repose sur des régularités que le modèle a assimilées en s’entraînant sur des millions de paires image-profondeur.
Les modèles d’IA entraînés sur ces données intègrent des indices visuels qui signalent de façon fiable les relations spatiales :
- Perspective atmosphérique : la brume augmente avec la distance, désaturant et adoucissant les objets lointains.
- Perspective linéaire : les lignes parallèles convergent vers des points de fuite à mesure que la distance augmente.
- Occlusion : les objets qui en masquent d’autres occupent un espace plus proche.
- Taille familière : les objets connus fournissent des repères d’échelle implicites.
- Gradient de texture : la texture d’une surface paraît plus fine à plus grande distance.
- Flou de défocalisation : une faible profondeur de champ garde nets les objets proches.
Le résultat est une carte de profondeur : une image en niveaux de gris où la luminosité de chaque pixel encode la distance estimée. Le blanc vif indique le proche, le noir profond le lointain. À partir de cette carte, une surface 3D approximative peut être reconstruite en projetant chaque pixel vers l’extérieur depuis la caméra, à la distance estimée.
L’estimation de profondeur monoculaire produit des profondeurs relatives. Le modèle peut indiquer que le vase est plus proche que la bibliothèque, mais pas la distance exacte de chacun en unités réelles. Pour les applications exigeant une précision métrique, les dispositifs à caméras stéréo ou les capteurs de profondeur dédiés fournissent le facteur d’échelle de calibration nécessaire pour convertir les estimations relatives en mesures absolues.
Les champs de radiance neuronaux : une représentation d’un autre genre
Le NeRF, présenté en 2020, a offert une réponse fondamentalement différente au problème de la photo vers 3D. Plutôt que de reconstruire un maillage et d’y appliquer des textures, un NeRF entraîne un réseau de neurones compact pour représenter la scène elle-même comme une fonction volumétrique continue.
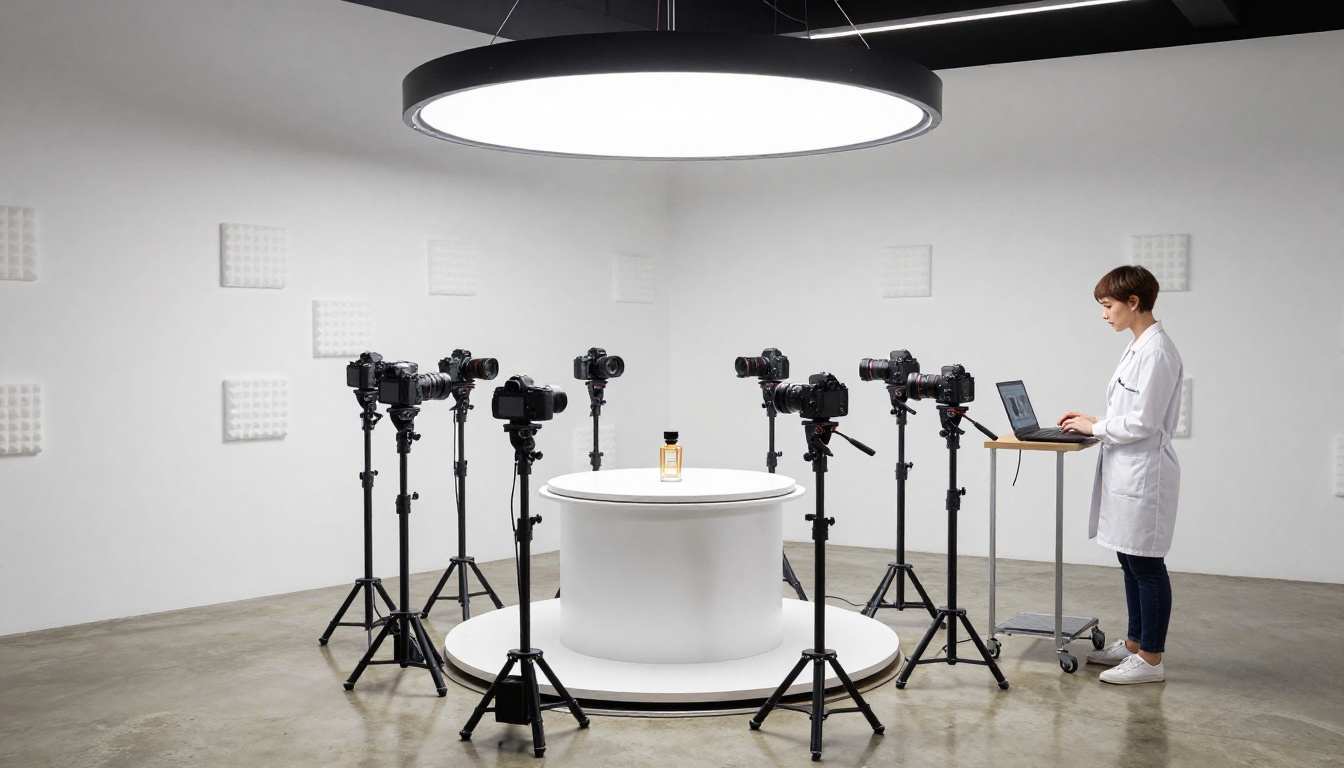
Pour une position 3D et une direction de visée données en entrée, le réseau fournit la couleur et la densité de l’espace à cet endroit. Pour générer une vue, on lance des rayons à travers les pixels d’une caméra virtuelle, on échantillonne le réseau en de nombreux points le long de chaque rayon, puis on compose les résultats en une couleur de pixel. Le réseau s’entraîne sur les mêmes entrées multi-images que la photogrammétrie, mais au lieu d’extraire une géométrie explicite, il assimile une fonction implicite capable de reproduire les vues d’entraînement d’origine et de généraliser à de points de vue entièrement nouveaux.
L’avantage en qualité par rapport à la photogrammétrie traditionnelle a été immédiat dans certains domaines. Les NeRF gèrent naturellement :
- Les reflets spéculaires, qui changent d’aspect selon l’angle de vue
- Les matériaux translucides comme le verre, les liquides et la fumée
- Les structures fines comme les cheveux et le feuillage, qui mettent en échec les algorithmes de maillage
- Une apparence cohérente selon des points de vue inédits, absents des données d’entraînement
La limite initiale était le coût de calcul. Les premiers modèles NeRF nécessitaient des heures d’entraînement pour une seule scène et plusieurs secondes par image pour le rendu. La recherche a depuis largement réduit cet écart. Des méthodes comme Instant-NGP ont ramené le temps d’entraînement à quelques minutes. Le 3D Gaussian Splatting (3DGS), présenté en 2023, permet un rendu en temps réel de haute qualité en représentant les scènes par des millions de gaussiennes 3D orientées plutôt que par un réseau de neurones, ce qui rend possible un aperçu interactif sur du matériel grand public.
Les schémas de capture qui font ou défont les résultats
Pour les méthodes multi-images, la couverture fait toute la différence
La qualité de toute reconstruction multi-images dépend davantage de la manière dont les images ont été capturées que de l’algorithme qui les traite. Un algorithme de pointe avec une mauvaise couverture produit des trous et des erreurs géométriques. Un algorithme solide avec une couverture complète et chevauchante produit un résultat net.
| Élément de capture | Norme minimale | Norme professionnelle |
|---|
| Espacement angulaire | Tous les 20 à 30 degrés | Tous les 10 à 15 degrés |
| Niveaux verticaux | 2 (horizontal + inclinaison vers le haut) | 3 à 4 (dont une prise de vue au nadir, vers le bas) |
| Recouvrement des images | 60 % entre images adjacentes | 80 % entre images adjacentes |
| Éclairage | Constant, sans ombres marquées | Ciel couvert ou studio diffusé |
| Résolution | 12 MP | 24 MP minimum |
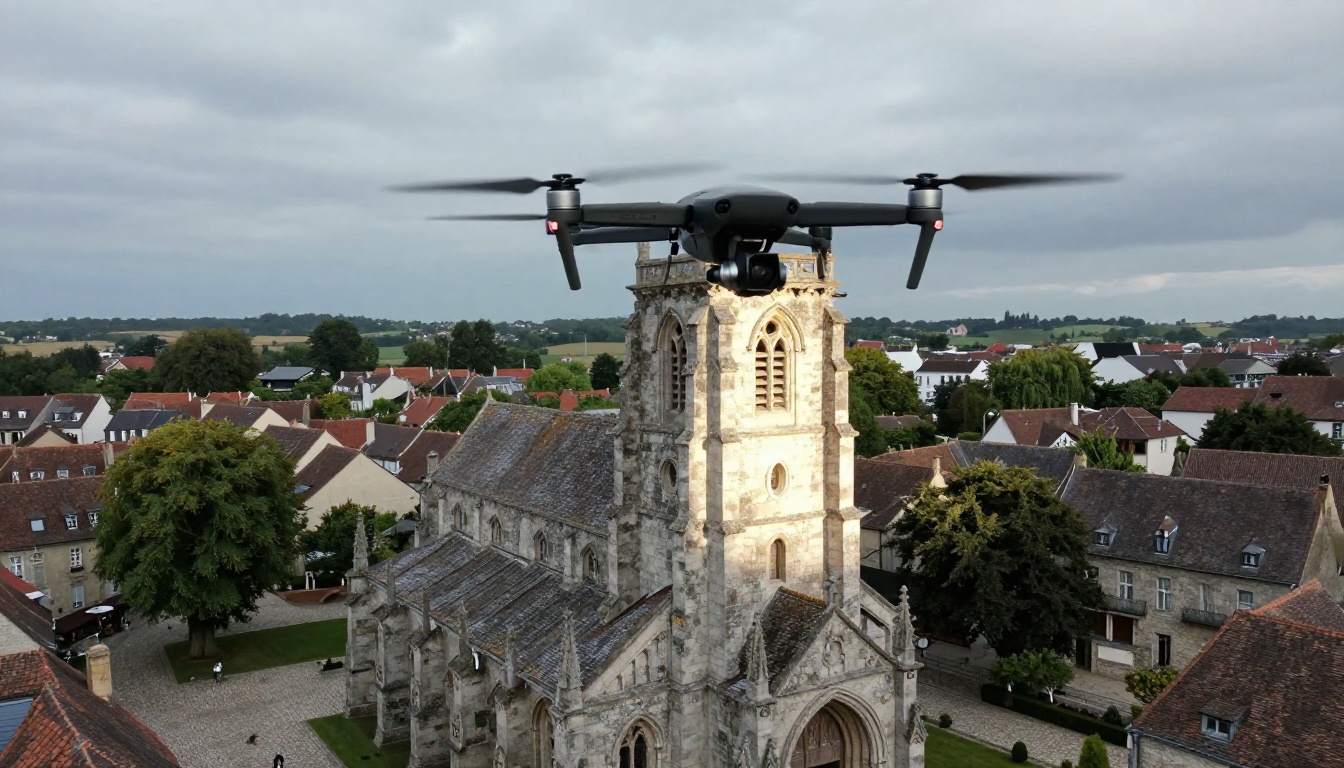
Pour les sujets de grande échelle (bâtiments, sites archéologiques, terrains), la photogrammétrie par drone est aujourd’hui la norme de l’industrie. Un drone suit une grille de vol programmée, capturant des images qui se chevauchent à chaque point de passage. Le plan de vol est conçu pour que chaque point du sujet apparaisse dans au moins trois ou quatre images prises sous des angles réellement différents, ce qui fournit à l’algorithme de reconstruction suffisamment de contraintes géométriques pour une triangulation précise.
💡 Conseil de capture : le vent est l’une des sources d’erreur les plus courantes en photogrammétrie en extérieur. Le moindre tremblement de l’appareil pendant la prise de vue crée un flou qui perturbe la mise en correspondance des caractéristiques. Prenez vos photos par temps calme ou utilisez une vitesse d’obturation plus rapide pour figer tout mouvement.
Des secteurs qui l’utilisent déjà à grande échelle
Chirurgie orthopédique et implants sur mesure
L’imagerie médicale a compté parmi les premières applications à forte valeur, et elle a largement dépassé le stade expérimental. Les chirurgiens orthopédistes utilisent couramment des reconstructions 3D issues de scanners pour planifier les remplacements articulaires, en sélectionnant et en positionnant les implants sur un modèle numérique de l’anatomie réelle du patient, avant la première incision.
Les implants personnalisés conçus à partir de l’anatomie 3D du patient représentent l’un des bénéfices cliniques les plus nets. Une prothèse de hanche standard, disponible sur étagère, existe en un nombre limité de tailles. Une prothèse sur mesure, modélisée à partir de la géométrie osseuse réelle du patient, s’ajuste avec précision, ce qui réduit la durée de l’opération et améliore la stabilité à long terme. Le modèle 3D qui le rend possible provient d’un scanner préopératoire standard, traité par un pipeline de segmentation et de reconstruction.
L’évaluation des plaies est une application plus récente qui gagne du terrain dans les milieux cliniques. Des scanners à lumière structurée ou des caméras de profondeur fixés sur des smartphones standard peuvent générer des modèles 3D précis de la géométrie d’une plaie, offrant aux cliniciens des mesures longitudinales objectives des dimensions, au lieu de s’en remettre à une estimation visuelle.
Architecture et documentation du patrimoine
Les architectes et les spécialistes de la conservation ont été parmi les premiers adoptants, et leurs cas d’usage n’ont fait que s’étendre.
Pour la rénovation d’un bâtiment existant, un relevé par drone produit un modèle 3D précis à quelques centimètres près, utilisable comme base pour les plans de récolement. Ce qui exigeait auparavant un scan LIDAR coûteux (souvent entre 5 000 et 50 000 $ par projet) ne coûte plus qu’un vol de drone et quelques heures de traitement.
La documentation du patrimoine profite de la nature sans contact du scan photogrammétrique. Les sites archéologiques fragiles, les sculptures endommagées et les détails architecturaux en détérioration peuvent être capturés en 3D précise sans aucun contact physique, ce qui crée un enregistrement numérique permanent et une référence pour suivre les dégradations futures.
Les services d’urbanisme utilisent des modèles de villes en 3D pour l’analyse des ombres, l’évaluation des lignes de visibilité et la visualisation de l’impact des projets. Lorsqu’un permis de construire est déposé, le bâtiment projeté s’insère dans le modèle 3D réel de la ville, rendant immédiatement visibles les effets sur les voisins et les espaces publics.
Jeux vidéo, cinéma et environnements en temps réel
Les studios d’effets visuels et les équipes de développement de jeux utilisent la photogrammétrie pour créer des assets haute fidélité depuis des années. Scanner des accessoires physiques, des visages d’acteurs et de vrais lieux de tournage produit des assets dotés d’un niveau de détail photographique que la génération procédurale ou la sculpture manuelle ne peuvent égaler à vitesse de production comparable.
💡 Pourquoi c’est important pour les jeux : un seul scan photogrammétrique d’un vrai mur en pierre produit une carte de texture présentant de véritables variations géologiques, qu’aucun artiste de matériaux ne pourrait reproduire à la main de façon rentable. Cette précision est ce qui distingue les environnements photoréalistes de ceux qui ne font qu’approximer la réalité.
Le changement de ces dernières années concerne surtout qui peut réaliser ce travail. Les logiciels de photogrammétrie grand public traitent désormais des séquences filmées au smartphone pour produire des assets de qualité professionnelle, rendant la création d’assets 3D photoréalistes accessible aux développeurs indépendants et aux petits studios, qui ne disposaient pas auparavant du budget nécessaire pour des installations de scan professionnelles.
E-commerce et réalité augmentée
Le scan de produits est devenu un flux de travail commercial important. Un seul scan photogrammétrique d’un produit physique donne un modèle 3D à partir duquel les équipes marketing peuvent générer, de façon programmée et sans nouvelle séance photo, n’importe quelle combinaison d’angles de caméra, de conditions d’éclairage et d’environnements.
Les applications d’aperçu de produits en réalité augmentée vont plus loin. L’application reconstruit la géométrie de base de la pièce à partir du flux de la caméra du téléphone, place le modèle du produit à la bonne échelle et le rend avec un éclairage estimé à partir de l’environnement. Les acheteurs peuvent interagir avec un produit dans leur propre espace avant de l’acheter. Les données de retours de grands distributeurs montrent de façon constante que les aperçus de produits en réalité augmentée réduisent les retours de 25 à 40 % pour les meubles et les articles de maison.
Affûtez vos photos sources avant la reconstruction
💡 La qualité de toute reconstruction est strictement limitée par la qualité des photos d’entrée. Des images floues, compressées en JPEG ou sous-exposées introduisent des erreurs de mise en correspondance qui s’accumulent à chaque étape du traitement.
L’action de prétraitement la plus efficace consiste à maximiser la netteté et la résolution des images. Les outils d’upscaling (augmentation de la résolution) par IA restaurent les détails que la compression ou un léger flou de l’appareil ont effacés, ce qui fournit aux algorithmes de photogrammétrie des données de points-clés plus fiables.
Real ESRGAN a fait ses preuves dans les pipelines de reconstruction professionnels pour restaurer les détails photographiques à partir de sources compressées. Il récupère les fines textures que la compression JPEG élimine, ce qui améliore directement la précision de la mise en correspondance dans les flux de photogrammétrie.
Clarity Pro Upscaler ajoute une passe de micro-accentuation de précision qui renforce la définition des contours sans les artefacts de halo que produit le masquage flou traditionnel. Des contours plus nets se traduisent directement par une détection de caractéristiques plus précise.
Pour les flux de travail nécessitant une isolation nette du sujet avant la reconstruction, Remove Background produit des détourages sans artefacts, qui empêchent les pixels de l’arrière-plan de perturber l’étape d’estimation de profondeur.
Lorsque l’objectif est de maximiser la résolution de sortie une fois la reconstruction terminée, Image Upscale by Topaz Labs permet un agrandissement jusqu’à 6x tout en préservant la structure fine du grain, utile lorsque les images sources ont été capturées avec un matériel plus ancien ou dans des conditions contraintes.
Ce qui met encore en difficulté les systèmes actuels
Malgré des progrès importants, certains types de scènes posent systématiquement problème aux méthodes actuelles :
| Catégorie de problème | Cause profonde | Solutions de contournement actuelles |
|---|
| Objets transparents et en verre | La lumière se courbe en les traversant, sans texture de surface à apparier | Scan à lumière structurée en polarisation croisée |
| Miroirs et surfaces réfléchissantes | Semblent contenir une géométrie impossible | Traiter comme des zones masquées, reconstruire à partir du contexte environnant |
| Structures fines (cheveux, fils, feuillage) | Couverture de pixels insuffisante pour une triangulation précise | Capture haute résolution, a priori propres à chaque catégorie |
| Surfaces sans texture (murs blancs, plastique lisse) | Aucun point-clé détectable pour la mise en correspondance | Projeter des motifs à lumière structurée sur la surface |
| Éléments dynamiques (personnes en mouvement, objets soufflés par le vent) | Rompt l’hypothèse de scène statique sur laquelle reposent toutes les méthodes multi-images | Séparer premier plan et arrière-plan, reconstruire chacun séparément |
Le mouvement est sans doute la contrainte pratique la plus difficile. Toutes les méthodes de reconstruction multi-images supposent que la scène reste immobile pendant la prise de vues. Une personne qui change de poids entre deux clichés, une feuille déplacée par le vent ou une ombre qui se déplace au passage des nuages créent des incohérences géométriques qui altèrent le résultat.
Pour les méthodes à image unique, la précision est bornée par la distribution des données d’entraînement. Les objets ou configurations que le modèle a trop peu rencontrés pendant l’entraînement produisent une géométrie invraisemblable dans les zones occultées, là où les a priori appris doivent se substituer à de véritables indices géométriques.
Commencez à créer avec les outils d’IA de PicassoIA
La reconstruction photo vers 3D se situe à l’intersection de la vision par ordinateur, de l’apprentissage automatique et de la géométrie. Les obstacles à l’utilisation de cette technologie tombent rapidement, et ses applications vont désormais des applications mobiles grand public aux systèmes de planification chirurgicale utilisés dans les hôpitaux du monde entier.
Si vous travaillez sur un projet où la qualité de l’image détermine la qualité du résultat, les outils d’IA de PicassoIA vous donnent un accès direct aux mêmes modèles d’upscaling et de traitement d’image que les pipelines 3D professionnels utilisent. Augmentez et restaurez vos photos sources avant la reconstruction, supprimez les arrière-plans pour une isolation plus propre du sujet, ou poussez la résolution de sortie à son maximum avec Topaz Image Upscale.
La technologie est prête. Partez des images que vous avez et voyez ce que l’IA en fait.


