Cuando la IA genera el fotograma 1 de tu personaje de anime y el fotograma 47 parece una persona completamente distinta, no es un simple fallo técnico. Has topado con el problema más difícil de la animación con IA: la coherencia de estilo entre fotogramas.
Esto no es una molestia menor. Rompe toda la ilusión. El contenido de anime hecho con IA suele verse entrecortado, inestable o "inquietante" no porque cada fotograma se vea mal por separado, sino porque los fotogramas consecutivos no parecen pertenecer al mismo mundo.
Entonces, ¿cómo resuelven los mejores sistemas de IA este problema? ¿Y qué herramientas de PicassoIA lo hacen bien?
Por qué cada fotograma quiere ser distinto
El problema de fondo es que la mayoría de los modelos de difusión de imágenes no tienen memoria.
Cada fotograma se genera a partir de una semilla de ruido, guiada por tu prompt. Cuando generas el fotograma 2, el modelo no "recuerda" cómo era el fotograma 1. Simplemente sigue el prompt otra vez. Y aun con prompts idénticos, los modelos de difusión son estocásticos: una pequeña variación en la distribución del ruido produce proporciones de personaje, grosores de línea, saturación de color o detalle de cabello visiblemente distintos.
Cómo se ve la deriva en la práctica
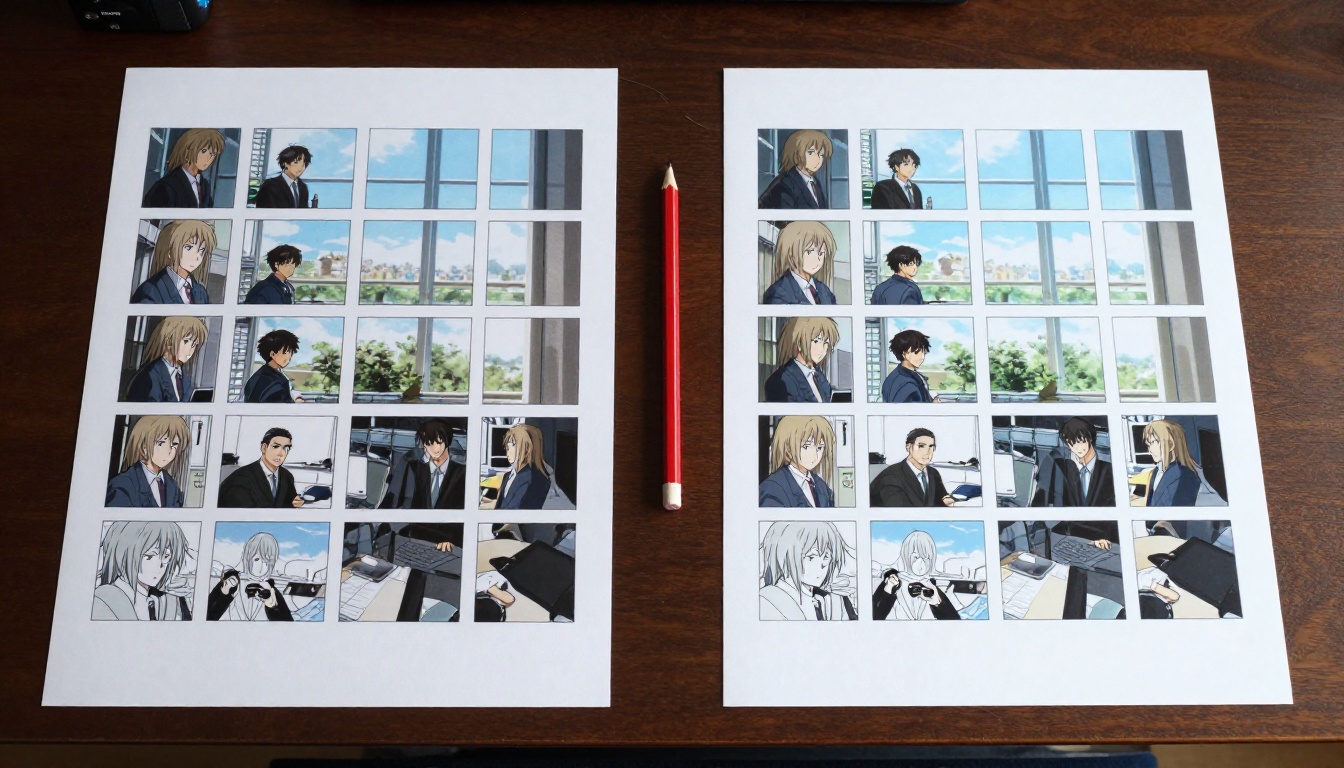
La deriva de estilo en el anime generado con IA suele aparecer en tres lugares:
- Rasgos del personaje: Los ojos cambian de forma o tamaño. El color del cabello varía un 10-15%. El tono de piel se calienta o se enfría entre fotogramas.
- Grosor de línea: El grosor del contorno que define la estética anime varía de forma impredecible cuando el modelo muestrea la distribución del ruido.
- Coherencia de la paleta de color: Los colores del fondo "respiran": cambian sutilmente en saturación o tono aunque nada de la escena debería cambiar.
El resultado es lo que los animadores llaman incoherencia temporal: fotogramas que se ven bien por separado, pero mal como secuencia.
Por qué importa más en el anime que en la imagen real
La generación de video con imagen real tiene cierta indulgencia natural. Un ligero cambio de tono en la piel se interpreta como un cambio de iluminación. Pero el anime se basa en sistemas visuales muy codificados: un personaje concreto tiene una paleta concreta, un estilo de línea concreto, una forma de ojos concreta. Cualquier desviación se percibe de inmediato como "otro personaje" y no como "otra iluminación".
Este es el reto de coherencia que separa las buenas herramientas de anime con IA de las excelentes.
Cómo codifican el estilo las redes neuronales
Para entender cómo funcionan los mejores sistemas de coherencia, hay que entender qué hace un modelo de difusión cuando genera un personaje de anime.
El espacio latente y el estilo como coordenada
Cada imagen que genera un modelo de difusión existe como un punto en el espacio latente: una representación matemática comprimida del mundo visual que el modelo procesó durante el entrenamiento. El estilo de un personaje no se guarda como un conjunto de reglas explícitas ("usa #F5D5A8 para la piel"). Es un conjunto de coordenadas en un espacio de alta dimensión.
Cuando un prompt dice "chica anime, pelo largo negro, uniforme escolar", el modelo muestrea la región del espacio latente asociada a esa descripción. Pero esa región es amplia. Hay miles de interpretaciones válidas de ese prompt, y el modelo elige una según la semilla de ruido.
Por eso el control de la semilla es una primera herramienta básica para la coherencia de estilo. Fijar la semilla mantiene más o menos estable el punto de muestreo. Pero el control de la semilla por sí solo falla en cuanto cambian el ángulo de cámara, la iluminación o el movimiento, porque cualquier cambio empuja al modelo a otra zona del mismo grupo.
Cómo lee el modelo el estilo visual
La idea clave es que los sistemas de coherencia más recientes no se limitan a controlar el prompt. Controlan directamente el embedding de estilo, inyectando coordenadas latentes concretas como señales de guía para que el modelo no pueda alejarse demasiado de ellas. Este es el mecanismo que hay detrás de IP-Adapter, el condicionamiento por imagen de referencia y técnicas parecidas que herramientas de PicassoIA como ToonCrafter y AnimateDiff Prompt Travel aprovechan internamente.
En lugar de esperar que el prompt sea lo bastante preciso para reproducir el mismo estilo, estas herramientas fijan el embedding de estilo de una imagen de referencia y lo usan como señal constante durante toda la generación. La salida del modelo se mantiene anclada porque el ancla se aplica matemáticamente, no solo se sugiere con texto.
Modelos LoRA: el bloqueo de precisión para personajes
La herramienta más fiable para fijar un personaje anime concreto en muchos fotogramas es una LoRA (Low-Rank Adaptation). Entender cómo funciona LoRA explica por qué produce resultados tan estables.
Qué cambia realmente LoRA
Un modelo de difusión estándar tiene miles de millones de parámetros: los pesos numéricos que definen cómo transforma el ruido en imágenes. LoRA no reentrena el modelo completo. En su lugar, inyecta un pequeño conjunto de matrices de desplazamiento aprendidas que empujan la atención del modelo hacia patrones visuales concretos.
Piénsalo como darle al modelo base unas gafas calibradas para un solo personaje. Cada vez que "mira" el espacio de generación, ve con más claridad las proporciones, la paleta y el trazo de ese personaje. El modelo base sigue encargándose de todo lo demás (iluminación, composición, fondo), pero los rasgos del personaje se alinean de forma fiable.
Qué pasa con la coherencia entre fotogramas
Cuando usas una LoRA entrenada con un personaje concreto y generas fotogramas con prompts distintos (el personaje corriendo, sentado, mirando a la izquierda), las matrices de desplazamiento de la LoRA mantienen estables los rasgos que definen al personaje. Las proporciones del rostro, el color del cabello y los detalles del vestuario se mantienen anclados aunque la pose cambie mucho.
Por eso los flujos de trabajo profesionales de anime con IA siempre empiezan con LoRA de personaje. Sin una, dependes solo de la ingeniería de prompts, y eso produce deriva visible a gran escala.
💡 Consejo práctico: Una LoRA de personaje bien entrenada necesita al menos 15-20 imágenes de referencia de alta calidad que muestren al personaje desde distintos ángulos. Cuantas más imágenes, mejor distingue la LoRA qué rasgos definen al personaje (forma de los ojos, longitud del cabello) y cuáles son accidentales (color de fondo, pose).
AnimateDiff y el problema del tiempo
La coherencia estática y la coherencia temporal son problemas distintos. Una LoRA asegura que el fotograma 1 y el fotograma 47 parezcan el mismo personaje. Pero AnimateDiff Prompt Travel aborda algo más difícil: que la transición entre fotogramas sea fluida y coherente en cuanto al estilo.
El módulo de movimiento: qué es realmente
AnimateDiff añade un módulo de atención temporal al pipeline estándar de generación de imágenes. Los transformadores de imagen normales atienden a relaciones espaciales dentro de un solo fotograma. El módulo temporal atiende a relaciones entre fotogramas, mirando lo que vino antes y después al generar cualquier fotograma.
Este cambio de arquitectura es importante. El modelo ya no genera cada fotograma de forma independiente. Genera los fotogramas como una secuencia, con cada fotograma condicionado por las representaciones latentes de los fotogramas adyacentes. El resultado es un movimiento que respeta la continuidad.
Prompt travel: controlar el estilo a lo largo del tiempo
AnimateDiff Prompt Travel amplía esto permitiéndote especificar prompts distintos para cada fotograma clave, mientras el módulo de movimiento interpola la transición. En trabajos de coherencia con anime, esto significa que puedes fijar un prompt de estilo en el fotograma 1 ("personaje anime, pelo oscuro, luz cálida de tarde, de pie") y otro en el fotograma 24 ("mismo personaje, mismo estilo, pose distinta"), y el sistema mantiene la coherencia visual a lo largo de la interpolación.
La coherencia viene de la ruta latente compartida: como todos los fotogramas pasan por las mismas capas de atención temporal, heredan las mismas estadísticas de estilo.
El papel de ControlNet como ancla de estilo
ControlNet no añade coherencia recordando el estilo. La añade controlando la estructura. Cuando generas un fotograma de personaje anime con una condición de bordes canny de ControlNet, le estás diciendo al modelo: no cambies la forma de las cosas.
Cómo los bordes canny bloquean la composición
Un mapa de bordes canny extrae la estructura de contornos de un fotograma de referencia. Cuando este mapa se usa como condición de ControlNet, cada fotograma generado tiene que coincidir con esa estructura de bordes. La IA puede variar el color y la textura, pero la silueta, las proporciones y las posiciones de los rasgos principales quedan ancladas.
En el anime en concreto, esto es potente, porque el estilo anime está definido en gran medida por su trazo. Si las líneas no cambian, la mayor parte de lo que hace que el anime "parezca anime" se mantiene estable a lo largo de toda la secuencia.
Mapas de profundidad para la coherencia espacial
El condicionamiento de profundidad de ControlNet funciona de forma parecida, pero para la disposición tridimensional. Un mapa de profundidad extraído del fotograma 1 define dónde están los objetos cercanos y los lejanos. Aplicar este mapa a los fotogramas siguientes mantiene las relaciones espaciales coherentes aunque el personaje se mueva, evitando que el fondo salte en profundidad percibida de un fotograma a otro.
Herramientas como ControlVideo en PicassoIA aplican este principio a lo largo de secuencias de video, manteniendo la coherencia estructural de un fotograma a otro con mapas de control extraídos.
Modelos de PicassoIA diseñados para la coherencia
Aquí la teoría se pone en práctica. Estas son las herramientas concretas de PicassoIA que gestionan directamente la coherencia del estilo anime.
AnimateDiff Prompt Travel
AnimateDiff Prompt Travel es lo más parecido que hay a un motor de coherencia específico para anime. El módulo de atención temporal se entrenó específicamente con contenido animado, lo que lo hace especialmente eficaz para mantener la estética de anime, con sombreado plano tipo cel y alto contraste, a lo largo de las secuencias de movimiento.
ToonCrafter
ToonCrafter se diseñó para animar ilustraciones: le das dos fotogramas clave y ToonCrafter genera los fotogramas intermedios conservando el estilo visual de ambas imágenes de entrada. Para trabajos de anime, es ideal en escenas con cambios de pose muy marcados. La coherencia del modelo viene de estar condicionado explícitamente por los dos fotogramas ancla a la vez.
ControlVideo
ControlVideo aplica el condicionamiento de ControlNet a lo largo de una secuencia de video. Acepta un video de origen o una secuencia de imágenes y usa los mapas estructurales extraídos para guiar la generación, lo que lo hace especialmente eficaz cuando tienes un movimiento de referencia que necesita reorientarse estilísticamente hacia la estética anime.
Kling v3 Motion Control
Kling v3 Motion Control gestiona la coherencia con un mecanismo distinto: la planificación explícita de trayectorias. Antes de generar los fotogramas, el modelo traza la ruta de movimiento de los objetos y personajes clave, y después genera cada fotograma sujeto a esa trayectoria. Los rasgos del personaje se mantienen estables porque el modelo sabe dónde debe estar cada parte del personaje en cada momento.
Wan 2.7 I2V
Wan 2.7 I2V (imagen a video) destaca por conservar el estilo de una única imagen de origen a lo largo de una secuencia animada. Como la imagen de origen se usa como fotograma de condicionamiento, las salidas del modelo quedan ancladas a sus estadísticas visuales: color, textura, trazo y disposición espacial.
P Video Animate
P Video Animate toma una foto o ilustración estática y la anima en un clip corto, manteniendo intactas las características visuales de la imagen de origen. Como el origen se integra en la generación como referencia directa, la identidad del personaje se conserva durante el movimiento.
| Modelo | Método de coherencia | Ideal para |
|---|
| AnimateDiff Prompt Travel | Módulos de atención temporal | Secuencias largas con prompts cambiantes |
| ToonCrafter | Interpolación de dos fotogramas clave | Clips cortos entre poses definidas |
| ControlVideo | Mapas estructurales de ControlNet | Redirección de movimiento con transferencia de estilo |
| Kling v3 Motion Control | Planificación de trayectorias | Secuencias de acción centradas en personajes |
| Wan 2.7 I2V | Condicionamiento por imagen de origen | Animar un solo fotograma de referencia |
| P Video Animate | Condicionamiento directo por imagen de origen | Dar vida a arte anime estático |
Cómo usar PicassoIA para un estilo de anime coherente
Este es un flujo de trabajo práctico en cuatro pasos para conseguir un estilo de anime coherente con el conjunto de herramientas de PicassoIA.
Paso 1: crea tu base de referencia
Genera tu fotograma ancla con un modelo de texto a imagen. Este es el aspecto "canónico" de tu personaje. Guarda la URL de la salida; será tu referencia para cada paso de generación posterior. Genera de 3 a 4 variaciones del mismo personaje en poses neutras ligeramente distintas y elige la que mejor represente el estilo que buscas.
Paso 2: elige tu herramienta de coherencia
Para clips cortos (2-5 segundos): usa ToonCrafter con tu pose inicial y final como los dos fotogramas clave. La interpolación quedará anclada estilísticamente a ambos.
Para secuencias largas (10 segundos o más): usa AnimateDiff Prompt Travel con prompts de fotogramas clave que mantengan los descriptores del personaje constantes a lo largo de toda la secuencia.
Para secuencias de acción con trayectorias de movimiento concretas: usa Kling v3 Motion Control o Wan 2.7 I2V para animar tu imagen de origen con una trayectoria guiada.
Paso 3: escala y pule
Cuando tengas una secuencia coherente, usa P Image Upscale o Clarity Pro Upscaler para mejorar la nitidez de los fotogramas individuales sin introducir nueva variación de estilo. Aplicar el escalado después de generar es más seguro que hacerlo durante la generación: conserva la coherencia que ya has conseguido.
En las secuencias de video, Real ESRGAN Video aplica superresolución a todo el clip a la vez, manteniendo el afilado fotograma a fotograma sin añadir deriva.
Paso 4: edita y refina los fotogramas problemáticos
Si ciertos fotogramas se desvían pese a tus herramientas de coherencia, P Video Edit te permite apuntar a secciones concretas con prompts de texto, reescribiendo solo los fotogramas problemáticos y dejando intacto el resto. Aleph 2 funciona de forma parecida: propaga las ediciones hechas en un fotograma a toda la secuencia.
Cuando la IA sigue fallando
Incluso con todos estos sistemas, la deriva de estilo no está del todo resuelta. Estos son los casos en los que sigue fallando y qué hacer al respecto.
Los 3 modos de fallo más comunes
1. Transiciones de mucho movimiento: Cuando un personaje se mueve muy rápido entre fotogramas clave, los módulos de atención temporal a veces dan prioridad a la coherencia del movimiento frente a la coherencia de estilo. El personaje llega a la pose correcta, pero con proporciones de rostro ligeramente distintas. Solución: reduce la magnitud del movimiento en tu prompt o divide la secuencia en subclips más cortos con fotogramas de anclaje solapados.
2. Filtración de color del fondo al personaje: Cuando el fondo contiene mucha información de color (cielo brillante, entornos vivos, patrones complejos), ese color puede "filtrarse" a la paleta del personaje a través de la atención cruzada del modelo. El cabello o el vestuario del personaje adquieren un matiz sutil de los elementos del fondo cercanos. Solución: usa un fondo neutro o desenfocado en tu fotograma de origen y en tus prompts de condicionamiento.
3. Pesos de LoRA en conflicto: Cuando usas dos LoRA a la vez (una para el personaje y otra para el estilo general), los pesos pueden entrar en conflicto y producir resultados comprometidos. El personaje se ve "lavado" o el estilo se aplana hacia un promedio genérico. Solución: reduce el peso de la LoRA secundaria a 0,6-0,7 y sube la LoRA primaria del personaje a 0,9-1,0.
Cómo detectar la filtración de estilo antes de que arruine una secuencia
Revisa estas tres cosas entre fotogramas antes de aceptar una generación:
- Simetría de los ojos: En el anime, un render asimétrico de los ojos entre fotogramas es una señal clara de deriva. Si los ojos se ven de distinto tamaño o forma de un fotograma a otro, hay deriva.
- Muestreo del peso de línea: Elige 5 fotogramas al azar y compara el grosor del trazo en la misma zona. Más de un 20% de variación significa deriva visible en movimiento.
- Muestreo de la paleta: Usa un cuentagotas de color sobre el cabello del personaje en tres fotogramas. Si el valor hexadecimal cambia más de 15 puntos en cualquier canal, espera una deriva de color visible durante la reproducción.
Estas comprobaciones rápidas tardan segundos, pero detectan la mayoría de los problemas de coherencia antes de que se acumulen a lo largo de una secuencia completa.
Crea tu propio contenido de anime coherente
La tecnología para la coherencia del estilo anime ya está aquí, de verdad. Usadas correctamente, las herramientas disponibles en PicassoIA producen resultados que, hechos a mano, habrían requerido semanas de trabajo de un gran equipo de animación tradicional.
La verdadera ventaja no es solo la velocidad. Es la capacidad de iterar: puedes generar 50 variaciones de una escena en el tiempo que tardarías en dibujar a mano una sola, usando los sistemas de coherencia descritos aquí para descartar las desviaciones y mantener la calidad constante de principio a fin.
Empieza con una única imagen ancla. Construye a partir de ahí usando la herramienta adecuada para la duración de tu secuencia y el tipo de movimiento. Si ves deriva, corrígela desde el origen, con pesos de LoRA más ajustados, mejor condicionamiento de referencia o edición de video específica con P Video Edit.
💡 El camino más rápido para obtener un anime coherente: genera tu fotograma ancla, anímalo con P Video Animate y escala el resultado con Clarity Pro Upscaler. Ese proceso de tres pasos tarda menos de cinco minutos y produce un clip coherente y de alta resolución a partir de cualquier imagen de referencia.
El catálogo completo de modelos de PicassoIA cubre cada etapa de este flujo de trabajo: desde la generación inicial de imágenes hasta la coherencia temporal, el escalado y la edición de video. Elige tu personaje, elige tu herramienta y comprueba lo estable que puedes hacerlo.


