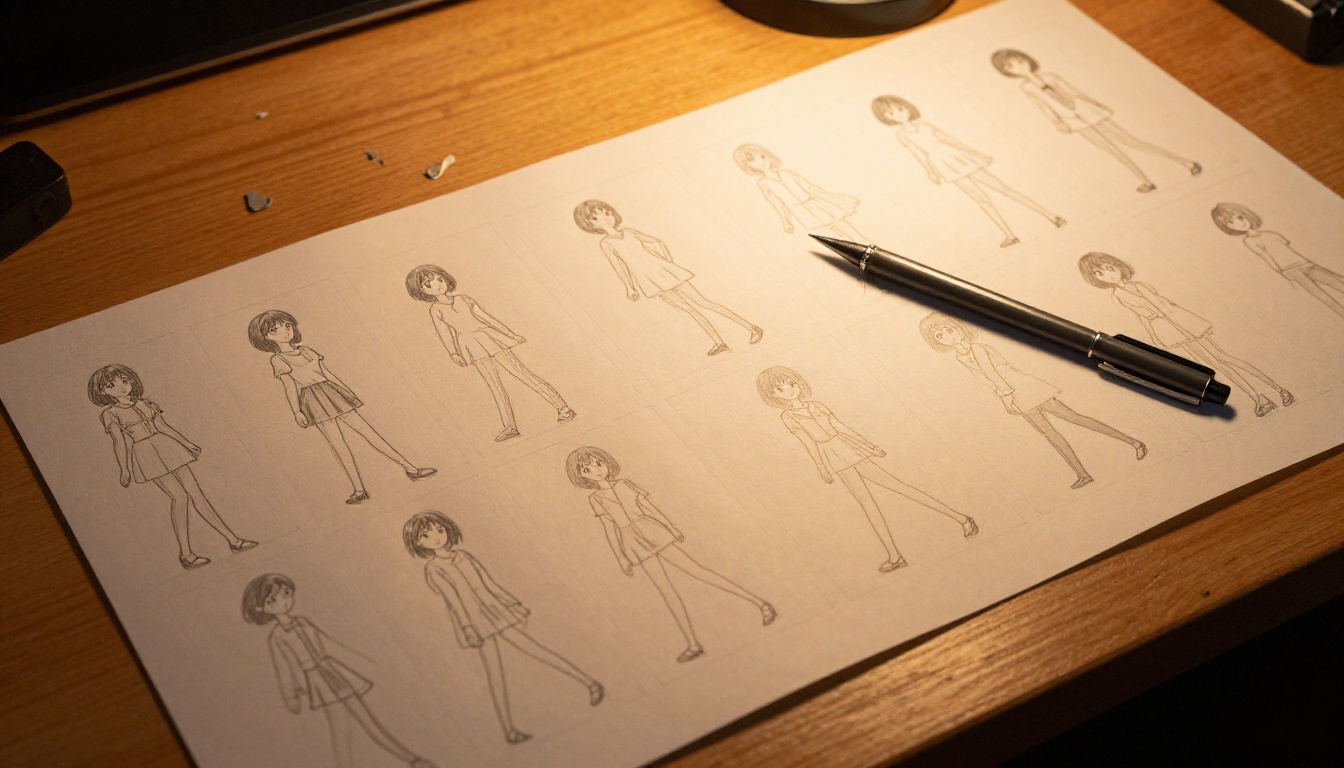
Quand l’IA génère l’image 1 de votre personnage anime et que l’image 47 montre une personne complètement différente, vous ne tombez pas sur un simple bug technique. Vous êtes face au problème le plus difficile de l’animation pilotée par IA : la cohérence du style d’une image à l’autre.
Ce n’est pas un simple désagrément. Cela brise toute l’illusion. Si le contenu anime généré par IA paraît souvent saccadé, instable ou « dérangeant », ce n’est pas parce que les images prises une à une sont mauvaises. C’est parce que des images consécutives ne donnent pas l’impression d’appartenir au même univers.
Alors, comment les meilleurs systèmes d’IA résolvent-ils ce problème ? Et quels outils de PicassoIA y parviennent ?
Pourquoi chaque image veut être différente
Le problème de fond vient du fait que la plupart des modèles de diffusion d’images n’ont aucune mémoire.
Chaque image est générée à partir d’une seed de bruit, guidée par votre prompt. Lorsque vous générez l’image 2, le modèle ne « se souvient » pas de l’apparence de l’image 1. Il suit simplement le prompt une nouvelle fois. Et même avec des prompts identiques, les modèles de diffusion sont stochastiques : une minuscule variation dans la distribution du bruit produit des proportions de personnage, des épaisseurs de trait, une saturation des couleurs ou des détails de cheveux visiblement différents.
À quoi ressemble la dérive en pratique
La dérive de style dans l’anime généré par IA apparaît généralement à trois endroits :
- Traits du personnage : les yeux changent de forme ou de taille. La couleur des cheveux varie de 10 à 15 %. Le teint se réchauffe ou se refroidit d’une image à l’autre.
- Épaisseur du trait : l’épaisseur du contour qui définit l’esthétique anime varie de façon imprévisible lorsque le modèle échantillonne la distribution du bruit.
- Cohérence de la palette : les couleurs de l’arrière-plan « respirent », changeant subtilement en saturation ou en teinte alors que rien dans la scène ne devrait changer.
Le résultat, que les animateurs appellent incohérence temporelle : des images qui paraissent correctes isolément, mais fausses en séquence.
Pourquoi c’est plus important pour l’anime que pour le réel
La génération de vidéos en prise de vue réelle bénéficie d’une certaine indulgence naturelle. Un léger décalage de teinte sur la peau se lit comme un changement d’éclairage. Mais l’anime repose sur des systèmes visuels très codifiés : un personnage donné a une palette précise, un style de trait précis, une forme d’œil précise. Tout écart est immédiatement perçu comme un « mauvais personnage » plutôt que comme un « éclairage différent ».
C’est le défi de la cohérence qui distingue les bons outils d’anime par IA des excellents.
Pour comprendre le fonctionnement des meilleurs systèmes de cohérence, il faut savoir ce que fait un modèle de diffusion lorsqu’il génère un personnage anime.
L’espace latent et le style comme coordonnée
Chaque image générée par un modèle de diffusion existe comme un point dans l’espace latent : une représentation mathématique compressée du monde visuel que le modèle a traité pendant son entraînement. Le style d’un personnage n’est pas stocké sous forme de règles explicites (« utiliser #F5D5A8 pour la peau »). C’est un amas de coordonnées dans un espace de grande dimension.
Quand un prompt dit « fille anime, longs cheveux noirs, uniforme scolaire », le modèle échantillonne dans la région de l’espace latent associée à cette description. Mais cette région est vaste. Il existe des milliers d’interprétations valables de ce prompt, et le modèle en choisit une selon la seed de bruit.
C’est pourquoi le contrôle de la seed est un premier outil de base pour la cohérence de style. Fixer la seed garde le point d’échantillonnage à peu près stable. Mais le contrôle de la seed seul ne suffit plus dès que l’angle de caméra, l’éclairage ou le mouvement changent, car chaque changement pousse le modèle vers un autre voisinage du même amas.
Comment le modèle lit le style visuel
L’idée clé est que les systèmes de cohérence récents ne se contentent pas de contrôler le prompt. Ils contrôlent directement l’embedding de style, en injectant des coordonnées latentes précises comme signaux de guidage, afin que le modèle ne puisse pas trop s’en éloigner. C’est le mécanisme derrière IP-Adapter, le conditionnement par image de référence et des techniques similaires que des outils de PicassoIA comme ToonCrafter et AnimateDiff Prompt Travel exploitent en coulisses.
Plutôt que d’espérer que le prompt soit assez précis pour reproduire le même style, ces outils figent l’embedding de style d’une image de référence et l’utilisent comme signal constant tout au long de la génération. La sortie du modèle reste ancrée, parce que l’ancrage est imposé mathématiquement, et non seulement suggéré par le texte.
Les modèles LoRA : le verrou de précision pour les personnages
L’outil le plus fiable pour verrouiller un personnage anime précis sur de nombreuses images est un LoRA (Low-Rank Adaptation). Comprendre son fonctionnement explique pourquoi il produit des résultats aussi stables.
Ce que change réellement un LoRA
Un modèle de diffusion standard possède des milliards de paramètres : les poids numériques qui définissent la manière dont il transforme le bruit en images. Un LoRA ne réentraîne pas tout le modèle. Il injecte un petit ensemble de matrices de décalage apprises qui orientent l’attention du modèle vers des motifs visuels précis.
Imaginez qu’on donne au modèle de base une paire de lunettes calibrée pour un seul personnage. Chaque fois qu’il « regarde » l’espace de génération, il voit plus clairement les proportions, la palette et le tracé de ce personnage. Le modèle de base gère toujours tout le reste (éclairage, composition, arrière-plan), mais les traits du personnage se recalent de façon fiable.
Ce qui se passe pour la cohérence d’une image à l’autre
Lorsque vous utilisez un LoRA entraîné sur un personnage précis et que vous générez des images avec des prompts différents (le personnage court, le personnage est assis, le personnage regarde à gauche), les matrices de décalage du LoRA gardent stables les traits qui définissent le personnage. Les proportions du visage, la couleur des cheveux et les détails de la tenue restent ancrés, même lorsque la pose change radicalement.
C’est pourquoi les pipelines professionnels d’anime par IA commencent toujours par des LoRA de personnage. Sans LoRA, vous ne comptez que sur l’ingénierie des prompts, ce qui produit une dérive visible à grande échelle.
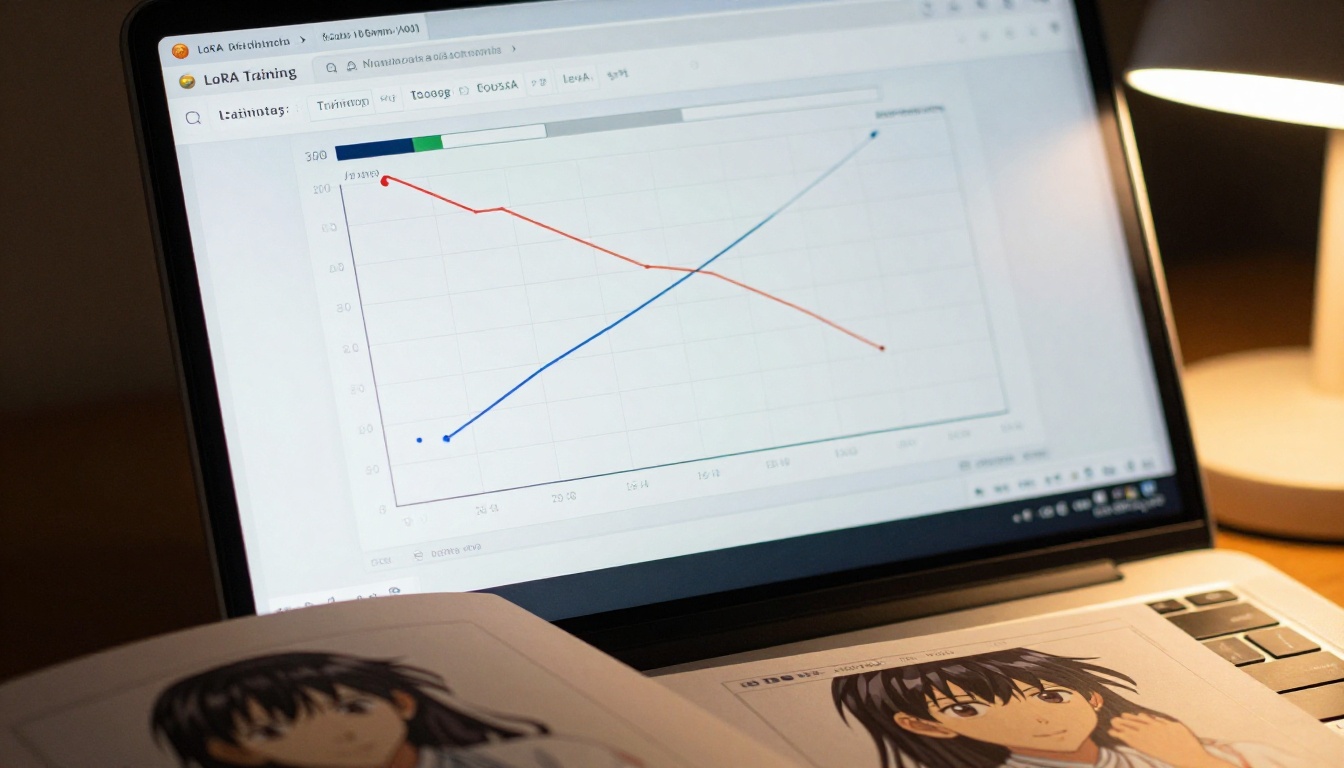
💡 Conseil pratique : un LoRA de personnage bien entraîné a besoin d’au moins 15 à 20 images de référence de qualité, montrant le personnage sous différents angles. Plus il y en a, plus le LoRA apprend quels traits définissent le personnage (forme des yeux, longueur des cheveux) et lesquels sont accessoires (couleur de l’arrière-plan, pose).
AnimateDiff et la question du temps
La cohérence statique et la cohérence temporelle sont deux problèmes différents. Un LoRA garantit que l’image 1 et l’image 47 montrent le même personnage. Mais AnimateDiff Prompt Travel s’attaque à un problème plus difficile : rendre la transition entre les images fluide et cohérente sur le plan stylistique.
Le module de mouvement : ce qu’il est vraiment
AnimateDiff ajoute un module d’attention temporelle au pipeline de génération d’images standard. Les transformeurs d’images classiques examinent les relations spatiales au sein d’une seule image. Le module temporel examine les relations entre les images, en regardant ce qui vient avant et après lorsqu’il génère une image donnée.
Ce changement d’architecture est important. Le modèle ne génère plus chaque image indépendamment. Il génère les images en séquence, chaque image étant conditionnée par les représentations latentes des images adjacentes. Le résultat est un mouvement qui respecte la continuité.
Prompt travel : contrôler le style dans le temps
AnimateDiff Prompt Travel prolonge cette logique en vous permettant de spécifier des prompts différents pour différentes keyframes, le module de mouvement interpolant la transition. Pour un travail de cohérence anime, cela signifie que vous pouvez fixer un prompt de style à l’image 1 (« personnage anime, cheveux foncés, lumière chaude de fin d’après-midi, debout ») et un autre à l’image 24 (« même personnage, même style, pose différente »), et que le système maintient la cohérence visuelle pendant l’interpolation.
La cohérence vient du chemin latent partagé : comme toutes les images passent par les mêmes couches d’attention temporelle, elles héritent des mêmes statistiques de style.
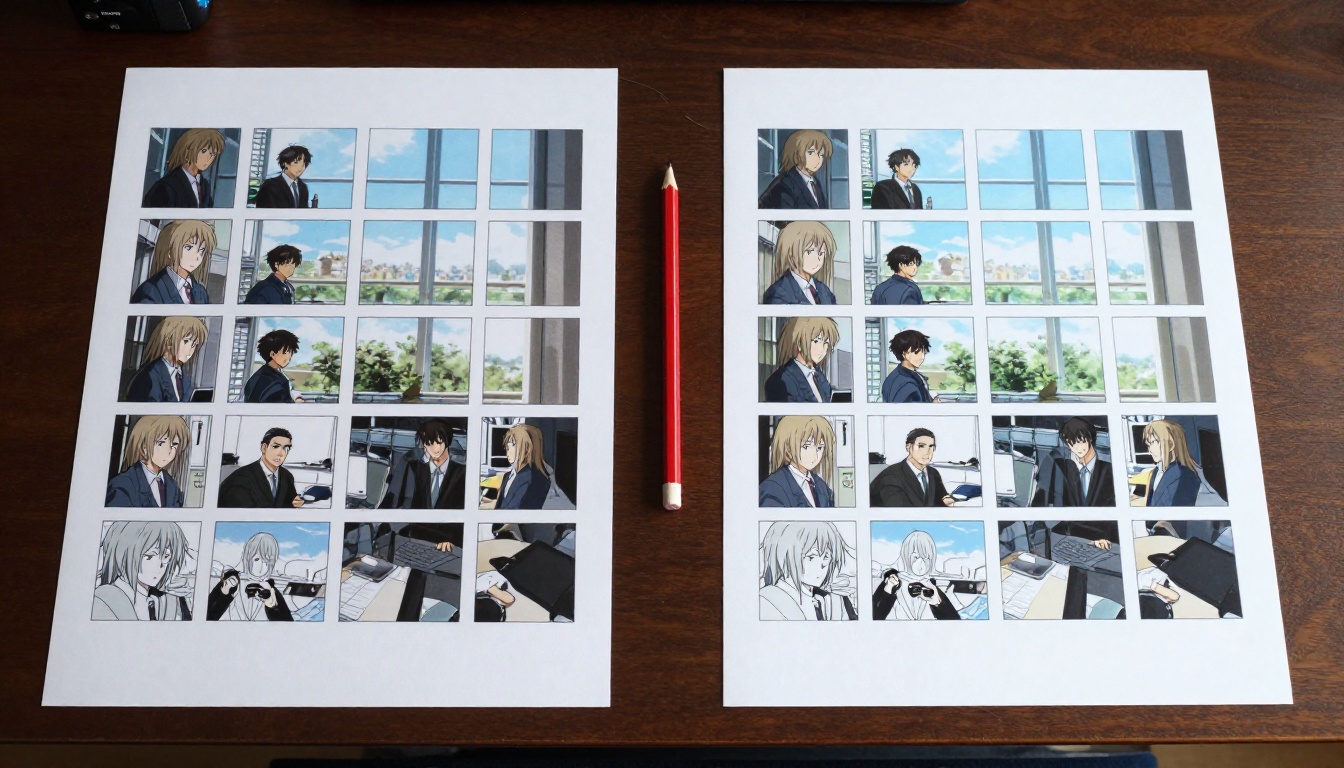
Le rôle de ControlNet comme ancre de style
ControlNet n’ajoute pas de cohérence en mémorisant le style. Il en ajoute en contrôlant la structure. Lorsque vous générez une image de personnage anime avec une condition de contours canny de ControlNet, vous dites au modèle : ne change pas la forme des choses.
Comment les contours canny verrouillent la composition
Une carte de contours canny extrait la structure des lignes d’une image de référence. Lorsque cette carte sert de condition ControlNet, chaque image générée doit correspondre à cette structure de contours. L’IA peut faire varier la couleur et la texture, mais la silhouette, les proportions et la position des principaux traits restent ancrées.
Pour l’anime en particulier, c’est puissant, car le style anime est largement défini par son tracé. Si les lignes ne changent pas, la plus grande partie de ce qui fait « ressembler à de l’anime » reste stable sur toute la séquence.
Cartes de profondeur pour la cohérence spatiale
Le conditionnement par carte de profondeur de ControlNet fonctionne de manière similaire, mais pour la disposition en trois dimensions. Une carte de profondeur extraite de l’image 1 définit où se trouvent les objets proches et lointains. Appliquer cette carte aux images suivantes garde les relations spatiales cohérentes, même lorsque le personnage bouge, et empêche l’arrière-plan de changer de profondeur perçue d’une image à l’autre.
Des outils comme ControlVideo sur PicassoIA appliquent ce principe aux séquences vidéo, en maintenant la cohérence structurelle d’une image à l’autre grâce à des cartes de contrôle extraites.
Les modèles de PicassoIA conçus pour la cohérence
C’est ici que la théorie rencontre la pratique. Voici les outils spécifiques de PicassoIA qui gèrent directement la cohérence du style anime.
AnimateDiff Prompt Travel
AnimateDiff Prompt Travel est ce qui se rapproche le plus d’un moteur dédié à la cohérence anime. Le module d’attention temporelle a été entraîné spécifiquement sur des contenus animés, ce qui le rend particulièrement efficace pour préserver l’esthétique cel-shaded et très contrastée de l’anime au fil des séquences en mouvement.
ToonCrafter
ToonCrafter a été conçu pour l’animation d’illustrations : vous fournissez deux keyframes et ToonCrafter génère les images intermédiaires tout en préservant le style visuel des deux images d’entrée. Pour un travail anime, c’est idéal pour les scènes avec des changements de pose marqués. La cohérence du modèle vient de son conditionnement explicite sur les deux images d’ancrage simultanément.
ControlVideo
ControlVideo applique le conditionnement ControlNet à travers une séquence vidéo. Il accepte une vidéo source ou une séquence d’images et utilise les cartes structurelles extraites pour guider la génération. C’est particulièrement efficace lorsque vous disposez d’un mouvement de référence qu’il faut transposer dans une esthétique anime.
Kling v3 Motion Control
Kling v3 Motion Control assure la cohérence par un autre mécanisme : la planification explicite de trajectoires. Avant de générer les images, le modèle trace le chemin de mouvement des objets et des personnages clés, puis génère chaque image en la contraignant à cette trajectoire. Les traits du personnage restent cohérents parce que le modèle sait où chaque partie du personnage doit se trouver à chaque instant.
Wan 2.7 I2V
Wan 2.7 I2V (Image vers vidéo) excelle à préserver le style d’une seule image source sur une séquence animée. Comme l’image source sert d’image de conditionnement, les sorties du modèle sont ancrées à ses statistiques visuelles : couleurs, textures, tracé et disposition spatiale.
P Video Animate
P Video Animate prend une photo ou une illustration statique et l’anime en un court clip tout en conservant les caractéristiques visuelles de l’image source. Comme la source est intégrée à la génération comme référence directe, l’identité du personnage est préservée pendant le mouvement.
| Modèle | Méthode de cohérence | Idéal pour |
|---|
| AnimateDiff Prompt Travel | Modules d’attention temporelle | Longues séquences avec prompts évolutifs |
| ToonCrafter | Interpolation à deux keyframes | Courts clips entre poses définies |
| ControlVideo | Cartes structurelles ControlNet | Transposition de mouvement avec transfert de style |
| Kling v3 Motion Control | Planification de trajectoires | Séquences d’action centrées sur le personnage |
| Wan 2.7 I2V | Conditionnement par image source | Animer une seule image de référence |
| P Video Animate | Conditionnement direct par la source | Donner vie à un art anime statique |
Voici un flux de travail pratique en quatre étapes pour obtenir un style anime cohérent avec l’ensemble d’outils de PicassoIA.
Étape 1 : constituez votre base de référence
Générez votre image d’ancrage avec un modèle de texte vers image. C’est l’apparence « canonique » de votre personnage. Conservez l’URL du résultat : elle deviendra votre référence pour chaque étape de génération suivante. Générez 3 ou 4 variations du même personnage dans des poses neutres légèrement différentes, puis choisissez celle qui représente le mieux le style visé.
Étape 2 : choisissez votre outil de cohérence
Pour les clips courts (2 à 5 secondes) : utilisez ToonCrafter avec votre pose de départ et votre pose de fin comme deux keyframes. L’interpolation sera ancrée stylistiquement sur les deux.
Pour les séquences plus longues (plus de 10 secondes) : utilisez AnimateDiff Prompt Travel avec des prompts de keyframes qui gardent les descripteurs du personnage constants tout au long de la séquence.
Pour les séquences d’action avec des trajectoires de mouvement précises : utilisez Kling v3 Motion Control ou Wan 2.7 I2V pour animer votre image source avec une trajectoire guidée.
Étape 3 : upscaler et peaufiner
Une fois la séquence cohérente obtenue, utilisez P Image Upscale ou Clarity Pro Upscaler pour rendre les images individuelles plus nettes sans introduire de nouvelle variation de style. L’upscaling après génération est plus sûr que l’upscaling pendant la génération : il préserve la cohérence que vous avez déjà construite.
Pour les séquences vidéo, Real ESRGAN Video applique la super-résolution à l’ensemble du clip simultanément, en assurant un affinage image par image sans ajouter de dérive.
Étape 4 : modifier et corriger les images problématiques
Si des images précises dérivent malgré vos outils de cohérence, P Video Edit vous permet de cibler des sections individuelles avec des prompts texte, en réécrivant uniquement les images problématiques tout en gardant le reste intact. Aleph 2 fonctionne de façon similaire, en propageant à toute la séquence les modifications apportées à une seule image.
Quand l’IA se trompe encore
Même avec tous ces systèmes, la dérive de style n’est pas totalement résolue. Voici les cas où elle persiste et ce qu’il faut faire.
Les 3 modes d’échec les plus courants
1. Transitions à mouvement intense : lorsqu’un personnage bouge très vite entre les keyframes, les modules d’attention temporelle privilégient parfois la cohérence du mouvement au détriment de la cohérence du style. Le personnage arrive à la bonne pose, mais avec des proportions de visage légèrement différentes. Solution : réduisez l’amplitude du mouvement dans votre prompt, ou découpez la séquence en sous-clips plus courts avec des images d’ancrage qui se chevauchent.
2. Contamination de couleur de l’arrière-plan vers le personnage : lorsque l’arrière-plan contient une forte information colorée (ciel vif, environnements saturés, motifs complexes), cette couleur peut « déteindre » sur la palette du personnage via l’attention croisée du modèle. Les cheveux ou la tenue du personnage prennent une légère teinte issue des éléments voisins de l’arrière-plan. Solution : utilisez un arrière-plan neutre ou hors mise au point dans votre image source et dans vos prompts de conditionnement.
3. Poids de LoRA en conflit : lorsque vous utilisez deux LoRA simultanément (l’un pour le personnage, l’autre pour le style général), leurs poids peuvent entrer en conflit et produire des résultats altérés. Le personnage paraît « délavé » ou le style s’aplatit vers une moyenne générique. Solution : réduisez le poids du LoRA secondaire à 0,6-0,7 et augmentez celui du LoRA de personnage principal à 0,9-1,0.
Comment repérer une contamination de style avant qu’elle ne ruine une séquence
Vérifiez ces trois points d’une image à l’autre avant d’accepter une génération :
- Symétrie des yeux : dans l’anime, un rendu d’yeux asymétrique d’une image à l’autre est un signal fort de dérive. Si les yeux paraissent de tailles ou de formes différentes d’une image à l’autre, la dérive est présente.
- Échantillonnage de l’épaisseur du trait : prenez 5 images au hasard et comparez l’épaisseur des traits dans la même zone. Une variation de plus de 20 % signifie une dérive visible en mouvement.
- Échantillonnage de la palette : utilisez une pipette de couleur sur les cheveux du personnage dans trois images. Si la valeur hexadécimale varie de plus de 15 points sur un canal quelconque, attendez-vous à une dérive de couleur visible à la lecture.
Ces contrôles rapides ne prennent que quelques secondes, mais ils détectent la plupart des problèmes de cohérence avant qu’ils ne s’accumulent sur une séquence complète.
Créez votre propre contenu anime cohérent
La technologie de cohérence du style anime est réellement disponible. Utilisés correctement, les outils proposés sur PicassoIA produisent des résultats qui auraient exigé une grande équipe d’animation traditionnelle travaillant pendant des semaines.
Le véritable avantage n’est pas seulement la vitesse. C’est la capacité d’itération : vous pouvez générer 50 variantes d’une scène dans le temps qu’il faudrait pour en dessiner une à la main, en utilisant les systèmes de cohérence décrits ici pour écarter la dérive et maintenir la qualité de bout en bout.
Commencez par une seule image d’ancrage. Construisez à partir de là en utilisant l’outil adapté à la longueur et au type de mouvement de votre séquence. Si vous constatez une dérive, corrigez-la à la source : avec des poids de LoRA mieux calibrés, un meilleur conditionnement par référence, ou une retouche vidéo ciblée avec P Video Edit.
💡 Le chemin le plus rapide vers une sortie anime cohérente : générez votre image d’ancrage, animez-la avec P Video Animate, puis upscalez le résultat avec Clarity Pro Upscaler. Ce pipeline en trois étapes prend moins de cinq minutes et produit un clip cohérent et haute résolution à partir de n’importe quelle image de référence.
La bibliothèque complète de modèles de PicassoIA couvre chaque étape de ce flux de travail : de la génération d’images initiale à la cohérence temporelle, en passant par l’upscaling et le montage vidéo. Choisissez votre personnage, choisissez votre outil, et voyez à quel point vous pouvez le rendre stable.


