जब AI आपके एनिमे कैरेक्टर का फ़्रेम 1 बनाता है और फ़्रेम 47 में वह बिल्कुल अलग इंसान जैसा दिखने लगता है, तो यह कोई साधारण तकनीकी गड़बड़ी नहीं है। आप AI-संचालित एनिमेशन की सबसे कठिन समस्या से टकराए हैं: फ़्रेम-दर-फ़्रेम स्टाइल कंसिस्टेंसी।
यह कोई छोटी-मोटी परेशानी नहीं है। यह पूरे भ्रम को तोड़ देती है। AI एनिमे कंटेंट अक्सर झटकेदार, भटकता हुआ या "अजीब-सा" इसलिए नहीं दिखता कि अलग-अलग फ़्रेम खराब दिखते हैं। वह इसलिए दिखता है कि लगातार आने वाले फ़्रेम ऐसे नहीं लगते जैसे वे एक ही दुनिया के हों।
तो सबसे अच्छे AI सिस्टम इसे असल में कैसे हल करते हैं? और PicassoIA पर कौन से टूल इसे सही तरीके से करते हैं?
हर फ़्रेम अलग क्यों होना चाहता है
मूल समस्या यह है कि ज़्यादातर इमेज डिफ्यूज़न मॉडल्स में कोई मेमोरी नहीं होती।
हर फ़्रेम एक नॉइज़ सीड से बनता है, जिसे आपका प्रॉम्प्ट गाइड करता है। जब आप फ़्रेम 2 बनाते हैं, तो मॉडल को याद नहीं रहता कि फ़्रेम 1 कैसा दिखता था। वह बस प्रॉम्प्ट को दोबारा फ़ॉलो करता है। और एक जैसे प्रॉम्प्ट होने पर भी डिफ्यूज़न मॉडल स्टोकैस्टिक होते हैं: नॉइज़ डिस्ट्रीब्यूशन में छोटा-सा बदलाव भी कैरेक्टर के अनुपात, लाइन की मोटाई, रंग की संतृप्ति या बालों की बारीकी में साफ़ दिखने वाला फ़र्क ला देता है।
व्यवहार में ड्रिफ़्ट कैसा दिखता है
AI एनिमे में स्टाइल ड्रिफ़्ट आम तौर पर तीन जगहों पर दिखता है:
- कैरेक्टर के फ़ीचर: आँखों का आकार या शक्ल बदल जाती है। बालों का रंग 10-15% तक खिसक जाता है। फ़्रेम के बीच स्किन टोन गर्म या ठंडा हो जाता है।
- लाइन वेट: वह बाहरी रेखा की मोटाई, जो एनिमे की पहचान तय करती है, नॉइज़ डिस्ट्रीब्यूशन से सैंपल लेते समय अनिश्चित ढंग से बदलती है।
- कलर पैलेट की एकरूपता: बैकग्राउंड के रंग "सांस लेते" हैं, यानी जब सीन में कुछ नहीं बदलना चाहिए तब भी उनकी संतृप्ति या ह्यू हल्की-सी बदल जाती है।
इसका नतीजा वह है जिसे एनिमेटर टेम्पोरल इनकोहेरेंस कहते हैं: ऐसे फ़्रेम जो अलग-अलग देखने पर ठीक लगते हैं, लेकिन क्रम में गलत लगते हैं।
लाइव-एक्शन से ज़्यादा एनिमे में यह क्यों मायने रखता है
लाइव-एक्शन वीडियो जनरेशन को कुछ स्वाभाविक रियायत मिल जाती है। त्वचा के टोन में हल्का बदलाव लाइटिंग में बदलाव जैसा लगता है। लेकिन एनिमे अत्यधिक कोडिफ़ाइड विज़ुअल सिस्टम पर बना है: किसी खास कैरेक्टर का एक खास पैलेट, एक खास लाइन स्टाइल और एक खास आँख का आकार होता है। कोई भी विचलन तुरंत "अलग लाइटिंग" की जगह "गलत कैरेक्टर" जैसा लगता है।
यही कंसिस्टेंसी की चुनौती अच्छे AI एनिमे टूल्स को बेहतरीन टूल्स से अलग करती है।
न्यूरल नेटवर्क असल में स्टाइल को कैसे एन्कोड करते हैं
सबसे अच्छे कंसिस्टेंसी सिस्टम कैसे काम करते हैं, यह समझने के लिए आपको यह समझना होगा कि डिफ्यूज़न मॉडल एक एनिमे कैरेक्टर बनाते समय असल में क्या करता है।
लेटेंट स्पेस और स्टाइल एक निर्देशांक के रूप में
डिफ्यूज़न मॉडल द्वारा बनाई गई हर इमेज लेटेंट स्पेस में एक बिंदु के रूप में मौजूद होती है: यह उस विज़ुअल दुनिया का एक संपीड़ित गणितीय प्रतिनिधित्व है जिसे मॉडल ने ट्रेनिंग के दौरान देखा था। किसी कैरेक्टर का स्टाइल स्पष्ट नियमों के सेट के रूप में स्टोर नहीं होता ("त्वचा के लिए #F5D5A8 इस्तेमाल करें")। यह एक उच्च-आयामी स्पेस में निर्देशांकों का एक समूह होता है।
जब प्रॉम्प्ट कहता है "anime girl, long black hair, school uniform", तो मॉडल उस विवरण से जुड़े लेटेंट स्पेस के क्षेत्र से सैंपल लेता है। लेकिन वह क्षेत्र बहुत बड़ा है। उस प्रॉम्प्ट की हज़ारों वैध व्याख्याएँ हो सकती हैं, और मॉडल नॉइज़ सीड के आधार पर एक चुन लेता है।
इसीलिए स्टाइल कंसिस्टेंसी के लिए सीड कंट्रोल पहला बुनियादी टूल है। सीड तय करने से सैंपलिंग बिंदु लगभग स्थिर रहता है। लेकिन अकेला सीड कंट्रोल तब टूट जाता है जब कैमरा एंगल, लाइटिंग या मोशन बदलता है, क्योंकि हर बदलाव मॉडल को उसी क्लस्टर के किसी दूसरे इलाके में धकेल देता है।
मॉडल विज़ुअल स्टाइल को कैसे पढ़ता है
मुख्य समझ यह है कि नए कंसिस्टेंसी सिस्टम सिर्फ़ प्रॉम्प्ट को कंट्रोल नहीं करते। वे स्टाइल एम्बेडिंग को सीधे कंट्रोल करते हैं, और विशिष्ट लेटेंट निर्देशांकों को गाइडेंस सिग्नल के रूप में डालते हैं ताकि मॉडल उनसे बहुत दूर न जा सके। यही तरीका IP-Adapter, रेफ़रेंस इमेज कंडिशनिंग और इसी तरह की दूसरी तकनीकों के पीछे है, जिन्हें PicassoIA के ToonCrafter और AnimateDiff Prompt Travel जैसे टूल अंदर से इस्तेमाल करते हैं।
यह उम्मीद करने के बजाय कि प्रॉम्प्ट इतना सटीक होगा कि वही स्टाइल दोबारा बन सके, ये टूल एक रेफ़रेंस इमेज से स्टाइल एम्बेडिंग पिन करते हैं और जनरेशन के दौरान उसे एक स्थिर सिग्नल की तरह इस्तेमाल करते हैं। मॉडल का आउटपुट इसलिए टिका रहता है क्योंकि एंकर गणितीय रूप से लागू होता है, केवल शब्दों में सुझाया नहीं जाता।
LoRA मॉडल: कैरेक्टर के लिए सटीक लॉक
कई फ़्रेम में किसी खास एनिमे कैरेक्टर को लॉक करने का सबसे भरोसेमंद टूल LoRA (Low-Rank Adaptation) है। LoRA कैसे काम करता है, यह समझने से पता चलता है कि यह इतने स्थिर नतीजे क्यों देता है।
LoRA असल में क्या बदलता है
एक स्टैंडर्ड डिफ्यूज़न मॉडल में अरबों पैरामीटर होते हैं: वे संख्यात्मक वेट जो तय करते हैं कि मॉडल नॉइज़ को इमेज में कैसे बदलता है। LoRA पूरे मॉडल को दोबारा ट्रेन नहीं करता। इसके बजाय यह सीखे गए ऑफ़सेट मैट्रिक्स का एक छोटा सेट डालता है जो मॉडल के अटेंशन को खास विज़ुअल पैटर्न की ओर थोड़ा मोड़ देते हैं।
इसे ऐसे समझें जैसे बेस मॉडल को एक जोड़ी चश्मा दे दिया गया हो, जो एक ही कैरेक्टर के लिए कैलिब्रेट किया गया हो। जब भी वह जनरेशन स्पेस को "देखता" है, उसे उस कैरेक्टर के अनुपात, पैलेट और लाइनवर्क ज़्यादा साफ़ दिखते हैं। बेस मॉडल अब भी लाइटिंग, कम्पोज़िशन और बैकग्राउंड जैसी बाकी सब चीज़ें संभालता है, लेकिन कैरेक्टर के फ़ीचर भरोसे से अपनी जगह पर बैठ जाते हैं।
फ़्रेम के बीच कंसिस्टेंसी पर क्या असर होता है
जब आप किसी खास कैरेक्टर पर ट्रेन किया गया LoRA इस्तेमाल करते हैं और अलग-अलग प्रॉम्प्ट से फ़्रेम बनाते हैं (कैरेक्टर दौड़ रहा है, कैरेक्टर बैठा है, कैरेक्टर बाईं ओर देख रहा है), तो LoRA के ऑफ़सेट मैट्रिक्स कैरेक्टर को परिभाषित करने वाले फ़ीचर स्थिर रखते हैं। पोज़ बहुत बदलने पर भी चेहरे का अनुपात, बालों का रंग और पोशाक के विवरण अपनी जगह पर रहते हैं।
इसीलिए प्रोफ़ेशनल AI एनिमे पाइपलाइन हमेशा कैरेक्टर LoRA से शुरू करती हैं। इसके बिना आप सिर्फ़ प्रॉम्प्ट इंजीनियरिंग पर निर्भर रहते हैं, जो बड़े पैमाने पर साफ़ दिखने वाला ड्रिफ़्ट पैदा करती है।
💡 व्यावहारिक टिप: एक अच्छी तरह ट्रेन किए गए कैरेक्टर LoRA को कैरेक्टर को अलग-अलग एंगल से दिखाने वाली कम से कम 15-20 उच्च-गुणवत्ता रेफ़रेंस इमेज चाहिए। ज़्यादा इमेज का मतलब है कि LoRA यह बेहतर पहचान पाता है कि कौन से फ़ीचर कैरेक्टर को परिभाषित करते हैं (आँख का आकार, बालों की लंबाई) और कौन से आकस्मिक हैं (बैकग्राउंड का रंग, पोज़)।
AnimateDiff और समय की समस्या
स्टैटिक कंसिस्टेंसी और टेम्पोरल कंसिस्टेंसी अलग-अलग समस्याएँ हैं। LoRA सुनिश्चित करता है कि फ़्रेम 1 और फ़्रेम 47 एक ही कैरेक्टर जैसे दिखें। लेकिन AnimateDiff Prompt Travel एक कठिन चीज़ संभालता है: फ़्रेमों के बीच संक्रमण को सुचारु और स्टाइल के हिसाब से एकसार बनाना।
मोशन मॉड्यूल: यह असल में क्या है
AnimateDiff स्टैंडर्ड इमेज जनरेशन पाइपलाइन में एक टेम्पोरल अटेंशन मॉड्यूल जोड़ता है। सामान्य इमेज ट्रांसफ़ॉर्मर एक ही फ़्रेम के भीतर स्पेशियल रिश्तों पर ध्यान देते हैं। टेम्पोरल मॉड्यूल फ़्रेमों के आर-पार के रिश्तों पर ध्यान देता है, और किसी भी फ़्रेम को बनाते समय आगे-पीछे के फ़्रेमों को देखता है।
यह आर्किटेक्चर बदलाव बहुत मायने रखता है। अब मॉडल हर फ़्रेम को अलग-अलग नहीं बनाता। वह फ़्रेमों को एक क्रम में बनाता है, जिसमें हर फ़्रेम आसपास के फ़्रेमों के लेटेंट रिप्रेज़ेंटेशन पर आधारित होता है। नतीजा ऐसी मोशन है जो निरंतरता का सम्मान करती है।
प्रॉम्प्ट ट्रैवल: समय के साथ स्टाइल को कंट्रोल करना
AnimateDiff Prompt Travel इसे आगे बढ़ाता है, जिससे आप अलग-अलग कीफ़्रेम के लिए अलग प्रॉम्प्ट तय कर सकते हैं, और मोशन मॉड्यूल संक्रमण को इंटरपोलेट करता है। एनिमे कंसिस्टेंसी के काम के लिए इसका मतलब है कि आप फ़्रेम 1 पर एक स्टाइल प्रॉम्प्ट लॉक कर सकते हैं ("anime character, dark hair, warm afternoon light, standing") और फ़्रेम 24 पर दूसरा ("same character, same style, different pose"), और सिस्टम इंटरपोलेशन के दौरान विज़ुअल एकरूपता बनाए रखता है।
यह कंसिस्टेंसी साझा लेटेंट पाथवे से आती है: क्योंकि सभी फ़्रेम एक ही टेम्पोरल अटेंशन लेयर्स से गुजरते हैं, वे एक ही स्टाइल आँकड़े विरासत में पाते हैं।
स्टाइल एंकर के रूप में ControlNet की भूमिका
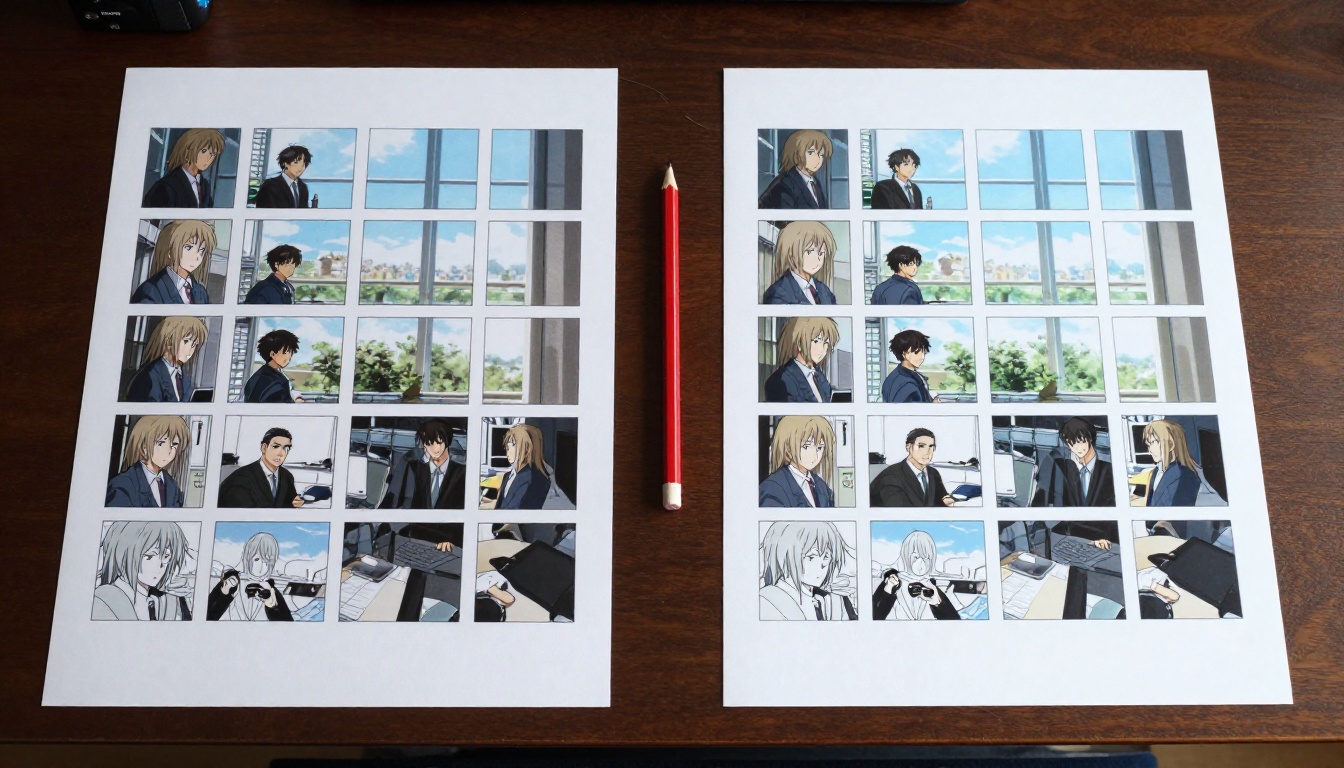
ControlNet स्टाइल को याद रखकर कंसिस्टेंसी नहीं जोड़ता। वह स्ट्रक्चर को कंट्रोल करके इसे जोड़ता है। जब आप ControlNet canny edge कंडिशन के साथ एनिमे कैरेक्टर फ़्रेम बनाते हैं, तो आप मॉडल से कह रहे हैं: चीज़ों का आकार न बदलें।
कैनी एज कम्पोज़िशन को कैसे लॉक करते हैं
कैनी एज मैप एक रेफ़रेंस फ़्रेम से आउटलाइन स्ट्रक्चर निकालता है। जब इस मैप को ControlNet कंडिशन के रूप में इस्तेमाल किया जाता है, तो हर जनरेट किए गए फ़्रेम को उस एज स्ट्रक्चर से मेल खाना पड़ता है। AI रंग और टेक्सचर बदल सकता है, लेकिन सिल्हूट, अनुपात और मुख्य फ़ीचर की जगहें एंकर रहती हैं।
एनिमे के लिए यह खास तौर पर शक्तिशाली है, क्योंकि एनिमे स्टाइल काफ़ी हद तक उसकी लाइनवर्क से परिभाषित होती है। अगर लाइनें नहीं बदलतीं, तो एनिमे को "एनिमे जैसा" दिखाने वाली ज़्यादातर चीज़ें पूरे क्रम में स्थिर रहती हैं।
स्पेशियल कंसिस्टेंसी के लिए डेप्थ मैप
ControlNet डेप्थ कंडिशनिंग भी लगभग इसी तरह काम करती है, लेकिन त्रि-आयामी लेआउट के लिए। फ़्रेम 1 से निकाला गया डेप्थ मैप तय करता है कि नज़दीक और दूर की चीज़ें कहाँ हैं। इस मैप को बाद के फ़्रेमों पर लगाने से कैरेक्टर के चलने पर भी स्पेशियल रिश्ते एकसार रहते हैं, और यह बैकग्राउंड को फ़्रेमों के बीच अपनी गहराई में उछलने से रोकता है।
PicassoIA पर ControlVideo जैसे टूल इसी सिद्धांत को वीडियो सीक्वेंस पर लागू करते हैं, और निकाले गए कंट्रोल मैप्स का इस्तेमाल करके फ़्रेम-दर-फ़्रेम स्ट्रक्चरल एकरूपता बनाए रखते हैं।
PicassoIA के मॉडल जो कंसिस्टेंसी के लिए बने हैं
यहाँ थ्योरी प्रैक्टिस से मिलती है। ये PicassoIA के वे खास टूल हैं जो एनिमे स्टाइल कंसिस्टेंसी सीधे संभालते हैं।
AnimateDiff Prompt Travel
AnimateDiff Prompt Travel उपलब्ध सबसे नज़दीकी समर्पित एनिमे कंसिस्टेंसी इंजन है। इसका टेम्पोरल अटेंशन मॉड्यूल खास तौर पर एनिमेटेड कंटेंट पर ट्रेन किया गया था, इसलिए यह मोशन सीक्वेंस में एनिमे की cel-shaded और हाई-कॉन्ट्रास्ट शैली बनाए रखने में खास तौर पर असरदार है।
ToonCrafter
ToonCrafter इलस्ट्रेशन एनिमेशन के लिए बनाया गया था: आप दो कीफ़्रेम देते हैं और ToonCrafter उनके बीच के फ़्रेम बनाता है, साथ ही दोनों इनपुट इमेज की विज़ुअल स्टाइल बनाए रखता है। एनिमे काम में यह मज़बूत पोज़ बदलाव वाले सीन के लिए आदर्श है। मॉडल की कंसिस्टेंसी इस बात से आती है कि यह दोनों एंकर फ़्रेमों पर एक साथ साफ़ तौर पर कंडीशन होता है।
ControlVideo
ControlVideo पूरे वीडियो सीक्वेंस में ControlNet कंडिशनिंग लागू करता है। यह सोर्स वीडियो या इमेज सीक्वेंस लेता है और जनरेशन को निर्देशित करने के लिए निकाले गए स्ट्रक्चरल मैप्स का इस्तेमाल करता है। जब आपके पास रेफ़रेंस मोशन हो जिसे एनिमे स्टाइल में स्टाइलिस्टिक रूप से दोबारा लक्षित करना हो, तब यह खास तौर पर असरदार है।
Kling v3 Motion Control
Kling v3 Motion Control कंसिस्टेंसी एक अलग तरीके से संभालता है: स्पष्ट ट्रैजेक्टरी प्लानिंग के ज़रिए। फ़्रेम बनाने से पहले मॉडल मुख्य ऑब्जेक्ट्स और कैरेक्टर के मोशन पाथ का नक्शा बनाता है, फिर हर फ़्रेम को उस ट्रajectory की सीमा में रखकर बनाता है। कैरेक्टर के फ़ीचर इसलिए स्थिर रहते हैं क्योंकि मॉडल जानता है कि हर पल कैरेक्टर का हर हिस्सा कहाँ होना चाहिए।
Wan 2.7 I2V
Wan 2.7 I2V (Image-to-Video) एक सिंगल सोर्स इमेज की स्टाइल को एनिमेटेड सीक्वेंस में बनाए रखने में माहिर है। चूँकि सोर्स इमेज एक कंडीशनिंग फ़्रेम के रूप में इस्तेमाल होती है, मॉडल के आउटपुट उसके विज़ुअल आँकड़ों से एंकर रहते हैं: रंग, टेक्सचर, लाइनवर्क और स्पेशियल लेआउट।
P Video Animate
P Video Animate एक स्टैटिक फ़ोटो या इलस्ट्रेशन लेता है और उसे एक छोटे क्लिप में एनिमेट करता है, जबकि सोर्स इमेज की विज़ुअल खासियतें बनी रहती हैं। क्योंकि सोर्स को सीधे रेफ़रेंस के रूप में जनरेशन में शामिल किया जाता है, मोशन के दौरान कैरेक्टर की पहचान बनी रहती है।
PicassoIA के साथ कंसिस्टेंट एनिमे स्टाइल कैसे पाएँ
PicassoIA के टूल सेट से कंसिस्टेंट एनिमे स्टाइल पाने का एक व्यावहारिक चार-चरणीय वर्कफ़्लो यह है।
चरण 1: अपना रेफ़रेंस बेस बनाएँ
एक टेक्स्ट-टू-इमेज मॉडल से अपना एंकर फ़्रेम बनाएँ। यही आपके कैरेक्टर का "कैनन" रूप है। इसका आउटपुट URL सहेज लें, क्योंकि यह हर आगे के जनरेशन चरण के लिए आपका रेफ़रेंस बन जाएगा। थोड़े अलग तटस्थ पोज़ में उसी कैरेक्टर के 3-4 वेरिएशन बनाएँ और वह चुनें जो आपकी इच्छित स्टाइल को सबसे अच्छी तरह दिखाता हो।
चरण 2: अपना कंसिस्टेंसी टूल चुनें
छोटे क्लिप (2-5 सेकंड) के लिए: अपने शुरुआती और आखिरी पोज़ को दो कीफ़्रेम के रूप में ToonCrafter के साथ इस्तेमाल करें। इंटरपोलेशन दोनों से स्टाइलिस्टिक रूप से एंकर होगा।
लंबे सीक्वेंस (10+ सेकंड) के लिए: AnimateDiff Prompt Travel को ऐसे कीफ़्रेम प्रॉम्प्ट के साथ इस्तेमाल करें जो पूरे समय कैरेक्टर के एक जैसे विवरण बनाए रखें।
खास मोशन पाथ वाले एक्शन सीक्वेंस के लिए: Kling v3 Motion Control या Wan 2.7 I2V का इस्तेमाल करके अपनी सोर्स इमेज को निर्देशित ट्रajectory के साथ एनिमेट करें।
चरण 3: अपस्केल करें और निखारें
एक बार कंसिस्टेंट सीक्वेंस तैयार हो जाए, तो बिना नई स्टाइल वेरिएशन लाए अलग-अलग फ़्रेम को साफ़ करने के लिए P Image Upscale या Clarity Pro Upscaler इस्तेमाल करें। जनरेशन के बाद अपस्केल करना जनरेशन के समय अपस्केल करने से ज़्यादा सुरक्षित है, क्योंकि इससे वह कंसिस्टेंसी बनी रहती है जो आप पहले ही बना चुके हैं।
वीडियो सीक्वेंस के लिए, Real ESRGAN Video पूरे क्लिप पर एक साथ सुपर-रिज़ोल्यूशन लागू करता है, और बिना ड्रिफ़्ट जोड़े हर फ़्रेम की शार्पनेस बनाए रखता है।
चरण 4: समस्या वाले फ़्रेम संपादित और परिष्कृत करें
अगर कंसिस्टेंसी टूल्स के बावजूद कुछ फ़्रेम बहकते हैं, तो P Video Edit आपको टेक्स्ट प्रॉम्प्ट से खास हिस्सों को निशाना बनाने देता है, और केवल समस्या वाले फ़्रेम फिर से लिखता है जबकि बाकी जस का तस रहता है। Aleph 2 भी इसी तरह काम करता है, और एक फ़्रेम पर किए गए संपादन को पूरे सीक्वेंस में फैला देता है।
जब AI अब भी गलती करता है
इन सभी सिस्टम के बावजूद स्टाइल ड्रिफ़्ट पूरी तरह हल नहीं हुआ है। यहाँ बताया गया है कि यह अब भी कब विफल होता है और उस पर क्या करना चाहिए।
सबसे आम 3 विफलता के तरीके
1. हाई-मोशन संक्रमण: जब कोई कैरेक्टर कीफ़्रेम के बीच बहुत तेज़ी से चलता है, तो टेम्पोरल अटेंशन मॉड्यूल कभी-कभी स्टाइल कंसिस्टेंसी की जगह मोशन कंसिस्टेंसी को प्राथमिकता देते हैं। कैरेक्टर सही पोज़ में पहुँचता है, लेकिन चेहरे के अनुपात थोड़े अलग होते हैं। समाधान: अपने प्रॉम्प्ट में मोशन की तीव्रता घटाएँ या सीक्वेंस को ओवरलैपिंग एंकर फ़्रेम वाले छोटे सब-क्लिप में तोड़ें।
2. बैकग्राउंड से कैरेक्टर में रंग का रिसाव: जब बैकग्राउंड में तेज़ रंग की जानकारी हो (चमकदार आसमान, चटख रंग के माहौल, जटिल पैटर्न), तो वह रंग मॉडल के क्रॉस-अटेंशन के ज़रिए कैरेक्टर के पैलेट में "रिस" सकता है। कैरेक्टर के बाल या पोशाक आसपास के बैकग्राउंड तत्वों से हल्का रंग ले लेते हैं। समाधान: अपने सोर्स फ़्रेम और कंडीशनिंग प्रॉम्प्ट में तटस्थ या आउट-ऑफ़-फ़ोकस बैकग्राउंड इस्तेमाल करें।
3. टकराते LoRA वेट: जब एक साथ दो LoRA इस्तेमाल होते हैं (एक कैरेक्टर के लिए, एक समग्र स्टाइल के लिए), तो उनके वेट टकरा सकते हैं और समझौता किए हुए नतीजे दे सकते हैं। कैरेक्टर "फीका" दिखता है या स्टाइल किसी सामान्य औसत की ओर सपाट हो जाती है। समाधान: दूसरे LoRA का वेट 0.6-0.7 तक घटाएँ और मुख्य कैरेक्टर LoRA को 0.9-1.0 तक बढ़ाएँ।
ड्रिफ़्ट के सीक्वेंस बिगाड़ने से पहले स्टाइल ब्लीड कैसे पकड़ें
किसी जनरेशन को स्वीकार करने से पहले फ़्रेमों में ये तीन चीज़ें जाँचें:
- आँखों की समरूपता: एनिमे में फ़्रेमों के बीच आँखों का असममित रेंडरिंग ड्रिफ़्ट का मज़बूत संकेत है। अगर फ़्रेमों में आँखों का आकार या शक्ल अलग दिखे, तो ड्रिफ़्ट मौजूद है।
- आउटलाइन वेट सैंपलिंग: 5 रैंडम फ़्रेम चुनें और एक ही हिस्से में लाइन की मोटाई की तुलना करें। 20% से ज़्यादा फ़र्क का मतलब मोशन में साफ़ दिखने वाला ड्रिफ़्ट है।
- पैलेट सैंपलिंग: तीन फ़्रेमों में कैरेक्टर के बालों पर कलर पिकर इस्तेमाल करें। अगर किसी भी चैनल में हेक्स वैल्यू 15 अंक से ज़्यादा खिसके, तो प्लेबैक में साफ़ रंग ड्रिफ़्ट की उम्मीद करें।
ये त्वरित जाँचें कुछ सेकंड लेती हैं, लेकिन पूरे सीक्वेंस में बढ़ने से पहले ज़्यादातर कंसिस्टेंसी समस्याएँ पकड़ लेती हैं।
अपना खुद का कंसिस्टेंट एनिमे कंटेंट बनाएँ
एनिमे स्टाइल कंसिस्टेंसी की तकनीक सचमुच आज मौजूद है। सही तरीके से इस्तेमाल करने पर PicassoIA पर उपलब्ध टूल ऐसे नतीजे देते हैं जिन्हें मैन्युअल रूप से पाने के लिए हफ़्तों तक काम करने वाली बड़ी पारंपरिक एनिमेशन टीम की ज़रूरत होती।
असली फ़ायदा सिर्फ़ रफ़्तार का नहीं है। यह इटरेशन क्षमता है: जितना समय एक चित्र हाथ से बनाने में लगता, उतने में आप किसी सीन के 50 वेरिएशन बना सकते हैं, और यहाँ बताए कंसिस्टेंसी सिस्टम का इस्तेमाल करके ड्रिफ़्ट छाँटते हुए पूरे समय गुणवत्ता बनाए रख सकते हैं।
एक सिंगल एंकर इमेज से शुरू करें। अपने सीक्वेंस की लंबाई और मोशन प्रकार के लिए सही टूल चुनकर उसी से आगे बढ़ें। अगर ड्रिफ़्ट दिखे, तो उसे स्रोत पर ठीक करें: सख्त LoRA वेट, बेहतर रेफ़रेंस कंडीशनिंग, या P Video Edit से निशाना साधकर वीडियो संपादन के ज़रिए।
💡 कंसिस्टेंट एनिमे आउटपुट का सबसे तेज़ रास्ता: अपना एंकर फ़्रेम बनाएँ, उसे P Video Animate से एनिमेट करें, और नतीजे को Clarity Pro Upscaler से अपस्केल करें। यह तीन-चरणीय पाइपलाइन पाँच मिनट से कम में पूरी होती है और किसी भी रेफ़रेंस इमेज से एक कंसिस्टेंट, हाई-रिज़ोल्यूशन क्लिप बनाती है।
PicassoIA पर पूरी मॉडल लाइब्रेरी इस वर्कफ़्लो के हर चरण को कवर करती है: शुरुआती इमेज जनरेशन से लेकर टेम्पोरल कंसिस्टेंसी, अपस्केलिंग और वीडियो संपादन तक। अपना कैरेक्टर चुनें, अपना टूल चुनें, और देखें कि आप उसे कितना स्थिर बना सकते हैं।


