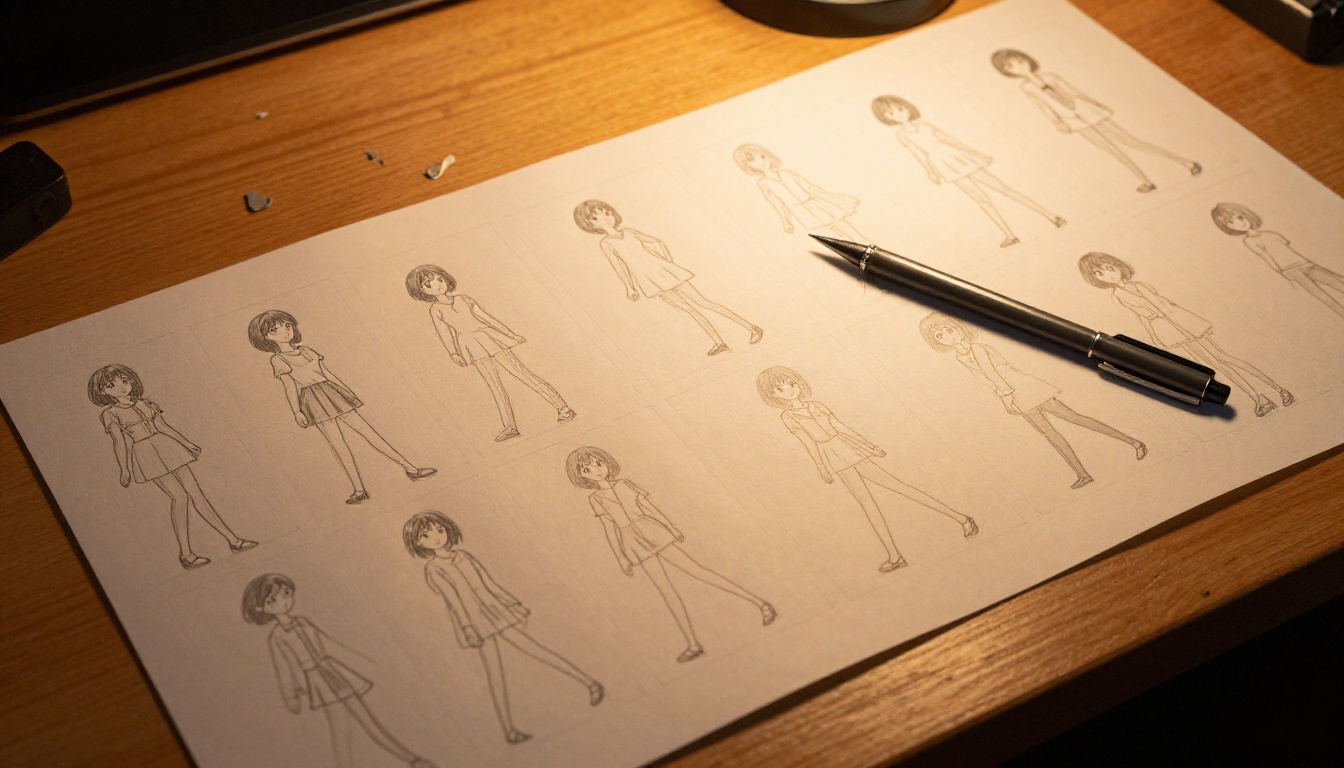
Quando a IA gera o quadro 1 do seu personagem de anime e o quadro 47 mostra uma pessoa completamente diferente, isso não é uma simples falha técnica. Você esbarrou no problema mais difícil da animação feita com IA: a consistência de estilo entre os quadros.
Isso não é um incômodo pequeno. Ele quebra toda a ilusão. O motivo pelo qual o conteúdo de anime feito com IA muitas vezes parece entrecortado, instável ou "estranho" não é que os quadros individuais sejam ruins. É que quadros consecutivos não parecem pertencer ao mesmo mundo.
Então, como os melhores sistemas de IA realmente resolvem isso? E quais ferramentas no PicassoIA acertam nesse ponto?
Por que cada quadro quer ser diferente
O problema de base é que a maioria dos modelos de difusão de imagem não tem memória.
Cada quadro é gerado a partir de uma seed de ruído, guiada pelo seu prompt. Quando você gera o quadro 2, o modelo não "lembra" como era o quadro 1. Ele simplesmente segue o prompt de novo. E mesmo com prompts idênticos, os modelos de difusão são estocásticos: uma pequena variação na distribuição do ruído produz proporções do personagem, espessura de linha, saturação de cor ou detalhes de cabelo visivelmente diferentes.
Como a deriva se parece na prática
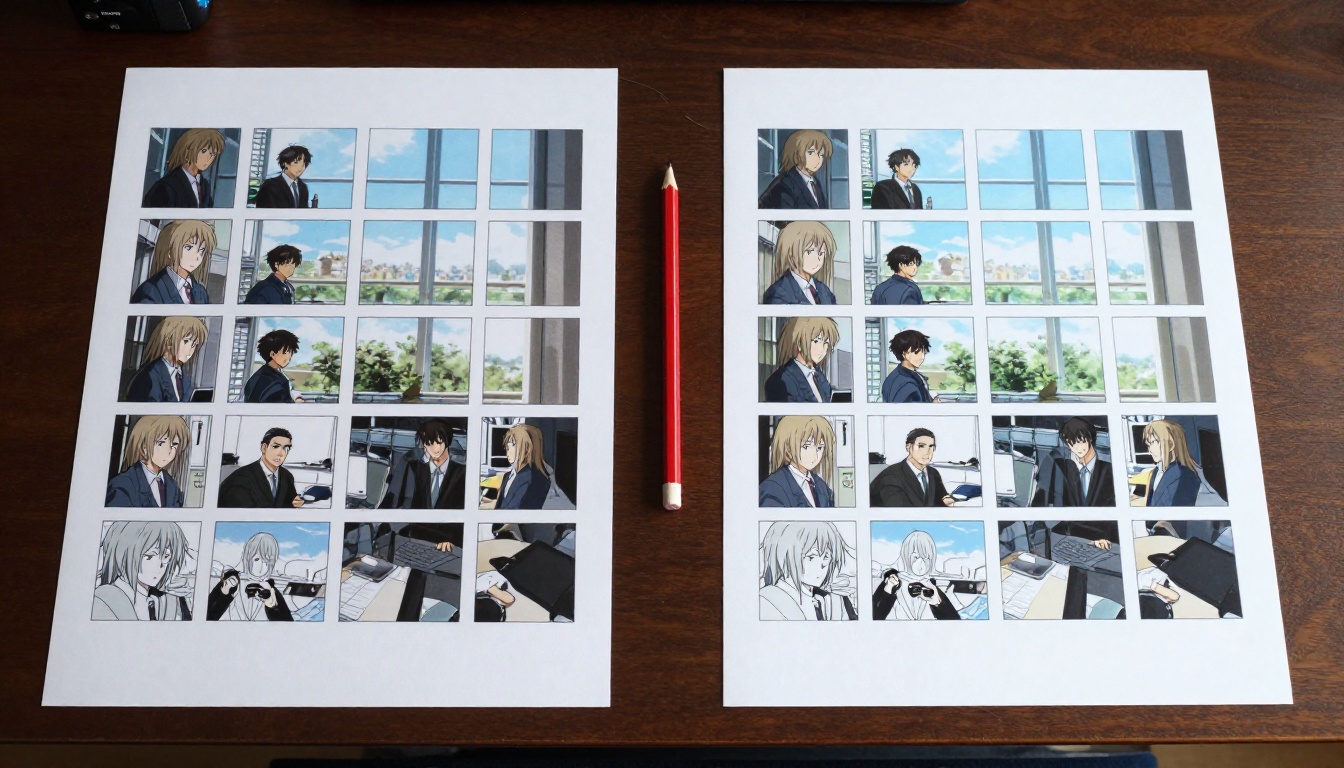
A deriva de estilo no anime feito com IA costuma aparecer em três lugares:
- Traços do personagem: Os olhos mudam de formato ou tamanho. A cor do cabelo varia de 10 a 15%. O tom da pele esquenta ou esfria entre os quadros.
- Espessura de linha: A espessura do contorno que define a estética do anime varia de forma imprevisível quando o modelo amostra a distribuição do ruído.
- Coerência da paleta de cores: As cores do fundo "respiram", mudando sutilmente em saturação ou matiz mesmo quando nada na cena deveria mudar.
O resultado é o que os animadores chamam de incoerência temporal: quadros que parecem bons isolados, mas errados como sequência.
Por que isso pesa mais no anime do que no live-action
A geração de vídeo com imagens reais tem uma certa tolerância natural. Uma leve mudança de tom na pele é lida como mudança de iluminação. Mas o anime é construído sobre sistemas visuais altamente codificados: um personagem específico tem uma paleta específica, um estilo de linha específico, um formato de olho específico. Qualquer desvio é lido de imediato como "personagem errado", e não como "iluminação diferente".
Esse é o desafio de consistência que separa as boas ferramentas de anime com IA das ótimas.
Como as redes neurais realmente codificam o estilo
Para entender como os melhores sistemas de consistência funcionam, é preciso entender o que um modelo de difusão faz quando gera um personagem de anime.
Espaço latente e estilo como coordenada
Cada imagem que um modelo de difusão gera existe como um ponto no espaço latente: uma representação matemática compacta do mundo visual que o modelo processou durante o treinamento. O estilo de um personagem não é armazenado como um conjunto de regras explícitas ("use #F5D5A8 para a pele"). É um agrupamento de coordenadas em um espaço de alta dimensão.
Quando um prompt diz "garota anime, cabelo longo preto, uniforme escolar", o modelo amostra da região do espaço latente associada a essa descrição. Mas essa região é grande. Existem milhares de interpretações válidas desse prompt, e o modelo escolhe uma com base na seed de ruído.
É por isso que o controle de seed é a primeira ferramenta básica para a consistência de estilo. Fixar a seed mantém o ponto de amostragem razoavelmente estável. Mas o controle de seed sozinho deixa de funcionar assim que o ângulo de câmera, a iluminação ou o movimento mudam, porque qualquer mudança empurra o modelo para outra vizinhança do mesmo agrupamento.
Como o modelo lê o estilo visual
A ideia central é que os sistemas de consistência mais novos não controlam apenas o prompt. Eles controlam o embedding de estilo diretamente, injetando coordenadas latentes específicas como sinais de orientação para que o modelo não consiga se afastar muito delas. Esse é o mecanismo por trás do IP-Adapter, do condicionamento por imagem de referência e de técnicas semelhantes que ferramentas do PicassoIA como ToonCrafter e AnimateDiff Prompt Travel usam por baixo dos panos.
Em vez de torcer para que o prompt seja preciso o bastante para reproduzir o mesmo estilo, essas ferramentas fixam o embedding de estilo de uma imagem de referência e o usam como um sinal constante durante toda a geração. A saída do modelo fica ancorada porque a âncora é imposta matematicamente, não apenas sugerida no texto.
Modelos LoRA: a trava de precisão para personagens
A ferramenta mais confiável para travar um personagem de anime específico em muitos quadros é uma LoRA (Low-Rank Adaptation). Entender como a LoRA funciona explica por que ela produz resultados tão estáveis.
O que a LoRA realmente altera
Um modelo de difusão padrão tem bilhões de parâmetros: os pesos numéricos que definem como ele transforma ruído em imagens. A LoRA não retreina o modelo inteiro. Em vez disso, ela injeta um pequeno conjunto de matrizes de deslocamento aprendidas que empurram a atenção do modelo na direção de padrões visuais específicos.
Pense nisso como dar ao modelo base um par de óculos calibrado para um único personagem. Toda vez que ele "olha" para o espaço de geração, enxerga com mais clareza as proporções, a paleta e o traço daquele personagem. O modelo base continua cuidando de todo o resto — iluminação, composição, fundo —, mas as características do personagem se alinham de forma confiável.
O que acontece com a consistência entre os quadros
Quando você usa uma LoRA treinada em um personagem específico e gera quadros com prompts diferentes (personagem correndo, personagem sentado, personagem olhando para a esquerda), as matrizes de deslocamento da LoRA mantêm estáveis as características que definem o personagem. Proporções do rosto, cor do cabelo e detalhes do figurino continuam ancorados mesmo quando a pose muda muito.
Por isso os pipelines profissionais de anime com IA sempre começam com LoRAs de personagem. Sem uma delas, você depende só da engenharia de prompt, o que produz deriva visível em escala.
💡 Dica prática: Uma LoRA de personagem bem treinada precisa de pelo menos 15 a 20 imagens de referência de alta qualidade, mostrando o personagem de diferentes ângulos. Mais imagens significam que a LoRA captura quais traços definem o personagem (formato do olho, comprimento do cabelo) e quais são incidentais (cor de fundo, pose).
AnimateDiff e o problema do tempo
Consistência estática e consistência temporal são problemas diferentes. Uma LoRA garante que o quadro 1 e o quadro 47 pareçam o mesmo personagem. Mas o AnimateDiff Prompt Travel enfrenta algo mais difícil: tornar a transição entre os quadros suave e coerente em termos de estilo.
O módulo de movimento: o que ele é de fato
O AnimateDiff adiciona um módulo de atenção temporal ao pipeline padrão de geração de imagens. Transformadores de imagem comuns prestam atenção às relações espaciais dentro de um único quadro. O módulo temporal presta atenção às relações entre quadros, olhando o que veio antes e o que vem depois ao gerar qualquer quadro.
Essa mudança de arquitetura é significativa. O modelo não gera mais cada quadro de forma independente. Ele gera os quadros como uma sequência, com cada quadro condicionado às representações latentes dos quadros adjacentes. O resultado é um movimento que respeita a continuidade.
Prompt travel: controlando o estilo ao longo do tempo
O AnimateDiff Prompt Travel amplia isso ao permitir especificar prompts diferentes para keyframes diferentes, com o módulo de movimento interpolando a transição. Para trabalhar a consistência de anime, isso significa que você pode fixar um prompt de estilo no quadro 1 ("personagem anime, cabelo escuro, luz quente de tarde, em pé") e outro no quadro 24 ("mesmo personagem, mesmo estilo, pose diferente"), e o sistema mantém a coerência visual ao longo da interpolação.
A consistência vem do caminho latente compartilhado: como todos os quadros passam pelas mesmas camadas de atenção temporal, eles herdam as mesmas estatísticas de estilo.
O papel do ControlNet como âncora de estilo
O ControlNet não adiciona consistência lembrando o estilo. Ele a adiciona controlando a estrutura. Quando você gera um quadro de personagem de anime com uma condição de bordas canny do ControlNet, está dizendo ao modelo: não mude a forma das coisas.
Como as bordas canny travam a composição
Um mapa de bordas canny extrai a estrutura de contorno de um quadro de referência. Quando esse mapa é usado como condição do ControlNet, cada quadro gerado precisa corresponder a essa estrutura de bordas. A IA pode variar cor e textura, mas a silhueta, as proporções e as posições dos traços principais ficam ancoradas.
No caso específico do anime, isso é poderoso porque o estilo do anime é em grande parte definido pelo traço. Se as linhas não mudam, a maior parte do que faz o anime "parecer anime" se mantém estável ao longo de toda a sequência.
Mapas de profundidade para coerência espacial
O condicionamento por mapa de profundidade do ControlNet funciona de forma parecida, mas para o layout tridimensional. Um mapa de profundidade extraído do quadro 1 define onde estão os objetos próximos e distantes. Aplicar esse mapa aos quadros seguintes mantém as relações espaciais consistentes mesmo quando o personagem se move, evitando que o fundo salte em profundidade percebida entre os quadros.
Ferramentas como o ControlVideo no PicassoIA aplicam esse princípio a sequências de vídeo, mantendo a coerência estrutural de quadro a quadro com mapas de controle extraídos.
Modelos do PicassoIA feitos para consistência
É aqui que a teoria encontra a prática. Estas são as ferramentas específicas do PicassoIA que tratam diretamente da consistência de estilo no anime.
AnimateDiff Prompt Travel
O AnimateDiff Prompt Travel é o mais próximo que existe de um motor de consistência de anime dedicado. O módulo de atenção temporal foi treinado especificamente com conteúdo animado, o que o torna particularmente eficaz para manter a estética cel-shaded e de alto contraste do anime ao longo de sequências em movimento.
ToonCrafter
O ToonCrafter foi criado para animação de ilustrações: você fornece dois keyframes e o ToonCrafter gera os quadros intermediários preservando o estilo visual das duas imagens de entrada. Para trabalhos de anime, isso é ideal em cenas com mudanças fortes de pose. A consistência do modelo vem de ser condicionado explicitamente pelos dois quadros âncora ao mesmo tempo.
ControlVideo
O ControlVideo aplica o condicionamento do ControlNet em uma sequência de vídeo. Ele aceita um vídeo de origem ou uma sequência de imagens e usa os mapas estruturais extraídos para orientar a geração, sendo particularmente eficaz quando você tem um movimento de referência que precisa ser redirecionado para uma estética de anime.
Kling v3 Motion Control
O Kling v3 Motion Control trata a consistência por um mecanismo diferente: planejamento explícito de trajetória. Antes de gerar os quadros, o modelo mapeia o caminho de movimento dos objetos e personagens principais e então gera cada quadro restrito por essa trajetória. As características do personagem permanecem consistentes porque o modelo sabe onde cada parte do personagem deve estar em cada momento.
Wan 2.7 I2V
O Wan 2.7 I2V (Image-to-Video) se destaca em preservar o estilo de uma única imagem de origem ao longo de uma sequência animada. Como a imagem de origem é usada como quadro de condicionamento, as saídas do modelo ficam ancoradas às suas estatísticas visuais: cor, textura, traço e layout espacial.
P Video Animate
O P Video Animate pega uma foto estática ou uma ilustração e a transforma em um clipe curto, mantendo intactas as características visuais da imagem de origem. Como a origem é incorporada à geração como referência direta, a identidade do personagem se preserva durante o movimento.
| Modelo | Método de consistência | Melhor para |
|---|
| AnimateDiff Prompt Travel | Módulos de atenção temporal | Sequências longas com prompts que mudam |
| ToonCrafter | Interpolação de dois keyframes | Clipes curtos entre poses definidas |
| ControlVideo | Mapas estruturais do ControlNet | Redirecionamento de movimento com transferência de estilo |
| Kling v3 Motion Control | Planejamento de trajetória | Sequências de ação guiadas pelo personagem |
| Wan 2.7 I2V | Condicionamento por imagem de origem | Animar um único quadro de referência |
| P Video Animate | Condicionamento direto pela origem | Dar vida a arte de anime estática |
Como usar o PicassoIA para um estilo de anime consistente
Aqui está um fluxo de trabalho prático em quatro etapas para obter um estilo de anime consistente com o conjunto de ferramentas do PicassoIA.
Etapa 1: Monte sua base de referência
Gere seu quadro âncora usando um modelo de texto para imagem. Esta é a aparência "canônica" do seu personagem. Salve a URL do resultado; ela se tornará sua referência para todas as etapas de geração seguintes. Gere de 3 a 4 variações do mesmo personagem em poses neutras ligeiramente diferentes e escolha a que melhor representa o estilo pretendido.
Etapa 2: Escolha sua ferramenta de consistência
Para clipes curtos (2 a 5 segundos): use o ToonCrafter com sua pose inicial e final como os dois keyframes. A interpolação ficará ancorada estilisticamente nas duas.
Para sequências mais longas (10 segundos ou mais): use o AnimateDiff Prompt Travel com prompts de keyframe que mantenham os descritores do personagem consistentes do início ao fim.
Para sequências de ação com trajetórias de movimento específicas: use o Kling v3 Motion Control ou o Wan 2.7 I2V para animar sua imagem de origem com uma trajetória guiada.
Etapa 3: Aumente a resolução e refine
Quando tiver uma sequência consistente, use o P Image Upscale ou o Clarity Pro Upscaler para deixar quadros individuais mais nítidos sem introduzir nova variação de estilo. Fazer upscaling depois da geração é mais seguro do que fazer no momento da geração: isso preserva a consistência que você já construiu.
Para sequências de vídeo, o Real ESRGAN Video aplica super-resolução em todo o clipe ao mesmo tempo, mantendo a nitidez quadro a quadro sem adicionar deriva.
Etapa 4: Edite e refine quadros problemáticos
Se quadros específicos derivarem apesar das suas ferramentas de consistência, o P Video Edit permite atingir seções individuais com prompts de texto, reescrevendo apenas os quadros problemáticos e mantendo o restante intacto. O Aleph 2 funciona de forma parecida, propagando as edições feitas em um quadro para toda a sequência.
Quando a IA ainda erra
Mesmo com todos esses sistemas, a deriva de estilo não está totalmente resolvida. Veja quando ela ainda falha e o que fazer a respeito.
As 3 falhas mais comuns
1. Transições de movimento intenso: Quando um personagem se move muito rápido entre os keyframes, os módulos de atenção temporal às vezes priorizam a coerência de movimento em vez da coerência de estilo. O personagem chega à pose certa, mas com proporções do rosto levemente diferentes. Correção: reduza a magnitude do movimento no prompt ou divida a sequência em subclipes mais curtos com quadros âncora sobrepostos.
2. Vazamento de cor do fundo para o personagem: Quando o fundo contém muita informação de cor (céu brilhante, ambientes vívidos, padrões complexos), essa cor pode "vazar" para a paleta do personagem pela atenção cruzada do modelo. O cabelo ou o figurino do personagem pega um leve tom dos elementos de fundo vizinhos. Correção: use um fundo neutro ou fora de foco no seu quadro de origem e nos prompts de condicionamento.
3. Pesos conflitantes de LoRA: Ao usar duas LoRAs ao mesmo tempo (uma para o personagem, outra para o estilo geral), os pesos podem entrar em conflito e produzir resultados comprometidos. O personagem fica "desbotado" ou o estilo se achata em uma média genérica. Correção: reduza o peso da LoRA secundária para 0,6 a 0,7 e aumente o peso da LoRA principal do personagem para 0,9 a 1,0.
Como identificar o vazamento de estilo antes que ele estrague uma sequência
Verifique estas três coisas entre os quadros antes de aceitar uma geração:
- Simetria dos olhos: No anime, a renderização assimétrica dos olhos entre os quadros é um forte sinal de deriva. Se os olhos parecem de tamanhos ou formatos diferentes de um quadro para outro, a deriva está presente.
- Amostragem do peso do contorno: Escolha 5 quadros aleatórios e compare a espessura do traço na mesma região. Mais de 20% de variação significa deriva visível em movimento.
- Amostragem da paleta: Use um conta-gotas de cor no cabelo do personagem em três quadros. Se o valor hexadecimal mudar mais de 15 pontos em qualquer canal, espere uma deriva de cor visível na reprodução.
Essas verificações rápidas levam segundos, mas pegam a maioria dos problemas de consistência antes que eles se acumulem em uma sequência inteira.
Crie seu próprio conteúdo de anime consistente
A tecnologia para a consistência de estilo no anime já está aqui, de fato. Usadas corretamente, as ferramentas disponíveis no PicassoIA produzem resultados que exigiriam uma grande equipe de animação tradicional trabalhando por semanas para alcançar manualmente.
A verdadeira vantagem não é só a velocidade. É a capacidade de iteração: você pode gerar 50 variações de uma cena no tempo que levaria para desenhar uma à mão, usando os sistemas de consistência descritos aqui para eliminar a deriva e manter a qualidade do começo ao fim.
Comece com uma única imagem âncora. Construa a partir dela usando a ferramenta certa para o tamanho da sequência e o tipo de movimento. Se notar deriva, corrija-a na origem, com pesos de LoRA mais firmes, melhor condicionamento por referência ou edição de vídeo direcionada com o P Video Edit.
💡 O caminho mais rápido para um resultado de anime consistente: gere sua imagem âncora, dê movimento a ela com o P Video Animate e faça o upscaling do resultado com o Clarity Pro Upscaler. Esse fluxo de três etapas leva menos de cinco minutos e produz um clipe consistente e de alta resolução a partir de qualquer imagem de referência.
A biblioteca completa de modelos do PicassoIA cobre cada etapa desse fluxo de trabalho: da geração inicial de imagens à consistência temporal, passando pelo upscaling e pela edição de vídeo. Escolha seu personagem, escolha sua ferramenta e veja o quão estável você consegue deixá-lo.


