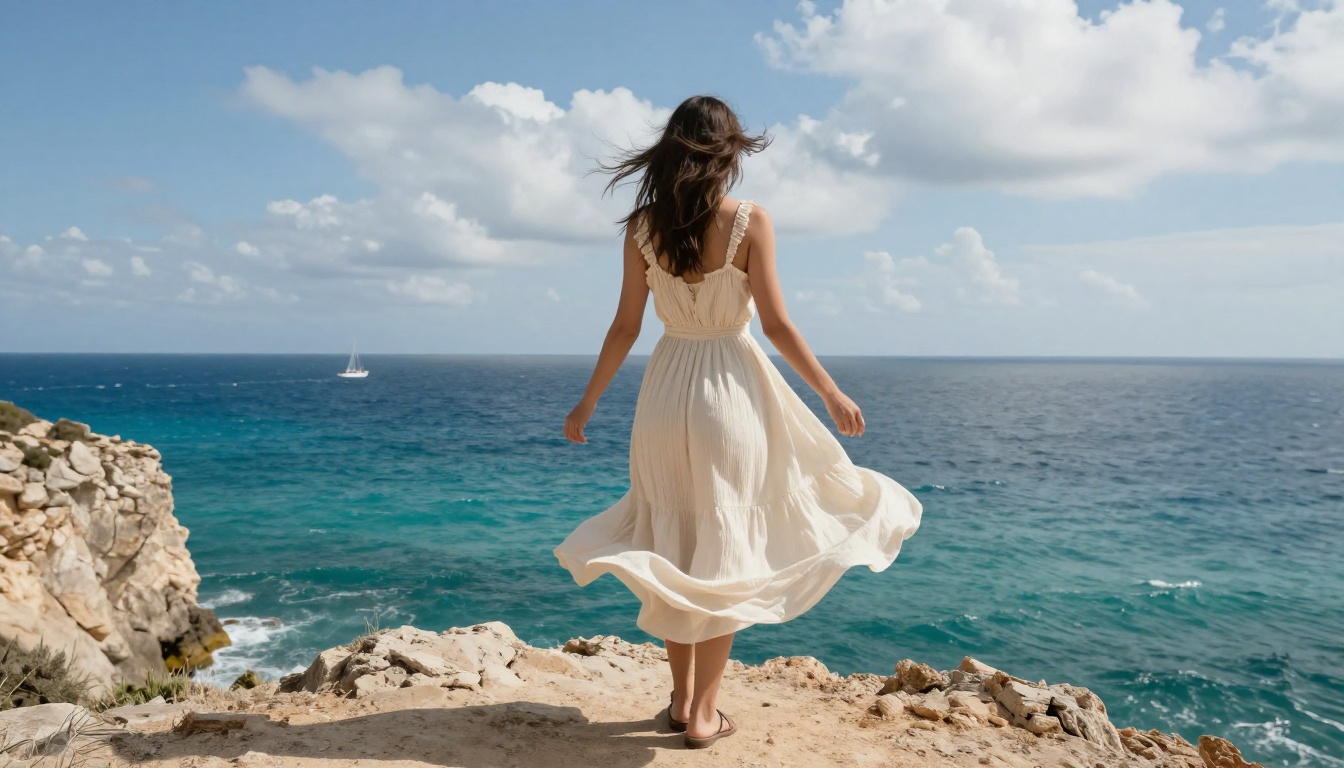
Las fotografías siempre han sido contenedores de tiempo. Capturan un instante único, lo comprimen sobre una superficie y lo mantienen ahí mientras el soporte aguante. Pero las fotografías no son realmente estáticas. En el momento en que se tomaron, estaban llenas de movimiento que simplemente se detuvo. Una ráfaga de viento doblaba ese árbol. Su pelo estaba a mitad de un vaivén. El agua estaba cayendo.
Los modelos de IA actuales pueden leer lo que contiene una fotografía y sintetizar cómo se habría visto un segundo después, dos segundos después, diez segundos después. El momento congelado sigue moviéndose. Y los resultados, cuando se hacen bien, son indistinguibles de una grabación real.
Esto es la IA de imagen a video (I2V). Aquí tienes exactamente cómo funciona, por qué importa y qué herramientas producen hoy los resultados más convincentes.
Qué significa realmente "animar una foto"
El término se estira para cubrir desde efectos de paralaje baratos hasta una síntesis de movimiento genuina. La distinción importa, porque los resultados son categorías de cosas completamente distintas.
Un fotograma. Movimiento sin límite.
La IA I2V real toma una sola imagen como única entrada visual y genera una secuencia de fotogramas que continúa de forma natural a partir de ella. El modelo no repite la imagen en bucle. No aplica un filtro predefinido. Sintetiza nuevos datos de píxeles a lo largo del tiempo, fotograma a fotograma, inventando contenido que nunca se capturó pero que es estadísticamente coherente con lo que sí se capturó.
Esto es una operación realmente nueva en los medios visuales. La fotografía captura un momento. La videografía registra una duración. La I2V crea duración a partir de un momento.
Por qué esto no es solo un filtro
Las apps de teléfono que "animan" fotos suelen usar paralaje con mapa de profundidad: la imagen se segmenta en capas según la profundidad estimada, y esas capas se desplazan de forma independiente para simular movimiento de cámara. El fondo se mueve más despacio que el primer plano. Produce una ilusión 2.5D convincente durante unos tres segundos, hasta que el bucle se vuelve evidente.
Los modelos I2V modernos hacen algo de una complejidad completamente distinta. Generan valores de píxeles totalmente nuevos para cada fotograma, guiados por la física de cómo es probable que se comporten los objetos de la escena. El pelo no solo se desplaza lateralmente. Se separa en mechones, cada uno siguiendo una trayectoria ligeramente distinta. El agua no se inclina. Ondula a la frecuencia correcta para su profundidad aparente. La tela se arruga y se alisa según la física de tensión que el modelo absorbió durante el entrenamiento.
La diferencia de calidad se ve de inmediato. Y, más importante, la diferencia en utilidad creativa es enorme.
La tecnología que hay detrás
Tres mecanismos básicos hacen posible la I2V. Entenderlos hace que los resultados sean más predecibles y te ayuda a escribir mejores prompts de movimiento.
Modelos de difusión y ruido temporal
La mayoría de los sistemas I2V más avanzados se construyen sobre modelos de difusión de video, una extensión de la arquitectura de difusión de imagen que impulsa los generadores de imágenes fijas. El proceso funciona así: la imagen de origen se trata como el fotograma 0, la condición de anclaje. Cada fotograma posterior se inicializa como ruido aleatorio. El modelo está entrenado para eliminar el ruido de esa secuencia temporal de forma iterativa, de manera que sea visualmente coherente, físicamente plausible y esté conectada causalmente con el primer fotograma.
Durante la generación, el modelo toma la imagen de anclaje más ruido aleatorio para los fotogramas del 1 al N, y los refina a lo largo de decenas de pasos de eliminación de ruido. Cada paso se pregunta: dado lo que muestra el fotograma 0 y la estimación ruidosa actual de lo que viene después, ¿cómo debería verse este fotograma? Tras suficientes pasos de refinamiento, la respuesta es un video suave y continuo.
Esto funciona tan bien porque los modelos de difusión de video se entrenan con miles de millones de secuencias de video junto con sus primeros fotogramas. El modelo absorbe una cantidad enorme de información estadística sobre cómo evolucionan las escenas con el tiempo y aplica ese conocimiento a cada nueva imagen que recibe.
Flujo óptico y estimación de profundidad
Antes de sintetizar el movimiento, muchos modelos calculan dos representaciones internas de la escena:
- Mapas de flujo óptico: campos vectoriales que describen la dirección y velocidad probables de cada región de píxeles
- Mapas de profundidad: una estimación, píxel a píxel, de la distancia a la cámara, inferida a partir de sombreado, perspectiva y gradientes de textura
Estas representaciones condicionan el proceso de generación. Una región estimada a 2 metros de la cámara recibe una dinámica de movimiento distinta de otra a 20 metros. Un rostro en primer plano recibe micromovimientos de expresión y de respiración. Una montaña en el fondo apenas se mueve.
Efecto práctico: Cuando subes un retrato en la playa a un modelo I2V, el modelo estima que la arena está cerca, el agua a media distancia y el horizonte lejos. Cada capa recibe una física de movimiento acorde con su profundidad antes de que empiece la generación. Por eso una buena salida I2V tiene paralaje natural sin que nadie lo especifique.
Cómo predice el modelo el movimiento
Durante la generación no se ejecuta ninguna simulación física explícita. El modelo no tiene un motor de física. Tiene datos de entrenamiento.
Los modelos se entrenan con videos que contienen pelo al viento, telas en movimiento, superficies de agua, fuego, humo y miles de otros elementos dinámicos, todos emparejados con sus primeros fotogramas. El modelo construye priores estadísticos sobre lo que tiende a pasar en escenas con esos elementos y los aplica cuando se encuentra con primeros fotogramas parecidos.
Cuando el modelo ve una foto de una mujer en un campo, reconoce la semántica visual: trigo, mujer, cielo abierto, tela. Recupera los comportamientos de movimiento aprendidos para cada elemento y los sintetiza en una secuencia de animación coherente. El movimiento no se calcula físicamente. Se recuerda estadísticamente.
I2V frente a T2V: ¿cuál es la diferencia?
Ambas categorías producen video con IA. Lo que las separa es la entrada.
| Tipo de modelo | Entrada | Salida | Mejor para |
|---|
| I2V (imagen a video) | 1 imagen + texto opcional | Video que parte de esa imagen | Animar tus fotos |
| T2V (texto a video) | Solo un prompt de texto | Video generado desde cero | Crear escenas nuevas |
| I2V con prompt de movimiento | Imagen + descripción del movimiento | Animación guiada de esa imagen | Control creativo preciso |
Para animar tus propias fotografías, la I2V es la única categoría correcta. Los modelos T2V no tienen ninguna obligación de parecerse a tu imagen de origen. Generan lo que describe el prompt, no lo que contiene tu foto concreta.
En un flujo I2V, el prompt de texto funciona como una instrucción de movimiento, no como una descripción de la escena. No describes lo que ya aparece en la foto. Describes lo que debe pasarle: "pelo que se mueve suavemente con el viento, tela ondulando, un lento avance de cámara hacia delante". El modelo ya ve la imagen. Necesita una dirección de movimiento, no una narración de la escena.
Los mejores modelos para animar fotos
Varios modelos se han convertido en referencias de calidad I2V. Así se diferencian en la práctica.
Wan 2.6 I2V: potencia pura
Wan 2.6 I2V de Wan Video es uno de los modelos I2V de pesos abiertos más potentes disponibles. Maneja escenas complejas con varios sujetos, mantiene la coherencia de identidad entre fotogramas y produce movimiento que respeta la iluminación y las relaciones de profundidad de la imagen original.
Para una entrega más rápida sin una pérdida importante de calidad, Wan 2.6 I2V Flash reduce bastante el tiempo de generación y conserva la calidad de movimiento principal. Las versiones anteriores, Wan 2.5 I2V y Wan 2.5 I2V Fast, siguen siendo sólidas para animar retratos en 720p.
Kling v2.6: movimiento cinematográfico
Kling v2.6 Motion Control de Kwaivgi se distingue por la especificación del movimiento de cámara. Puedes controlar no solo qué se mueve dentro de la escena, sino también cómo se comporta la cámara virtual de forma independiente: avance lento, arco, órbita. Los resultados se parecen menos a una "foto animada" y más a una grabación real de una cámara físicamente presente.
Kling v3 Motion Control amplía esto con la especificación de movimiento por sujeto, lo que permite que distintos elementos del encuadre reciban instrucciones de movimiento independientes.
Hailuo 2.3 Fast: velocidad sin sacrificios
Hailuo 2.3 Fast de Minimax entrega salida en 1080p en una fracción del tiempo que requieren la mayoría de los modelos estándar. Para creadores de contenido que necesitan volumen, es el caballo de batalla de producción. La fidelidad del movimiento es especialmente sólida en retratos y rostros.
Video 01 Live: especialista en retratos
Video 01 Live se diseñó específicamente para animar imágenes fijas. Se centra en el realismo de los retratos: micro-expresiones faciales, movimiento natural de los ojos, respiración sutil y dinámica del pelo. Para animar fotos de personas, es una de las opciones más naturalistas disponibles.
Para un I2V gratuito de nivel básico a 720p, Wan 2.1 I2V 720p de Wavespeed AI ofrece resultados fiables sin barreras de costo.
Elección rápida: ¿Trabajo de cámara cinematográfico? Usa Kling. ¿Producción de contenido en gran volumen? Usa Hailuo. ¿El movimiento ambiental más naturalista? Usa Wan 2.6. ¿Realismo en retratos? Usa Video 01 Live.
Cómo ha cambiado la calidad
La mejora de la I2V desde 2023 ha sido muy notable. La tabla siguiente muestra los avances técnicos concretos que la impulsaron.
| Qué mejoró | Efecto en la salida |
|---|
| Conjuntos de entrenamiento más grandes | Priores de movimiento más realistas y variados |
| Arquitecturas con conciencia 3D | Los objetos rotan correctamente en lugar de solo desplazarse |
| Mecanismos de atención temporal | Se mantuvo la coherencia en secuencias más largas |
| Entrenamiento con mayor resolución | Se conservan los detalles finos del pelo, la tela y la piel |
| Señales de condicionamiento del movimiento | Control del usuario sobre la velocidad y la dirección |
Kling v2.1 representó la generación que hizo fiable la I2V para sujetos complejos. Modelos actuales como Kling v3 Omni Video y Wan 2.6 I2V acercan la animación fotorrealista a cualquiera que tenga una biblioteca de fotos y un navegador.
Qué fotos funcionan mejor
No todas las fotografías se animan igual de bien. La composición tiene un efecto importante en la calidad de la salida.
Consejos de composición que mejoran la salida
El aislamiento del sujeto importa. Las fotos en las que el sujeto principal está claramente separado del fondo (mediante poca profundidad de campo, contraste de iluminación o separación espacial) dan al modelo límites de movimiento más limpios. El modelo necesita deducir dónde termina el sujeto y dónde empieza el fondo. El desenfoque ayuda.
Los contextos de movimiento naturales dan los mejores resultados. El pelo, la tela, el agua, las llamas, el humo y la vegetación son elementos que el modelo ha visto en movimiento miles de millones de veces. Se animan con una física predecible y convincente. La arquitectura de bordes duros y los objetos estáticos hechos por el ser humano tienden a producir una animación menos atractiva, a menos que el prompt de movimiento se centre en el movimiento de la cámara y no en el del sujeto.
La luz suave y uniforme genera una salida más fluida. Las sombras duras con luz lateral o las imágenes de alto contraste pueden causar artefactos de parpadeo, porque el modelo tiene dificultades para mantener la coherencia de las sombras entre fotogramas. La luz nublada, la hora dorada o la iluminación difusa de estudio producen las animaciones más suaves.
Una mayor resolución de entrada da más información al modelo. Una imagen de origen de 1024 píxeles de ancho supera a un JPEG comprimido de 640 píxeles. El modelo reconstruye detalles durante la generación, pero solo puede trabajar con lo que le aporta el origen.
Errores comunes que arruinan los resultados
- Prompts de movimiento que compiten entre sí. Pedir "persona caminando, viento soplando, cámara alejándose y olas rompiendo" a la vez confunde la síntesis de movimiento. Una sola dirección de movimiento dominante por generación produce una salida más limpia.
- Esperar cambios de expresión dramáticos. Los modelos I2V están entrenados para conservar la identidad del sujeto. Manejan bien los micro-gestos sutiles, pero no están diseñados para grandes movimientos faciales. Lo sutil resulta más natural.
- Usar imágenes muy editadas o compuestas. Las fotos con una corrección de color extrema, retoques intensos o elementos compuestos evidentes alteran los priores de profundidad y de movimiento del modelo. Una foto más cercana al original en bruto da mejores resultados.
- Ignorar los requisitos de bucle. Si quieres que la animación se repita sin cortes para redes sociales, especifica el comportamiento de bucle en el prompt o procesa el clip resultante en un editor de video después. La mayoría de los modelos no generan bucles perfectos por defecto.
Usos reales ahora mismo
La I2V ha dejado atrás hace tiempo la novedad. Estas son las aplicaciones prácticas que ya se usan en producción activa.
Contenido para redes que detiene el scroll
Las imágenes estáticas en los feeds suelen tener tasas de interacción más bajas que el video. La I2V ofrece un término medio: tomas una fotografía (más rápido, más barato y más fácil que una producción de video) y la animas en un clip de 5 segundos. El resultado conserva la calidad visual de la fotografía con el rendimiento en el feed del video.
Las marcas de moda, las cuentas de viajes, los fotógrafos de comida y las agencias inmobiliarias ya aplican este flujo de trabajo. Una sola sesión de retratos produce tanto recursos fijos como contenido de video a partir de los mismos archivos originales.
Trabajo de portafolio y narrativa visual
Los fotógrafos y artistas visuales usan la I2V para crear portafolios en movimiento a partir de su obra fija. Una serie de paisajes se convierte en un reel cinematográfico. Una sesión de retratos genera contenido de video sin reservar una sesión de video aparte.
Para el movimiento corporal y la animación de personajes, Dreamactor M2.0 de ByteDance permite la síntesis de movimiento de cuerpo completo a partir de un video de referencia, lo que hace accesible una animación compleja sin conocimientos de animación. Kling Avatar v2 se encarga de la animación guiada por el rostro, útil para contenido de presentadores y de personas que hablan a cámara.
Conservar los recuerdos familiares
Las fotografías antiguas impresas pueden digitalizarse y animarse, añadiendo una dimensión temporal a los archivos familiares. Modelos como I2VGen XL de Ali-Vilab se diseñaron para manejar una gran variedad de tipos de imagen, incluidas entradas históricas, de baja resolución o con iluminación poco convencional.
Para la animación guiada por audio, Audio to Video de Lightricks genera movimiento sincronizado con una pista de audio proporcionada. Sube una fotografía familiar y una pieza de música, y el modelo crea una animación en la que el movimiento sigue el ritmo y el carácter emocional del sonido.
Prompts de movimiento: escribir para el movimiento
Escribir prompts I2V eficaces es una habilidad distinta de escribir prompts para generar imágenes. El modelo ya ve la imagen. Necesita una instrucción de movimiento, no una descripción de la escena.
Prompt débil: "Una mujer de pie en un campo con el pelo suelto, con un vestido blanco"
Esto describe la imagen. El modelo ya tiene la imagen.
Prompt sólido: "El pelo y el vestido ondulan suavemente con una brisa leve, los tallos de trigo se mecen a una frecuencia natural, la cámara avanza lentamente hacia la izquierda, la luz cálida de la tarde se mantiene estable"
Esto describe lo que debería pasar. Ahora el modelo tiene una dirección.
Estructura eficaz de un prompt de movimiento:
- Movimiento del sujeto: lo que hace la persona o el objeto principal
- Movimiento del entorno: viento, agua, cambios de luz en el fondo
- Comportamiento de la cámara: paneo, avance, inclinación, órbita o plano fijo
- Calificador de intensidad: suave, lento, sutil, dramático, rápido
Consejo para el prompt: Un único evento de movimiento coherente da mejores resultados que varias instrucciones en competencia. "Brisa suave en la escena con un lento avance de cámara" es más eficaz que seis movimientos simultáneos tirando en direcciones distintas.
El vocabulario que funciona siempre bien en los prompts I2V tiende a venir de la cinematografía y de la escritura sobre la naturaleza: "drift", "ripple", "sway", "settle", "billow", "rack focus", "push in", "pull back". Estos términos aparecen con frecuencia en contextos de movimiento en los datos de entrenamiento, y los modelos responden a ellos con precisión.
En el caso concreto del pelo, "fluyendo suavemente", "agitado por el viento" o "mechones sueltos que atrapan la brisa" producen resultados más naturales que un genérico "pelo moviéndose". Para el agua, "rizado suave en la superficie", "ola suave" y "quieta, con reflejos cambiando" se corresponden con comportamientos concretos que el modelo ha visto y puede reproducir.
Tus fotos ya son video
Cada fotografía que has tomado contiene movimiento que se detuvo en el obturador. Los modelos de IA de 2027 tienen suficiente inteligencia visual para leer ese movimiento detenido y continuarlo, sintetizando video a partir de un solo fotograma con resultados que resisten un escrutinio serio.
No es una función de novedad para fotos antiguas. Es una herramienta de producción práctica que se sitúa entre la fotografía y la videografía, cubriendo un hueco que no tenía solución hasta hace poco. Una fotografía profesional que antes producía un solo entregable ahora produce dos: la imagen fija y el clip animado.
Picasso IA pone a disposición de su navegador más de 80 modelos de I2V y síntesis de movimiento. Desde opciones rápidas como Wan 2.6 I2V Flash, que devuelven resultados en segundos, hasta herramientas de calidad cinematográfica como Kling v2.6 Motion Control, que te dan un control preciso sobre el movimiento de la cámara y del sujeto, toda la gama está disponible sin necesidad de hardware local ni instalación.
Toma una fotografía de tu biblioteca. Escribe un prompt de movimiento. Descubre qué estaba sosteniendo quieto.