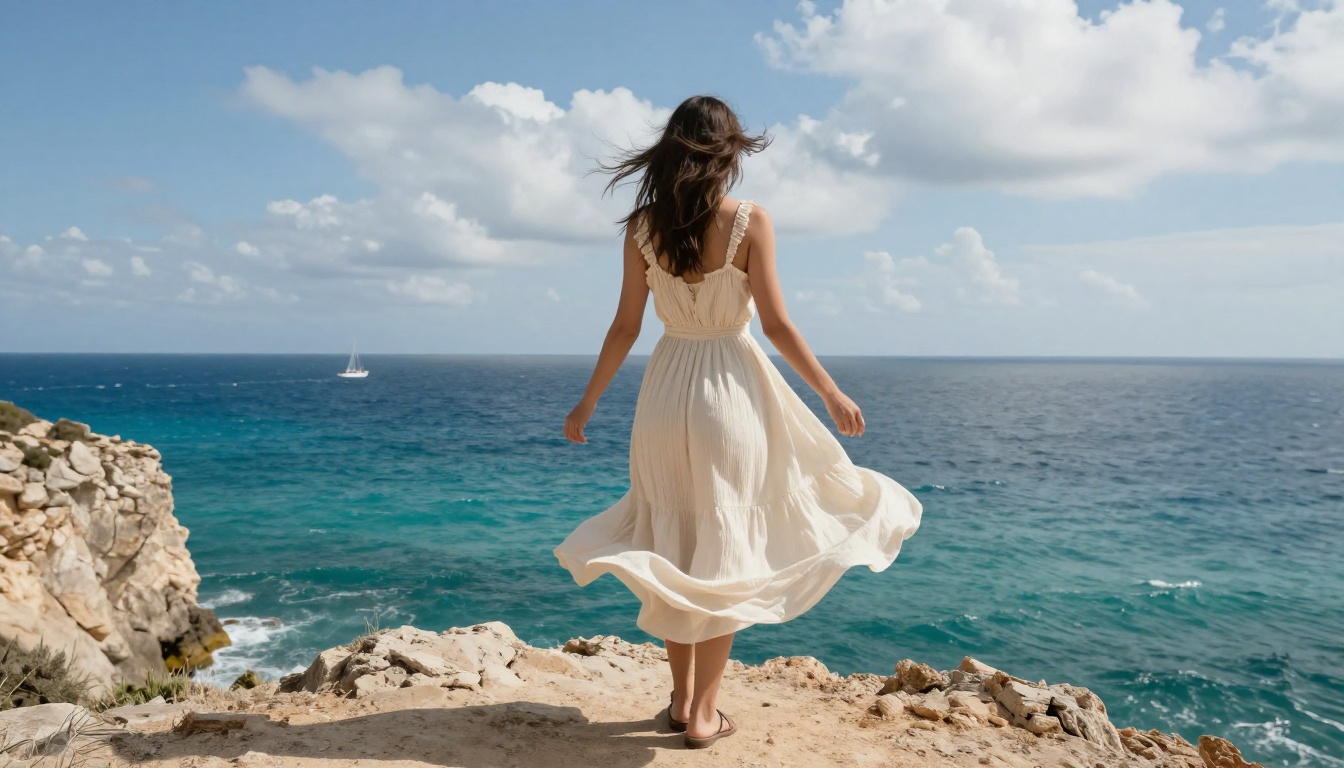
Les photographies ont toujours été des conteneurs de temps. Elles captent un instant unique, le compressent sur une surface et le conservent aussi longtemps que le support survit. Pourtant, les photographies ne sont pas vraiment statiques. Au moment où elles ont été prises, elles étaient pleines de mouvement qui s’est simplement arrêté. Un coup de vent faisait plier cet arbre. Ses cheveux étaient en plein balancement. L’eau tombait.
Les modèles d’IA actuels savent lire ce que contient une photographie et synthétiser à quoi elle ressemblerait une seconde plus tard, deux secondes plus tard, dix secondes plus tard. L’instant figé se remet en mouvement. Et les résultats, lorsque le travail est bien fait, sont impossibles à distinguer d’une véritable séquence filmée.
C’est ce que fait l’image vers vidéo (I2V) grâce à l’IA. Voici son fonctionnement exact, pourquoi cela compte et quels outils produisent aujourd’hui les résultats les plus convaincants.
Ce que signifie vraiment « animer une photo »
Le terme est étiré pour couvrir aussi bien de simples effets de parallaxe bon marché que la véritable synthèse de mouvement. La distinction compte, car les résultats appartiennent à des catégories totalement différentes.
Une image. Un mouvement illimité.
Une véritable IA I2V prend une seule image comme unique entrée visuelle et génère une séquence d’images qui se prolongent naturellement à partir d’elle. Le modèle ne fait pas boucler l’image. Il n’applique pas de filtre prédéfini. Il synthétise de nouvelles données de pixels dans le temps, image après image, en inventant un contenu qui n’a jamais été capturé mais qui est statistiquement cohérent avec ce qui l’a été.
C’est une opération réellement nouvelle dans le domaine des médias visuels. La photographie capture un instant. La vidéo enregistre une durée. L’I2V crée une durée à partir d’un instant.
Pourquoi ce n’est pas qu’un filtre
Les applications de smartphone qui « animent » les photos utilisent généralement une parallaxe par carte de profondeur : l’image est découpée en couches selon une profondeur estimée, et ces couches se déplacent indépendamment pour simuler un mouvement de caméra. L’arrière-plan bouge plus lentement que le premier plan. On obtient une illusion 2,5D convaincante pendant environ trois secondes, avant que la boucle ne devienne évidente.
Les modèles I2V modernes font quelque chose de bien plus complexe. Ils génèrent de nouvelles valeurs de pixels pour chaque image, en tenant compte de la physique du comportement probable des objets de la scène. Les cheveux ne se contentent pas de glisser latéralement. Ils se séparent en mèches, chacune suivant une trajectoire légèrement différente. L’eau ne s’incline pas. Elle ondule à la fréquence correcte pour sa profondeur apparente. Le tissu se froisse et se défroisse selon une physique de la tension que le modèle a assimilée pendant son entraînement.
La différence de qualité est immédiatement visible. Plus important encore, la différence d’utilité créative est énorme.
La technologie qui se cache derrière
Trois mécanismes principaux rendent l’I2V possible. Les comprendre rend les résultats plus prévisibles et vous aide à rédiger de meilleurs prompts de mouvement.
Modèles de diffusion et bruit temporel
La plupart des systèmes I2V de pointe reposent sur des modèles de diffusion vidéo, une extension de l’architecture de diffusion d’images qui alimente les générateurs d’images fixes. Le processus fonctionne ainsi : l’image source est traitée comme l’image 0, la condition d’ancrage. Chaque image suivante est initialisée sous forme de bruit aléatoire. Le modèle est entraîné à débruiter itérativement cette séquence temporelle de manière visuellement cohérente, physiquement plausible et liée causalement à la première image.
Pendant la génération, le modèle prend l’image d’ancrage plus du bruit aléatoire pour les images 1 à N, et les affine sur plusieurs dizaines d’étapes de débruitage. À chaque étape, il se pose la question suivante : étant donné ce que montre l’image 0 et l’estimation bruitée actuelle de ce qui vient ensuite, à quoi doit ressembler cette image ? Après assez d’étapes d’affinage, la réponse est une vidéo lisse et continue.
Si cela fonctionne si bien, c’est que les modèles de diffusion vidéo sont entraînés sur des milliards de séquences vidéo accompagnées de leurs premières images. Le modèle assimile une quantité considérable d’informations statistiques sur la façon dont les scènes évoluent dans le temps, et applique ce savoir à chaque nouvelle image qu’il reçoit.
Flux optique et estimation de la profondeur
Avant de synthétiser le mouvement, de nombreux modèles calculent deux représentations internes de la scène :
- Cartes de flux optique : champs vectoriels décrivant la direction et la vitesse probables de chaque zone de pixels
- Cartes de profondeur : une estimation, pixel par pixel, de la distance à la caméra, déduite des ombres, de la perspective et des gradients de texture
Ces représentations conditionnent le processus de génération. Une zone estimée à 2 mètres de la caméra reçoit une dynamique de mouvement différente de celle d’une zone située à 20 mètres. Un visage au premier plan se voit attribuer des micro-expressions et un mouvement de respiration. Une montagne en arrière-plan bouge à peine.
Effet concret : lorsque vous importez un portrait de plage dans un modèle I2V, celui-ci estime que le sable est proche, que l’eau se trouve à mi-distance et que l’horizon est loin. Chaque couche reçoit une physique de mouvement adaptée à sa profondeur avant même le début de la génération. C’est pourquoi une bonne sortie I2V présente une parallaxe naturelle sans que personne ne l’ait précisée.
Comment le modèle prédit le mouvement
Aucune simulation physique explicite ne tourne pendant la génération. Le modèle n’a pas de moteur physique. Il a des données d’entraînement.
Les modèles sont entraînés sur des vidéos contenant des cheveux au vent, des tissus en mouvement, des surfaces d’eau, du feu, de la fumée et des milliers d’autres éléments dynamiques, tous associés à leurs premières images. Le modèle construit des a priori statistiques sur ce qui tend à se produire dans les scènes contenant ces éléments, et les applique lorsqu’il rencontre des premières images similaires.
Lorsque le modèle voit la photo d’une femme dans un champ, il reconnaît la sémantique visuelle : blé, femme, ciel ouvert, tissu. Il récupère les comportements de mouvement appris pour chaque élément et les synthétise en une séquence d’animation cohérente. Le mouvement n’est pas calculé physiquement. Il est statistiquement mémorisé.
I2V ou T2V : quelle est la différence ?
Les deux catégories produisent des vidéos grâce à l’IA. C’est l’entrée qui les distingue.
| Type de modèle | Entrée | Sortie | Idéal pour |
|---|
| I2V (image vers vidéo) | 1 image + texte facultatif | Vidéo partant de cette image | Animer vos photos |
| T2V (texte vers vidéo) | Prompt textuel uniquement | Vidéo générée à partir de zéro | Créer de nouvelles scènes |
| I2V avec prompt de mouvement | Image + description du mouvement | Animation guidée de cette image | Un contrôle créatif précis |
Pour animer vos propres photographies, l’I2V est la seule bonne catégorie. Les modèles T2V n’ont aucune obligation de ressembler à votre image source. Ils génèrent ce que décrit le prompt, et non ce que contient votre photo en particulier.
Dans un flux de travail I2V, le prompt textuel fonctionne comme une instruction de mouvement, et non comme une description de scène. Vous ne décrivez pas ce qui se trouve déjà sur la photo. Vous décrivez ce qui doit lui arriver : « des cheveux qui flottent doucement dans le vent, un tissu qui ondule, un lent travelling avant de la caméra ». Le modèle voit l’image. Il a besoin d’une direction de mouvement, pas d’une narration de la scène.
Les meilleurs modèles pour animer des photos
Plusieurs modèles sont devenus les références de la qualité I2V. Voici comment ils se distinguent en pratique.
Wan 2.6 I2V : la puissance brute
Wan 2.6 I2V de Wan Video compte parmi les modèles I2V à poids ouverts les plus performants disponibles. Il gère des scènes complexes avec plusieurs sujets, conserve la cohérence des identités d’une image à l’autre et produit un mouvement qui respecte l’éclairage et les relations de profondeur de l’image d’origine.
Pour un délai de génération plus court sans perte notable de qualité, Wan 2.6 I2V Flash réduit nettement le temps de génération tout en préservant la qualité de mouvement de base. Les versions antérieures, Wan 2.5 I2V et Wan 2.5 I2V Fast, restent solides pour l’animation de portraits en 720p.
Kling v2.6 : mouvement cinématographique
Kling v2.6 Motion Control de Kwaivgi se distingue par la précision de ses mouvements de caméra. Vous contrôlez non seulement ce qui bouge dans la scène, mais aussi la façon dont la caméra virtuelle se comporte de manière indépendante : travelling lent, arc, orbite. Les résultats ressemblent moins à une « photo animée » et davantage à des images réelles tournées par une caméra physiquement présente.
Kling v3 Motion Control prolonge cette approche avec une spécification du mouvement par sujet, permettant à différents éléments du cadre de recevoir des instructions de mouvement indépendantes.
Hailuo 2.3 Fast : la vitesse sans sacrifice
Hailuo 2.3 Fast de Minimax produit une sortie en 1080p en une fraction du temps que requièrent la plupart des modèles standard. Pour les créateurs de contenu qui ont besoin de volume, c’est le cheval de trait de la production. La fidélité du mouvement est particulièrement remarquable sur les sujets de portrait et les visages.
Video 01 Live : le spécialiste du portrait
Video 01 Live a été conçu spécifiquement pour animer des images fixes. Il met l’accent sur le réalisme des portraits : micro-expressions faciales, mouvements naturels des yeux, respiration subtile et dynamique des cheveux. Pour animer des photos de personnes, c’est l’une des options les plus naturalistes disponibles.
Pour une I2V d’entrée de gamme gratuite en 720p, Wan 2.1 I2V 720p de Wavespeed AI offre des résultats fiables sans barrière financière.
Orientation rapide : travail de caméra cinématographique ? Utilisez Kling. Production de contenu en grand volume ? Utilisez Hailuo. Mouvement ambiant le plus naturel ? Utilisez Wan 2.6. Réalisme du portrait ? Utilisez Video 01 Live.
Comment la qualité a évolué
Les progrès de l’I2V depuis 2023 ont été spectaculaires. Le tableau ci-dessous présente les avancées techniques précises qui les ont rendus possibles.
| Ce qui s’est amélioré | Effet sur le résultat |
|---|
| Jeux de données d’entraînement plus vastes | Des a priori de mouvement plus réalistes et variés |
| Architectures sensibles à la 3D | Les objets tournent correctement au lieu de simplement glisser |
| Mécanismes d’attention temporelle | La cohérence se maintient sur des séquences plus longues |
| Entraînement en plus haute résolution | Détails fins des cheveux, des tissus et de la peau préservés |
| Signaux de conditionnement du mouvement | Contrôle utilisateur sur la vitesse et la direction |
Kling v2.1 a représenté la génération qui a rendu l’I2V fiable pour les sujets complexes. Les modèles actuels comme Kling v3 Omni Video et Wan 2.6 I2V mettent une animation photoréaliste à la portée de quiconque possède une photothèque et un navigateur.
Quelles photos fonctionnent le mieux
Toutes les photographies ne s’animent pas aussi bien. La composition a un effet significatif sur la qualité du résultat.
Conseils de composition pour améliorer le résultat
L’isolation du sujet compte. Les photos où le sujet principal se détache clairement de l’arrière-plan (grâce à une faible profondeur de champ, à un contraste d’éclairage ou à une séparation spatiale) offrent au modèle des limites de mouvement plus nettes. Le modèle doit déduire où le sujet s’arrête et où commence l’arrière-plan. Le flou aide.
Les contextes de mouvement naturels donnent les meilleurs résultats. Les cheveux, les tissus, l’eau, les flammes, la fumée et la végétation sont des éléments que le modèle a vus en mouvement des milliards de fois. Ils s’animent avec une physique prévisible et convaincante. L’architecture aux lignes dures et les objets statiques fabriqués par l’homme produisent généralement une animation moins convaincante, sauf si le prompt de mouvement se concentre sur le mouvement de caméra plutôt que sur celui du sujet.
Un éclairage doux et uniforme génère une sortie plus fluide. Les ombres latérales dures ou les images très contrastées peuvent provoquer des artefacts de scintillement, car le modèle peine à maintenir la cohérence des ombres d’une image à l’autre. La lumière couverte, l’heure dorée ou un éclairage de studio diffus produisent les animations les plus fluides.
Une résolution d’entrée plus élevée fournit davantage d’informations au modèle. Une image source de 1024 pixels de large donne de meilleurs résultats qu’un JPEG compressé de 640 pixels. Le modèle reconstruit des détails pendant la génération, mais il ne peut travailler qu’avec ce que la source lui fournit.
Les erreurs courantes qui ruinent les résultats
- Des prompts de mouvement concurrents. Demander simultanément « une personne qui marche, du vent qui souffle, une caméra qui dézoome, des vagues qui s’écrasent » brouille la synthèse du mouvement. Une seule direction de mouvement dominante par génération produit un résultat plus propre.
- Attendre des changements d’expression spectaculaires. Les modèles I2V sont entraînés à préserver l’identité du sujet. Ils gèrent bien les micro-expressions, mais ne sont pas conçus pour de grands mouvements du visage. La subtilité donne un résultat plus naturel.
- Utiliser des images très retouchées ou composites. Les photos à l’étalonnage colorimétrique extrême, fortement retouchées ou comportant des éléments de montage évidents perturbent les a priori de profondeur et de mouvement du modèle. Une photo proche du brut donne de meilleurs résultats.
- Ignorer les exigences de boucle. Si vous voulez que l’animation boucle proprement pour les réseaux sociaux, précisez le comportement de boucle dans le prompt ou retravaillez le clip dans un logiciel de montage vidéo ensuite. La plupart des modèles ne génèrent pas de boucles parfaites par défaut.
Les usages concrets dès aujourd’hui
L’I2V a largement dépassé la simple nouveauté. Voici les applications pratiques déjà utilisées en production.
Du contenu social qui arrête le défilement
Les images statiques dans les fils d’actualité génèrent généralement moins d’interactions que la vidéo. L’I2V offre un entre-deux : vous prenez une photographie (plus rapide, moins coûteuse et plus simple qu’une production vidéo), puis vous l’animez en un clip de 5 secondes. Le résultat conserve la qualité visuelle de la photographie avec les performances d’une vidéo dans les fils d’actualité.
Les marques de mode, les comptes de voyage, les photographes culinaires et les agences immobilières utilisent déjà ce flux de travail. Une seule séance de portraits produit à la fois des visuels fixes et du contenu vidéo à partir des mêmes fichiers bruts.
Travaux de portfolio et narration visuelle
Photographes et artistes visuels utilisent l’I2V pour créer des portfolios en mouvement à partir de leurs œuvres fixes. Une série de paysages devient un reel cinématographique. Une séance de portraits génère du contenu vidéo sans qu’il faille réserver une séance vidéo distincte.
Pour le mouvement du corps et l’animation de personnages, Dreamactor M2.0 de ByteDance permet une synthèse de mouvement du corps entier pilotée par une vidéo de référence, rendant l’animation complexe accessible sans expertise en animation. Kling Avatar v2 gère l’animation pilotée par le visage, utile pour les contenus face caméra et les présentations.
Préserver les souvenirs de famille
Les anciennes photographies imprimées peuvent être numérisées puis animées, ajoutant une dimension temporelle aux archives familiales. Des modèles comme I2VGen XL d’Ali-Vilab ont été conçus pour gérer une grande variété de types d’images, y compris des images historiques, de faible résolution ou à l’éclairage inhabituel.
Pour l’animation pilotée par le son, Audio to Video de Lightricks génère un mouvement synchronisé avec une piste audio fournie. Importez une photo de famille et un morceau de musique, et le modèle crée une animation dont le mouvement suit le rythme et le caractère émotionnel du son.
Le prompting de mouvement : écrire pour le mouvement
Rédiger de bons prompts I2V est une compétence distincte de la rédaction de prompts pour la génération d’images. Le modèle voit déjà l’image. Il a besoin d’une instruction de mouvement, et non d’une description de scène.
Prompt faible : « Une femme debout dans un champ, les cheveux détachés, vêtue d’une robe blanche »
Cela décrit l’image. Le modèle a déjà l’image.
Prompt efficace : « Cheveux et robe ondulant doucement dans une brise légère, tiges de blé qui se balancent à une fréquence naturelle, lent glissement de caméra vers la gauche, lumière chaude de l’après-midi qui reste stable »
Cela décrit ce qui doit se passer. Le modèle dispose maintenant d’une direction.
Structure efficace d’un prompt de mouvement :
- Mouvement du sujet : ce que fait la personne ou l’objet principal
- Mouvement de l’environnement : vent, eau, changements de lumière en arrière-plan
- Comportement de la caméra : panoramique, travelling avant, inclinaison, orbite ou plan fixe
- Qualificatif d’intensité : doux, lent, subtil, spectaculaire, rapide
Conseil de prompt : un seul événement de mouvement cohérent produit de meilleurs résultats que plusieurs instructions concurrentes. « Un vent léger traverse la scène avec un lent travelling avant » est plus efficace que six mouvements simultanés tirant dans des directions différentes.
Le vocabulaire qui fonctionne systématiquement bien dans les prompts I2V vient en général de la cinématographie et de l’écriture sur la nature : « dériver », « onduler », « se balancer », « se poser », « gonfler », « mise au point sélective », « zoom avant », « recul ». Ces termes apparaissent fréquemment dans les données d’entraînement, dans des contextes de mouvement, et les modèles y répondent avec précision.
Pour les cheveux en particulier, « flottant doucement », « balayés par le vent » ou « mèches attrapant la brise » donnent des résultats plus naturels que le générique « cheveux en mouvement ». Pour l’eau, « légère ondulation de surface », « vague douce » et « immobile avec des reflets qui se déplacent » correspondent à des comportements précis que le modèle a vus et sait reproduire.
Vos photos sont déjà des vidéos
Chaque photographie que vous avez jamais prise contient un mouvement qui s’est arrêté au déclenchement. Les modèles d’IA de 2027 disposent d’une intelligence visuelle suffisante pour lire ce mouvement figé et le prolonger, en synthétisant une vidéo à partir d’une seule image, avec des résultats qui résistent à un examen sérieux.
Il ne s’agit pas d’une fonction gadget réservée aux vieilles photos. C’est un véritable outil de production, à mi-chemin entre la photographie et la vidéo, qui comble un manque sans solution jusqu’à récemment. Une photographie professionnelle qui ne produisait auparavant qu’un seul livrable en produit désormais deux : l’image fixe et le clip animé.
PicassoIA met à disposition dans le navigateur plus de 80 modèles d’I2V et de synthèse de mouvement. Des options rapides comme Wan 2.6 I2V Flash, qui livrent des résultats en quelques secondes, jusqu’aux outils de qualité cinématographique comme Kling v2.6 Motion Control, qui vous donnent un contrôle précis sur le mouvement de la caméra et du sujet, toute la gamme est disponible sans matériel local ni installation.
Prenez une photographie dans votre photothèque. Rédigez un prompt de mouvement. Découvrez ce qu’elle retenait immobile.