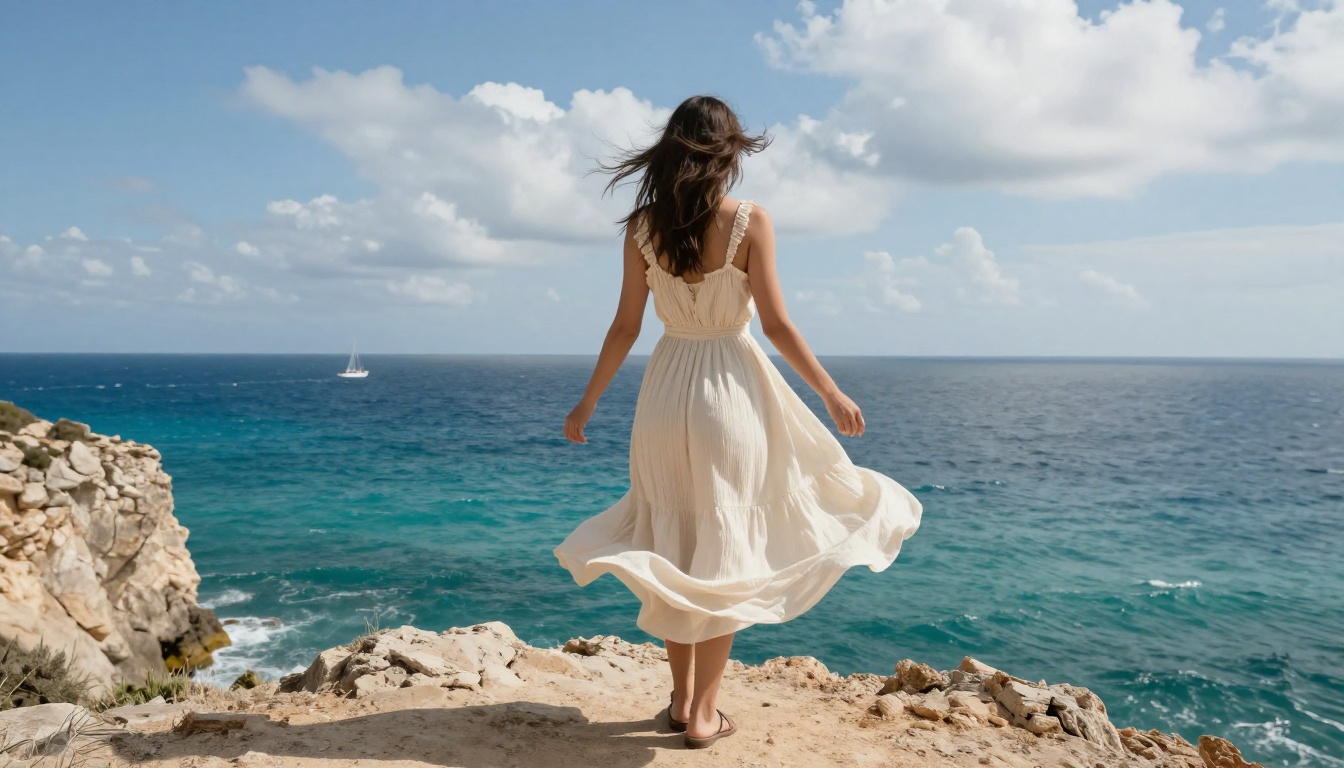
As fotografias sempre foram recipientes de tempo. Elas capturam um instante único, comprimem-no em uma superfície e o mantêm ali enquanto o suporte durar. Mas fotografias não são realmente estáticas. No momento em que foram tiradas, estavam cheias de movimento que simplesmente parou. Uma rajada de vento dobrava aquela árvore. O cabelo dela estava no meio de um balanço. A água estava caindo.
Os modelos de IA atuais conseguem ler o que uma fotografia contém e sintetizar como ela estaria um segundo depois, dois segundos depois, dez segundos depois. O momento congelado continua se movendo. E os resultados, quando bem feitos, são indistinguíveis de imagens reais.
Isto é a IA de imagem para vídeo (I2V). Veja exatamente como funciona, por que importa e quais ferramentas estão produzindo os resultados mais convincentes hoje.
O que significa, de fato, "animar uma foto"
O termo é esticado para cobrir desde efeitos baratos de paralaxe até a síntese genuína de movimento. A distinção importa, porque os resultados pertencem a categorias completamente diferentes.
Um quadro. Movimento ilimitado.
A IA I2V de verdade recebe uma única imagem como sua única entrada visual e gera uma sequência de quadros que continua naturalmente a partir dela. O modelo não repete a imagem em loop. Não aplica um filtro predefinido. Ele sintetiza novos dados de pixel ao longo do tempo, quadro a quadro, inventando conteúdo que nunca foi capturado, mas que é estatisticamente coerente com o que foi.
Isto é uma operação genuinamente nova na mídia visual. A fotografia captura um momento. A videografia registra duração. A I2V cria duração a partir de um momento.
Por que isto não é apenas um filtro
Aplicativos de celular que "animam" fotos normalmente usam paralaxe por mapa de profundidade: a imagem é segmentada em camadas conforme a profundidade estimada, e essas camadas se deslocam de forma independente para simular o movimento da câmera. O fundo se move mais devagar que o primeiro plano. Isso produz uma ilusão 2.5D convincente por cerca de três segundos, até que o loop se torne óbvio.
Os modelos I2V modernos fazem algo categoricamente mais complexo. Eles geram valores de pixel totalmente novos para cada quadro, informados pela física de como os objetos da cena provavelmente se comportam. O cabelo não apenas se desloca lateralmente. Ele se separa em mechas, cada uma seguindo uma trajetória ligeiramente diferente. A água não se inclina como um objeto rígido. Ela ondula na frequência correta para sua profundidade aparente. O tecido amassa e desamassa de acordo com a física de tensão que o modelo absorveu durante o treinamento.
A diferença de qualidade é visível de imediato. Mais importante ainda, a diferença de utilidade criativa é enorme.
A tecnologia por trás disso
Três mecanismos centrais tornam a I2V possível. Entendê-los torna os resultados mais previsíveis e ajuda você a escrever prompts de movimento melhores.
Modelos de difusão e ruído temporal
A maioria dos sistemas I2V de ponta é construída sobre modelos de difusão de vídeo, uma extensão da arquitetura de difusão de imagens que alimenta os geradores de imagens estáticas. O processo funciona assim: a imagem de origem é tratada como o quadro 0, a condição âncora. Cada quadro seguinte é inicializado como ruído aleatório. O modelo é treinado para remover o ruído dessa sequência temporal de forma iterativa, de um jeito visualmente coerente, fisicamente plausível e conectado causalmente ao primeiro quadro.
Durante a geração, o modelo recebe a imagem âncora mais ruído aleatório para os quadros de 1 a N, e os refina ao longo de dezenas de etapas de remoção de ruído. Em cada etapa, ele pergunta: dado o que o quadro 0 mostra e a estimativa ruidosa atual do que vem a seguir, como este quadro deve parecer? Depois de passos de refinamento suficientes, a resposta é um vídeo suave e contínuo.
A razão pela qual isso funciona tão bem é que os modelos de difusão de vídeo são treinados com bilhões de sequências de vídeo, junto com os seus primeiros quadros. O modelo absorve uma quantidade enorme de informação estatística sobre como as cenas evoluem no tempo e aplica esse conhecimento a cada nova imagem que recebe.
Fluxo óptico e estimativa de profundidade
Antes de sintetizar o movimento, muitos modelos calculam duas representações internas da cena:
- Mapas de fluxo óptico: campos vetoriais que descrevem a direção e a velocidade prováveis de cada região de pixels
- Mapas de profundidade: uma estimativa, pixel a pixel, da distância até a câmera, inferida a partir de sombreamento, perspectiva e gradientes de textura
Essas representações condicionam o processo de geração. Uma região estimada a 2 metros da câmera recebe uma dinâmica de movimento diferente da de uma região a 20 metros. Um rosto em primeiro plano recebe microexpressões e movimento da respiração. Uma montanha ao fundo mal se move.
Efeito prático: quando você envia um retrato na praia a um modelo I2V, ele estima que a areia está perto, a água está a meia distância e o horizonte está longe. Cada camada recebe uma física de movimento adequada à sua profundidade antes de a geração começar. É por isso que uma boa saída I2V tem paralaxe natural sem que ninguém precise especificá-la.
Como o modelo prevê o movimento
Nenhuma simulação física explícita roda durante a geração. O modelo não tem um motor de física. Ele tem dados de treinamento.
Os modelos são treinados com vídeos que contêm cabelo ao vento, tecidos em movimento, superfícies de água, fogo, fumaça e milhares de outros elementos dinâmicos, todos pareados com seus primeiros quadros constituintes. O modelo constrói priors estatísticos sobre o que tende a acontecer em cenas com esses elementos e aplica esses priors quando encontra primeiros quadros semelhantes.
Quando o modelo vê a foto de uma mulher em um campo, ele reconhece a semântica visual: trigo, mulher, céu aberto, tecido. Ele recupera os comportamentos de movimento aprendidos para cada elemento e os sintetiza em uma sequência de animação coerente. O movimento não é calculado fisicamente. É lembrado estatisticamente.
I2V ou T2V: qual é a diferença?
As duas categorias produzem vídeo com IA. A entrada é o que as separa.
| Tipo de modelo | Entrada | Saída | Melhor uso para |
|---|
| I2V (Imagem para vídeo) | 1 imagem + texto opcional | Vídeo que começa a partir dessa imagem | Animar suas fotos |
| T2V (Texto para vídeo) | Apenas prompt de texto | Vídeo gerado do zero | Criar cenas novas |
| I2V com prompt de movimento | Imagem + descrição de movimento | Animação guiada dessa imagem | Controle criativo preciso |
Para animar as suas próprias fotografias, a I2V é a única categoria correta. Modelos T2V não têm obrigação de se parecer com a sua imagem de origem. Eles geram o que o prompt descreve, não o que a sua foto específica contém.
O prompt de texto em um fluxo de trabalho I2V funciona como uma instrução de movimento, não como uma descrição de cena. Você não descreve o que já está na foto. Você descreve o que deve acontecer com ela: "cabelo balançando suavemente ao vento, tecido ondulando, uma aproximação lenta da câmera para a frente". O modelo vê a imagem. Ele precisa de direção de movimento, não de narração da cena.
Os melhores modelos para animação de fotos
Vários modelos se tornaram referências de qualidade I2V. Veja como eles se diferenciam na prática.
Wan 2.6 I2V: potência bruta
O Wan 2.6 I2V, da Wan Video, é um dos modelos I2V de pesos abertos mais fortes disponíveis. Ele lida com cenas complexas com múltiplos sujeitos, mantém a consistência de identidade entre os quadros e produz movimento que respeita a iluminação e as relações de profundidade da imagem original.
Para uma entrega mais rápida sem perda significativa de qualidade, o Wan 2.6 I2V Flash reduz bastante o tempo de geração e preserva a qualidade central do movimento. Versões anteriores, o Wan 2.5 I2V e o Wan 2.5 I2V Fast, continuam sólidas para animação de retratos em 720p.
Kling v2.6: movimento cinematográfico
O Kling v2.6 Motion Control, da Kwaivgi, se destaca pela especificação de movimento de câmera. Você pode controlar não apenas o que se move dentro da cena, mas também como a câmera virtual se comporta de forma independente: aproximação lenta, arco, órbita. Os resultados parecem menos uma "foto animada" e mais um material real filmado por uma câmera fisicamente presente.
O Kling v3 Motion Control amplia isso com especificação de movimento por sujeito, permitindo que diferentes elementos do quadro recebam instruções de movimento independentes.
Hailuo 2.3 Fast: velocidade sem sacrifício
O Hailuo 2.3 Fast, da Minimax, entrega saída em 1080p em uma fração do tempo que a maioria dos modelos padrão exige. Para criadores de conteúdo que precisam de volume, ele é o carro-chefe da produção. A fidelidade de movimento é especialmente forte em sujeitos retratados e rostos.
Video 01 Live: especialista em retratos
O Video 01 Live foi projetado especificamente para animar imagens estáticas. Ele foca no realismo de retratos: microexpressões faciais, movimento natural dos olhos, movimento sutil da respiração e dinâmica do cabelo. Para animar fotos de pessoas, esta é uma das opções mais naturalistas disponíveis.
Para I2V gratuita de entrada em 720p, o Wan 2.1 I2V 720p, da Wavespeed AI, oferece resultados confiáveis sem barreiras de custo.
Roteamento rápido: trabalho de câmera cinematográfico? Use o Kling. Produção de conteúdo em grande volume? Use o Hailuo. Movimento ambiente mais naturalista? Use o Wan 2.6. Realismo de retratos? Use o Video 01 Live.
Como a qualidade mudou
A melhoria da I2V desde 2023 foi acentuada. A tabela abaixo mostra os avanços técnicos específicos que a impulsionaram.
| O que melhorou | Efeito na saída |
|---|
| Conjuntos de dados de treinamento maiores | Priors de movimento mais realistas e variados |
| Arquiteturas com consciência 3D | Objetos giram corretamente em vez de apenas se deslocar |
| Mecanismos de atenção temporal | Consistência mantida em sequências mais longas |
| Treinamento em alta resolução | Detalhes finos em cabelo, tecido e pele preservados |
| Sinais de condicionamento de movimento | Controle do usuário sobre velocidade e direção |
O Kling v2.1 representou a geração que tornou a I2V confiável para sujeitos complexos. Modelos atuais como o Kling v3 Omni Video e o Wan 2.6 I2V colocam a animação fotorrealista ao alcance de qualquer pessoa com uma biblioteca de fotos e um navegador.
Que fotos funcionam melhor
Nem toda fotografia se anima igualmente bem. A composição tem um efeito significativo na qualidade da saída.
Dicas de composição que melhoram a saída
O isolamento do sujeito importa. Fotos em que o sujeito principal está claramente separado do fundo (por meio de profundidade de campo rasa, contraste de iluminação ou separação espacial) dão ao modelo limites de movimento mais limpos. O modelo precisa inferir onde o sujeito termina e onde o fundo começa. O desfoque ajuda.
Contextos de movimento naturais produzem os melhores resultados. Cabelo, tecido, água, chamas, fumaça e vegetação são elementos que o modelo já viu em movimento bilhões de vezes. Eles se animam com uma física previsível e convincente. Arquitetura de linhas duras e objetos estáticos feitos pelo homem tendem a produzir uma animação menos envolvente, a não ser que o prompt de movimento se concentre no movimento da câmera em vez do movimento do sujeito.
Iluminação suave e uniforme gera uma saída mais fluida. Sombras duras de luz lateral ou imagens de alto contraste podem causar artefatos de cintilação, porque o modelo tem dificuldade em manter a consistência das sombras entre os quadros. Luz nublada, a hora dourada ou iluminação de estúdio difusa produzem as animações mais suaves.
Maior resolução de entrada dá mais informação ao modelo. Uma imagem de origem com 1024 pixels de largura supera um JPEG comprimido de 640 pixels. O modelo reconstrói detalhes durante a geração, mas só consegue trabalhar com o que a fonte fornece.
Erros comuns que estragam os resultados
- Prompts de movimento concorrentes. Pedir "pessoa caminhando, vento soprando, câmera afastando, ondas quebrando" ao mesmo tempo confunde a síntese de movimento. Uma direção de movimento dominante por geração produz uma saída mais limpa.
- Esperar mudanças expressivas dramáticas. Os modelos I2V são treinados para preservar a identidade do sujeito. Eles lidam bem com microexpressões sutis, mas não são projetados para grandes movimentos faciais. O sutil se lê de forma mais natural.
- Usar imagens muito editadas ou montadas. Fotos com gradação de cor extrema, retoque pesado ou elementos de montagem evidentes perturbam os priors de profundidade e de movimento do modelo. Quanto mais próximo de uma foto bruta, melhores os resultados.
- Ignorar requisitos de loop. Se você quer que a animação faça um loop limpo para redes sociais, especifique o comportamento de loop no prompt ou processe o clipe final em um editor de vídeo depois. A maioria dos modelos não gera loops perfeitos por padrão.
Usos reais agora mesmo
A I2V já foi muito além da novidade. Estas são as aplicações práticas que já estão em uso ativo na produção.
Conteúdo social que para o scroll
Imagens estáticas nos feeds costumam ter taxas de interação menores que o vídeo. A I2V oferece um meio-termo: tire uma fotografia (mais rápido, mais barato e mais fácil do que uma produção de vídeo) e depois anime-a em um clipe de 5 segundos. O resultado carrega a qualidade visual da fotografia com o desempenho de feed do vídeo.
Marcas de moda, perfis de viagem, fotógrafos de gastronomia e imobiliárias já estão rodando esse fluxo de trabalho. Uma única sessão de retratos gera tanto os materiais estáticos quanto o conteúdo em vídeo a partir dos mesmos arquivos brutos.
Trabalhos de portfólio e narrativa visual
Fotógrafos e artistas visuais usam a I2V para criar portfólios em movimento a partir de trabalhos estáticos. Uma série de paisagens vira um reel cinematográfico. Uma sessão de retratos gera conteúdo em vídeo sem a necessidade de marcar uma sessão de vídeo separada.
Para movimento corporal e animação de personagens, o Dreamactor M2.0, da ByteDance, permite a síntese de movimento de corpo inteiro guiada por um vídeo de referência, tornando a animação complexa acessível sem experiência em animação. O Kling Avatar v2 cuida da animação guiada pelo rosto, útil para conteúdo de apresentadores e de cabeça falante.
Preservando memórias de família
Fotografias antigas impressas podem ser digitalizadas e animadas, acrescentando uma dimensão temporal aos arquivos de família. Modelos como o I2VGen XL, da Ali-Vilab, foram projetados para lidar com uma grande variedade de tipos de imagem, incluindo entradas históricas, de baixa resolução ou com iluminação não convencional.
Para animação guiada por áudio, o Audio to Video, da Lightricks, gera movimento sincronizado com uma faixa de áudio fornecida. Envie uma fotografia de família e uma música, e o modelo cria uma animação em que o movimento segue o ritmo e o caráter emocional do som.
Prompts de movimento: escrevendo para o movimento
Escrever prompts I2V eficazes é uma habilidade distinta de escrever prompts de geração de imagens. O modelo já vê a imagem. Ele precisa de instrução de movimento, não de descrição de cena.
Prompt fraco: "Uma mulher em pé em um campo, com o cabelo solto e um vestido branco"
Isso descreve a imagem. O modelo já tem a imagem.
Prompt forte: "Cabelo e vestido ondulando suavemente em uma brisa leve, hastes de trigo balançando na frequência natural, uma lenta deriva da câmera para a esquerda, luz quente de tarde que se mantém estável"
Isso descreve o que deve acontecer. O modelo agora tem uma direção.
Estrutura eficaz de um prompt de movimento:
- Movimento do sujeito: o que a pessoa ou o objeto principal faz
- Movimento do ambiente: vento, água, mudanças de luz no fundo
- Comportamento da câmera: panorâmica, aproximação, inclinação, órbita ou quadro fixo
- Qualificador de intensidade: suave, lento, sutil, dramático, rápido
Dica de prompt: um único evento de movimento coerente produz resultados melhores do que várias instruções concorrentes. "Vento suave pela cena com uma lenta aproximação da câmera" é mais eficaz do que seis movimentos simultâneos puxando em direções diferentes.
O vocabulário que funciona bem de forma consistente em prompts I2V tende a vir da cinematografia e da escrita sobre a natureza: "deriva", "ondular", "balançar", "assentar", "inflar", "troca de foco", "aproximar", "afastar". Esses termos aparecem com frequência em contextos de movimento nos dados de treinamento, e os modelos respondem a eles com precisão.
Para cabelo especificamente, "fluindo suavemente", "agitado pelo vento" ou "mechas soltas captando a brisa" produzem resultados mais naturais do que o genérico "cabelo se movendo". Para água, "ondulação suave na superfície", "onda gentil" e "parada, com reflexos mudando" correspondem a comportamentos específicos que o modelo já viu e consegue reproduzir.
Suas fotos já são vídeo
Cada fotografia que você já tirou contém um movimento que parou no obturador. Os modelos de IA em 2027 têm inteligência visual suficiente para ler esse movimento parado e continuá-lo, sintetizando vídeo a partir de um único quadro, com resultados que resistem a um exame sério.
Isto não é um recurso de novidade para fotos antigas. É uma ferramenta de produção prática que fica entre a fotografia e a videografia, preenchendo uma lacuna que não tinha solução até pouco tempo atrás. Uma fotografia profissional que antes gerava uma entrega agora gera duas: a imagem estática e o clipe animado.
A Picasso IA disponibiliza mais de 80 modelos de I2V e de síntese de movimento no navegador. Desde opções rápidas, como o Wan 2.6 I2V Flash, que devolve resultados em segundos, até ferramentas de qualidade cinematográfica, como o Kling v2.6 Motion Control, que dão controle preciso sobre o movimento da câmera e do sujeito, a gama completa está lá, sem exigir hardware local nem qualquer instalação.
Pegue uma fotografia da sua biblioteca. Escreva um prompt de movimento. Descubra o que ela estava segurando parada.