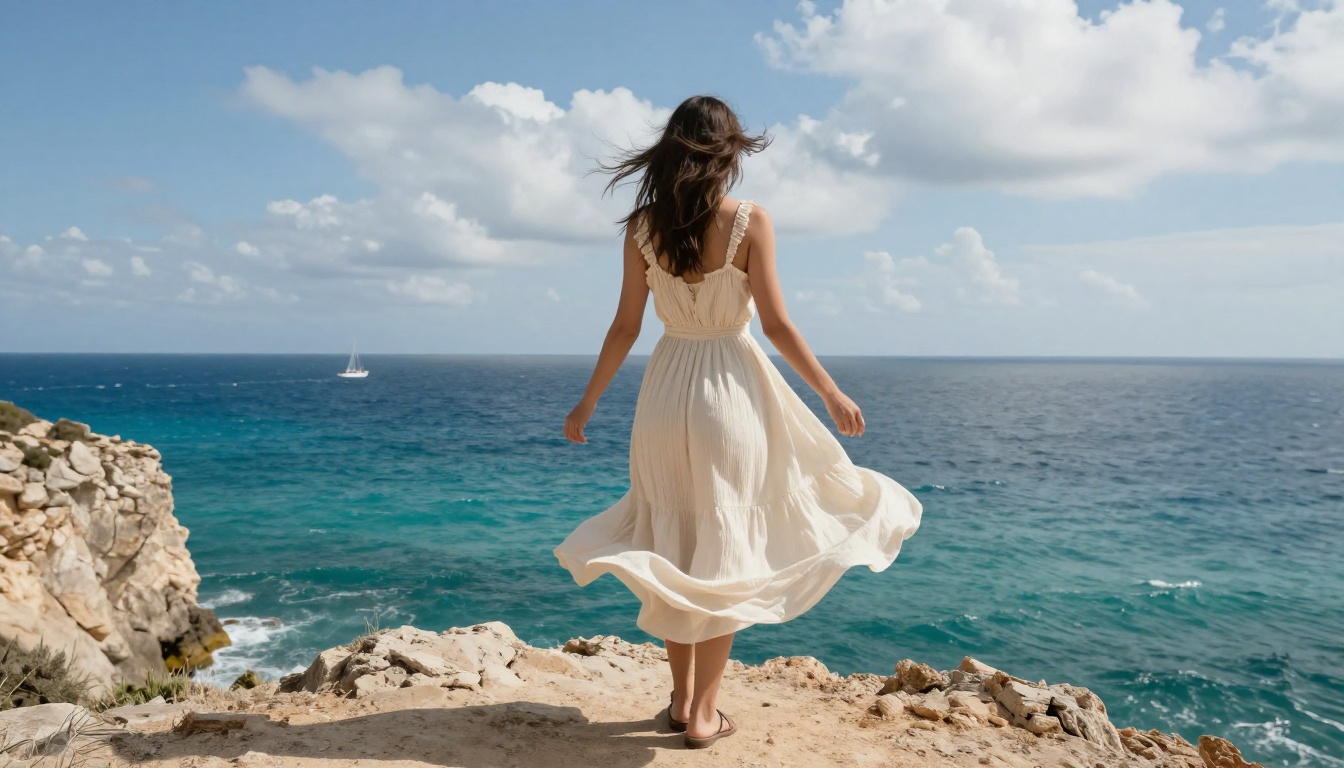
स्थिर फ़ोटोग्राफ़ हमेशा से समय को संजोने का माध्यम रहे हैं। वे एक ही पल को पकड़ते हैं, उसे एक सतह पर समेट देते हैं और जब तक माध्यम बचा रहे, उसे वहीं रोके रखते हैं। लेकिन फ़ोटो सचमुच स्थिर नहीं होतीं। जिस क्षण उन्हें खींचा गया, उसमें गति भरी थी जो बस थम गई। एक झोंका उस पेड़ को झुका रहा था। उसके बाल बीच में लहरा रहे थे। पानी गिर रहा था।
आज के AI मॉडल पढ़ सकते हैं कि फ़ोटो में क्या है, और यह अनुमान लगा सकते हैं कि एक सेकंड बाद, दो सेकंड बाद या दस सेकंड बाद वह कैसी दिखती। जमा हुआ पल फिर से चलने लगता है। और अच्छे से किए जाने पर नतीजे असली फ़ुटेज से अलग नहीं लगते।
यह इमेज-टू-वीडियो (I2V) AI है। यहाँ बताया गया है कि यह ठीक-ठीक कैसे काम करता है, यह क्यों मायने रखता है, और आज कौन से टूल सबसे विश्वसनीय नतीजे दे रहे हैं।
"फ़ोटो एनिमेशन" का असल मतलब क्या है
इस शब्द को सस्ते पैरलैक्स इफ़ेक्ट से लेकर असली मोशन सिंथेसिस तक, हर चीज़ के लिए इस्तेमाल किया जाता है। यह फ़र्क़ इसलिए ज़रूरी है क्योंकि इनके नतीजे पूरी तरह अलग किस्म की चीज़ें हैं।
एक फ़्रेम। असीमित मोशन।
असली I2V AI एक ही इमेज को अपने एकमात्र विज़ुअल इनपुट के रूप में लेता है और फ़्रेम्स का ऐसा क्रम बनाता है जो उसी से स्वाभाविक रूप से आगे बढ़ता है। मॉडल इमेज को लूप नहीं करता। वह कोई प्रीसेट फ़िल्टर भी नहीं लगाता। वह समय के पार नए पिक्सल डेटा को संश्लेषित करता है, फ़्रेम दर फ़्रेम, ऐसी चीज़ें गढ़ते हुए जो कभी कैद नहीं हुईं, पर जो जो कैद हुआ उससे सांख्यिकीय रूप से मेल खाती हैं।
विज़ुअल मीडिया में यह सचमुच एक नया काम है। फ़ोटोग्राफ़ी एक पल को कैद करती है। वीडियोग्राफ़ी अवधि को रिकॉर्ड करती है। I2V एक पल से अवधि बनाता है।
यह सिर्फ़ फ़िल्टर क्यों नहीं है
फ़ोटो को "एनिमेट" करने वाले स्मार्टफ़ोन ऐप आम तौर पर डेप्थ-मैप पैरलैक्स का इस्तेमाल करते हैं: इमेज को अनुमानित गहराई के आधार पर परतों में बाँटा जाता है, और ये परतें कैमरा मूवमेंट की नकल के लिए स्वतंत्र रूप से खिसकाई जाती हैं। पृष्ठभूमि अग्रभूमि से धीमी चलती है। यह लगभग तीन सेकंड तक एक विश्वसनीय 2.5D भ्रम पैदा करता है, फिर लूप साफ़ नज़र आने लगता है।
आधुनिक I2V मॉडल इससे मूल रूप से कहीं ज़्यादा जटिल काम करते हैं। वे हर फ़्रेम के लिए बिल्कुल नए पिक्सल मान बनाते हैं, जो इस बात से तय होते हैं कि दृश्य की वस्तुएँ संभवतः कैसे व्यवहार करेंगी। बाल सिर्फ़ बग़ल में नहीं खिसकते। वे अलग-अलग लटों में बँट जाते हैं, और हर लट का रास्ता थोड़ा अलग होता है। पानी सिर्फ़ झुकता नहीं। वह अपनी दिखाई देने वाली गहराई के हिसाब से सही आवृत्ति पर लहराता है। कपड़े की सिलवटें ट्रेनिंग से सीखे गए तनाव के भौतिकी-नियमों के अनुसार बनती और मिटती हैं।
गुणवत्ता का फ़र्क़ तुरंत दिख जाता है। उससे भी ज़्यादा, रचनात्मक उपयोग में फ़र्क़ बहुत बड़ा है।
इसके पीछे की टेक्नोलॉजी
I2V को संभव बनाने वाली तीन मुख्य प्रक्रियाएँ हैं। इन्हें समझने से नतीजे ज़्यादा पूर्वानुमेय बनते हैं और आप बेहतर मोशन प्रॉम्प्ट लिख पाते हैं।
डिफ़्यूज़न मॉडल और टेम्पोरल नॉइज़
ज़्यादातर अत्याधुनिक I2V सिस्टम वीडियो डिफ़्यूज़न मॉडल पर बने होते हैं, जो उस इमेज डिफ़्यूज़न आर्किटेक्चर का विस्तार है जो स्टिल-इमेज जनरेटर को चलाता है। प्रक्रिया कुछ ऐसे काम करती है: स्रोत इमेज को फ़्रेम 0 माना जाता है, यानी एंकर कंडीशन। इसके बाद हर आने वाला फ़्रेम रैंडम नॉइज़ से शुरू होता है। मॉडल को उस टेम्पोरल क्रम से नॉइज़ हटाने के लिए ट्रेन किया जाता है, ऐसे तरीके से जो विज़ुअली कोहेरेंट हो, भौतिक रूप से संभव हो और पहले फ़्रेम से कारण-संबंध में जुड़ा हो।
जनरेशन के दौरान मॉडल एंकर इमेज और फ़्रेम 1 से N तक के लिए रैंडम नॉइज़ लेता है, और दर्जनों डिनॉइज़िंग स्टेप्स में उन्हें परिष्कृत करता है। हर स्टेप यह सवाल पूछता है: यह देखते हुए कि फ़्रेम 0 क्या दिखाता है, और आगे क्या आएगा इसका मौजूदा नॉइज़ी अनुमान क्या है, तो यह फ़्रेम कैसा दिखना चाहिए? पर्याप्त परिष्करण के बाद उत्तर एक चिकना, निरंतर वीडियो होता है।
यह इतना अच्छा काम इसलिए करता है क्योंकि वीडियो डिफ़्यूज़न मॉडल अरबों वीडियो सीक्वेंस और उनके पहले फ़्रेम्स पर ट्रेन किए जाते हैं। मॉडल दृश्य समय के साथ कैसे बदलते हैं, इसकी बहुत बड़ी सांख्यिकीय जानकारी सीखता है और उस ज्ञान को हर नई इमेज पर लागू करता है जो उसे मिलती है।
ऑप्टिकल फ़्लो और डेप्थ अनुमान
मोशन संश्लेषित करने से पहले, कई मॉडल दृश्य के दो आंतरिक प्रतिनिधित्व गणना करते हैं:
- ऑप्टिकल फ़्लो मैप: वेक्टर फ़ील्ड जो हर पिक्सल क्षेत्र की संभावित दिशा और गति बताते हैं
- डेप्थ मैप: शेडिंग, परिप्रेक्ष्य और टेक्सचर ग्रेडिएंट से अनुमानित, कैमरे से दूरी का प्रति-पिक्सल अनुमान
ये प्रतिनिधित्व जनरेशन प्रक्रिया को कंडीशन करते हैं। जिस क्षेत्र को कैमरे से 2 मीटर दूर अनुमानित किया गया है, उसे 20 मीटर वाले क्षेत्र से अलग मोशन डायनामिक्स मिलते हैं। अग्रभूमि के चेहरे को सूक्ष्म भाव और साँस लेने की गति मिलती है। पृष्ठभूमि का पहाड़ मुश्किल से हिलता है।
व्यावहारिक असर: जब आप किसी I2V मॉडल पर बीच समुद्र तट का पोर्ट्रेट अपलोड करते हैं, तो वह अनुमान लगाता है कि रेत पास है, पानी मध्य दूरी पर है और क्षितिज दूर है। जनरेशन शुरू होने से पहले हर परत को उसकी गहराई के अनुरूप मोशन भौतिकी मिलती है। इसी वजह से अच्छे I2V आउटपुट में बिना किसी के बताए प्राकृतिक पैरलैक्स होता है।
मॉडल गति का अनुमान कैसे लगाता है
जनरेशन के दौरान कोई स्पष्ट भौतिकी सिमुलेशन नहीं चलता। मॉडल के पास कोई फ़िज़िक्स इंजन नहीं है। उसके पास ट्रेनिंग डेटा है।
मॉडल ऐसे वीडियो पर ट्रेन होते हैं जिनमें हवा में बाल, गतिमान कपड़े, पानी की सतहें, आग, धुआँ और हज़ारों अन्य गतिशील तत्व होते हैं, और इन्हें उनके शुरुआती फ़्रेम्स से जोड़ा जाता है। मॉडल इस बारे में सांख्यिकीय पूर्व-धारणाएँ बनाता है कि ऐसे तत्वों वाले दृश्यों में आम तौर पर क्या होता है, और जब उसे मिलते-जुलते पहले फ़्रेम मिलते हैं, तो वही धारणाएँ लागू करता है।
जब मॉडल खेत में खड़ी एक महिला की फ़ोटो देखता है, तो वह विज़ुअल अर्थ पहचानता है: गेहूँ, महिला, खुला आसमान, कपड़ा। वह हर तत्व के लिए सीखे गए मोशन व्यवहार निकालता है और उन्हें एक सुसंगत एनिमेशन सीक्वेंस में जोड़ता है। मोशन की गणना भौतिकी के आधार पर नहीं होती। वह सांख्यिकीय रूप से याद किया जाता है।
I2V बनाम T2V: फ़र्क़ क्या है?
दोनों श्रेणियाँ AI से वीडियो बनाती हैं। इनमें फ़र्क़ इनपुट से पैदा होता है।
| मॉडल प्रकार | इनपुट | आउटपुट | सबसे अच्छा उपयोग |
|---|
| I2V (इमेज-टू-वीडियो) | 1 इमेज + वैकल्पिक टेक्स्ट | उसी इमेज से शुरू होने वाला वीडियो | अपनी फ़ोटो एनिमेट करना |
| T2V (टेक्स्ट-टू-वीडियो) | सिर्फ़ टेक्स्ट प्रॉम्प्ट | शुरुआत से बना वीडियो | नए दृश्य बनाना |
| मोशन प्रॉम्प्ट वाला I2V | इमेज + मोशन विवरण | उस इमेज का निर्देशित एनिमेशन | सटीक रचनात्मक नियंत्रण |
अपनी फ़ोटो एनिमेट करने के लिए सिर्फ़ I2V ही सही श्रेणी है। T2V मॉडल पर आपकी सोर्स इमेज से मिलता-जुलता होने की कोई बाध्यता नहीं होती। वे वही बनाते हैं जो प्रॉम्प्ट बताता है, न कि वह जो आपकी खास फ़ोटो में है।
I2V वर्कफ़्लो में टेक्स्ट प्रॉम्प्ट मोशन निर्देश का काम करता है, दृश्य का वर्णन नहीं। आपको फ़ोटो में जो पहले से है उसका वर्णन नहीं करना होता। आपको बताना होता है कि उसके साथ क्या होना चाहिए: "हवा में धीरे लहराते बाल, लहराता कपड़ा, धीरे-धीरे कैमरा आगे बढ़ता हुआ।" मॉडल इमेज देखता है। उसे मोशन की दिशा चाहिए, दृश्य का बखान नहीं।
फ़ोटो एनिमेशन के लिए सबसे अच्छे मॉडल
कई मॉडल I2V क्वालिटी के बेंचमार्क बन चुके हैं। व्यवहार में वे कैसे अलग हैं, यह यहाँ है।
Wan 2.6 I2V: कच्ची ताक़त
Wan Video का Wan 2.6 I2V उपलब्ध सबसे मज़बूत ओपन-वेट I2V मॉडलों में से एक है। यह कई सब्जेक्ट वाले जटिल दृश्यों को संभालता है, फ़्रेमों के बीच पहचान की निरंतरता बनाए रखता है और ऐसा मोशन बनाता है जो मूल इमेज की रोशनी और गहराई के संबंधों का सम्मान करता है।
क्वालिटी में ज़्यादा कमी किए बिना तेज़ नतीजों के लिए, Wan 2.6 I2V Flash जनरेशन समय को काफ़ी कम कर देता है और मुख्य मोशन क्वालिटी बनाए रखता है। पिछले वर्ज़न, Wan 2.5 I2V और Wan 2.5 I2V Fast, 720p पोर्ट्रेट एनिमेशन के लिए अब भी भरोसेमंद हैं।
Kling v2.6: सिनेमैटिक मोशन
Kwaivgi का Kling v2.6 Motion Control कैमरा मूवमेंट की विशिष्टता से अलग पहचान बनाता है। आप सिर्फ़ यह नियंत्रित नहीं करते कि दृश्य में क्या हिलता है, बल्कि यह भी कि वर्चुअल कैमरा अलग से कैसे व्यवहार करता है: धीमा पुश, आर्क, ऑर्बिट। नतीजे "एनिमेटेड फ़ोटो" से ज़्यादा उस असली फ़ुटेज जैसे लगते हैं जो किसी भौतिक रूप से मौजूद कैमरे से शूट हुआ हो।
Kling v3 Motion Control इसे प्रति-सब्जेक्ट मोशन विशिष्टता तक बढ़ाता है, जिससे फ़्रेम के अलग-अलग तत्वों को स्वतंत्र मोशन निर्देश मिल सकते हैं।
Hailuo 2.3 Fast: बिना समझौते की रफ़्तार
Minimax का Hailuo 2.3 Fast ज़्यादातर स्टैंडर्ड मॉडलों को लगने वाले समय के एक हिस्से में 1080p आउटपुट देता है। जिन कंटेंट क्रिएटर्स को बड़ी मात्रा में काम चाहिए, उनके लिए यह उत्पादन का भरोसेमंद वर्कहॉर्स है। पोर्ट्रेट सब्जेक्ट और चेहरों पर इसकी मोशन फ़िडेलिटी खास तौर पर मज़बूत है।
Video 01 Live: पोर्ट्रेट विशेषज्ञ
Video 01 Live खास तौर पर स्थिर इमेज को एनिमेट करने के लिए बनाया गया था। यह पोर्ट्रेट यथार्थवाद पर केंद्रित है: चेहरे के सूक्ष्म भाव, स्वाभाविक आँखों की हरकत, हल्की साँस की गति और बालों की डायनामिक्स। लोगों की फ़ोटो एनिमेट करने के लिए, यह उपलब्ध सबसे प्राकृतिक विकल्पों में से एक है।
720p पर मुफ़्त एंट्री-लेवल I2V के लिए, Wavespeed AI का Wan 2.1 I2V 720p बिना लागत की बाधा के भरोसेमंद नतीजे देता है।
त्वरित रूटिंग: सिनेमैटिक कैमरा वर्क चाहिए? Kling इस्तेमाल करें। बड़े पैमाने पर कंटेंट प्रोडक्शन? Hailuo इस्तेमाल करें। सबसे प्राकृतिक परिवेश मोशन? Wan 2.6 इस्तेमाल करें। पोर्ट्रेट यथार्थवाद? Video 01 Live इस्तेमाल करें।
क्वालिटी कैसे बदली है
2023 से I2V में सुधार बहुत तेज़ रहा है। नीचे की तालिका उन ख़ास तकनीकी प्रगतियों को दिखाती है जिन्होंने इसे आगे बढ़ाया।
| क्या सुधरा | आउटपुट पर असर |
|---|
| बड़े ट्रेनिंग डेटासेट | ज़्यादा यथार्थवादी और विविध मोशन पूर्व-धारणाएँ |
| 3D-अवेयर आर्किटेक्चर | ऑब्जेक्ट सिर्फ़ खिसकने के बजाय सही तरह घूमते हैं |
| टेम्पोरल अटेंशन मैकेनिज़्म | लंबे सीक्वेंस में भी निरंतरता बनी रहती है |
| उच्च-रिज़ॉल्यूशन ट्रेनिंग | बाल, कपड़े और त्वचा का बारीक डिटेल सुरक्षित रहता है |
| मोशन कंडीशनिंग सिग्नल | गति और दिशा पर यूज़र का नियंत्रण |
Kling v2.1 वह पीढ़ी थी जिसने जटिल सब्जेक्ट्स के लिए I2V को भरोसेमंद बनाया। Kling v3 Omni Video और Wan 2.6 I2V जैसे मौजूदा मॉडल फ़ोटोरियलिस्टिक एनिमेशन को किसी भी ऐसे व्यक्ति की पहुँच में रख देते हैं जिसके पास फ़ोटो लाइब्रेरी और एक ब्राउज़र है।
कौन सी फ़ोटो सबसे अच्छी काम करती हैं
हर फ़ोटो बराबर अच्छी तरह एनिमेट नहीं होती। कम्पोज़िशन का आउटपुट क्वालिटी पर काफ़ी असर पड़ता है।
कम्पोज़िशन की टिप्स जो आउटपुट सुधारती हैं
सब्जेक्ट का अलगाव मायने रखता है। वे फ़ोटो जिनमें मुख्य सब्जेक्ट पृष्ठभूमि से साफ़ तौर पर अलग दिखता है (उथली डेप्थ ऑफ़ फ़ील्ड, रोशनी के कंट्रास्ट या स्पेशियल अलगाव से), मॉडल को मोशन की साफ़ सीमाएँ देती हैं। मॉडल को अनुमान लगाना होता है कि सब्जेक्ट कहाँ खत्म होता है और पृष्ठभूमि कहाँ शुरू होती है। ब्लर मदद करता है।
प्राकृतिक मोशन वाले संदर्भ सबसे अच्छे नतीजे देते हैं। बाल, कपड़ा, पानी, लपटें, धुआँ और पौधे ऐसे तत्व हैं जिन्हें मॉडल ने अरबों बार गति में देखा है। वे अनुमानित, विश्वसनीय भौतिकी के साथ एनिमेट होते हैं। सख़्त किनारों वाली वास्तुकला और स्थिर मानव-निर्मित वस्तुएँ कम प्रभावशाली एनिमेशन देती हैं, जब तक कि मोशन प्रॉम्प्ट सब्जेक्ट की गति के बजाय कैमरा मूवमेंट पर केंद्रित न हो।
नरम, समान रोशनी सहज आउटपुट देती है। तेज़ साइड-लिट परछाइयाँ या हाई-कंट्रास्ट इमेज फ़्लिकरिंग आर्टिफ़ैक्ट पैदा कर सकती हैं, क्योंकि मॉडल फ़्रेमों के बीच परछाई की निरंतरता बनाए रखने में संघर्ष करता है। बादलों वाली रोशनी, गोल्डन आवर या डिफ़्यूज़्ड स्टूडियो लाइटिंग सबसे सहज एनिमेशन देती है।
ज़्यादा इनपुट रिज़ॉल्यूशन मॉडल को ज़्यादा जानकारी देता है। 1024 पिक्सल चौड़ी सोर्स इमेज एक कंप्रेस्ड 640 पिक्सल JPEG से बेहतर प्रदर्शन करती है। मॉडल जनरेशन के दौरान डिटेल को फिर से बनाता है, लेकिन वह उतने ही पर काम कर सकता है जितना सोर्स देता है।
आम गलतियाँ जो नतीजे बिगाड़ती हैं
- आपस में टकराते मोशन प्रॉम्प्ट। एक साथ "व्यक्ति चल रहा है, हवा चल रही है, कैमरा ज़ूम आउट हो रहा है, लहरें टकरा रही हैं" माँगना मोशन संश्लेषण को भ्रमित करता है। हर जनरेशन में एक प्रमुख मोशन दिशा से साफ़ आउटपुट मिलता है।
- नाटकीय भाव परिवर्तन की उम्मीद। I2V मॉडल सब्जेक्ट की पहचान बनाए रखने के लिए ट्रेन होते हैं। वे सूक्ष्म भावों को अच्छी तरह संभालते हैं, पर बड़े चेहरे के हाव-भाव के लिए नहीं बने हैं। सूक्ष्म ज़्यादा स्वाभाविक लगता है।
- बहुत ज़्यादा एडिट या कंपोज़िट की गई इमेज का इस्तेमाल। अत्यधिक कलर ग्रेडिंग, भारी रीटचिंग या स्पष्ट कंपोज़िट तत्वों वाली फ़ोटो मॉडल की गहराई और मोशन पूर्व-धारणाओं को बिगाड़ देती हैं। रॉ फ़ोटो के जितनी करीब हो, नतीजे उतने बेहतर होते हैं।
- लूप की ज़रूरतों को नज़रअंदाज़ करना। अगर आप चाहते हैं कि एनिमेशन सोशल मीडिया के लिए साफ़ तौर पर लूप हो, तो प्रॉम्प्ट में लूप व्यवहार बताएँ या बाद में आउटपुट क्लिप को वीडियो एडिटर में प्रोसेस करें। ज़्यादातर मॉडल डिफ़ॉल्ट रूप से सीमलेस लूप नहीं बनाते।
अभी असली दुनिया में उपयोग
I2V नयेपन की सीमा से काफ़ी आगे निकल चुका है। ये वे व्यावहारिक उपयोग हैं जो पहले से सक्रिय उत्पादन में हैं।
सोशल कंटेंट जो ध्यान खींच लेता है
फ़ीड में स्थिर इमेज आम तौर पर वीडियो की तुलना में कम इंटरैक्शन रेट पाती हैं। I2V एक बीच का रास्ता देता है: एक फ़ोटो खींचें (जो वीडियो प्रोडक्शन से तेज़, सस्ती और आसान है), फिर उसे 5 सेकंड की क्लिप में एनिमेट करें। नतीजा फ़ोटोग्राफ़ी जैसी विज़ुअल क्वालिटी के साथ वीडियो जैसा फ़ीड प्रदर्शन देता है।
फ़ैशन ब्रांड, ट्रैवल अकाउंट, फ़ूड फ़ोटोग्राफ़र और रियल एस्टेट एजेंसियाँ पहले से यह वर्कफ़्लो चला रही हैं। एक ही पोर्ट्रेट सेशन से उन्हीं कच्ची फ़ाइलों से स्थिर एसेट और वीडियो कंटेंट दोनों बनते हैं।
पोर्टफ़ोलियो का काम और विज़ुअल स्टोरीटेलिंग
फ़ोटोग्राफ़र और विज़ुअल आर्टिस्ट स्थिर काम से मोशन पोर्टफ़ोलियो बनाने के लिए I2V इस्तेमाल करते हैं। एक लैंडस्केप सीरीज़ सिनेमैटिक रील बन जाती है। एक पोर्ट्रेट शूट अलग वीडियो सेशन बुक किए बिना वीडियो कंटेंट बनाता है।
फ़ुल-बॉडी मोशन और कैरेक्टर एनिमेशन के लिए, ByteDance का Dreamactor M2.0 रेफ़रेंस वीडियो से चलने वाला पूरे शरीर का मोशन सिंथेसिस देता है, जिससे एनिमेशन की विशेषज्ञता के बिना भी जटिल एनिमेशन संभव होता है। Kling Avatar v2 चेहरे-आधारित एनिमेशन संभालता है, जो टॉकिंग-हेड और प्रेज़ेंटर कंटेंट के लिए उपयोगी है।
पारिवारिक यादों को संजोना
पुरानी छपी फ़ोटो को डिजिटल किया जा सकता है और एनिमेट किया जा सकता है, जिससे पारिवारिक संग्रह में एक समय-आयाम जुड़ जाता है। Ali-Vilab का I2VGen XL जैसे मॉडल कई तरह की इमेज संभालने के लिए बनाए गए थे, जिनमें ऐतिहासिक, कम रिज़ॉल्यूशन या असामान्य रोशनी वाले इनपुट शामिल हैं।
ऑडियो-आधारित एनिमेशन के लिए, Lightricks का Audio to Video दिए गए ऑडियो ट्रैक के साथ सिंक्रोनाइज़्ड मोशन बनाता है। एक पारिवारिक फ़ोटो और एक गाना अपलोड करें, और मॉडल ऐसा एनिमेशन बनाता है जहाँ हरकतें आवाज़ की लय और भावनात्मक स्वभाव के साथ चलती हैं।
मोशन प्रॉम्प्टिंग: गति के लिए लिखना
प्रभावी I2V प्रॉम्प्ट लिखना इमेज जनरेशन प्रॉम्प्ट लिखने से अलग कौशल है। मॉडल पहले से इमेज देखता है। उसे मोशन निर्देश चाहिए, दृश्य का वर्णन नहीं।
कमज़ोर प्रॉम्प्ट: "बाल खुले और सफ़ेद पोशाक पहने एक महिला खेत में खड़ी है"
यह इमेज का वर्णन करता है। मॉडल के पास इमेज पहले से है।
मज़बूत प्रॉम्प्ट: "हल्की हवा में बाल और पोशाक धीरे-धीरे लहराते हुए, गेहूँ के डंठल प्राकृतिक आवृत्ति पर झूलते हुए, धीमा कैमरा ड्रिफ़्ट बाईं ओर, गुनगुनी दोपहर की रोशनी स्थिर रहती हुई"
यह बताता है कि क्या होना चाहिए। अब मॉडल के पास दिशा है।
प्रभावी मोशन प्रॉम्प्ट की संरचना:
- सब्जेक्ट की गति - व्यक्ति या मुख्य वस्तु क्या करती है
- पर्यावरणीय गति - पृष्ठभूमि में हवा, पानी, रोशनी के बदलाव
- कैमरा व्यवहार - पैन, पुश, टिल्ट, ऑर्बिट, या स्थिर होल्ड
- तीव्रता का विशेषण - धीमा, हल्का, सूक्ष्म, नाटकीय, तेज़
प्रॉम्प्ट टिप: एक सुसंगत मोशन घटना कई टकराते निर्देशों से बेहतर नतीजे देती है। "दृश्य में हल्की हवा और धीरे आगे बढ़ता कैमरा" छह अलग-अलग दिशाओं में खींचने वाली एक साथ की गतियों से ज़्यादा प्रभावी है।
जो शब्दावली I2V प्रॉम्प्ट में लगातार अच्छा काम करती है, वह आम तौर पर सिनेमैटोग्राफ़ी और प्रकृति-लेखन से आती है: "ड्रिफ़्ट", "रिपल", "स्वे", "सेटल", "बिलो", "रैक फ़ोकस", "पुश इन", "पुल बैक"। ये शब्द ट्रेनिंग डेटा में मोशन संदर्भों में अक्सर आते हैं, और मॉडल इन पर सटीकता से प्रतिक्रिया देते हैं।
ख़ास तौर पर बालों के लिए, "धीरे लहराते", "हवा में उड़ते" या "हवा पकड़ती ढीली लटें" जैसे शब्द सामान्य "बाल हिल रहे हैं" की तुलना में ज़्यादा स्वाभाविक नतीजे देते हैं। पानी के लिए, "सॉफ़्ट सरफ़ेस रिपल", "हल्की लहर" और "प्रतिबिंब बदलते हुए शांत पानी" ऐसे विशेष व्यवहारों से मेल खाते हैं जिन्हें मॉडल ने देखा है और दोहरा सकता है।
आपकी फ़ोटो पहले से वीडियो हैं
आपने जो भी फ़ोटो कभी खींची है, उसमें वह मोशन है जो शटर पर रुक गया था। 2027 के AI मॉडलों के पास उस रुकी हुई गति को पढ़ने और उसे आगे बढ़ाने की पर्याप्त विज़ुअल समझ है। वे एक फ़्रेम से वीडियो बनाते हैं, और उनके नतीजे गंभीर जाँच में भी खरे उतरते हैं।
यह पुरानी फ़ोटो के लिए कोई नयापन-भरा फ़ीचर नहीं है। यह एक व्यावहारिक प्रोडक्शन टूल है जो फ़ोटोग्राफ़ी और वीडियोग्राफ़ी के बीच बैठता है और उस कमी को भरता है जिसका हाल तक कोई समाधान नहीं था। जो पेशेवर फ़ोटो पहले एक आउटपुट देती थी, अब दो देती है: स्थिर इमेज और एनिमेटेड क्लिप।
Picasso IA ब्राउज़र में 80 से ज़्यादा I2V और मोशन सिंथेसिस मॉडल उपलब्ध कराता है। Wan 2.6 I2V Flash जैसे तेज़ विकल्प, जो सेकंडों में नतीजे देते हैं, से लेकर Kling v2.6 Motion Control जैसे सिनेमैटिक-क्वालिटी टूल तक, जो कैमरे और सब्जेक्ट की गति पर सटीक नियंत्रण देते हैं, पूरी रेंज यहाँ है, और इसके लिए लोकल हार्डवेयर या किसी इंस्टॉलेशन की ज़रूरत नहीं।
अपनी लाइब्रेरी से एक फ़ोटो लें। एक मोशन प्रॉम्प्ट लिखें। देखें कि वह क्या स्थिर रखे हुए था।