Cómo crear arte de IA NSFW con Stable Diffusion 3.5
Stable Diffusion 3.5 ha elevado el listón de la generación de arte de IA NSFW fotorrealista. Este artículo desglosa las estructuras exactas de prompt, los ajustes de CFG, las comparativas de modelos y las instrucciones paso a paso para crear imágenes impresionantes y sugerentes ahora mismo, tanto si lo ejecutas en local como si usas una plataforma en el navegador.
La llegada de Stable Diffusion 3.5 Large marcó un punto de inflexión para los creadores de arte de IA que quieren imágenes fotorrealistas y sensuales sin las frustraciones de los modelos anteriores. Esta arquitectura de tercera generación ofrece una fidelidad de textura de piel sin precedentes, una simulación de iluminación natural y una adherencia al prompt que los checkpoints anteriores simplemente no podían igualar. Tanto si trabajas con una configuración local como si lo haces todo desde el navegador, el flujo de trabajo para producir arte de IA NSFW de alta calidad nunca ha sido tan accesible ni tan visualmente convincente.
Por qué SD 3.5 cambió la escena del arte NSFW
Las versiones anteriores de Stable Diffusion eran potentes, pero irregulares. La anatomía se desmoronaba. Los rostros se deformaban. Los tonos de piel parecían plásticos. SD 3.5 corrigió casi todo eso con su arquitectura MMDiT (Multimodal Diffusion Transformer), que gestiona la coherencia espacial mucho mejor que el enfoque UNet original.
Las tres variantes principales sirven cada una para un propósito distinto en el trabajo NSFW:
La variante Large es la que necesitas para la fotografía sensual de calidad final. La versión Turbo reduce el tiempo de generación alrededor de un 60 % con una pérdida de calidad apenas perceptible, lo que la hace ideal para probar prompts antes de lanzar un render completo.
La diferencia de arquitectura que importa
El núcleo MMDiT procesa los tokens de texto y de imagen en un espacio de atención unificado. En la práctica, esto significa que las descripciones de iluminación, textura de tela y posición del cuerpo en tu prompt se interpretan con mucha más fidelidad. Una frase como "luz matinal volumétrica desde la izquierda, seda que capta los reflejos" se renderizará realmente así, en lugar de aproximarse.
Esto también significa que los prompts negativos son menos críticos que con SDXL o SD 1.5, aunque siguen ayudando a afinar el resultado.
Qué hacen realmente los ajustes
Configurar bien los parámetros de generación marca la diferencia entre un resultado turbio y una imagen impresionante. Esto es lo que controla cada ajuste en el trabajo fotorrealista NSFW:
Escala CFG
CFG (Classifier-Free Guidance) controla cuánto sigue el modelo tu prompt frente a la interpretación creativa. Para el arte fotorrealista NSFW:
CFG 3,5 a 4,5: Más suelto, con un aspecto más natural y pictórico
CFG 5 a 6: El punto ideal para resultados fotorrealistas
CFG 7 o más: Quemado, colores sobresaturados, contraste poco natural
SD 3.5 se entrenó con valores de CFG más bajos que los modelos anteriores. Usarlo con CFG 7, como harías con SD 1.5, produce resultados sobresaturados y quemados.
Pasos de muestreo
SD 3.5 Large converge más rápido que los modelos anteriores:
20 pasos: Aceptable para pruebas
28 a 35 pasos: La mejor relación entre calidad y tiempo
40 o más pasos: Rendimientos decrecientes, salvo que uses DPM++ 2M Karras
En la variante Turbo, de 8 a 12 pasos bastan gracias a su arquitectura destilada.
Resolución y relación de aspecto
SD 3.5 se entrenó de forma nativa a 1024x1024. Para la fotografía NSFW, estas resoluciones dan los mejores resultados:
1152x896 para planos de paisaje y de entorno
896x1152 para retratos y fotografía de figura
1024x1024 para planos de belleza y primeros planos
Superar 1,5 megapíxeles sin un upscaler por mosaicos introducirá artefactos. Usa herramientas de Super Resolution después de la generación para llegar a una salida en 4K.
Cómo escribir prompts que realmente funcionan
La estructura del prompt para SD 3.5 difiere de las versiones anteriores de Stable Diffusion. El modelo responde mejor al lenguaje natural que a prompts cargados de palabras clave.
La fórmula de prompt en cuatro partes
Un prompt que ofrece siempre resultados NSFW de alta calidad sigue esta estructura:
Descripción del sujeto: Aspecto de edad, tipo de cuerpo, expresión, estado de la ropa
Entorno: Lugar, mobiliario, accesorios, hora del día
Especificación de iluminación: Dirección, calidad (dura/suave), temperatura de color
Calificadores técnicos: Objetivo, tipo de película, resolución
💡 Consejo: Sé específico con la dirección de la luz. "Luz cálida desde la izquierda" produce una textura de piel mucho mejor que un genérico "buena iluminación".
Ejemplo de prompt que funciona:
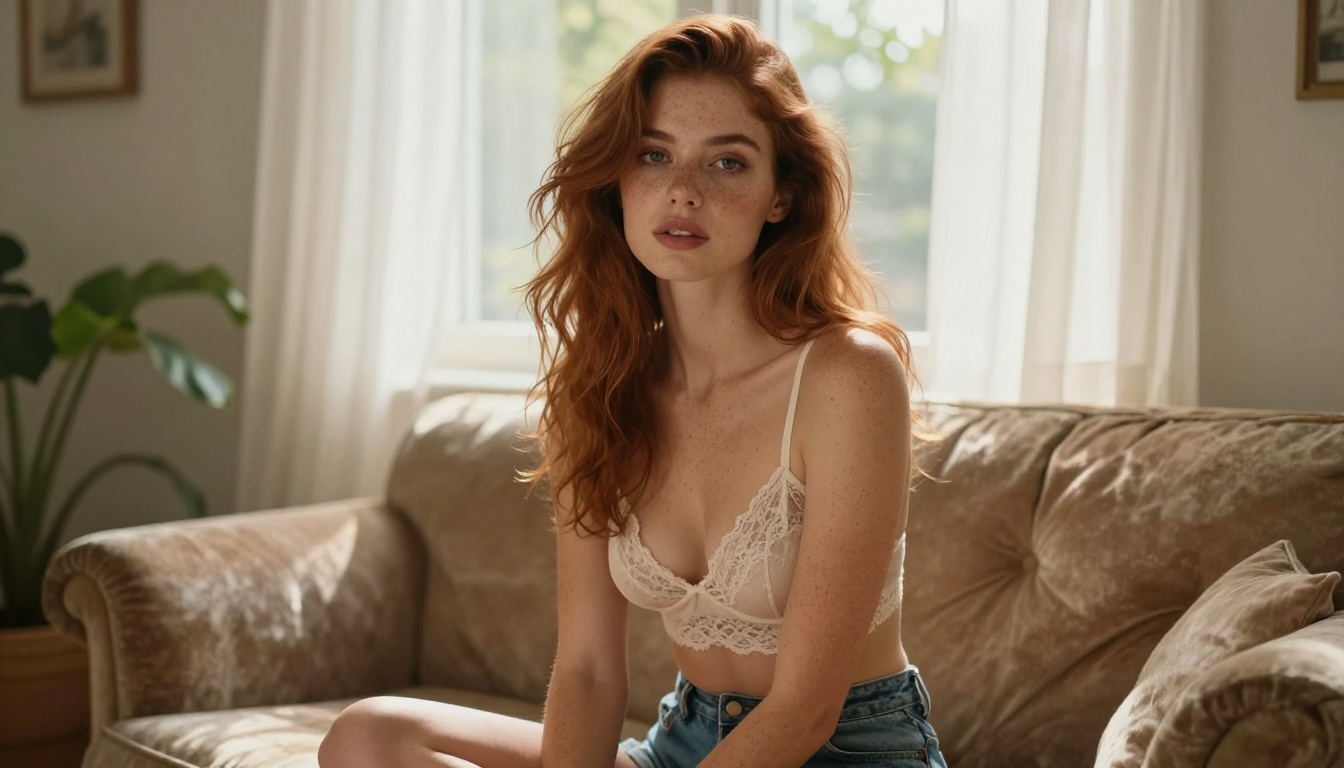
young woman with auburn hair, wearing lace bralette, sitting on vintage velvet sofa, afternoon sunlight through sheer curtains creating soft shadows, 50mm f/2.0, Kodak Portra 400 film grain, photorealistic 8K
Ejemplo de prompt que falla:
sexy beautiful woman, perfect body, high quality, realistic, nsfw
El segundo ejemplo no da a SD 3.5 nada con lo que trabajar en cuanto a espacio. El modelo necesita anclas del entorno para producir una anatomía coherente.
Los prompts negativos siguen siendo útiles
Aunque SD 3.5 es más robusto, un prompt negativo bien enfocado reduce los problemas habituales:
cartoon, 3D render, painting, illustration, anime, bad anatomy, deformed hands, blurry, low quality, JPEG artifacts, overexposed, plastic skin
Mantén los prompts negativos concisos. Los prompts negativos sobrecargados, con más de 50 términos, pueden degradar la calidad del resultado en SD 3.5.
Palabras clave para el fotorrealismo
Estos términos empujan de forma fiable a SD 3.5 hacia resultados fotorrealistas:
Ejecutar SD 3.5 en local requiere una GPU potente y una configuración técnica considerable. PicassoIA elimina por completo esa barrera y te permite acceder a Stable Diffusion 3.5 Large y sus variantes directamente desde el navegador, sin instalar nada.
Paso 2: Escribe tu prompt
Usa la fórmula de cuatro partes descrita antes. Pega el sujeto, el entorno, la iluminación y los calificadores técnicos en el campo del prompt.
Paso 3: Define tu relación de aspecto
Para la fotografía de figura, elige 9:16. Para los planos de entorno, usa 16:9. Para los primeros planos de belleza, usa 1:1.
Paso 4: Ajusta la guidance scale (CFG)
Fija el CFG en 5 para la primera prueba. Si la imagen se ve plana, súbelo a 5,5. Si se ve quemada, bájalo a 4,5.
Paso 6: Genera e itera
Lanza la primera generación. Si te gusta la composición pero quieres más detalle, vuelve a generar con la misma semilla y añade más detalles de iluminación. Si quieres otra pose o escenario, cambia la descripción del entorno.
💡 Consejo: Usa SD 3.5 Large Turbo para probar de 5 a 10 variaciones de prompt con rapidez y, después, cambia a SD 3.5 Large para tu render final de alta calidad.
Comparativa de SD 3.5 con otros modelos para el trabajo NSFW
SD 3.5 no es la única opción. Según lo que busques, otros modelos de PicassoIA pueden encajar mejor en casos de uso concretos.
Para el fotorrealismo puro con anatomía correcta, SD 3.5 Large y RealVisXL v3.0 Turbo son tus dos mejores opciones. SD 3.5 gana en flexibilidad de prompt. RealVisXL gana en textura de piel desde el primer momento.
Cuándo usar SDXL en su lugar
SDXL tiene un ecosistema de LoRA enorme. Si trabajas con estilos de personaje concretos, estéticas de artistas o tipos de cuerpo especializados que tienen pesos LoRA propios, SDXL te ofrece más opciones de personalización que SD 3.5. La contrapartida es que tienes que encontrar y aplicar el LoRA adecuado, en lugar de confiar solo en el texto del prompt.
5 errores comunes que arruinan los resultados
La mayoría de los resultados pobres de arte de IA NSFW se deben a un pequeño grupo de errores recurrentes.
1. Usar valores de CFG altos de flujos de trabajo antiguos
Copiar los ajustes de flujos de trabajo de SD 1.5 (CFG 7 a 9) en SD 3.5 produce imágenes duras y sobresaturadas. SD 3.5 funciona mejor con CFG 4 a 6. Este es el error más común al cambiar desde modelos anteriores.
2. Descripciones vagas del sujeto
"Mujer hermosa" no le dice nada útil al modelo. Incluye el color del pelo, el tipo de cuerpo, el estado de la ropa y la expresión emocional. Cuanta más información espacial aportes, más correcta será la anatomía del resultado.
3. Ignorar la dirección de la luz
La luz lo es todo en la fotografía de figura, tanto la real como la generada por IA. Un prompt sin dirección de luz recurre por defecto a una iluminación plana y apagada. Indica siempre dónde está la fuente de luz y su calidad (dura, suave, difusa o direccional).
4. Especificar en exceso los prompts negativos
Los prompts negativos largos (más de 40 términos) pueden suprimir cosas que sí quieres. Mantén los negativos centrados en 10 a 15 términos básicos: anatomía deforme, borroso, artefactos, dibujos animados y similares.
5. Resolución incorrecta para el sujeto
SD 3.5 no se entrenó con resoluciones muy altas. Generar a 2048x2048 o más sin generación por mosaicos provoca distorsión del cuerpo. Mantente en el rango nativo y escala después con herramientas de Super Resolution.
Control de rasgos corporales concretos
El control detallado del cuerpo es uno de los aspectos en los que SD 3.5 ha mejorado de forma notable. El modelo responde bien al lenguaje posicional detallado.
Descripciones de poses que funcionan
En lugar de nombres genéricos de poses, describe qué está haciendo cada parte del cuerpo:
"sentada con las piernas cruzadas en un sofá de terciopelo, manos apoyadas en las rodillas, inclinada ligeramente hacia delante"
"tumbada boca arriba con ambos brazos por encima de la cabeza, una rodilla ligeramente levantada"
"de pie en perfil de tres cuartos mirando a la derecha, una mano apoyada en el marco de una puerta"
Este nivel de precisión posicional reduce notablemente los errores de anatomía.
Vocabulario de ángulos de cámara
El ángulo que especifiques determina toda la composición espacial:
Descripción de cámara
Efecto
"plano contrapicado, mirando hacia arriba"
Alarga la figura y enfatiza la altura
"plano medio a la altura de los ojos"
Perspectiva natural e íntima
"vista aérea cenital"
Aplana la profundidad, interesante para poses tumbadas
ControlNet funciona alimentando una imagen de referencia (un esqueleto de pose, un mapa de profundidad o un mapa de bordes) en el proceso de generación junto con el prompt de texto. El modelo genera entonces un contenido que coincide tanto con el texto como con la referencia estructural.
Flujo de trabajo práctico con ControlNet para arte de figura NSFW:
Busca una imagen de referencia con la pose deseada
Extrae el esqueleto de OpenPose o el mapa de profundidad
Ajusta el peso de ControlNet entre 0,6 y 0,8 para obtener los mejores resultados
Un peso de ControlNet más alto (0,9 o más) fija la pose de forma rígida, pero puede reducir la calidad de la textura de la piel. Un peso más bajo (0,4 a 0,5) da más libertad creativa al modelo, pero puede alejarse de la pose de referencia.
Escalado y postprocesado
Una salida sólida de 1024x1024 es solo el punto de partida. Para arte de IA NSFW de calidad profesional, el pipeline de postprocesado importa tanto como la generación inicial.
Super Resolution para el detalle fino
Las herramientas de Super Resolution de PicassoIA escalan las imágenes de 2x a 4x y recuperan detalle fino en lugar de simplemente interpolar píxeles. Una foto de figura de 1024 px escalada a 4096 px muestra una mejora visible en:
Separación de los mechones de pelo individuales
Textura de los poros de la piel en primer plano
Detalle del tejido en la ropa
Nitidez de los ojos y claridad del iris
Inpainting para correcciones puntuales
El inpainting permite corregir zonas concretas sin regenerar toda la imagen. Si las manos están mal, si un rasgo facial necesita ajustes o si quieres cambiar una prenda, el inpainting regenera solo la zona enmascarada y conserva el resto.
Este flujo de trabajo produce resultados casi perfectos:
Genera la imagen base
Identifica los problemas de anatomía o las zonas que hay que mejorar
Enmascara esas zonas en una herramienta de inpainting
Escribe un prompt específico solo para esa región
Regenera solo la zona enmascarada con una fuerza alta (0,7 a 0,85)
💡 Consejo: Para corregir específicamente las manos, haz una pasada de inpainting en primer plano a 512x512. SD 3.5 maneja la anatomía de las manos mucho mejor en recortes más pequeños.
Empieza a crear ahora mismo
Acceder a Stable Diffusion 3.5 Large no requiere GPU, ni instalación, ni configuración técnica. PicassoIA lo ejecuta en la nube con una interfaz de prompt sencilla que pone toda la potencia de SD 3.5 detrás de una interfaz limpia y accesible.
Si SD 3.5 no es tu estética preferida, la plataforma también tiene SD 3.5 Large Turbo para una iteración más rápida, RealVisXL v3.0 Turbo para un render de piel ultrarrealista y Flux 1.1 Pro si quieres estéticas glamour de colores muy saturados. La colección completa de 91 modelos de texto a imagen permite cambiar de estilo sin cambiar de herramientas ni de flujo de trabajo.
Empieza con SD 3.5 Large Turbo para probar rápidamente tus conceptos de prompt y luego pasa a SD 3.5 Large para tus renders finales. Combínalo con Super Resolution para una salida en 4K y con inpainting para las correcciones puntuales. Ese flujo de trabajo de tres herramientas cubre todo lo que necesitas para producir fotografía de IA sensual de calidad profesional sin ninguna infraestructura local.
El trabajo con el prompt es lo que separa los resultados olvidables de las imágenes impresionantes. Aplica la fórmula de cuatro partes, mantén el CFG entre 4 y 6, especifica la dirección de la luz y deja que SD 3.5 haga el resto. Ve a PicassoIA y lanza tu primer prompt ahora mismo.