Midjourney genera imágenes preciosas. Nadie lo va a discutir. Pero cuando intentas hacer algo fuera de su único estilo visual, como generar un retrato hiperrealista con detalle de poros en la piel, iterar 50 variaciones de estilo en una sola sesión sin pagar por cada generación, o pasar de lo fotorrealista a lo pictórico y al anime dentro del mismo flujo de trabajo, chocas enseguida con un muro. La variedad de modelos no está ahí. Y esa carencia es justo por donde hay que empezar la conversación.
No se trata de que Midjourney sea malo. Se trata de lo que pasa cuando tu proyecto exige más de lo que puede ofrecer una sola herramienta. Cuando preparas mockups de fotografía de producto, contenido para redes sociales a escala, retratos editoriales o arte conceptual que tiene que ajustarse con precisión a un brief, un modelo cerrado y único, con una sola tendencia estética, no basta. La pregunta no es "¿qué IA hace imágenes más bonitas?". La pregunta es "¿qué plataforma me da la herramienta adecuada para cada trabajo concreto?". Ahí es donde "Picasso AI tiene todos los modelos que Midjourney no tiene" deja de ser un titular y se convierte en una realidad funcional con implicaciones reales en el flujo de trabajo.
Los límites reales de Midjourney
Midjourney es un modelo cerrado. Tienes un solo motor, una sola tendencia estética y una sola estructura de precios. La plataforma ha mejorado mucho de una versión a otra, pero todos sus resultados llevan la misma firma de fondo: esa calidad ligeramente ilustrativa y pictórica que hace que una imagen de Midjourney se reconozca a la legua.
Eso es una ventaja cuando quieres ese look. Es una limitación cuando no lo quieres.
Esto es lo que Midjourney no te ofrece:
- Múltiples modelos base con datos de entrenamiento y características de salida fundamentalmente distintos
- Arquitecturas de código abierto como Stable Diffusion, que tiene años de ajuste fino por parte de la comunidad detrás
- Modelos especializados en retratos, ajustados específicamente para piel, cabello y estructura facial realistas
- Versiones optimizadas en velocidad que producen resultados utilizables en menos de cinco segundos por generación
- Controles de scheduler y de guidance que te permiten ajustar el proceso de difusión a nivel técnico
- Flujos img2img completos en los que subes una foto de referencia y la reorientas con un prompt
- Prompts negativos que excluyen explícitamente los elementos no deseados del resultado
- Semillas reproducibles con control total de la iteración desde un punto de partida fijo
Cuando sumas esas carencias en un flujo de trabajo real de producción de contenido, dejan de ser pequeñas molestias y se convierten en horas de soluciones provisionales, cambios de plataforma y una calidad de resultados mermada.
El catálogo de modelos del que nadie habla
El catálogo de texto a imagen de PicassoIA supera los 90 modelos. No son 90 variantes de un mismo modelo, sino arquitecturas distintas con fortalezas diferentes, tendencias estéticas diferentes y controles técnicos diferentes. La familia Flux por sí sola cubre tres casos de uso distintos. Además, encuentras especialistas en retratos, motores multiestilo y la arquitectura de código abierto Stable Diffusion con acceso técnico completo.
Aquí es donde la diferencia se vuelve concreta.
Flux Schnell: velocidad a escala
Flux Schnell genera una imagen completa de 1 megapíxel en menos de cinco segundos con cuatro pasos de eliminación de ruido. Si ejecutas 50 variaciones de prompt para encontrar la dirección visual adecuada, esperar entre 30 y 45 segundos por imagen en otra plataforma te cuesta tiempo de trabajo real a lo largo de la sesión. Flux Schnell no te lo cuesta.
El modelo admite 11 relaciones de aspecto, exporta en webp, jpg o png con una calidad ajustable de 0 a 100, y funciona en PicassoIA sin límites de generación. Puedes iterar un concepto completo sin estar pendiente de un contador de créditos. Un parámetro de semilla te permite reproducir exactamente cualquier resultado cuando encuentras algo que merece la pena desarrollar.
💡 Cuándo usarlo: Bocetos conceptuales, iteración rápida, generación de lotes para revisión de clientes y cualquier flujo en el que llegar rápido a la dirección correcta importe más que la calidad absoluta del resultado. Flux Schnell no es el modelo para trabajo de detalle en la versión final. Nada le gana en velocidad.
Flux Dev: precisión sin concesiones
Flux Dev es un modelo de 12.000 millones de parámetros pensado para quienes necesitan que el prompt aparezca de verdad en la imagen. La mayoría de los generadores de IA interpretan tus palabras de forma libre, suavizan los detalles o ignoran partes de tu descripción por completo. Flux Dev está ajustado para seguir los prompts con precisión real, así que cuando describes una escena concreta, una condición de iluminación o un detalle del sujeto, la imagen refleja siempre esos matices.
Sirve tanto para generación de texto a imagen como para edición img2img, admite 11 relaciones de aspecto y te permite controlar los pasos de inferencia entre 28 y 50 para equilibrar calidad y velocidad de generación. Un parámetro de guidance determina cuánto se ajusta el modelo a tu texto frente a componer con más libertad. El parámetro de semilla te permite fijar un resultado y seguir iterando a partir de él, cambiando una variable cada vez.
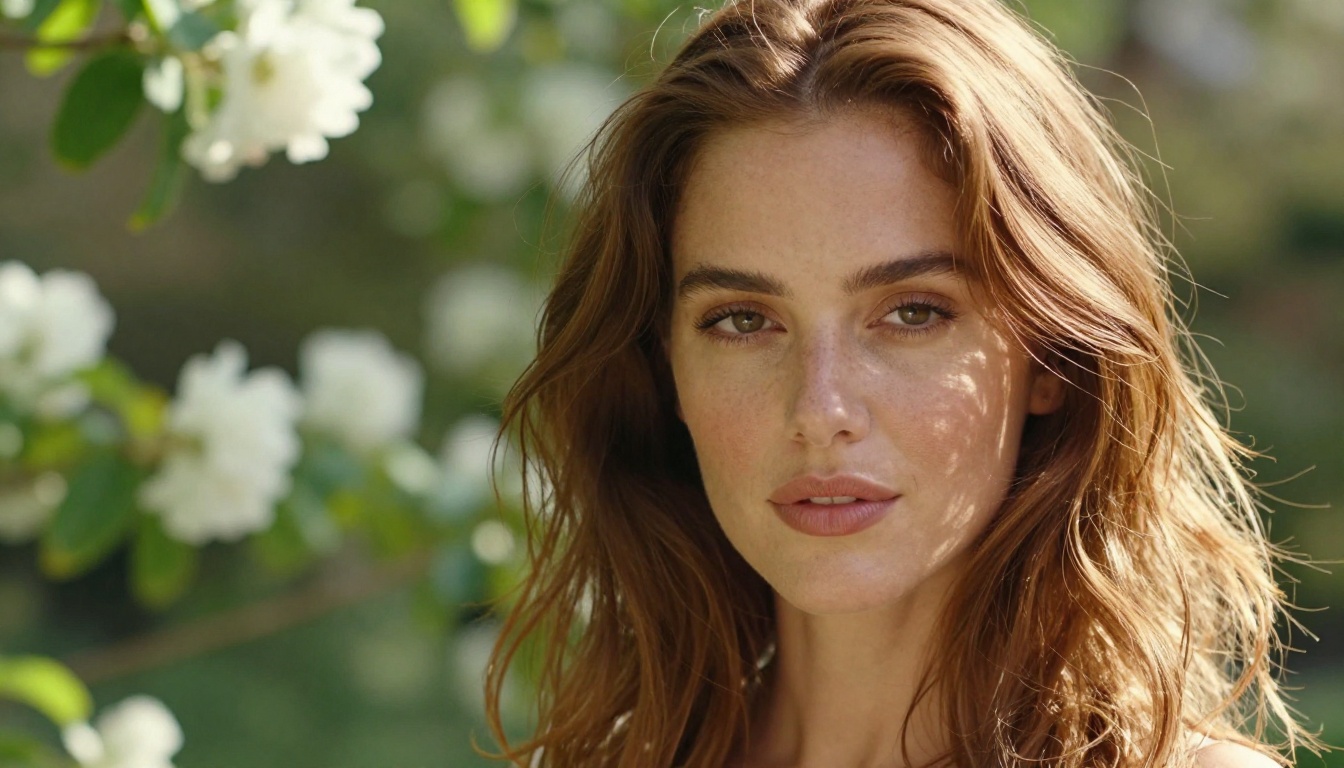
💡 Ideal para: Mockups de producto, arte conceptual en el que la composición debe ajustarse a un brief, imágenes editoriales y cualquier flujo en el que "más o menos" no sea suficiente.
Flux Pro: cuando el brief tiene que cumplirse
Flux Pro añade un control de guidance y un ajuste de interval sobre la base de precisión de Flux Dev. Guidance determina lo fielmente que el resultado se ajusta a tu descripción de texto. Interval introduce variación compositiva entre ejecuciones, algo útil cuando quieres un abanico de opciones a partir del mismo prompt en lugar de resultados parecidos cada vez.
El modelo también acepta una imagen de referencia junto con tu texto, lo que ofrece un mecanismo de guía basado en referencias que va más allá de lo que pueden hacer las palabras por sí solas. Para trabajos de marca en los que el brief de copy y una imagen de referencia visual deben guiar el resultado a la vez, Flux Pro gestiona ambas entradas al mismo tiempo. Es el modelo que se gana su sitio en los flujos de producción de las agencias.
| Característica | Flux Schnell | Flux Dev | Flux Pro |
|---|
| Velocidad de generación | Menos de 5 segundos | 15-30 segundos | 20-40 segundos |
| Precisión del prompt | Buena | Alta | Muy alta |
| Soporte img2img | No | Sí | Sí |
| Entrada de imagen como prompt | No | No | Sí |
| Control de guidance | Básico | Sí | Sí, más Interval |
| Ideal para | Bocetos rápidos | Trabajo de precisión | Producción basada en briefs |
Retratos fotorrealistas bien resueltos
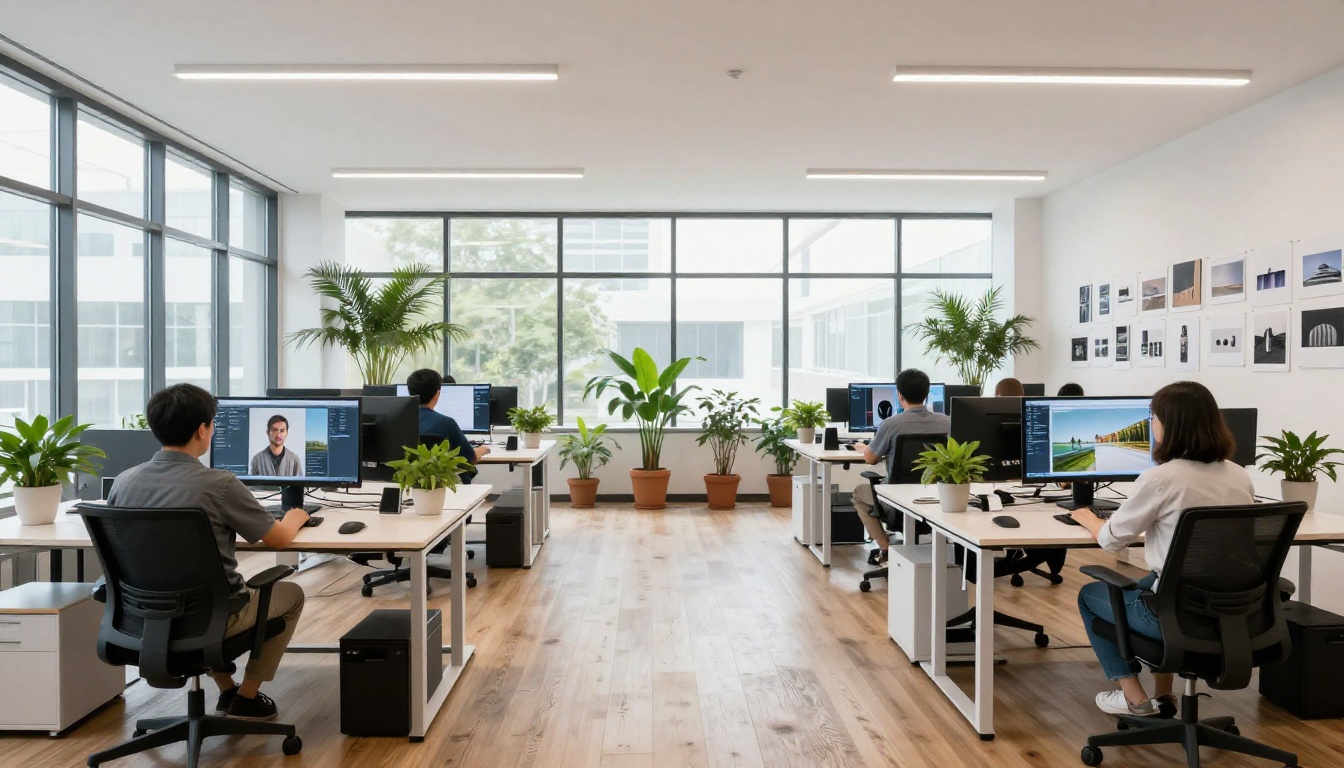
Aquí es donde el enfoque de un solo modelo de Midjourney muestra su debilidad práctica más importante. Los rostros humanos realistas necesitan un entrenamiento especializado. Los modelos genéricos producen piel que parece demasiado lisa, manos con anatomía incorrecta e iluminación que resulta artificial aunque la composición sea correcta.
Realistic Vision v5.1
Realistic Vision v5.1 se creó específicamente para resolver este problema. El modelo se ajustó con retratos humanos fotorrealistas, con un enfoque deliberado en tres puntos de fallo recurrentes de los generadores genéricos: el realismo de la textura de la piel, la precisión de la estructura facial y el comportamiento natural de la luz.
Esto es lo que obtienes realmente con este modelo:
- Detalle de poros en la piel que aguanta un recorte cerrado sin parecer retocado con aerógrafo ni de plástico
- Control mediante prompt negativo para excluir los artefactos más comunes en retratos antes de que aparezcan
- Schedulers duales (EulerA y MultistepDPM-Solver) para distintas características de render y definición de bordes
- Resolución personalizada de hasta 1024 px en cualquiera de los ejes
- Integración de VAE que produce una saturación de color más rica y un detalle más fino que los resultados del modelo base estándar
- Rango de guidance scale de 3,5 a 7 para equilibrar la fidelidad al prompt con la variación creativa
El prompt negativo por defecto de Realistic Vision ya excluye los artefactos más habituales en retratos generados por IA: iris deformes, pupilas deformes, dedos extra, manos deformadas, proporciones incorrectas, cuellos largos y render de estilo CGI. Puedes ampliar o modificar ese prompt negativo según lo que tu resultado concreto necesite evitar.
Para fotógrafos de producto, creadores de redes sociales o diseñadores que necesitan imágenes de personas de calidad constante cuando las requieren, este modelo genera resultados que parecen obra de un fotógrafo de retratos experimentado. Es una capacidad que el motor de uso general de Midjourney no replica de forma fiable.
Variedad de estilos más allá de un solo look
Dreamshaper XL Turbo
Dreamshaper XL Turbo cubre toda la gama de estilos visuales dentro de un solo modelo: retratos fotorrealistas, ilustraciones pictóricas, personajes de anime, viñetas de estilo manga y arte conceptual de entornos. Funciona con la resolución nativa de SDXL (1024x1024) y produce resultados utilizables con tan solo seis pasos de eliminación de ruido, normalmente en menos de diez segundos.
Siete schedulers te dan un control significativo sobre la estética del renderizado. DDIM produce características de borde distintas a las de K_EULER. Cambiar de scheduler con el mismo prompt pasa el resultado de nítido y fotográfico a suave y pictórico sin cambiar ni una palabra del texto. Esto importa cuando trabajas con varios formatos y estilos de contenido dentro de la misma semana.
Un equipo de redes sociales que necesita una foto de producto fotorrealista el lunes y una ilustración de personaje estilo anime el jueves no tiene que cambiar de plataforma, de cuenta ni de flujo de trabajo. Un modelo, una interfaz, toda la gama de estilos.
💡 Consejo sobre schedulers: Empieza con K_EULER para la mayoría de trabajos. Cambia a DPMSolverMultistep cuando quieras una definición de bordes más nítida. HeunDiscrete da resultados más pictóricos y con textura con el mismo prompt.
Stable Diffusion clásico
Stable Diffusion sigue siendo la base del ecosistema de generación de imágenes de código abierto. En PicassoIA funciona con seis schedulers, control de resolución de 64 px a 1024 px en incrementos precisos, soporte de prompt negativo y una guidance scale ajustable.
Su verdadero valor está en el control técnico que expone. Seis opciones de scheduler producen resultados notablemente distintos: DDIM, K_EULER, DPMSolverMultistep, K_EULER_ANCESTRAL, PNDM y KLMS tienen cada uno características diferentes. Si entiendes los modelos de difusión y quieres tener los mandos para dirigir el resultado a nivel técnico, Stable Diffusion te da esa superficie de control. Midjourney no expone nada de esto.
Cómo usar Flux Dev en PicassoIA
Como Flux Dev es uno de los modelos más versátiles disponibles, así se consiguen los mejores resultados, paso a paso:
Paso 1: escribe un prompt específico
Flux Dev sigue los prompts con gran fidelidad, así que los prompts vagos dan resultados vagos. Describe el sujeto, la dirección de la luz, el fondo, el ambiente y cualquier detalle de composición con términos claros.
Ejemplo: "Foto RAW, retrato en primer plano de una mujer de unos 30 años en una cafetería soleada, luz cálida de la tarde desde la izquierda, profundidad de campo reducida, textura natural de la piel, pared de fondo color crema, 85 mm f/1.8"
Paso 2: fija la relación de aspecto antes de generar
Elige la relación que encaje con el uso previsto. 16:9 para banners web, 1:1 para publicaciones en redes y 9:16 para historias verticales. Cambiarla después te cuesta otra generación.
Paso 3: fija los pasos de inferencia entre 28 y 35
Con 28 pasos obtienes un resultado rápido y limpio para la mayoría de sujetos. De 35 a 50 añaden más detalle a cambio de más tiempo de generación. Para la mayor parte del trabajo comercial, 28 es un buen punto de partida.
Paso 4: fija una semilla para iterar
Cuando consigas un resultado que merezca la pena desarrollar, anota el número de semilla. Cambia una cosa en tu prompt y vuelve a generar con la misma semilla. Verás exactamente qué ha cambiado en lugar de obtener una composición completamente distinta.
Paso 5: usa img2img para trabajos basados en referencias
Sube una foto de referencia y fija la intensidad del prompt entre 0,6 y 0,8. Los valores bajos conservan más de la estructura original de la imagen. Los valores altos dejan que el prompt modifique más la composición visual. Empieza en 0,7 y ajusta a partir de ahí.
💡 Ajuste de guidance: Empieza en 3,5 en la primera ejecución. Súbelo a 5-7 si el resultado no sigue lo bastante de cerca la descripción de tu prompt. Bájalo por debajo de 3 si quieres más variación compositiva entre ejecuciones.
Qué obtienes realmente frente a Midjourney
| Capacidad | Midjourney | PicassoIA |
|---|
| Total de modelos de texto a imagen | 1 | 90+ |
| Modelos de código abierto | No | Sí (SDXL, SD, Flux) |
| Modelos especializados en retratos | No | Sí (Realistic Vision v5.1) |
| Modelos optimizados en velocidad | No | Sí (Flux Schnell) |
| Un solo modelo multiestilo | No | Sí (Dreamshaper XL Turbo) |
| Flujo img2img | Limitado | Completo (Flux Dev, Flux Pro) |
| Prompts negativos | No | Sí |
| Selección de scheduler | No | Sí (hasta 7 opciones) |
| Control de guidance scale | No | Sí |
| Control de variación de interval | No | Sí (Flux Pro) |
| Control de semilla | Parcial | Completo |
| Límites de generación | Sí | No |
| Estilos anime y manga | Limitado | Sí |
| Escalado con Super Resolution | No | Sí |
| Eliminación de fondo | No | Sí |
| Texto a video | No | Sí (87 modelos) |
| Intercambio de rostros | No | Sí |
| Generación de música con IA | No | Sí |
La diferencia no es marginal. Es estructural. Midjourney construyó un producto alrededor de un único modelo cerrado y bien afinado. PicassoIA construyó una plataforma para darte el modelo adecuado para cada tarea concreta.
A quién le cambia las cosas de verdad
No todo el mundo necesita 90 modelos. Si tu flujo de trabajo es "generar imágenes para redes sociales" y la estética de Midjourney encaja con lo que buscas, no hay fricción que merezca la pena resolver. Pero si alguna de estas situaciones te describe, la carencia de modelos se vuelve significativa:
Creadores de contenido que producen en varios formatos visuales, fotorrealistas, ilustrados y de estilo anime, necesitan una plataforma que los cubra todos en un solo lugar, sin suscripciones, cuentas ni cambios de herramienta por separado.
Equipos de producto que crean mockups e imágenes de estilo de vida necesitan precisión de prompt y soporte img2img. Subir una foto de referencia más una reorientación de texto es un flujo real y repetible. Hace falta un modelo diseñado para gestionar ambas entradas con limpieza.
Fotógrafos de retratos y retocadores que quieren imágenes de referencia asistidas por IA necesitan un modelo entrenado específicamente con rostros. Un motor de propósito general que de vez en cuando acierta con los rostros no es lo mismo que uno pensado para esa categoría de resultados.
Desarrolladores y usuarios avanzados que entienden los modelos de difusión quieren selección de scheduler, controles de guidance y semillas reproducibles. Necesitan la superficie técnica que solo exponen las plataformas basadas en código abierto.
Agencias con producción a gran volumen que cubren cientos de piezas para distintos briefs, estilos y clientes necesitan generación ilimitada sin que el precio por imagen condicione las decisiones creativas.
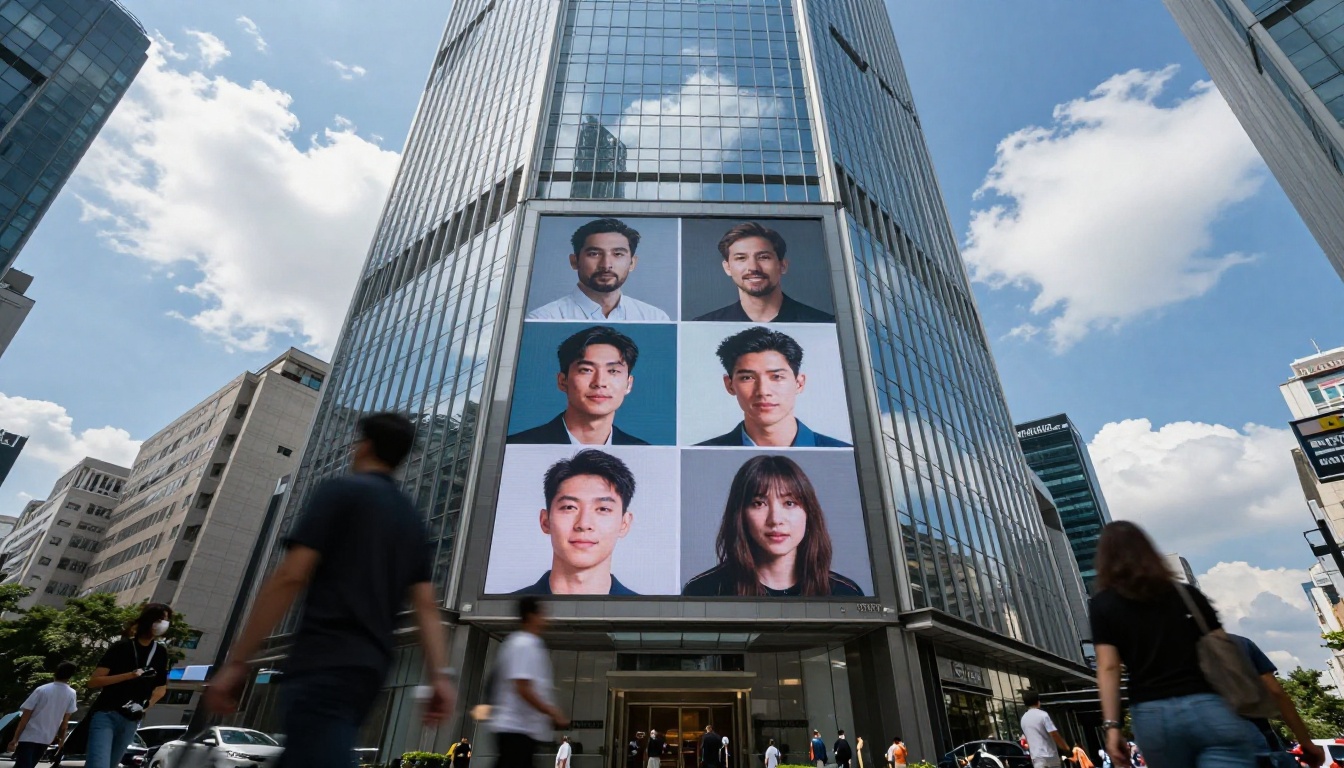
Elige un modelo y empieza ya
Los modelos de este artículo funcionan ahora mismo en PicassoIA, desde tu navegador, sin configuración, sin límites de créditos y sin límites de generación. Elige el que encaje con la tarea que tienes delante:
- Bocetos conceptuales rápidos: Flux Schnell en menos de cinco segundos por imagen
- Producción precisa con prompt: Flux Dev con img2img y control total de la semilla
- Trabajo de marca basado en briefs: Flux Pro con entrada de imagen como prompt e interval para la variación
- Retratos fotorrealistas: Realistic Vision v5.1 con detalle de poros en la piel
- Contenido multiestilo: Dreamshaper XL Turbo para foto, anime e ilustración
- Control técnico: Stable Diffusion con seis schedulers y control total de la resolución
Escribe un prompt. Elige un modelo. Mira qué resultado sale. La diferencia entre un modelo y noventa aparece en el momento en que tu brief se vuelve lo bastante específico como para que una estética de propósito general ya no sirva.


