Midjourney सुंदर इमेज बनाता है। इस पर कोई बहस नहीं है। लेकिन जब आप उसकी एक ही विज़ुअल लेन से बाहर कुछ करने की कोशिश करते हैं, जैसे पोर-लेवल स्किन डिटेल वाला हाइपर-रियलिस्टिक पोर्ट्रेट बनाना, या एक सेशन में बिना हर जनरेशन का पैसा दिए 50 स्टाइल वेरिएशन आज़माना, या एक ही वर्कफ़्लो में फ़ोटोरियलिस्टिक से पेंटरली और फिर एनीमे पर जाना, तो आप जल्दी ही एक सीमा पर अटक जाते हैं। मॉडल की विविधता वहाँ नहीं है। और यही वह कमी है जहाँ से बात शुरू होनी चाहिए।
यह Midjourney के बुरा होने की बात नहीं है। बात यह है कि जब आपका प्रोजेक्ट एक टूल से ज़्यादा माँगता है, तब क्या होता है। जब आप प्रोडक्ट फ़ोटोग्राफ़ी के मॉकअप, बड़े पैमाने पर सोशल मीडिया कंटेंट, एडिटोरियल पोर्ट्रेट, या ऐसा कॉन्सेप्ट आर्ट बना रहे हों जिसे ब्रीफ़ से हूबहू मेल खाना हो, तो एक ही बंद मॉडल, जिसका एक ही सौंदर्य-झुकाव हो, काफ़ी नहीं होता। सवाल यह नहीं है कि "कौन सा AI सुंदर तस्वीरें बनाता है?" सवाल यह है कि "कौन सा प्लेटफ़ॉर्म मुझे हर खास काम के लिए सही टूल देता है?" यहीं पर Picasso AI में वे सारे मॉडल हैं जो Midjourney में नहीं हैं, यह शीर्षक सिर्फ़ हेडलाइन से आगे बढ़कर एक व्यावहारिक सच्चाई बन जाता है, जिसके वर्कफ़्लो पर असली असर पड़ते हैं।
Midjourney आपको असल में किन चीज़ों तक सीमित रखता है
Midjourney एक बंद मॉडल है। आपको एक इंजन, एक सौंदर्य-झुकाव और एक ही प्राइसिंग स्ट्रक्चर मिलता है। प्लेटफ़ॉर्म ने अलग-अलग वर्ज़न में काफ़ी सुधार किया है, लेकिन हर आउटपुट में वही मूल पहचान रहती है: थोड़ी चित्रात्मक, पेंटरली क्वालिटी, जिससे एक Midjourney इमेज दूर से ही पहचानी जा सकती है।
जब आपको वह लुक चाहिए, तो यह एक खूबी है। जब नहीं चाहिए, तो यह एक बाधा है।
Midjourney आपको यह नहीं देता:
- कई बेस मॉडल जिनका ट्रेनिंग डेटा और आउटपुट की विशेषताएँ मौलिक रूप से अलग हों
- ओपन-सोर्स आर्किटेक्चर जैसे Stable Diffusion, जिसके पीछे वर्षों की कम्युनिटी फ़ाइन-ट्यूनिंग है
- पोर्ट्रेट-विशेष मॉडल जो असली दिखने वाली त्वचा, बाल और चेहरे की बनावट के लिए ख़ास तौर पर फ़ाइन-ट्यून किए गए हों
- स्पीड-ऑप्टिमाइज़्ड वर्ज़न जो हर जनरेशन में पाँच सेकंड से कम में इस्तेमाल लायक आउटपुट दें
- शेड्यूलर और गाइडेंस कंट्रोल जो आपको डिफ़्यूज़न प्रक्रिया को तकनीकी स्तर पर ट्यून करने दें
- पूरे img2img वर्कफ़्लो जहाँ आप एक रेफ़रेंस फ़ोटो अपलोड करके उसे प्रॉम्प्ट से दिशा दे सकें
- नेगेटिव प्रॉम्प्ट जो आउटपुट से अवांछित तत्वों को साफ़ तौर पर बाहर रखें
- रीप्रोड्यूसिबल सीड जिनसे आप एक तय शुरुआती बिंदु से हर वेरिएशन पर पूरा नियंत्रण रख सकें
जब आप असली कंटेंट प्रोडक्शन वर्कफ़्लो में इन कमियों को जोड़ते हैं, तो वे छोटी-मोटी असुविधाएँ नहीं रह जातीं। वे घंटों के जुगाड़, बार-बार प्लेटफ़ॉर्म बदलने और समझौते वाली आउटपुट क्वालिटी का रूप ले लेती हैं।
वह मॉडल लाइनअप जिसके बारे में कोई बात नहीं करता
PicassoIA की टेक्स्ट-टू-इमेज कैटलॉग में 90 से ज़्यादा मॉडल हैं। ये एक मॉडल के 90 वेरिएशन नहीं, बल्कि अलग-अलग आर्किटेक्चर हैं, जिनकी ताकत, सौंदर्य-झुकाव और तकनीकी कंट्रोल अलग-अलग हैं। अकेले Flux परिवार तीन अलग इस्तेमाल के मामलों को कवर करता है। इसके अलावा, आपको पोर्ट्रेट विशेषज्ञ, मल्टी-स्टाइल इंजन और पूरे तकनीकी एक्सपोज़र वाला ओपन-सोर्स Stable Diffusion आर्किटेक्चर मिलता है।
यहाँ देखिए कि यह कमी ठोस रूप कैसे लेती है।
Flux Schnell: बड़े पैमाने पर स्पीड
Flux Schnell चार डीनोइज़िंग स्टेप्स का इस्तेमाल करके पाँच सेकंड से कम में पूरी 1-मेगापिक्सल इमेज बनाता है। अगर आप सही विज़ुअल दिशा खोजने के लिए 50 प्रॉम्प्ट वेरिएशन चला रहे हैं, तो किसी दूसरे प्लेटफ़ॉर्म पर हर इमेज के लिए 30-45 सेकंड इंतज़ार करना पूरे सेशन में असली कीमती समय खर्च करता है। Flux Schnell ऐसा नहीं करता।
यह मॉडल 11 आस्पेक्ट रेशियो सपोर्ट करता है, webp, jpg या png में आउटपुट देता है, और क्वालिटी 0 से 100 तक एडजस्ट की जा सकती है। यह PicassoIA पर बिना किसी जनरेशन कैप के चलता है। आप क्रेडिट काउंटर देखे बिना पूरा कॉन्सेप्ट सेशन चला सकते हैं। जब आपको कोई नतीजा आगे विकसित करने लायक लगे, तो सीड पैरामीटर से आप उसे बिल्कुल वैसा ही दोबारा बना सकते हैं।
💡 इसे कब इस्तेमाल करें: कॉन्सेप्ट ड्राफ़्टिंग, तेज़ इटरेशन, क्लाइंट रिव्यू के लिए बैच बनाना, और ऐसा कोई भी वर्कफ़्लो जहाँ सही दिशा जल्दी पाना, पूरी आउटपुट क्वालिटी से ज़्यादा मायने रखता है। Flux Schnell फ़ाइनल-आउटपुट की बारीक डिटेल वाले काम के लिए मॉडल नहीं है। स्पीड में इसका कोई मुकाबला नहीं।
Flux Dev: बिना समझौते की सटीकता
Flux Dev एक 12-बिलियन पैरामीटर मॉडल है, जो उन यूज़र्स के लिए बना है जिन्हें चाहिए कि प्रॉम्प्ट सचमुच इमेज में दिखे। ज़्यादातर AI जेनरेटर आपके शब्दों की व्याख्या ढीली तरह से करते हैं, डिटेल्स को धुंधला कर देते हैं या आपके विवरण का हिस्सा पूरी तरह नज़रअंदाज़ कर देते हैं। Flux Dev प्रॉम्प्ट को असली सटीकता से फ़ॉलो करने के लिए ट्यून किया गया है, इसलिए जब आप कोई खास सीन, लाइटिंग कंडीशन या सब्जेक्ट की डिटेल बताते हैं, तो इमेज उन बातों को लगातार दिखाती है।
यह टेक्स्ट-टू-इमेज और img2img एडिटिंग दोनों संभालता है, 11 आस्पेक्ट रेशियो सपोर्ट करता है, और क्वालिटी बनाम जनरेशन स्पीड को संतुलित करने के लिए 28 से 50 के बीच इनफ़रेंस स्टेप्स पर आपको कंट्रोल देता है। एक गाइडेंस पैरामीटर तय करता है कि मॉडल आपके टेक्स्ट को कितनी सख्ती से फ़ॉलो करे, बनाम कितनी आज़ादी से कंपोज़ करे। सीड पैरामीटर से आप कोई नतीजा लॉक कर सकते हैं और एक समय में एक वेरिएबल बदलते हुए उसी से आगे बढ़ सकते हैं।
💡 किसके लिए सबसे अच्छा: प्रोडक्ट मॉकअप, ऐसा कॉन्सेप्ट आर्ट जहाँ कंपोज़िशन को ब्रीफ़ से मेल खाना हो, एडिटोरियल इमेजरी, और ऐसा कोई भी वर्कफ़्लो जहाँ "लगभग ठीक" सचमुच काफ़ी न हो।
Flux Pro: जब ब्रीफ़ पर टिके रहना ज़रूरी हो
Flux Pro Flux Dev की सटीकता की नींव के ऊपर एक गाइडेंस कंट्रोल और एक इंटरवल सेटिंग जोड़ता है। गाइडेंस तय करता है कि आउटपुट आपके टेक्स्ट विवरण से कितनी करीबी से मेल खाए। इंटरवल अलग-अलग रन में कंपोज़िशनल वेरिएंस लाता है, जो तब काम का है जब आपको एक ही प्रॉम्प्ट से हर बार मिलते-जुलते नतीजों की बजाय विकल्पों की एक विविध रेंज चाहिए।
यह मॉडल आपके टेक्स्ट के साथ एक इमेज प्रॉम्प्ट भी स्वीकार करता है, जिससे आपको रेफ़रेंस-आधारित दिशा देने का तरीका मिलता है, जो अकेले शब्द जितना कर सकते हैं उससे आगे जाता है। ब्रांड वर्क के लिए, जहाँ कॉपी ब्रीफ़ और विज़ुअल रेफ़रेंस इमेज दोनों को एक साथ आउटपुट को दिशा देनी हो, Flux Pro दोनों इनपुट एक साथ संभालता है। यह वही मॉडल है जो एजेंसी प्रोडक्शन पाइपलाइन में अपनी जगह बनाता है।
| फ़ीचर | Flux Schnell | Flux Dev | Flux Pro |
|---|
| जनरेशन स्पीड | 5 सेकंड से कम | 15-30 सेकंड | 20-40 सेकंड |
| प्रॉम्प्ट एक्यूरेसी | अच्छी | ज़्यादा | बहुत ज़्यादा |
| img2img सपोर्ट | नहीं | हाँ | हाँ |
| इमेज प्रॉम्प्ट इनपुट | नहीं | नहीं | हाँ |
| गाइडेंस कंट्रोल | बेसिक | हाँ | हाँ, इंटरवल के साथ |
| किसके लिए सबसे अच्छा | तेज़ ड्राफ़्ट | सटीक काम | ब्रीफ़ पर आधारित प्रोडक्शन |
फ़ोटोरियलिस्टिक पोर्ट्रेट, सही तरीके से
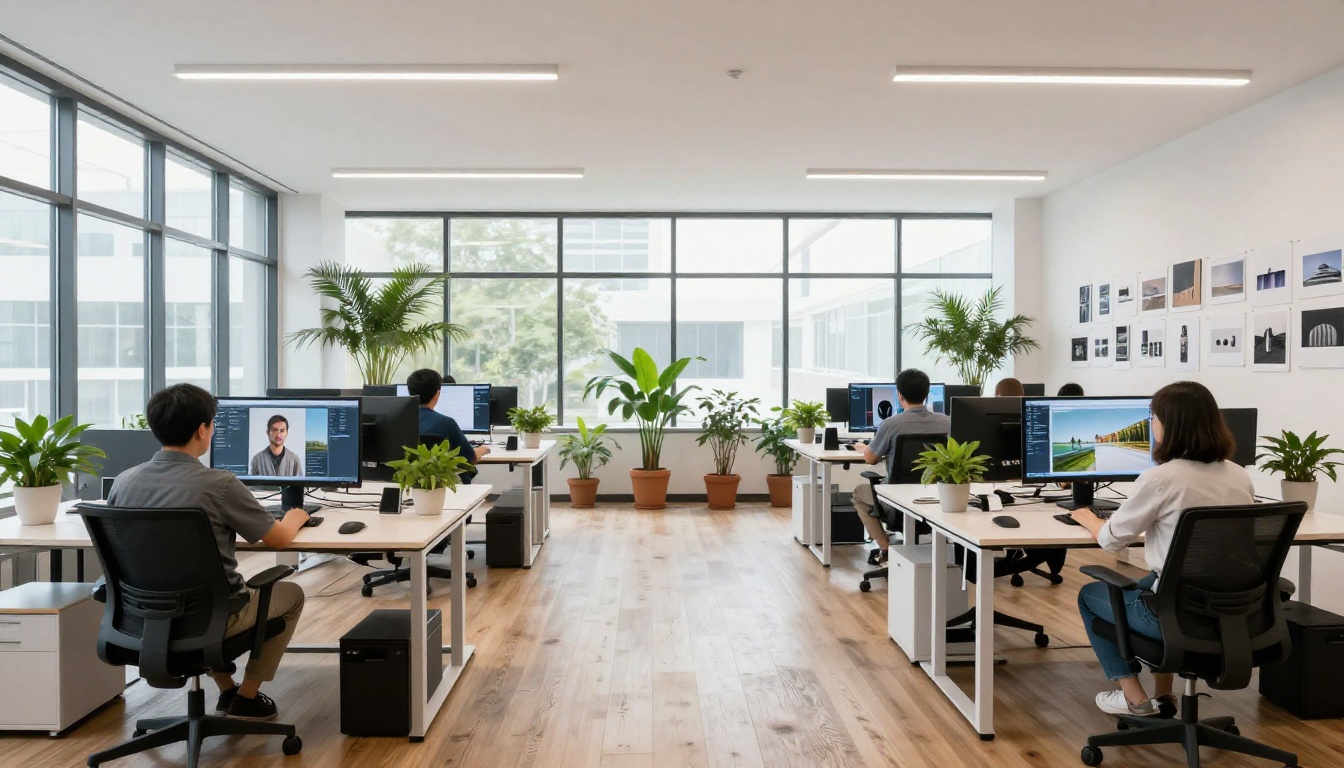
यहीं पर Midjourney के सिंगल-मॉडल तरीके की सबसे बड़ी व्यावहारिक कमज़ोरी दिखती है। असली मानव चेहरों के लिए ख़ास ट्रेनिंग चाहिए। आम मॉडल ऐसी त्वचा बनाते हैं जो बहुत चिकनी लगती है, ऐसे हाथ बनाते हैं जो शारीरिक रूप से गलत होते हैं, और ऐसी लाइटिंग देते हैं जो कंपोज़िशन सही होने पर भी नकली लगती है।
Realistic Vision v5.1
Realistic Vision v5.1 ठीक इसी समस्या को हल करने के लिए बनाया गया था। इस मॉडल को फ़ोटोरियलिस्टिक मानव पोर्ट्रेट पर फ़ाइन-ट्यून किया गया है, और इसमें आम जेनरेटरों की तीन बार-बार होने वाली विफलता वाली जगहों पर जानबूझकर ध्यान दिया गया है: स्किन टेक्सचर की वास्तविकता, चेहरे की बनावट की सटीकता, और प्राकृतिक लाइटिंग का व्यवहार।
इस मॉडल के साथ आपको असल में यह मिलता है:
- पोर-लेवल स्किन डिटेल जो क्लोज़ क्रॉप में भी एयरब्रश्ड या प्लास्टिक जैसी दिखे बिना टिकी रहे
- नेगेटिव प्रॉम्प्ट कंट्रोल जो सबसे आम पोर्ट्रेट आर्टिफ़ैक्ट्स को दिखने से पहले ही बाहर रखे
- ड्यूअल शेड्यूलर (EulerA और MultistepDPM-Solver) अलग-अलग रेंडरिंग विशेषताओं और एज डेफ़िनिशन के लिए
- कस्टम रेज़ोल्यूशन किसी भी अक्ष पर 1024px तक
- VAE इंटीग्रेशन जो स्टैंडर्ड बेस मॉडल आउटपुट से ज़्यादा समृद्ध कलर सैचुरेशन और बारीक डिटेल देता है
- गाइडेंस स्केल रेंज 3.5 से 7 तक, प्रॉम्प्ट की निष्ठा और क्रिएटिव वेरिएशन के बीच संतुलन के लिए
Realistic Vision के डिफ़ॉल्ट नेगेटिव प्रॉम्प्ट में ही सबसे आम AI पोर्ट्रेट आर्टिफ़ैक्ट्स पहले से बाहर रखे गए हैं: विकृत आइरिस, विकृत पुतलियाँ, अतिरिक्त उंगलियाँ, बदले हुए हाथ, गलत अनुपात, लंबी गर्दन और CGI-स्टाइल रेंडरिंग। आपकी खास इमेज को जिससे बचना है, उसके आधार पर आप इस नेगेटिव प्रॉम्प्ट को बढ़ा या बदल सकते हैं।
प्रोडक्ट फ़ोटोग्राफ़रों, सोशल मीडिया क्रिएटरों, या ऐसे डिज़ाइनरों के लिए जिन्हें माँग पर लगातार मानव-सब्जेक्ट वाली इमेजरी चाहिए, यह मॉडल ऐसे आउटपुट देता है जो किसी कुशल पोर्ट्रेट फ़ोटोग्राफ़र की तस्वीरों जैसे दिखते हैं। यह एक ऐसी क्षमता है जिसे Midjourney का जनरल-पर्पज़ इंजन भरोसे से दोहरा नहीं पाता।
एक लुक से आगे स्टाइल की रेंज
Dreamshaper XL Turbo
Dreamshaper XL Turbo एक ही मॉडल के भीतर दृश्य स्टाइलों की पूरी रेंज संभालता है: फ़ोटोरियलिस्टिक पोर्ट्रेट, पेंटरली इलस्ट्रेशन, एनीमे कैरेक्टर, मंगा-स्टाइल पैनल और एनवायरनमेंट कॉन्सेप्ट आर्ट। यह SDXL के नेटिव रेज़ोल्यूशन (1024x1024) पर चलता है और छह डीनोइज़िंग स्टेप्स जितना कम में इस्तेमाल लायक नतीजे देता है, आम तौर पर दस सेकंड से कम में।
सात शेड्यूलर रेंडरिंग सौंदर्य पर सार्थक नियंत्रण देते हैं। DDIM, K_EULER से अलग एज विशेषताएँ देता है। एक ही प्रॉम्प्ट पर शेड्यूलर बदलने से आउटपुट बिना टेक्स्ट का एक शब्द बदले तीखा और फ़ोटोग्राफ़िक से नरम और पेंटरली हो सकता है। यह तब मायने रखता है जब आप एक ही हफ़्ते में कई कंटेंट फ़ॉर्मैट और स्टाइल पर काम कर रहे हों।
एक सोशल मीडिया टीम को सोमवार को फ़ोटोरियलिस्टिक प्रोडक्ट शॉट चाहिए और गुरुवार को एनीमे-स्टाइल कैरेक्टर इलस्ट्रेशन। उसे प्लेटफ़ॉर्म, अकाउंट या वर्कफ़्लो बदलने की ज़रूरत नहीं पड़ती। एक मॉडल, एक इंटरफ़ेस, स्टाइल की पूरी रेंज।
💡 शेड्यूलर टिप: ज़्यादातर काम के लिए K_EULER से शुरू करें। तीखी एज डेफ़िनिशन चाहिए तो DPMSolverMultistep पर जाएँ। उसी प्रॉम्प्ट पर HeunDiscrete ज़्यादा पेंटरली, टेक्स्चर वाले नतीजे देता है।
Stable Diffusion क्लासिक्स
Stable Diffusion ओपन-सोर्स इमेज जनरेशन इकोसिस्टम की नींव बना हुआ है। PicassoIA पर यह छह शेड्यूलर, 64px से 1024px तक सटीक इंक्रीमेंट में रेज़ोल्यूशन कंट्रोल, नेगेटिव प्रॉम्प्ट सपोर्ट और एडजस्टेबल गाइडेंस स्केल के साथ चलता है।
इसकी असली खूबी वह तकनीकी कंट्रोल है जो यह खोलकर देता है। छह शेड्यूलर विकल्प सार्थक रूप से अलग नतीजे देते हैं: DDIM, K_EULER, DPMSolverMultistep, K_EULER_ANCESTRAL, PNDM और KLMS, हर एक की अलग विशेषताएँ हैं। अगर आप डिफ़्यूज़न मॉडल समझते हैं और चाहते हैं कि तकनीकी स्तर पर आउटपुट को सचमुच दिशा देने वाले हैंडल आपके हाथ में हों, तो Stable Diffusion वह सतह देता है। Midjourney इनमें से कुछ भी उजागर नहीं करता।
PicassoIA पर Flux Dev कैसे इस्तेमाल करें
चूँकि Flux Dev उपलब्ध सबसे बहुमुखी मॉडलों में से एक है, यहाँ बताया गया है कि सबसे अच्छे नतीजे कैसे पाएँ:
स्टेप 1: एक खास प्रॉम्प्ट लिखें
Flux Dev प्रॉम्प्ट को उच्च निष्ठा से फ़ॉलो करता है, इसलिए धुंधले प्रॉम्प्ट धुंधले नतीजे देते हैं। सब्जेक्ट, लाइटिंग की दिशा, बैकग्राउंड, मूड और कंपोज़िशन की कोई भी खास बात साफ़ शब्दों में बताएँ।
उदाहरण: "RAW photo, close-up portrait of a woman in her 30s in a sunlit cafe, warm afternoon light from the left, shallow depth of field, natural skin texture, cream-colored wall background, 85mm f/1.8"
स्टेप 2: जनरेट करने से पहले आस्पेक्ट रेशियो सेट करें
वह रेशियो चुनें जो आपके इस्तेमाल से मेल खाए। वेब बैनर के लिए 16:9, सोशल पोस्ट के लिए 1:1, वर्टिकल स्टोरी के लिए 9:16। बाद में बदलने पर एक और जनरेशन खर्च होती है।
स्टेप 3: इनफ़रेंस स्टेप्स 28-35 पर सेट करें
28 स्टेप्स ज़्यादातर सब्जेक्ट के लिए तेज़ और साफ़ आउटपुट देते हैं। 35 से 50 स्टेप्स जनरेशन के समय की कीमत पर बारीक डिटेल जोड़ते हैं। ज़्यादातर कमर्शियल काम के लिए 28 सही शुरुआती बिंदु है।
स्टेप 4: इटरेशन के लिए सीड लॉक करें
जब कोई नतीजा आगे विकसित करने लायक लगे, तो उसका सीड नंबर नोट करें। प्रॉम्प्ट में एक चीज़ बदलें और उसी सीड से दोबारा चलाएँ। आपको ठीक पता चलेगा कि क्या बदला, बजाय इसके कि पूरी तरह अलग कंपोज़िशन मिले।
स्टेप 5: रेफ़रेंस-आधारित काम के लिए img2img इस्तेमाल करें
एक रेफ़रेंस फ़ोटो अपलोड करें और प्रॉम्प्ट स्ट्रेंथ 0.6 से 0.8 पर सेट करें। कम वैल्यू मूल इमेज की संरचना को ज़्यादा बचाती है। ज़्यादा वैल्यू प्रॉम्प्ट को विज़ुअल कंपोज़िशन पर ज़्यादा हावी होने देती है। 0.7 से शुरू करें और वहीं से एडजस्ट करें।
💡 गाइडेंस सेटिंग: पहले रन के लिए 3.5 से शुरू करें। अगर आउटपुट आपके प्रॉम्प्ट विवरण को करीबी से नहीं मान रहा, तो 5 से 7 तक बढ़ाएँ। अगर रन-दर-रन ज़्यादा कंपोज़िशनल वेरिएशन चाहिए, तो 3 से नीचे लाएँ।
आपको असल में क्या मिलता है बनाम Midjourney
| क्षमता | Midjourney | PicassoIA |
|---|
| कुल टेक्स्ट-टू-इमेज मॉडल | 1 | 90+ |
| ओपन-सोर्स मॉडल | नहीं | हाँ (SDXL, SD, Flux) |
| पोर्ट्रेट-विशेष मॉडल | नहीं | हाँ (Realistic Vision v5.1) |
| स्पीड-ऑप्टिमाइज़्ड मॉडल | नहीं | हाँ (Flux Schnell) |
| मल्टी-स्टाइल एकल मॉडल | नहीं | हाँ (Dreamshaper XL Turbo) |
| img2img वर्कफ़्लो | सीमित | पूरा (Flux Dev, Flux Pro) |
| नेगेटिव प्रॉम्प्ट | नहीं | हाँ |
| शेड्यूलर चयन | नहीं | हाँ (7 विकल्प तक) |
| गाइडेंस स्केल कंट्रोल | नहीं | हाँ |
| इंटरवल वेरिएंस कंट्रोल | नहीं | हाँ (Flux Pro) |
| सीड कंट्रोल | आंशिक | पूरा |
| जनरेशन सीमाएँ | हाँ | नहीं |
| एनीमे और मंगा स्टाइल | सीमित | हाँ |
| Super Resolution अपस्केलिंग | नहीं | हाँ |
| बैकग्राउंड हटाना | नहीं | हाँ |
| टेक्स्ट-टू-वीडियो | नहीं | हाँ (87 मॉडल) |
| फेस स्वैप | नहीं | हाँ |
| AI म्यूज़िक जनरेशन | नहीं | हाँ |
यह अंतर मामूली नहीं है। यह ढाँचागत है। Midjourney ने एक अच्छी तरह ट्यून किए गए बंद मॉडल के आसपास एक प्रोडक्ट बनाया। PicassoIA ने हर खास काम के लिए सही मॉडल देने वाला प्लेटफ़ॉर्म बनाया।
इससे असल में किसकी ज़िंदगी बदलती है
हर किसी को 90 मॉडल की ज़रूरत नहीं है। अगर आपका वर्कफ़्लो "सोशल मीडिया के लिए इमेज बनाना" है और Midjourney का सौंदर्य आपकी ज़रूरत से मेल खाता है, तो सुलझाने लायक कोई दिक्कत नहीं है। लेकिन अगर इनमें से कोई भी आपकी स्थिति बताता है, तो मॉडल की कमी अहम हो जाती है:
कंटेंट क्रिएटर जो फ़ोटोरियलिस्टिक, इलस्ट्रेटेड और एनीमे-स्टाइल जैसे कई विज़ुअल फ़ॉर्मैट में काम करते हैं, उन्हें ऐसा प्लेटफ़ॉर्म चाहिए जो इन सबको एक जगह संभाले, अलग सब्सक्रिप्शन, अलग अकाउंट या टूल बदलने के बोझ के बिना।
प्रोडक्ट टीमें जो मॉकअप और लाइफ़स्टाइल इमेजरी बनाती हैं, उन्हें प्रॉम्प्ट की सटीकता और img2img सपोर्ट चाहिए। रेफ़रेंस फ़ोटो के साथ टेक्स्ट से दिशा देना एक असली, दोहराने लायक वर्कफ़्लो है। इसके लिए ऐसा मॉडल चाहिए जो दोनों इनपुट को साफ़ तौर पर संभाले।
पोर्ट्रेट फ़ोटोग्राफ़र और रिटचर जो AI-सहायित रेफ़रेंस इमेजरी चाहते हैं, उन्हें ऐसा मॉडल चाहिए जो खास तौर पर चेहरों पर ट्रेन हो। एक जनरल-पर्पज़ इंजन जो कभी-कभार चेहरे सही बनाता है, वह उस मॉडल जैसा नहीं है जो इसी आउटपुट श्रेणी के लिए बना हो।
डेवलपर और पावर यूज़र जो डिफ़्यूज़न मॉडल समझते हैं, उन्हें शेड्यूलर सिलेक्शन, गाइडेंस कंट्रोल और रीप्रोड्यूसिबल सीड चाहिए। उन्हें वह तकनीकी सतह चाहिए जो सिर्फ़ ओपन-सोर्स-आधारित प्लेटफ़ॉर्म उजागर करते हैं।
बड़े पैमाने पर प्रोडक्शन करने वाली एजेंसियाँ जो अलग-अलग ब्रीफ़, स्टाइल और क्लाइंट के सैकड़ों एसेट बनाती हैं, उन्हें बिना प्रति-इमेज कीमत के दबाव के असीमित जनरेशन चाहिए, ताकि क्रिएटिव फ़ैसले प्रभावित न हों।
एक मॉडल चुनें और अभी शुरू करें
इस लेख के मॉडल अभी PicassoIA पर आपके ब्राउज़र में चल रहे हैं, बिना किसी सेटअप, बिना क्रेडिट कैप और बिना जनरेशन की सीमा के। सामने के असली काम के हिसाब से वह चुनें जो फ़िट बैठे:
- तेज़ कॉन्सेप्ट ड्राफ़्ट: Flux Schnell, हर इमेज पर पाँच सेकंड से कम में
- प्रॉम्प्ट-सटीक प्रोडक्शन: Flux Dev, img2img और पूरे सीड कंट्रोल के साथ
- ब्रीफ़-आधारित ब्रांड वर्क: Flux Pro, इमेज प्रॉम्प्ट इनपुट और इंटरवल वेरिएंस के साथ
- फ़ोटोरियलिस्टिक पोर्ट्रेट: Realistic Vision v5.1, पोर-लेवल स्किन डिटेल के साथ
- मल्टी-स्टाइल कंटेंट: Dreamshaper XL Turbo, फ़ोटो, एनीमे और इलस्ट्रेशन में
- तकनीकी कंट्रोल: Stable Diffusion, छह शेड्यूलर और पूरे रेज़ोल्यूशन कंट्रोल के साथ
प्रॉम्प्ट लिखें। मॉडल चुनें। देखें कि क्या नतीजा आता है। एक मॉडल और नब्बे मॉडल के बीच का फ़र्क तब साफ़ दिखता है, जब आपका ब्रीफ़ इतना खास हो जाए कि कोई जनरल-पर्पज़ स्टाइल अब काम न आए।


