O Midjourney produz imagens bonitas. Ninguém vai discutir isso. Mas quando você tenta fazer algo fora da sua única faixa visual, como gerar um retrato hiper-realista com detalhes de poros na pele, ou iterar por 50 variações de estilo em uma única sessão sem pagar por geração, ou alternar do fotorrealista para o pictórico e depois para o anime no mesmo fluxo de trabalho, você rapidamente esbarra em um limite. A amplitude de modelos simplesmente não está ali. E é exatamente essa lacuna por onde a conversa precisa começar.
Isso não é sobre o Midjourney ser ruim. É sobre o que acontece quando seu projeto exige mais do que uma única ferramenta pode oferecer. Quando você está criando mockups de fotos de produtos, conteúdo para redes sociais em escala, retratos editoriais ou arte conceitual que precisa seguir um briefing com precisão, um único modelo fechado com uma tendência estética só não basta. A pergunta não é "qual IA faz imagens mais bonitas?". É "qual plataforma me dá a ferramenta certa para cada tarefa específica?". É aí que "Picasso AI tem todos os modelos que o Midjourney não tem" deixa de ser só um título e passa a ser uma realidade funcional, com implicações concretas no fluxo de trabalho.
O que o Midjourney realmente limita você a usar
O Midjourney é um modelo fechado. Você tem um único motor, uma tendência estética e uma única estrutura de preços. A plataforma melhorou bastante ao longo das versões, mas cada imagem carrega a mesma assinatura subjacente: aquela qualidade levemente ilustrativa e pictórica que torna uma imagem do Midjourney reconhecível de longe.
Isso é um recurso quando você quer esse visual. É uma limitação quando não quer.
Veja o que o Midjourney não oferece:
- Vários modelos base com dados de treinamento e características de saída fundamentalmente diferentes
- Arquiteturas de código aberto, como o Stable Diffusion, que tem anos de fine-tuning da comunidade por trás
- Modelos especializados em retratos, com fine-tuning específico para pele, cabelo e estrutura facial realistas
- Versões otimizadas para velocidade que produzem resultados utilizáveis em menos de cinco segundos por geração
- Controles de scheduler e de guidance que permitem ajustar o processo de difusão em nível técnico
- Fluxos completos de img2img, em que você envia uma foto de referência e a redireciona com um prompt
- Prompts negativos que excluem explicitamente elementos indesejados da saída
- Seeds reproduzíveis, com controle total da iteração a partir de um ponto de partida fixo
Quando você soma essas lacunas em um fluxo de trabalho real de produção de conteúdo, elas deixam de ser pequenos inconvenientes e passam a representar horas de gambiarras, troca de plataformas e queda na qualidade do resultado.
A linha de modelos de que ninguém fala
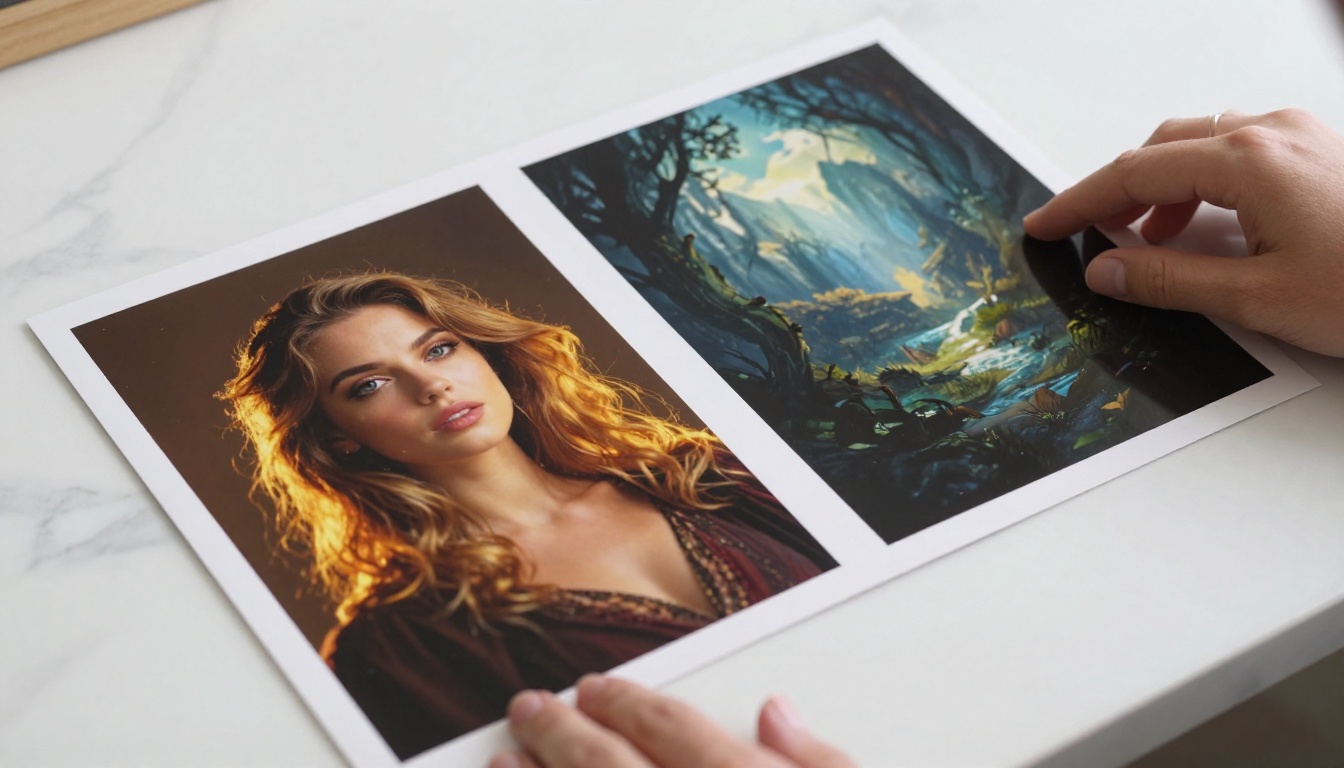
O catálogo de texto para imagem da PicassoIA tem mais de 90 modelos. Não são 90 variações de um mesmo modelo, mas arquiteturas distintas, com pontos fortes diferentes, tendências estéticas diferentes e controles técnicos diferentes. Só a família Flux cobre três casos de uso distintos. Além disso, você encontra especialistas em retratos, motores de múltiplos estilos e a arquitetura de código aberto Stable Diffusion, com total exposição técnica.
Veja onde a diferença fica concreta.
Flux Schnell: velocidade em escala
O Flux Schnell gera uma imagem completa de 1 megapixel em menos de cinco segundos, usando quatro passos de denoising. Se você roda 50 variações de prompt para encontrar a direção visual certa, esperar de 30 a 45 segundos por imagem em outra plataforma custa tempo de trabalho real ao longo de uma sessão. O Flux Schnell não faz você perder esse tempo.
O modelo aceita 11 proporções, gera em webp, jpg ou png com qualidade ajustável de 0 a 100, e roda na PicassoIA sem limites de geração. Você pode iterar por uma sessão inteira de conceitos sem ficar olhando um contador de créditos. Um parâmetro de seed permite reproduzir exatamente qualquer resultado quando você encontrar algo que vale desenvolver mais.
💡 Quando usar: Rascunhos de conceito, iteração rápida, geração de lotes para revisão de clientes e qualquer fluxo em que chegar rapidamente à direção certa importe mais do que a qualidade absoluta da saída. O Flux Schnell não é o modelo para trabalho de detalhe na saída final. Nada o supera em velocidade.
Flux Dev: precisão sem concessões
O Flux Dev é um modelo de 12 bilhões de parâmetros feito para quem precisa que o prompt realmente apareça na imagem. A maioria dos geradores de IA interpreta suas palavras de forma livre, suavizando detalhes ou ignorando partes da sua descrição. O Flux Dev é ajustado para seguir prompts com precisão real, então, quando você descreve uma cena específica, uma condição de iluminação ou um detalhe do sujeito, a imagem reflete esses detalhes de forma consistente.
Ele faz tanto geração de texto para imagem quanto edição img2img, aceita 11 proporções e permite controlar os passos de inferência entre 28 e 50 para equilibrar qualidade e velocidade de geração. Um parâmetro de guidance controla o quão rigorosamente o modelo segue o seu texto em vez de compor com mais liberdade. O parâmetro de seed permite fixar um resultado e iterar a partir dele, mudando uma variável por vez.
💡 Ideal para: Mockups de produtos, arte conceitual em que a composição precisa seguir um briefing, imagens editoriais e qualquer fluxo em que "mais ou menos" simplesmente não basta.
Flux Pro: quando o briefing precisa ser respeitado
O Flux Pro acrescenta um controle de guidance e uma configuração de intervalo sobre a base de precisão do Flux Dev. O guidance determina o quanto a saída segue de perto a sua descrição em texto. O intervalo introduz variação de composição entre as execuções, o que é útil quando você quer um leque de opções a partir do mesmo prompt, em vez de resultados parecidos a cada vez.
O modelo também aceita uma imagem como prompt junto com o texto, oferecendo um mecanismo de direcionamento baseado em referência que vai além do que só palavras conseguem fazer. Para trabalhos de marca em que o texto do briefing e uma imagem de referência visual precisam orientar a saída ao mesmo tempo, o Flux Pro processa as duas entradas de uma vez. É o modelo que se justifica nos fluxos de produção de agências.
| Recurso | Flux Schnell | Flux Dev | Flux Pro |
|---|
| Velocidade de geração | Menos de 5 segundos | 15-30 segundos | 20-40 segundos |
| Precisão do prompt | Boa | Alta | Muito alta |
| Suporte a img2img | Não | Sim | Sim |
| Entrada de imagem como prompt | Não | Não | Sim |
| Controle de guidance | Básico | Sim | Sim, mais Intervalo |
| Ideal para | Rascunhos rápidos | Trabalho de precisão | Produção baseada em briefing |
Retratos fotorrealistas bem feitos
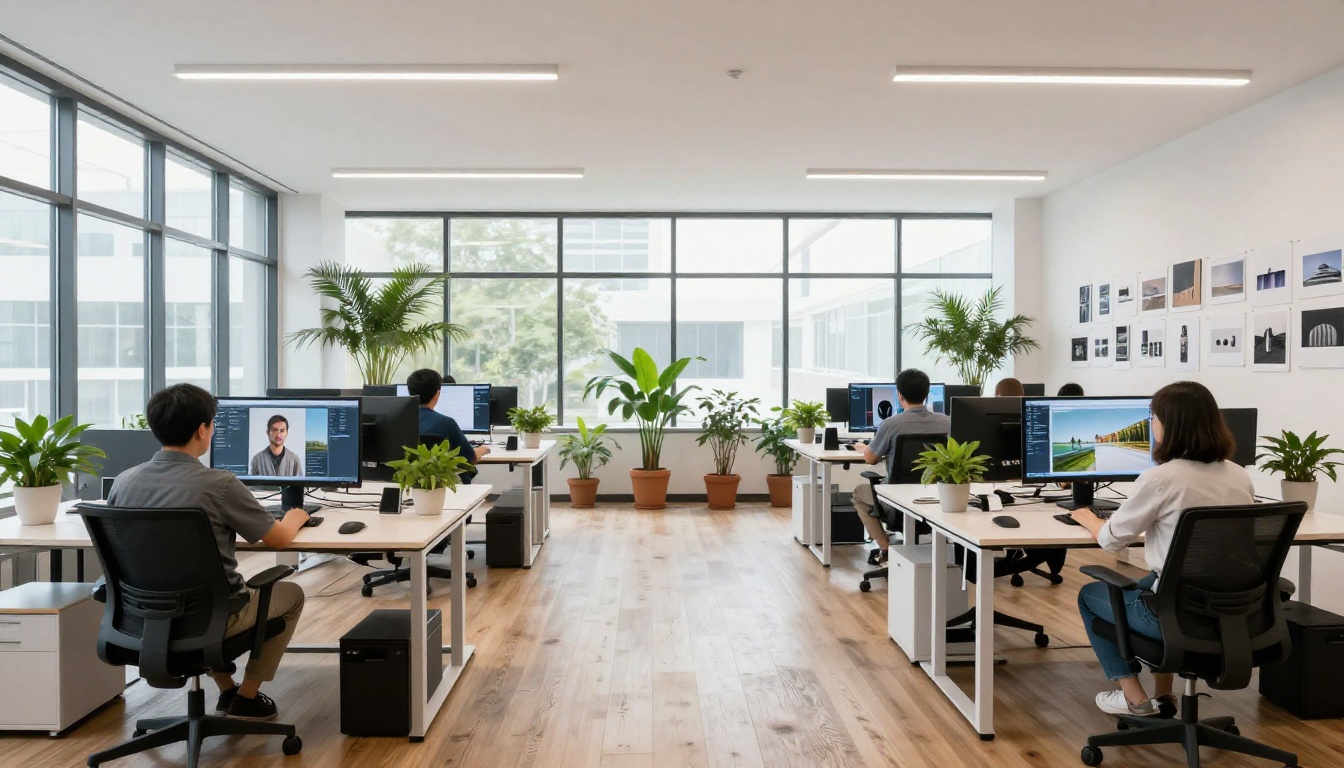
É aqui que a abordagem de modelo único do Midjourney mostra sua fraqueza prática mais significativa. Rostos humanos realistas exigem treinamento especializado. Modelos genéricos produzem pele que parece lisa demais, mãos com anatomia errada e iluminação que parece artificial, mesmo quando a composição está correta.
Realistic Vision v5.1
O Realistic Vision v5.1 foi criado especificamente para resolver esse problema. O modelo passou por fine-tuning com retratos humanos fotorrealistas, com foco deliberado em três pontos de falha recorrentes em geradores genéricos: realismo da textura da pele, precisão da estrutura facial e comportamento natural da iluminação.
O que você realmente recebe com este modelo:
- Detalhes de poros na pele que se sustentam em recortes próximos, sem parecer retocados no aerógrafo ou com aparência de plástico
- Controle por prompt negativo para excluir os artefatos mais comuns de retratos antes que apareçam
- Dois schedulers (EulerA e MultistepDPM-Solver) para diferentes características de renderização e definição de bordas
- Resolução personalizada de até 1024px em qualquer eixo
- Integração de VAE que produz saturação de cor mais rica e detalhes mais finos do que as saídas do modelo base padrão
- Faixa de guidance scale de 3,5 a 7 para equilibrar fidelidade ao prompt e variação criativa
O prompt negativo padrão do Realistic Vision já exclui os artefatos mais comuns de retratos gerados por IA: íris deformadas, pupilas deformadas, dedos extras, mãos distorcidas, proporções ruins, pescoços longos e renderização com aparência de CGI. Você amplia ou modifica esse prompt negativo de acordo com o que a sua saída específica precisa evitar.
Para fotógrafos de produtos, criadores de redes sociais ou designers que precisam de imagens consistentes com sujeitos humanos sob demanda, este modelo produz saídas que parecem ter sido feitas por um fotógrafo de retratos experiente. É uma capacidade que o motor de uso geral do Midjourney não reproduz de forma confiável.
Amplitude de estilos além de um único visual
Dreamshaper XL Turbo
O Dreamshaper XL Turbo cobre toda a gama de estilos visuais dentro de um único modelo: retratos fotorrealistas, ilustrações pictóricas, personagens de anime, painéis no estilo mangá e arte conceitual de ambientes. Ele roda na resolução nativa do SDXL (1024x1024) e produz resultados utilizáveis com apenas seis passos de denoising, normalmente em menos de dez segundos.
Sete schedulers dão a você um controle significativo sobre a estética da renderização. O DDIM produz características de borda diferentes do K_EULER. Trocar de scheduler com o mesmo prompt muda a saída de nítida e fotográfica para suave e pictórica, sem alterar uma palavra do texto. Isso importa quando você trabalha com vários formatos e estilos de conteúdo na mesma semana.
Uma equipe de redes sociais que precisa de uma foto de produto fotorrealista na segunda-feira e de uma ilustração de personagem em estilo anime na quinta não precisa trocar de plataforma, de conta ou de fluxo de trabalho. Um modelo, uma interface, a gama completa de estilos.
💡 Dica de scheduler: Comece com o K_EULER para a maior parte dos trabalhos. Mude para o DPMSolverMultistep quando quiser uma definição de bordas mais nítida. O HeunDiscrete dá resultados mais pictóricos e texturizados com o mesmo prompt.
Clássicos do Stable Diffusion
O Stable Diffusion continua sendo a base do ecossistema de geração de imagens de código aberto. Na PicassoIA, ele roda com seis schedulers, controle de resolução de 64px a 1024px em incrementos precisos, suporte a prompt negativo e uma guidance scale ajustável.
Seu valor real está no controle técnico que expõe. Seis opções de scheduler produzem resultados significativamente diferentes: DDIM, K_EULER, DPMSolverMultistep, K_EULER_ANCESTRAL, PNDM e KLMS têm características distintas. Se você entende modelos de difusão e quer as alavancas para de fato direcionar a saída em nível técnico, o Stable Diffusion oferece esse acesso. O Midjourney não expõe nada disso.
Como usar o Flux Dev na PicassoIA
Como o Flux Dev é um dos modelos mais versáteis disponíveis, veja exatamente como obter os melhores resultados:
Passo 1: Escreva um prompt específico
O Flux Dev segue prompts com alta fidelidade, então prompts vagos produzem resultados vagos. Descreva o sujeito, a direção da iluminação, o fundo, o clima e quaisquer detalhes de composição em termos claros.
Exemplo: "Foto RAW, retrato em close de uma mulher na casa dos 30 anos em um café ensolarado, luz quente da tarde vinda da esquerda, profundidade de campo rasa, textura natural da pele, fundo de parede cor creme, 85mm f/1.8"
Passo 2: Defina a proporção antes de gerar
Escolha a proporção que corresponde ao seu uso pretendido. 16:9 para banners da web, 1:1 para posts em redes sociais, 9:16 para stories verticais. Mudá-la depois custa mais uma geração.
Passo 3: Defina os passos de inferência entre 28 e 35
28 passos geram uma saída rápida e limpa para a maioria dos sujeitos. De 35 a 50 passos adicionam detalhes mais finos ao custo do tempo de geração. Para a maioria dos trabalhos comerciais, 28 é o ponto de partida certo.
Passo 4: Fixe um seed para iterar
Quando você obtiver um resultado que vale desenvolver, anote o número do seed. Ajuste uma coisa no prompt e rode de novo com o mesmo seed. Você verá exatamente o que mudou, em vez de receber uma composição completamente diferente.
Passo 5: Use img2img para trabalhos baseados em referência
Envie uma foto de referência e defina a força do prompt entre 0,6 e 0,8. Valores mais baixos preservam mais da estrutura da imagem original. Valores mais altos deixam o prompt substituir mais da composição visual. Comece com 0,7 e ajuste a partir daí.
💡 Configuração de guidance: Comece com 3,5 na primeira execução. Aumente para 5 a 7 se a saída não estiver seguindo a sua descrição do prompt com proximidade suficiente. Diminua para abaixo de 3 se quiser mais variação de composição entre as execuções.
| Recurso | Midjourney | PicassoIA |
|---|
| Total de modelos de texto para imagem | 1 | 90+ |
| Modelos de código aberto | Não | Sim (SDXL, SD, Flux) |
| Modelos especializados em retratos | Não | Sim (Realistic Vision v5.1) |
| Modelos otimizados para velocidade | Não | Sim (Flux Schnell) |
| Modelo único com múltiplos estilos | Não | Sim (Dreamshaper XL Turbo) |
| Fluxo img2img | Limitado | Completo (Flux Dev, Flux Pro) |
| Prompts negativos | Não | Sim |
| Seleção de scheduler | Não | Sim (até 7 opções) |
| Controle de guidance scale | Não | Sim |
| Controle de variação por intervalo | Não | Sim (Flux Pro) |
| Controle de seed | Parcial | Completo |
| Limites de geração | Sim | Não |
| Estilos anime e mangá | Limitado | Sim |
| Aumento de resolução com Super Resolution | Não | Sim |
| Remoção de fundo | Não | Sim |
| Texto para vídeo | Não | Sim (87 modelos) |
| Troca de rosto | Não | Sim |
| Geração de música com IA | Não | Sim |
A diferença não é marginal. É estrutural. O Midjourney construiu um produto em torno de um modelo fechado bem ajustado. A PicassoIA construiu uma plataforma em torno de dar a você o modelo certo para cada tarefa específica.
Para quem isso realmente muda as coisas
Nem todo mundo precisa de 90 modelos. Se o seu fluxo é "gerar imagens para redes sociais" e a estética do Midjourney corresponde ao que você procura, não há atrito que valha a pena resolver. Mas se qualquer uma destas situações descreve a sua, a lacuna de modelos se torna significativa:
Criadores de conteúdo que produzem em vários formatos visuais, fotorrealistas, ilustrados, em estilo anime, precisam de uma plataforma que atenda a todos em um só lugar, sem assinaturas separadas, contas separadas ou a sobrecarga de trocar de ferramenta.
Equipes de produto que criam mockups e imagens de estilo de vida precisam de precisão de prompt e suporte a img2img. Enviar uma foto de referência mais um redirecionamento em texto é um fluxo real e repetível. Ele precisa de um modelo construído para lidar com as duas entradas de forma limpa.
Fotógrafos de retratos e retocadores que querem imagens de referência assistidas por IA precisam de um modelo treinado especificamente com rostos. Um motor de uso geral que acerta rostos de vez em quando não é o mesmo que um construído em torno dessa categoria de saída.
Desenvolvedores e usuários avançados que entendem modelos de difusão querem seleção de scheduler, controles de guidance e seeds reproduzíveis. Eles precisam dos recursos técnicos que só plataformas baseadas em código aberto expõem.
Agências com produção em volume que cobrem centenas de peças em briefings, estilos e clientes diferentes precisam de geração ilimitada, sem que a precificação por imagem pressione as decisões criativas.
Escolha um modelo e comece agora
Os modelos deste artigo estão rodando na PicassoIA agora mesmo, no seu navegador, sem configuração, sem limites de crédito e sem limites de geração. Escolha o que se encaixa na tarefa real à sua frente:
- Rascunhos de conceito rápidos: Flux Schnell com menos de cinco segundos por imagem
- Produção com precisão de prompt: Flux Dev com img2img e controle total de seed
- Trabalhos de marca baseados em briefing: Flux Pro com entrada de imagem como prompt e variação por intervalo
- Retratos fotorrealistas: Realistic Vision v5.1 com detalhes de poros na pele
- Conteúdo em múltiplos estilos: Dreamshaper XL Turbo entre foto, anime e ilustração
- Controle técnico: Stable Diffusion com seis schedulers e controle total de resolução
Escreva um prompt. Escolha um modelo. Veja o que volta. A diferença entre um modelo e noventa aparece no momento em que o seu briefing fica específico o bastante para que uma estética de uso geral não dê mais conta.


