Midjourney produit de belles images. Personne ne va le contester. Mais dès que vous essayez de sortir de sa seule voie visuelle, par exemple pour générer un portrait hyperréaliste avec un grain de peau jusqu’au pore, ou pour itérer sur 50 variations de style dans une même session sans payer à chaque génération, ou pour passer du photoréaliste à la peinture puis à l’anime dans un même flux de travail, vous vous heurtez vite à un mur. La variété de modèles n’est pas là. Et c’est précisément là que la discussion doit commencer.
Il ne s’agit pas de dire que Midjourney est mauvais. Il s’agit de ce qui se passe quand votre projet exige plus qu’un seul outil ne peut offrir. Lorsque vous construisez des maquettes de photos de produits, des contenus pour les réseaux sociaux à grande échelle, des portraits éditoriaux ou du concept art qui doit répondre précisément à un brief, un modèle unique et fermé, avec une seule tendance esthétique, ne suffit pas. La question n’est pas « quelle IA fait les plus jolies images ? ». Elle est plutôt « quelle plateforme me donne le bon outil pour chaque tâche précise ? ». C’est là que « Picasso AI a tous les modèles que Midjourney n’a pas » cesse d’être un simple titre pour devenir une réalité fonctionnelle, avec de réelles implications pour votre flux de travail.
Ce à quoi Midjourney vous limite vraiment
Midjourney est un modèle fermé. Vous obtenez un seul moteur, une seule tendance esthétique et une seule structure tarifaire. La plateforme s’est nettement améliorée d’une version à l’autre, mais chaque résultat porte la même signature de fond : cette qualité légèrement illustrative et picturale qui rend une image Midjourney reconnaissable à des kilomètres.
C’est un atout lorsque c’est ce rendu que vous recherchez. C’est une contrainte lorsque ce n’est pas le cas.
Voici ce que Midjourney ne vous donne pas :
- Plusieurs modèles de base aux données d’entraînement et aux caractéristiques de sortie fondamentalement différentes
- Des architectures open source comme Stable Diffusion, qui bénéficie d’années de fine-tuning communautaire
- Des modèles spécialisés dans les portraits, affinés spécifiquement pour la peau, les cheveux et la structure du visage réalistes
- Des versions optimisées pour la vitesse qui produisent un résultat exploitable en moins de cinq secondes par génération
- Des contrôles de scheduler et de guidance qui vous permettent d’ajuster le processus de diffusion au niveau technique
- Des flux img2img complets où vous importez une photo de référence et la réorientez avec un prompt
- Des prompts négatifs qui excluent explicitement les éléments indésirables du résultat
- Des seeds reproductibles avec un contrôle total des itérations à partir d’un point de départ figé
Lorsque vous additionnez ces lacunes sur un véritable flux de travail de production de contenu, elles cessent d’être de simples désagréments mineurs et représentent des heures de solutions de contournement, de changements de plateforme et de qualité de rendu dégradée.
La gamme de modèles dont personne ne parle
Le catalogue texte vers image de PicassoIA compte plus de 90 modèles. Il ne s’agit pas de 90 variantes d’un même modèle, mais d’architectures distinctes, avec des forces différentes, des tendances esthétiques différentes et des contrôles techniques différents. La famille Flux couvre à elle seule trois cas d’usage distincts. Au-delà, vous trouvez des spécialistes des portraits, des moteurs multi-styles et l’architecture open source Stable Diffusion, avec une exposition technique complète.
Voici où l’écart devient concret.
Flux Schnell : la vitesse à grande échelle
Flux Schnell génère une image complète d’1 mégapixel en moins de cinq secondes, en quatre étapes de débruitage. Si vous lancez 50 variantes de prompt pour trouver la bonne direction visuelle, attendre 30 à 45 secondes par image sur une autre plateforme vous coûte un temps de travail réel au fil d’une session. Flux Schnell, lui, ne vous le fait pas perdre.
Le modèle prend en charge 11 formats, exporte en webp, jpg ou png avec une qualité réglable de 0 à 100, et fonctionne sur PicassoIA sans plafond de génération. Vous pouvez itérer sur une session complète de concepts sans surveiller un compteur de crédits. Un paramètre seed vous permet de reproduire exactement n’importe quel résultat lorsque vous en trouvez un qui mérite d’être développé.
💡 Quand l’utiliser : l’élaboration de concepts, l’itération rapide, la génération de lots pour la validation client et tout flux où arriver vite à la bonne direction compte davantage que la qualité absolue du résultat. Flux Schnell n’est pas le modèle pour le travail de détail sur un rendu final. Rien ne le bat en vitesse.
Flux Dev : la précision sans compromis
Flux Dev est un modèle de 12 milliards de paramètres conçu pour les utilisateurs qui ont besoin que le prompt se retrouve réellement dans l’image. La plupart des générateurs d’IA interprètent vos mots de façon approximative, adoucissent les détails ou ignorent entièrement une partie de votre description. Flux Dev est réglé pour suivre les prompts avec une vraie précision, donc lorsque vous décrivez une scène, une condition d’éclairage ou un détail précis du sujet, l’image reflète ces spécificités de manière constante.
Il gère à la fois la génération texte vers image et l’édition img2img, prend en charge 11 formats et vous permet de régler les étapes d’inférence de 28 à 50 pour équilibrer qualité et vitesse de génération. Un paramètre de guidance contrôle la rigueur avec laquelle le modèle suit votre texte, ou la liberté qu’il prend dans la composition. Le paramètre seed vous permet de figer un résultat et de partir de là en modifiant une variable à la fois.
💡 Idéal pour : les maquettes de produits, le concept art dont la composition doit correspondre à un brief, l’imagerie éditoriale et tout flux où « à peu près » ne suffit vraiment pas.
Flux Pro : quand le brief doit tenir
Flux Pro ajoute un contrôle de guidance et un réglage d’intervalle à la base de précision de Flux Dev. La guidance détermine à quel point le résultat correspond à votre description textuelle. L’intervalle introduit une variance de composition d’une génération à l’autre, ce qui est utile lorsque vous voulez un éventail d’options à partir du même prompt plutôt que des résultats similaires à chaque fois.
Le modèle accepte aussi une image de prompt en complément de votre texte, ce qui offre un mécanisme de pilotage par référence, allant au-delà de ce que les mots seuls peuvent faire. Pour un travail de marque où le brief rédactionnel et une image de référence visuelle doivent guider le résultat en même temps, Flux Pro traite les deux entrées simultanément. C’est le modèle qui trouve sa place dans les chaînes de production des agences.
| Caractéristique | Flux Schnell | Flux Dev | Flux Pro |
|---|
| Vitesse de génération | Moins de 5 secondes | 15-30 secondes | 20-40 secondes |
| Précision du prompt | Bonne | Élevée | Très élevée |
| Prise en charge de img2img | Non | Oui | Oui |
| Entrée d’image en prompt | Non | Non | Oui |
| Contrôle de la guidance | Basique | Oui | Oui plus Intervalle |
| Idéal pour | Brouillons rapides | Travail de précision | Production sur brief |
Des portraits photoréalistes réussis
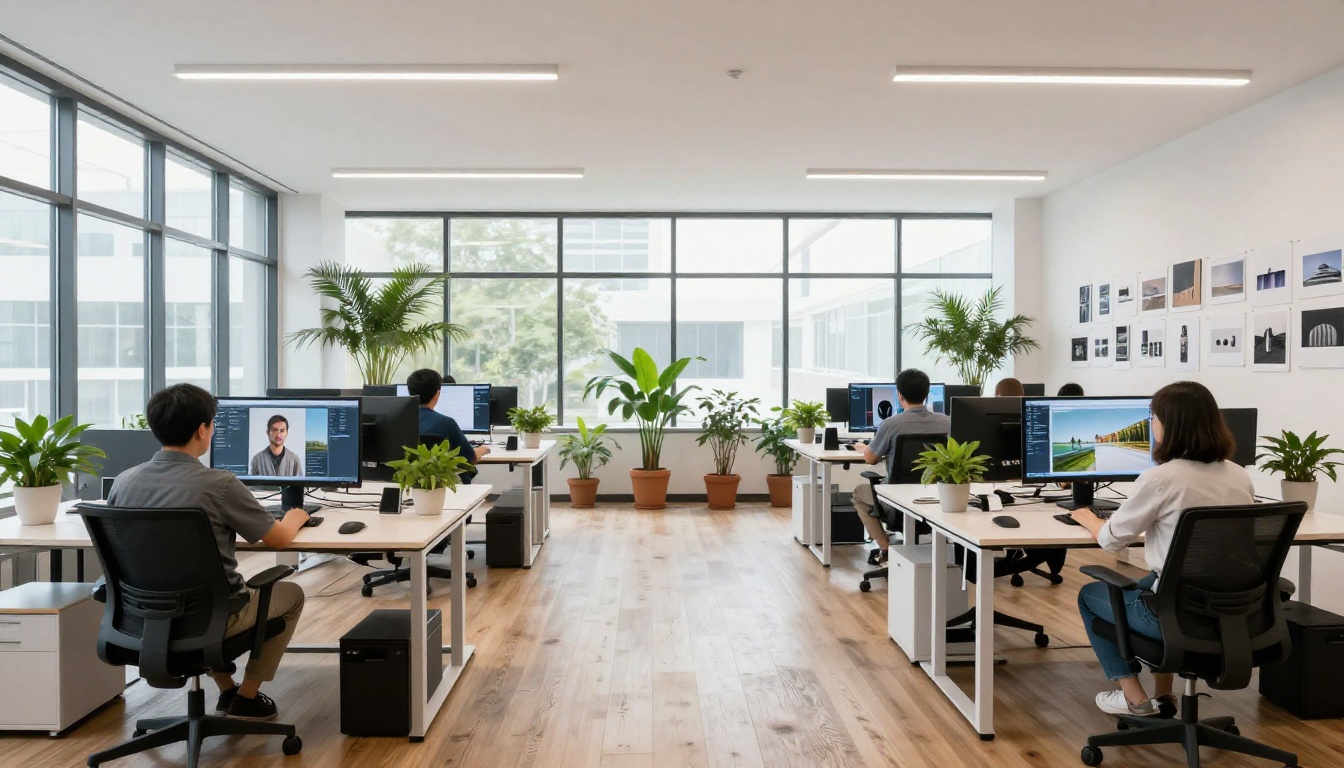
C’est ici que l’approche à modèle unique de Midjourney révèle sa faiblesse pratique la plus marquée. Les visages humains réalistes demandent un entraînement spécialisé. Les modèles génériques produisent une peau trop lisse, des mains anatomiquement incorrectes et un éclairage qui paraît artificiel, même lorsque la composition est par ailleurs juste.
Realistic Vision v5.1
Realistic Vision v5.1 a été conçu spécifiquement pour résoudre ce problème. Le modèle a été affiné sur des portraits humains photoréalistes, en se concentrant délibérément sur trois points de défaillance récurrents des générateurs génériques : le réalisme de la texture de la peau, la justesse de la structure faciale et le comportement naturel de la lumière.
Voici ce que vous obtenez concrètement avec ce modèle :
- Un détail de peau jusqu’au pore qui tient sous un recadrage serré, sans paraître retouché à l’aérographe ni plastique
- Un contrôle par prompt négatif pour exclure les artefacts les plus courants des portraits avant qu’ils n’apparaissent
- Deux schedulers (EulerA et MultistepDPM-Solver) pour différentes caractéristiques de rendu et de définition des contours
- Une résolution personnalisée allant jusqu’à 1024 px sur chaque axe
- Une intégration VAE qui produit une saturation des couleurs plus riche et des détails plus fins que les résultats du modèle de base standard
- Une plage de guidance scale de 3,5 à 7 pour équilibrer la fidélité au prompt et la variation créative
Le prompt négatif par défaut de Realistic Vision exclut déjà les artefacts les plus courants des portraits IA : iris déformés, pupilles déformées, doigts en trop, mains mutantes, mauvaises proportions, cous trop longs et rendu de style CGI. Vous complétez ou modifiez ce prompt négatif selon ce que votre résultat doit éviter.
Pour les photographes de produits, les créateurs de contenus pour les réseaux sociaux ou les designers qui ont besoin d’images de sujets humains cohérentes à la demande, ce modèle produit des résultats qui ressemblent à ceux d’un portraitiste expérimenté. C’est une capacité que le moteur généraliste de Midjourney ne reproduit pas de façon fiable.
Une gamme de styles au-delà d’une seule esthétique
Dreamshaper XL Turbo
Dreamshaper XL Turbo gère toute la gamme des styles visuels au sein d’un seul modèle : portraits photoréalistes, illustrations picturales, personnages d’anime, planches de style manga et concept art d’environnements. Il fonctionne à la résolution native de SDXL (1024x1024) et produit des résultats exploitables en six étapes de débruitage seulement, généralement en moins de dix secondes.
Sept schedulers vous donnent un contrôle réel sur l’esthétique du rendu. DDIM produit des caractéristiques de contours différentes de K_EULER. Changer de scheduler sur le même prompt fait passer le résultat du net et photographique au doux et pictural, sans modifier un seul mot du texte. Cela compte lorsque vous travaillez sur plusieurs formats de contenu et styles au cours d’une même semaine.
Une équipe de réseaux sociaux qui a besoin d’une photo de produit photoréaliste le lundi et d’une illustration de personnage de style anime le jeudi n’a pas à changer de plateforme, de compte ou de flux de travail. Un seul modèle, une seule interface, toute la gamme de styles.
💡 Astuce sur les schedulers : commencez par K_EULER pour la plupart des travaux. Passez à DPMSolverMultistep lorsque vous voulez une définition des contours plus nette. HeunDiscrete donne des résultats plus picturaux et texturés avec le même prompt.
Les classiques de Stable Diffusion
Stable Diffusion reste la base de l’écosystème open source de génération d’images. Sur PicassoIA, il fonctionne avec six schedulers, un contrôle de la résolution de 64 px à 1024 px par incréments précis, la prise en charge des prompts négatifs et une guidance scale réglable.
Sa vraie valeur réside dans le contrôle technique qu’il expose. Six options de scheduler produisent des résultats sensiblement différents : DDIM, K_EULER, DPMSolverMultistep, K_EULER_ANCESTRAL, PNDM et KLMS ont chacun des caractéristiques distinctes. Si vous maîtrisez les modèles de diffusion et voulez disposer de leviers capables de réellement orienter le résultat au niveau technique, Stable Diffusion vous offre cette surface de contrôle. Midjourney n’en expose aucune.
Comme Flux Dev est l’un des modèles les plus polyvalents disponibles, voici comment obtenir les meilleurs résultats :
Étape 1 : rédigez un prompt précis
Flux Dev suit les prompts avec une grande fidélité, donc des prompts vagues donnent des résultats vagues. Décrivez le sujet, la direction de la lumière, l’arrière-plan, l’ambiance et tout détail de composition en termes clairs.
Exemple : « RAW photo, portrait en gros plan d’une femme d’une trentaine d’années dans un café ensoleillé, lumière chaude de l’après-midi venant de la gauche, faible profondeur de champ, texture de peau naturelle, arrière-plan d’un mur couleur crème, 85mm f/1.8 »
Étape 2 : réglez votre format avant de générer
Choisissez le ratio qui correspond à votre usage. 16:9 pour les bannières web, 1:1 pour les publications sur les réseaux sociaux, 9:16 pour les stories verticales. Le changer après vous coûte une génération supplémentaire.
Étape 3 : réglez les étapes d’inférence entre 28 et 35
28 étapes donnent un résultat rapide et net pour la plupart des sujets. De 35 à 50, on gagne en détails fins au prix d’un temps de génération plus long. Pour la plupart des travaux commerciaux, 28 est le bon point de départ.
Étape 4 : figez un seed pour itérer
Lorsque vous obtenez un résultat qui mérite d’être développé, notez le numéro du seed. Modifiez une seule chose dans votre prompt et relancez avec le même seed. Vous verrez exactement ce qui a changé, au lieu d’obtenir une composition complètement différente.
Étape 5 : utilisez img2img pour un travail à partir de référence
Importez une photo de référence et réglez la force du prompt entre 0,6 et 0,8. Des valeurs plus basses préservent davantage la structure de l’image d’origine. Des valeurs plus élevées laissent le prompt remplacer davantage la composition visuelle. Commencez à 0,7 et ajustez à partir de là.
💡 Réglage de la guidance : commencez à 3,5 pour le premier essai. Montez à 5 ou 7 si le résultat ne suit pas assez fidèlement votre description. Descendez en dessous de 3 si vous voulez plus de variation de composition d’un essai à l’autre.
Ce que vous obtenez réellement face à Midjourney
| Capacité | Midjourney | PicassoIA |
|---|
| Total des modèles texte vers image | 1 | Plus de 90 |
| Modèles open source | Non | Oui (SDXL, SD, Flux) |
| Modèles spécialisés dans les portraits | Non | Oui (Realistic Vision v5.1) |
| Modèles optimisés pour la vitesse | Non | Oui (Flux Schnell) |
| Modèle unique multi-styles | Non | Oui (Dreamshaper XL Turbo) |
| Flux de travail img2img | Limité | Complet (Flux Dev, Flux Pro) |
| Prompts négatifs | Non | Oui |
| Choix du scheduler | Non | Oui (jusqu’à 7 options) |
| Contrôle de la guidance scale | Non | Oui |
| Contrôle de la variance d’intervalle | Non | Oui (Flux Pro) |
| Contrôle du seed | Partiel | Complet |
| Plafonds de génération | Oui | Non |
| Styles anime et manga | Limité | Oui |
| Upscaling Super Resolution | Non | Oui |
| Suppression d’arrière-plan | Non | Oui |
| Texte vers vidéo | Non | Oui (87 modèles) |
| Échange de visage | Non | Oui |
| Génération de musique IA | Non | Oui |
L’écart n’est pas marginal. Il est structurel. Midjourney a bâti un produit autour d’un seul modèle fermé et bien réglé. PicassoIA a bâti une plateforme autour de l’idée de vous donner le bon modèle pour chaque tâche précise.
Pour qui cela change vraiment les choses
Tout le monde n’a pas besoin de 90 modèles. Si votre flux consiste à « générer des images pour les réseaux sociaux » et que l’esthétique de Midjourney correspond à ce que vous recherchez, il n’y a aucune friction qui vaille la peine d’être résolue. Mais si l’une de ces situations vous correspond, l’écart de modèles devient important :
Les créateurs de contenus qui produisent sur plusieurs formats visuels, photoréalistes, illustrés, de style anime, ont besoin d’une plateforme qui les gère tous au même endroit, sans abonnements, comptes ou changements d’outils séparés.
Les équipes produit qui créent des maquettes et des visuels de style de vie ont besoin d’une grande précision de prompt et d’une prise en charge de img2img. Fournir une photo de référence accompagnée d’une réorientation textuelle est un flux réel et reproductible. Il faut un modèle conçu pour traiter proprement les deux entrées.
Les photographes de portrait et les retoucheurs qui veulent des images de référence assistées par IA ont besoin d’un modèle entraîné spécifiquement sur les visages. Un moteur généraliste qui réussit parfois les visages n’équivaut pas à un outil construit autour de cette catégorie de résultats.
Les développeurs et utilisateurs avancés qui comprennent les modèles de diffusion veulent le choix du scheduler, les contrôles de guidance et des seeds reproductibles. Ils ont besoin d’une surface technique que seules les plateformes basées sur l’open source exposent.
Les agences qui produisent en volume, couvrant des centaines de visuels pour différents briefs, styles et clients, ont besoin d’une génération illimitée, sans que la tarification à l’image ne pèse sur les décisions créatives.
Choisissez un modèle et commencez dès maintenant
Les modèles présentés dans cet article fonctionnent sur PicassoIA dès maintenant, dans votre navigateur, sans installation, sans plafond de crédits et sans limite de génération. Choisissez celui qui correspond à la tâche qui vous attend :
- Brouillons de concepts rapides : Flux Schnell en moins de cinq secondes par image
- Production précise sur prompt : Flux Dev avec img2img et contrôle complet du seed
- Travail de marque sur brief : Flux Pro avec entrée d’image en prompt et variance d’intervalle
- Portraits photoréalistes : Realistic Vision v5.1 avec un détail de peau jusqu’au pore
- Contenus multi-styles : Dreamshaper XL Turbo pour la photo, l’anime et l’illustration
- Contrôle technique : Stable Diffusion avec six schedulers et un contrôle complet de la résolution
Rédigez un prompt. Choisissez un modèle. Voyez ce qui en ressort. La différence entre un modèle et quatre-vingt-dix apparaît dès que votre brief devient assez précis pour qu’une esthétique généraliste ne suffise plus.


