Consejos para escribir buenos prompts a agentes de programación: qué funciona de verdad en 2027
No sacas el máximo partido a tu agente de programación porque tus prompts no son lo bastante específicos. Este artículo explica paso a paso cómo estructurar los prompts, elegir el contexto adecuado y escribir instrucciones que produzcan código que funcione a la primera.
Has visto las demos. La IA escribe código perfecto en segundos, el desarrollador se recuesta en la silla y listo. La realidad a la que se enfrentan la mayoría de los desarrolladores es otra: resultados vagos, importaciones erróneas, lógica que casi funciona y respuestas que no dan en el clavo. La distancia entre esas demos pulidas y el uso diario depende casi por completo de cómo escribes los prompts. Mejores entradas producen resultados muy superiores, y las reglas no son evidentes.
Por qué fallan la mayoría de los prompts de programación
El error más común es pensar que un agente de programación es "lo bastante listo como para resolverlo solo". No lo es. Un agente de programación es un motor de predicción, y predice a partir de lo que tú le das. Si entra basura, sale basura, y sigue siendo una verdad aplastante, incluso con los modelos más avanzados.
Instrucciones vagas = código vago
Pide a un agente que "escriba una función para procesar datos de usuario" y escribirá algo. Incluso puede tener buena pinta. Pero procesará los datos equivocados, en el formato equivocado, sin gestión de errores y con nombres de variables que no significan nada en tu base de código. El agente no ha fallado. Has fallado tú, al dar una especificación incompleta.
El agente no puede leerte la mente. No puede ver tu base de código a menos que se la muestres. No sabe qué significa "procesar" para tu aplicación. Cada suposición que hace es una conjetura.
Lo que los agentes realmente "entienden"
Cuando envías un prompt, el modelo solo ve tokens. No ve tono, intención ni conocimiento del dominio que das por supuesto. La diferencia entre estos dos prompts es enorme:
Malo: "Escribe una función de inicio de sesión"
Bueno: "Escribe una función de Python llamada authenticate_user(email: str, password: str) -> dict que compare las credenciales con una base de datos PostgreSQL usando bcrypt para la comparación de contraseñas. Devuelve {success: True, user_id: int} si tiene éxito o {success: False, error: str} si falla. Usa el auxiliar db_connection() que ya existe en src/database.py."
El segundo prompt elimina decenas de suposiciones. Se especifican el lenguaje, la firma de la función, los tipos de datos, el tipo de base de datos, la biblioteca de hash, el formato de respuesta y la estructura del proyecto. El resultado será utilizable sin reescribirlo.
Los 5 patrones de prompt que generan código útil
No son teoría. Son patrones que usan los desarrolladores que obtienen con regularidad código funcional de los agentes de IA en el primer o segundo intento.
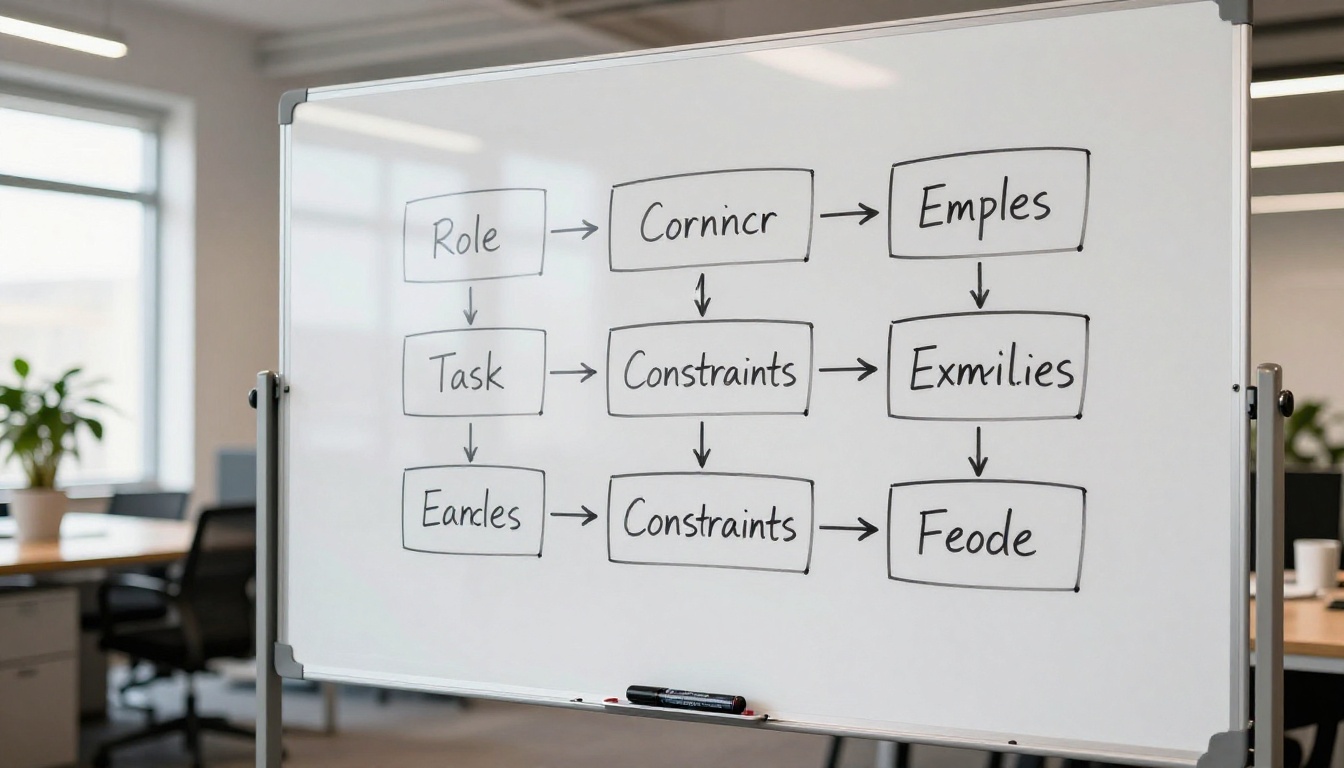
Formato rol + tarea + restricción
Estructura cada prompt no trivial en tres componentes:
Rol: indica al agente qué tipo de experto está haciendo de
Tarea: describe con precisión qué hay que construir
Restricciones: enumera lo que no debe hacer, qué bibliotecas usar y cuál es el formato de salida
💡 Ejemplo: "Eres un ingeniero senior de backend en Python. Escribe un middleware de limitación de tasa para una aplicación FastAPI. Usa Redis para el almacenamiento. No uses ninguna biblioteca de terceros para limitar la tasa. Devuelve el middleware como una clase que se pueda registrar con app.add_middleware()."
Solo con esta estructura de tres partes, la calidad del resultado mejorará de forma medible.
Da ejemplos, no solo instrucciones
El prompting con ejemplos (few-shot) es uno de los enfoques menos aprovechados en los flujos de trabajo de programación reales. En lugar de describir lo que quieres, muéstralo.
Si quieres una función que siga un patrón concreto de tu base de código, pega primero una función similar que ya exista como ejemplo. Di "sigue exactamente este patrón" y luego describe la nueva. El agente reproducirá las convenciones de nombres, el estilo de gestión de errores, los patrones de registro y el formato de los docstrings sin que tengas que enumerar todos esos requisitos de forma explícita.
Sin ejemplo: "Escribe una función auxiliar para extraer fechas de cadenas de texto"
Con ejemplo:
Here is an existing helper in our codebase:

def parse_currency(value: str) -> Decimal:
    """Parses a currency string like '$1,234.56' into Decimal."""
    try:
        cleaned = value.replace('$', '').replace(',', '')
        return Decimal(cleaned)
    except InvalidOperation:
        raise ValueError(f"Cannot parse currency: {value!r}")

Write a similar helper called parse_date(value: str) -> date that handles formats:
'YYYY-MM-DD', 'MM/DD/YYYY', and 'DD-Mon-YYYY'.
La segunda versión producirá una función que encaja con tu base de código a la primera.
Acota el alcance, no lo amplíes
Uno de los hábitos más perjudiciales en el desarrollo asistido por IA es pedir demasiado de una vez. "Constrúyeme un sistema de autenticación completo" producirá un resultado hinchado y genérico que afectará a tu arquitectura de maneras que no esperas.
Divide las tareas grandes en unidades atómicas:
Prompt malo
Prompt mejor
"Construye un sistema de pagos"
"Escribe la función create_payment_intent"
"Refactoriza todo el módulo de usuarios"
"Refactoriza get_user_by_email para usar async/await"
"Añade logging a la aplicación"
"Añade logging estructurado a order_service.py"
"Escribe tests para la API"
"Escribe tests unitarios con pytest para POST /api/orders"
Alcance pequeño, resultado específico. Siempre puedes encadenar prompts.
El contexto lo es todo
El contexto es la palanca más poderosa que tienes. Más contexto relevante casi siempre mejora el resultado. El reto está en saber qué incluir y qué dejar fuera.
Qué incluir en cada prompt
Como mínimo, cada prompt no trivial debería incluir:
El lenguaje y su versión: Python 3.11, TypeScript 5.2, Go 1.22
El código existente relevante: pega la función, la clase o el archivo que vas a modificar
El mensaje de error (si estás depurando): la traza completa, no un resumen
El comportamiento esperado: qué debería hacer frente a lo que hace
Las bibliotecas que ya usas: lo que está disponible para que no invente otras nuevas
Si falta incluso uno de estos elementos, el resultado necesitará correcciones importantes.
Cuánto contexto es demasiado
Existen límites de tokens, y meter todos los archivos de tu proyecto en un prompt es contraproducente. El agente empieza a perder el foco en la tarea real cuando recibe demasiado material que no viene al caso.
Una regla práctica: incluye solo lo que está directamente relacionado con el cambio. Si modificas una función, pega la función y sus dependencias inmediatas. Si depuras una ruta, pega el manejador de esa ruta y el modelo que usa. Deja fuera los módulos no relacionados.
💡 Consejo avanzado: usa comentarios para resumir lo que hace el código omitido. // The UserService class handles DB reads. It has find_by_id(id) and update(id, data) methods. Así el agente recibe la superficie de la API sin gastar tokens en la implementación completa.
Depurar con agentes de IA
Los agentes de IA son compañeros de depuración excepcionales cuando reciben la información correcta. El error típico es pedirle a un agente que arregle algo sin darle el cuadro completo.
La regla de "reproducir primero"
Antes de pedirle a un agente que arregle un error, incluye el caso de reproducción mínimo. No toda la base de código, ni una descripción del error. El código que falla, la entrada que lo dispara y la salida exacta del error.
Prompt débil: "Mi API a veces devuelve un error 500, ¿puedes arreglarlo?"
Prompt sólido:
This function throws a KeyError intermittently:

def process_webhook(payload: dict) -> None:
    user_id = payload['user']['id']   # crashes when 'user' is absent
    update_subscription(user_id)

Error: KeyError: 'user'
Input that triggered it: {"event": "payment.failed", "amount": 49.99}

Fix the function to handle missing 'user' gracefully. If 'user' is absent, log a warning and return early.
El segundo prompt le da al agente todo lo que necesita. La corrección será acertada y seguirá tu intención.
Cuándo pedir una explicación o una corrección
No toda interacción debería terminar con "arréglalo". A veces necesitas leer lo que hace un fragmento de código antes de cambiarlo.
Pide una explicación cuando:
Heredas código que no escribiste
Trabajas con una biblioteca o framework que no conoces
Quieres entender por qué funcionó una corrección
Pide una corrección cuando:
El comportamiento esperado ya está claro
Tienes un caso de reproducción
El alcance es lo bastante pequeño como para verificarlo rápido
Mezclar ambas cosas en un mismo prompt suele producir un muro de texto que lo explica todo y no cambia nada. Mantenlas separadas.
Elegir el modelo adecuado para programar
No todos los modelos de lenguaje rinden igual en tareas de programación. Las diferencias son importantes, y usar el modelo equivocado para una tarea añade fricción a tu flujo de trabajo.
Velocidad frente a precisión: la contrapartida
Los modelos más pequeños y rápidos son excelentes para:
Sugerencias de autocompletado
Funciones de utilidad sencillas
Conversiones de formato rápidas
Generación de código repetitivo (boilerplate)
Los modelos más grandes y capaces merecen la latencia extra para:
Decisiones de arquitectura
Problemas algorítmicos complejos
Depurar condiciones de carrera sutiles
Refactorizaciones con restricciones estrictas
El objetivo es ajustar la capacidad del modelo a la complejidad de la tarea. Usar un modelo de razonamiento de vanguardia para cambiar el nombre de una variable es un desperdicio. Usar un modelo pequeño y rápido para diseñar una estrategia de caché distribuida es un error.
Modelos pensados para tareas de programación
Varios modelos disponibles en PicassoIA destacan especialmente en generación de código y razonamiento. Claude 4 Sonnet está diseñado para programar con precisión y seguir instrucciones al pie de la letra, lo que lo convierte en una de las mejores opciones para flujos de trabajo de programación con agentes. Claude 4.5 Sonnet amplía esto con mejores capacidades de depuración en varios lenguajes.
Para quienes quieren un razonamiento sólido junto con la generación de código, DeepSeek R1 descompone bien los problemas paso a paso antes de producir el resultado. Kimi K2 Instruct es otra opción sólida, muy valorada para razonamiento y tareas de programación.
Si necesitas modelos especializados en código, entrenados específicamente con conjuntos de datos de programación, Granite 8B Code Instruct 128K y Granite 20B Code Instruct 8K, de IBM, merecen una prueba. Ambos están ajustados para completar código y seguir instrucciones en un contexto de programación.
Para tareas generales que combinan redacción, análisis y generación de código, GPT 5.1 y Kimi K2.6 ofrecen capacidades flexibles para crear agentes. Kimi K2.6 en particular está diseñado para tareas de agentes de IA de varios pasos en las que el razonamiento y la salida de código deben funcionar juntos.
Ejemplos reales que generan código limpio
Los consejos abstractos son difíciles de aplicar. Estos son ejemplos concretos de antes y después que muestran cómo la calidad del prompt afecta directamente a la calidad del código.
Refactorizar una función
Antes: "Refactoriza esta función para que quede más limpia"
Después:
Refactor the following Python function. Requirements:
1. Extract the database query into a separate helper called _fetch_user_records
2. Replace the nested if/else with early returns
3. Add type annotations to all parameters and return value
4. Do not change the external behavior or function signature

Current code:
[paste function here]
El resultado del segundo prompt no requiere ninguna reescritura. Sigue tus requisitos exactamente porque tú los has indicado.
Escribir tests desde cero
Los tests son el ámbito donde los agentes de programación con IA aportan un valor enorme cuando se les pide bien. El enfoque consiste en especificar qué comportamientos probar, no solo qué archivo probar.
Débil: "Escribe tests para el servicio de usuarios"
Sólido:
Write pytest tests for UserService.create_user in src/services/user_service.py.

Test these specific cases:
1. Successful creation returns a user dict with 'id', 'email', and 'created_at' keys
2. Duplicate email raises DuplicateUserError
3. Invalid email format raises ValidationError
4. Missing required fields raises MissingFieldError

Mock the database with unittest.mock.patch. Do not write integration tests.
El segundo prompt produce cuatro casos de prueba centrados y significativos que cubren los fallos reales de la función, sin que tengas que retocar nada después.
Iterar sin empezar de nuevo
Una habilidad poco valorada es el prompting iterativo: refinar el resultado sin abandonar el contexto de la conversación. En lugar de regenerarlo desde cero cuando el resultado está casi bien, pide la corrección directamente:
"La función es correcta, pero cambia el manejo de errores para usar excepciones personalizadas de src/exceptions.py en lugar de las integradas"
"Mantén todo igual, pero renombra todas las variables siguiendo snake_case"
"Añade docstrings en formato Google a cada función que hayas escrito"
Las correcciones iterativas conservan lo que funcionó y cambian solo lo que no. Esto es muchísimo más rápido que empezar una sesión nueva cada vez que el resultado se salta un detalle.
Cómo usan los equipos los agentes de programación de forma eficaz
Usarlos en solitario es una cosa. Cuando un equipo comparte flujos de trabajo de programación con IA, unas cuantas prácticas separan a los equipos muy productivos de los caóticos.
Plantillas de prompts compartidas
Los mejores equipos crean plantillas de prompts reutilizables para las tareas repetidas. Una plantilla para "añadir un nuevo endpoint de API" podría incluir huecos para la ruta, el método HTTP, el esquema de la petición, el esquema de la respuesta y los requisitos de autenticación. Los nuevos miembros del equipo rellenan los huecos y obtienen cada vez un resultado constante y ajustado al patrón.
Esto elimina la variación que aparece cuando cinco desarrolladores piden "lo mismo" de cinco formas totalmente distintas y reciben cinco implementaciones con estructuras diferentes.
Revisar antes de fusionar
El código generado por IA debe revisarse con el mismo rigor que el escrito por personas. El agente no conoce tus requisitos de seguridad, la sensibilidad de tus datos ni los casos límite de tu negocio. Escribe código que parece correcto. Tu trabajo es comprobar que de verdad lo es.
💡 Hábito crítico: nunca fusiones código generado por IA sin ejecutarlo antes con tu suite de tests real. El agente optimiza para producir código que se lee bien, no código que maneje los casos límite específicos de tu producción.
Bibliotecas de prompts como activo del equipo
Documenta los prompts que producen buenos resultados con regularidad. Compártelos en la wiki o el repositorio de tu equipo. Un prompt que genera de forma fiable migraciones de base de datos correctas para tu stack vale más que cualquier fragmento de código individual que produzca. El prompt es el activo reutilizable. El código es el resultado.
Prueba estos patrones en PicassoIA
Cada consejo de este artículo se puede aplicar de inmediato. No necesitas herramientas nuevas ni cambiar de editor. Necesitas escribir mejores prompts, y los mejores prompts empiezan por la especificidad, la estructura y el contexto.
PicassoIA te da acceso directo a los modelos que se comentan aquí, uno al lado del otro, sin cambiar de plataforma. Tanto si quieres el razonamiento profundo de Claude 4 Sonnet, el entrenamiento específico en código de Granite 8B Code Instruct 128K o las capacidades para crear agentes de Kimi K2.6, puedes ejecutar exactamente el mismo prompt en varios modelos y comparar la calidad del resultado en segundos.
Empieza con una función en la que estés trabajando ahora mismo. Aplica el formato rol + tarea + restricción. Incluye como contexto el código existente relevante. Especifica el formato de salida que esperas. Después compara ese resultado con lo que habría producido tu prompt vago anterior. La diferencia será evidente, y el hábito se quedará contigo.
Tu agente de programación es tan eficaz como las instrucciones que le das. Dale mejores instrucciones y entrega mejor software.