Conseils pour bien prompter les agents de code en 2027 : ce qui fonctionne vraiment
Vous ne tirez pas le meilleur de votre agent de code parce que vos prompts ne sont pas assez précis. Cet article détaille comment structurer les prompts, choisir le bon contexte et rédiger des consignes qui produisent du code fonctionnel dès la première tentative.
Vous avez vu les démonstrations. L’IA écrit un code parfait en quelques secondes, le développeur se détend, et c’est terminé. La réalité à laquelle se heurtent la plupart des développeurs est tout autre : résultats vagues, mauvais imports, logique presque juste, réponses qui passent complètement à côté du sujet. L’écart entre ces démonstrations soignées et l’usage quotidien tient presque entièrement à la façon dont vous formulez vos prompts. De meilleures entrées produisent des sorties nettement meilleures, et les règles ne sont pas évidentes.
Pourquoi la plupart des prompts de code échouent
L’idée reçue la plus répandue est qu’un agent de code est « assez intelligent pour se débrouiller ». Ce n’est pas le cas. Un agent de code est un moteur de prédiction, et il prédit à partir de ce que vous lui donnez. Garbage in, garbage out reste brutalement vrai, même avec les modèles de pointe.
Des consignes vagues donnent du code vague
Demandez à un agent d’« écrire une fonction pour traiter les données utilisateur » et il écrira quelque chose. Cela pourra même paraître raisonnable. Mais il traitera les mauvaises données, dans le mauvais format, sans gestion des erreurs, avec des noms de variables qui ne veulent rien dire pour votre base de code. L’agent n’a pas échoué. C’est vous qui avez échoué, en fournissant une spécification incomplète.
L’agent ne peut pas lire dans vos pensées. Il ne peut pas voir votre base de code si vous ne la lui montrez pas. Il ne sait pas ce que « traiter » signifie pour votre application. Chaque hypothèse qu’il fait est une supposition.
Ce que les agents « entendent » vraiment
Lorsque vous envoyez un prompt, le modèle ne voit que des tokens. Ni ton, ni intention, ni connaissances du domaine supposées. L’écart entre ces deux prompts est énorme :
Mauvais : « Écrivez une fonction de connexion »
Bon : « Écrivez une fonction Python appelée authenticate_user(email: str, password: str) -> dict qui vérifie les identifiants dans une base PostgreSQL en utilisant bcrypt pour comparer les mots de passe. Renvoyez {success: True, user_id: int} en cas de succès ou {success: False, error: str} en cas d’échec. Utilisez l’helper db_connection() existant provenant de src/database.py. »
Le second prompt élimine des dizaines de suppositions. Le langage, la signature de la fonction, les types de données, le type de base de données, la bibliothèque de hachage, le format de retour et la structure du projet sont tous précisés. Le résultat sera utilisable sans réécriture.
Les 5 schémas de prompts qui livrent du code
Ce ne sont pas des théories. Ce sont des schémas utilisés par des développeurs qui obtiennent régulièrement du code fonctionnel dès la première ou la deuxième tentative.
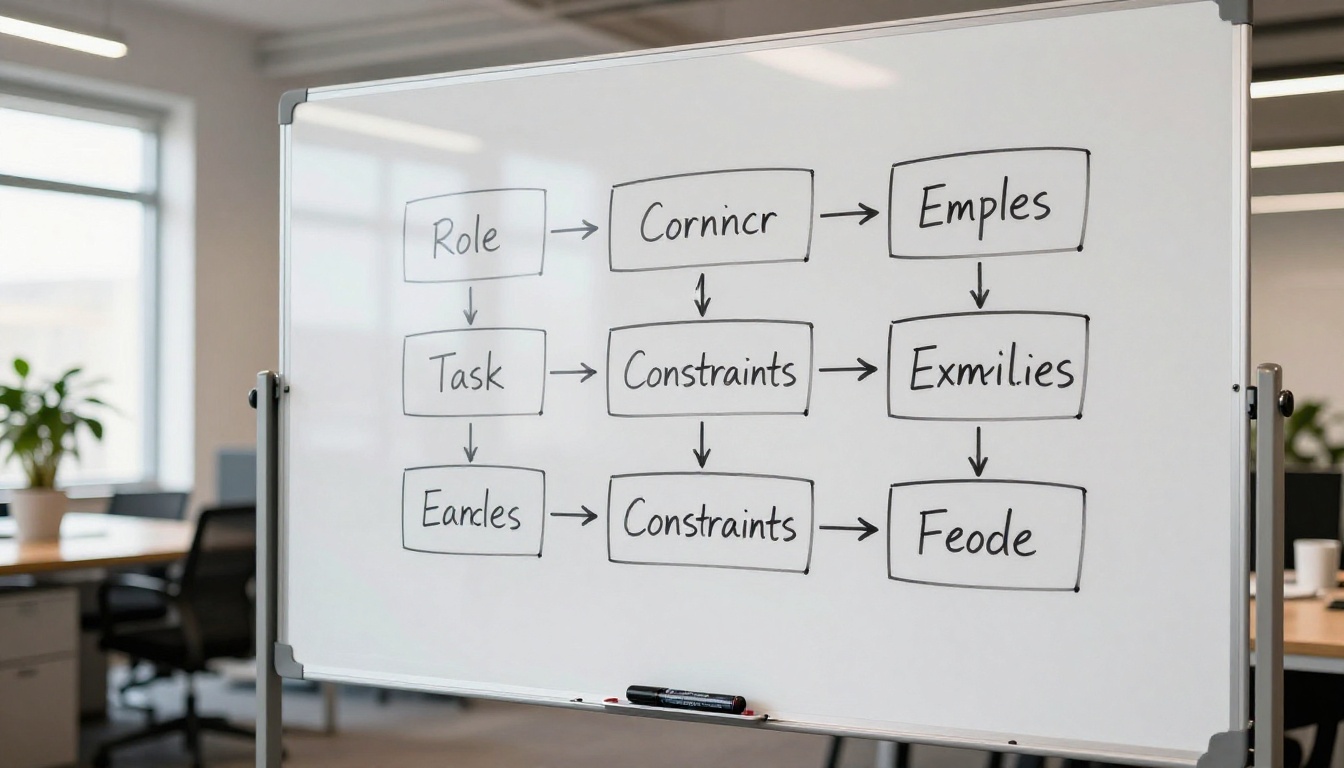
Format Rôle + Tâche + Contrainte
Structurez chaque prompt non trivial autour de trois composantes :
Rôle : indiquez à l’agent le type d’expert qu’il doit incarner
Tâche : décrivez précisément ce qui doit être construit
Contraintes : listez ce qu’il ne doit pas faire, les bibliothèques à utiliser et le format de sortie
💡 Exemple : « Vous êtes un ingénieur backend Python senior. Écrivez un middleware de limitation de débit pour une application FastAPI. Utilisez Redis pour le stockage. N’utilisez aucune bibliothèque tierce de limitation de débit. Renvoyez le middleware sous la forme d’une classe pouvant être enregistrée avec app.add_middleware(). »
Cette structure en trois parties suffit à améliorer de façon mesurable la qualité des sorties.
Donnez des exemples, pas seulement des consignes
Le prompting par exemples (few-shot) est l’une des approches les moins utilisées dans les flux de travail de code au quotidien. Au lieu de décrire ce que vous voulez, montrez-le.
Si vous voulez une fonction qui suit un schéma précis de votre base de code, collez d’abord une fonction similaire existante comme exemple. Dites « suivez exactement ce schéma », puis décrivez la nouvelle. L’agent reprendra les conventions de nommage, le style de gestion des erreurs, les schémas de journalisation et le format des docstrings, sans que vous ayez à lister toutes ces exigences explicitement.
Sans exemple : « Écrivez une fonction utilitaire pour analyser des dates à partir de chaînes de caractères »
Avec exemple :
Here is an existing helper in our codebase:

def parse_currency(value: str) -> Decimal:
    """Parses a currency string like '$1,234.56' into Decimal."""
    try:
        cleaned = value.replace('$', '').replace(',', '')
        return Decimal(cleaned)
    except InvalidOperation:
        raise ValueError(f"Cannot parse currency: {value!r}")

Write a similar helper called parse_date(value: str) -> date that handles formats:
'YYYY-MM-DD', 'MM/DD/YYYY', and 'DD-Mon-YYYY'.
La seconde version produira du premier coup une fonction qui s’intègre à votre base de code.
Délimitez un périmètre étroit, pas large
L’une des habitudes les plus néfastes dans le développement assisté par IA consiste à demander trop d’un coup. « Créez-moi un système d’authentification complet » produira une sortie gonflée et générique, qui touche votre architecture de façons auxquelles vous ne vous attendez pas.
Découpez les grandes tâches en unités atomiques :
Mauvais prompt
Meilleur prompt
« Construisez un système de paiement »
« Écrivez la fonction create_payment_intent »
« Refactorisez tout le module utilisateur »
« Refactorisez get_user_by_email pour utiliser async/await »
« Ajoutez des logs à l’application »
« Ajoutez une journalisation structurée à order_service.py »
« Écrivez des tests pour l’API »
« Écrivez des tests unitaires pytest pour POST /api/orders »
Périmètre réduit, sortie précise. Vous pouvez toujours enchaîner les prompts.
Le contexte est tout
Le contexte est le levier le plus puissant dont vous disposez. Plus le contexte pertinent est riche, plus la sortie s’améliore presque toujours. Le défi consiste à savoir quoi inclure et quoi laisser de côté.
Ce qu’il faut inclure dans chaque prompt
Au minimum, chaque prompt non trivial devrait inclure :
Le langage et sa version : Python 3.11, TypeScript 5.2, Go 1.22
Le code existant pertinent : collez la fonction, la classe ou le fichier modifié
Le message d’erreur (en cas de débogage) : la trace complète, pas un résumé
Le comportement attendu : ce qui devrait se passer et ce qui se passe réellement
Les bibliothèques déjà utilisées : ce qui est disponible, pour qu’il n’en invente pas de nouvelles
L’omission d’un seul de ces éléments suffit à produire une sortie qui nécessite des corrections importantes.
Quand le contexte devient trop
Les limites de tokens existent, et coller chaque fichier de votre projet dans un prompt est contre-productif. L’agent commence à perdre de vue la tâche réelle lorsqu’on lui fournit trop de matière sans rapport.
Règle pratique : n’incluez que ce qui est directement adjacent à la modification. Si vous modifiez une fonction, collez la fonction et ses dépendances immédiates. Si vous déboguez une route, collez le gestionnaire de la route et le modèle qu’il utilise. Laissez de côté les modules sans rapport.
💡 Astuce : utilisez des commentaires pour résumer ce que fait le code omis. // The UserService class handles DB reads. It has find_by_id(id) and update(id, data) methods. Cela donne à l’agent la surface de l’API sans consommer de tokens pour l’implémentation complète.
Déboguer avec des agents IA
Les agents IA sont d’excellents partenaires de débogage lorsqu’on leur fournit les bonnes informations. L’erreur typique consiste à demander à un agent de corriger quelque chose sans lui donner la vue d’ensemble.
La règle « reproduire d’abord »
Avant de demander à un agent de corriger un bug, incluez le cas de reproduction minimal. Pas la base de code entière, pas une simple description du bug. Le code qui échoue réellement, l’entrée qui le déclenche et le message d’erreur exact.
Prompt faible : « Mon API renvoie parfois une erreur 500, pouvez-vous la corriger ? »
Prompt solide :
This function throws a KeyError intermittently:

def process_webhook(payload: dict) -> None:
    user_id = payload['user']['id']   # crashes when 'user' is absent
    update_subscription(user_id)

Error: KeyError: 'user'
Input that triggered it: {"event": "payment.failed", "amount": 49.99}

Fix the function to handle missing 'user' gracefully. If 'user' is absent, log a warning and return early.
Le second prompt donne à l’agent tout ce dont il a besoin. La correction sera juste et respectera votre intention.
Quand demander une explication plutôt qu’un correctif
Toute interaction ne doit pas se terminer par « corrigez ça ». Parfois, il faut comprendre ce que fait un morceau de code avant de le modifier.
Demandez une explication lorsque :
vous héritez de code que vous n’avez pas écrit
vous travaillez avec une bibliothèque ou un framework que vous ne connaissez pas
vous cherchez à comprendre pourquoi une correction a fonctionné
Demandez un correctif lorsque :
le comportement attendu est déjà clair
vous disposez d’un cas de reproduction
le périmètre est assez restreint pour être vérifié rapidement
Mélanger les deux dans le même prompt produit souvent un mur de texte qui explique tout et ne change rien. Gardez-les séparés.
Choisir le bon modèle pour le code
Tous les modèles de langage ne se valent pas sur les tâches de code. Les écarts sont importants, et utiliser le mauvais modèle pour une tâche ajoute des frictions à votre flux de travail.
Compromis entre vitesse et précision
Les modèles plus petits et plus rapides conviennent parfaitement à :
les suggestions d’autocomplétion
les fonctions utilitaires simples
les conversions de format rapides
la génération de code répétitif
Les modèles plus grands et plus capables valent le surcoût en latence pour :
les décisions d’architecture
les problèmes algorithmiques complexes
le débogage de conditions de concurrence subtiles
le refactoring avec des contraintes strictes
L’objectif est d’adapter la capacité du modèle à la complexité de la tâche. Utiliser un modèle de raisonnement de pointe pour renommer une variable est un gaspillage. Utiliser un petit modèle rapide pour concevoir une stratégie de cache distribuée est une erreur.
Des modèles conçus pour les tâches de code
Plusieurs modèles disponibles sur PicassoIA sont particulièrement performants en génération de code et en raisonnement. Claude 4 Sonnet est conçu pour un code précis et le respect des instructions, ce qui en fait l’un des meilleurs choix pour les flux de travail de code agentiques. Claude 4.5 Sonnet va plus loin avec un débogage plus performant dans plusieurs langages.
Pour les développeurs qui veulent un raisonnement solide associé à la génération de code, DeepSeek R1 décompose bien les problèmes étape par étape avant de produire une sortie. Kimi K2 Instruct est un autre choix solide, très bien noté pour le raisonnement et les tâches de code.
Si vous avez besoin de modèles spécialisés dans le code, entraînés précisément sur des jeux de données de programmation, Granite 8B Code Instruct 128K et Granite 20B Code Instruct 8K d’IBM valent le détour. Tous deux sont optimisés pour la complétion de code et le respect des instructions dans un contexte de programmation.
Pour les tâches générales qui combinent rédaction, analyse et génération de code, GPT 5.1 et Kimi K2.6 offrent des capacités polyvalentes pour construire des agents. Kimi K2.6 est en particulier conçu pour les tâches d’agents IA en plusieurs étapes, où le raisonnement et la production de code doivent fonctionner ensemble.
Des exemples concrets qui livrent un code propre
Les conseils abstraits sont difficiles à appliquer. Voici des exemples concrets avant-après qui montrent comment la qualité du prompt influe directement sur la qualité du code.
Refactoriser une fonction
Avant : « Refactorisez cette fonction pour la rendre plus propre »
Après :
Refactor the following Python function. Requirements:
1. Extract the database query into a separate helper called _fetch_user_records
2. Replace the nested if/else with early returns
3. Add type annotations to all parameters and return value
4. Do not change the external behavior or function signature

Current code:
[paste function here]
La sortie du second prompt ne demande aucune réécriture. Elle respecte exactement vos exigences, parce que vous les avez formulées.
Écrire des tests à partir de zéro
Les tests sont le domaine où les agents de code IA apportent une valeur considérable lorsqu’ils sont bien sollicités. L’approche consiste à préciser les comportements à tester, et pas seulement le fichier à tester.
Faible : « Écrivez des tests pour le service utilisateur »
Solide :
Write pytest tests for UserService.create_user in src/services/user_service.py.

Test these specific cases:
1. Successful creation returns a user dict with 'id', 'email', and 'created_at' keys
2. Duplicate email raises DuplicateUserError
3. Invalid email format raises ValidationError
4. Missing required fields raises MissingFieldError

Mock the database with unittest.mock.patch. Do not write integration tests.
Le second prompt produit quatre cas de test ciblés et pertinents, qui couvrent les modes de défaillance réels de la fonction, sans aucun retraitement de votre part.
Itérer sans tout recommencer
Une compétence sous-estimée est le prompting itératif : affiner une sortie sans abandonner le contexte de la conversation. Au lieu de tout régénérer lorsque la sortie est presque bonne, formulez directement la correction :
« La fonction est correcte, mais modifiez la gestion des erreurs pour utiliser des exceptions personnalisées de src/exceptions.py au lieu des exceptions intégrées »
« Gardez tout tel quel, mais renommez toutes les variables pour suivre la convention snake_case »
« Ajoutez des docstrings au format Google à chaque fonction que vous avez écrite »
Les corrections itératives conservent ce qui a fonctionné et ne modifient que ce qui n’a pas marché. C’est plusieurs ordres de grandeur plus rapide que de démarrer une nouvelle session chaque fois que la sortie oublie un détail.
Comment les équipes utilisent efficacement les agents de code
L’usage individuel est une chose. Lorsqu’une équipe partage des flux de travail de code IA, quelques pratiques distinguent les équipes très productives des équipes désorganisées.
Modèles de prompts partagés
Les meilleures équipes créent des modèles de prompts réutilisables pour les tâches répétées. Un modèle pour « ajouter un nouveau point de terminaison API » peut inclure des emplacements pour le chemin de la route, la méthode HTTP, le schéma de requête, le schéma de réponse et les exigences d’authentification. Les nouveaux membres de l’équipe complètent les champs et obtiennent à chaque fois une sortie cohérente, conforme aux schémas établis.
Cela élimine les variations qui apparaissent lorsque cinq développeurs demandent la « même chose » de cinq façons totalement différentes et obtiennent cinq implémentations structurellement différentes.
Relire avant la fusion
Le code généré par IA doit être relu avec la même rigueur que le code écrit par un humain. L’agent ne connaît ni vos exigences de sécurité, ni la sensibilité de vos données, ni les cas limites de votre métier. Il écrit du code qui paraît correct. Votre travail consiste à vérifier qu’il l’est réellement.
💡 Réflexe essentiel : ne fusionnez jamais de code généré par IA sans l’avoir exécuté sur votre suite de tests réelle. L’agent optimise la production d’un code agréable à lire, pas la gestion des cas limites propres à votre production.
Des bibliothèques de prompts comme bien commun de l’équipe
Documentez les prompts qui produisent régulièrement de bons résultats. Partagez-les dans le wiki ou le dépôt de votre équipe. Un prompt qui génère de façon fiable des migrations de base de données correctes pour votre stack a plus de valeur que chaque morceau de code qu’il produit. Le prompt est l’actif réutilisable. Le code est le résultat.
Essayez ces schémas sur PicassoIA
Chaque conseil de cet article est immédiatement applicable. Vous n’avez pas besoin de nouveaux outils. Vous n’avez pas besoin de changer d’éditeur. Vous devez écrire de meilleurs prompts, et les meilleurs prompts reposent sur la précision, la structure et le contexte.
PicassoIA vous donne un accès direct aux modèles évoqués ici, côte à côte, sans changer de plateforme. Que vous vouliez le raisonnement approfondi de Claude 4 Sonnet, l’entraînement spécifique au code de Granite 8B Code Instruct 128K ou les capacités de construction d’agents de Kimi K2.6, vous pouvez exécuter exactement le même prompt sur plusieurs modèles et comparer la qualité des sorties en quelques secondes.
Commencez par une fonction sur laquelle vous travaillez réellement en ce moment. Appliquez le format rôle + tâche + contrainte. Incluez le code existant pertinent comme contexte. Précisez le format de sortie attendu. Comparez ensuite ce résultat à ce que votre ancien prompt vague aurait produit. La différence sera évidente, et l’habitude restera.
La qualité de votre agent de code ne dépend que des consignes que vous lui donnez. Donnez-lui de meilleures consignes, et livrez de meilleurs logiciels.