कोडिंग एजेंट को बेहतर प्रॉम्प्ट देने के टिप्स: 2027 में असल में क्या काम करता है
आप अपने कोडिंग एजेंट से पूरा फ़ायदा इसलिए नहीं उठा पा रहे, क्योंकि आपके प्रॉम्प्ट काफ़ी स्पष्ट नहीं हैं। यह आर्टिकल बताता है कि प्रॉम्प्ट की संरचना कैसे बनाएँ, सही कॉन्टेक्स्ट कैसे चुनें और ऐसे निर्देश कैसे लिखें जो पहली बार में ही काम करने वाला कोड दें।
आपने डेमो देखे होंगे। AI कुछ ही सेकंड में परफ़ेक्ट कोड लिख देता है, डेवलपर आराम से पीछे टिककर बैठ जाता है और काम खत्म। लेकिन ज़्यादातर डेवलपर्स की असली स्थिति अलग होती है: अस्पष्ट आउटपुट, गलत इंपोर्ट, ऐसा लॉजिक जो लगभग काम करता है, और ऐसे जवाब जो बात को पूरी तरह से चूक जाते हैं। उन चमकदार डेमो और रोज़मर्रा के असली इस्तेमाल के बीच का फ़ासला लगभग पूरी तरह इस पर निर्भर है कि आप प्रॉम्प्ट कैसे लिखते हैं। बेहतर इनपुट से कहीं बेहतर आउटपुट मिलता है, और इसके नियम स्पष्ट नहीं हैं।
ज़्यादातर कोडिंग प्रॉम्प्ट क्यों असफल होते हैं
सबसे आम गलतफ़हमी यह है कि कोडिंग एजेंट "खुद समझ लेने जितना स्मार्ट" है। ऐसा नहीं है। कोडिंग एजेंट एक प्रेडिक्शन इंजन है, और वह वही अनुमान लगाता है जो आप उसे देते हैं। गंदा इनपुट, गंदा आउटपुट, यह बात फ़्रंटियर मॉडल के साथ भी उतनी ही सच है।
अस्पष्ट निर्देश = अस्पष्ट कोड
किसी एजेंट से "user data को process करने वाला function लिखो" कहेंगे, तो वह कुछ न कुछ ज़रूर लिख देगा। शायद वह उचित भी दिखे। लेकिन वह गलत डेटा को प्रोसेस करेगा, गलत फ़ॉर्मेट में करेगा, बिना एरर हैंडलिंग के करेगा, और ऐसे वेरिएबल नाम रखेगा जिनका आपके कोडबेस में कोई मतलब नहीं। एजेंट असफल नहीं हुआ। असफल आप हुए, क्योंकि आपने अधूरी स्पेसिफ़िकेशन दी।
एजेंट आपका मन नहीं पढ़ सकता। जब तक आप उसे नहीं दिखाते, वह आपका कोडबेस नहीं देख सकता। उसे नहीं पता कि आपके एप्लिकेशन में "process" का मतलब क्या है। वह जो भी धारणा बनाता है, वह एक अनुमान ही होता है।
एजेंट असल में "सुनता" क्या है
जब आप प्रॉम्प्ट भेजते हैं, तो मॉडल सिर्फ़ टोकन देखता है। उसे न लहजा दिखता है, न इरादा, न डोमेन का कोई माना हुआ ज्ञान। इन दो प्रॉम्प्ट के बीच का फ़र्क बहुत बड़ा है:
खराब: "एक login function लिखो"
अच्छा: "authenticate_user(email: str, password: str) -> dict नाम का एक Python फ़ंक्शन लिखो जो पासवर्ड की तुलना के लिए bcrypt का उपयोग करके PostgreSQL डेटाबेस के विरुद्ध क्रेडेंशियल जाँचे। सफल होने पर {success: True, user_id: int} और विफल होने पर {success: False, error: str} लौटाओ। src/database.py से मौजूदा db_connection() हेल्पर का इस्तेमाल करो।"
दूसरा प्रॉम्प्ट दर्जनों अनुमानों को खत्म कर देता है। भाषा, function signature, डेटा टाइप, database का प्रकार, hashing library, रिटर्न फ़ॉर्मेट और प्रोजेक्ट की संरचना, सब कुछ तय है। आउटपुट बिना दोबारा लिखे इस्तेमाल किया जा सकेगा।
5 प्रॉम्प्ट पैटर्न जो असली कोड देते हैं
ये सिर्फ़ थ्योरी नहीं हैं। ये वे पैटर्न हैं जिन्हें इस्तेमाल करने वाले डेवलपर्स AI एजेंट से पहली या दूसरी कोशिश में लगातार काम करने वाला कोड पाते हैं।
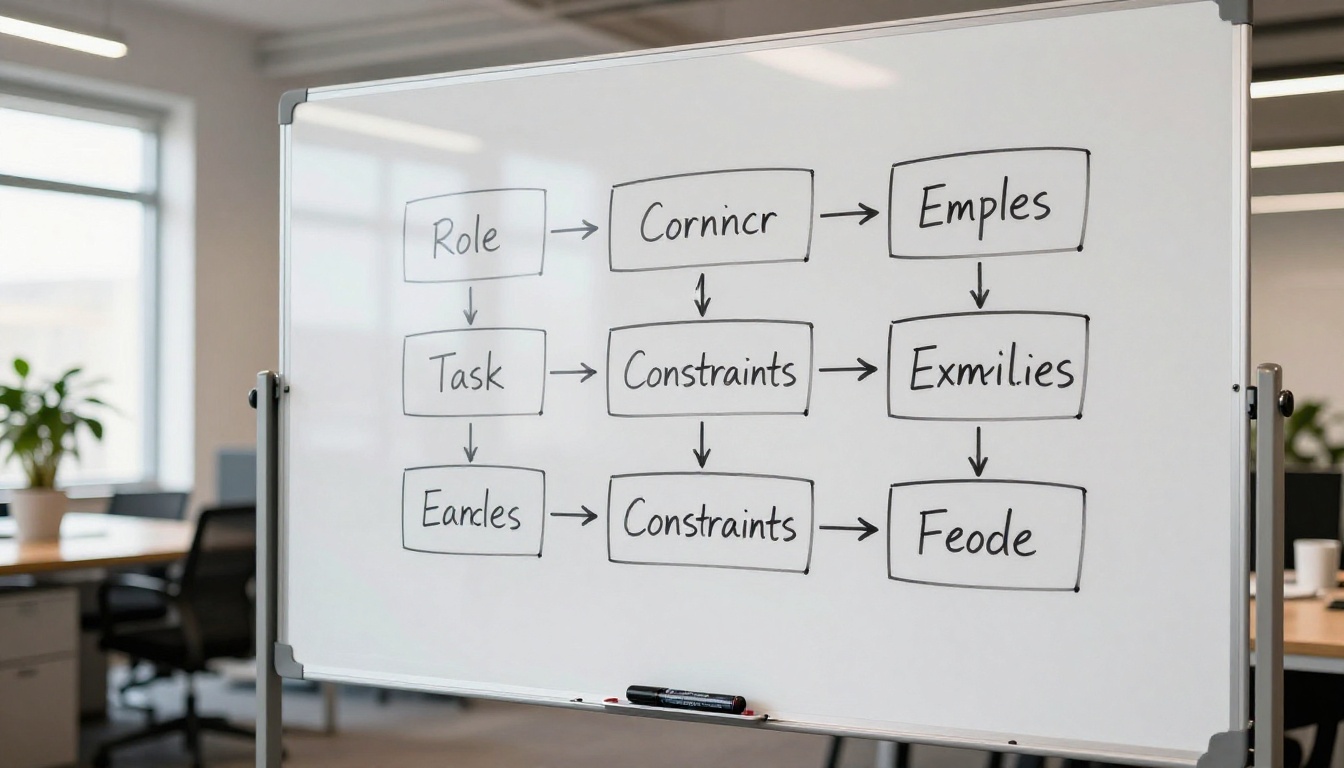
रोल + टास्क + कंस्ट्रेंट फ़ॉर्मेट
हर गैर-सामान्य प्रॉम्प्ट को तीन हिस्सों में बाँटें:
रोल: एजेंट को बताएँ कि वह किस तरह का विशेषज्ञ बनकर काम कर रहा है
टास्क: साफ़-साफ़ बताएँ कि क्या बनाना है
कंस्ट्रेंट: लिखें कि उसे क्या नहीं करना है, कौन-सी libraries इस्तेमाल करनी हैं और आउटपुट का फ़ॉर्मेट क्या है
💡 उदाहरण: "आप एक सीनियर Python बैकएंड इंजीनियर हैं। एक FastAPI एप्लिकेशन के लिए रेट-लिमिटिंग मिडलवेयर लिखो। स्टोरेज के लिए Redis का उपयोग करो। किसी भी थर्ड-पार्टी रेट-लिमिटिंग लाइब्रेरी का इस्तेमाल मत करो। मिडलवेयर को एक क्लास के रूप में लौटाओ, जिसे app.add_middleware() के साथ रजिस्टर किया जा सके।"
अकेला यह तीन-हिस्सों वाला ढाँचा भी आउटपुट की गुणवत्ता को साफ़ तौर पर बेहतर बना देता है।
सिर्फ़ निर्देश नहीं, उदाहरण दें
प्रैक्टिकल कोडिंग वर्कफ़्लो में फ्यू-शॉट प्रॉम्प्टिंग सबसे कम इस्तेमाल होने वाले तरीकों में से एक है। जो आप चाहते हैं उसे बताने के बजाय उसे दिखाएँ।
अगर आपको अपने कोडबेस के किसी खास पैटर्न वाला function चाहिए, तो पहले कोई मिलता-जुलता मौजूदा function उदाहरण के तौर पर पेस्ट करें। कहें "ठीक इसी पैटर्न को फ़ॉलो करो" और फिर नया function बताएँ। एजेंट नामकरण की परंपरा, एरर हैंडलिंग का तरीका, logging पैटर्न और docstring फ़ॉर्मेट की नकल कर लेगा, और आपको इन सभी शर्तों को अलग से गिनाना नहीं पड़ेगा।
उदाहरण के बिना: "स्ट्रिंग से तारीखें parse करने के लिए एक helper function लिखो"
उदाहरण के साथ:
Here is an existing helper in our codebase:

def parse_currency(value: str) -> Decimal:
    """Parses a currency string like '$1,234.56' into Decimal."""
    try:
        cleaned = value.replace('$', '').replace(',', '')
        return Decimal(cleaned)
    except InvalidOperation:
        raise ValueError(f"Cannot parse currency: {value!r}")

Write a similar helper called parse_date(value: str) -> date that handles formats:
'YYYY-MM-DD', 'MM/DD/YYYY', and 'DD-Mon-YYYY'.
दूसरा संस्करण पहली कोशिश में ही ऐसा function देगा जो आपके कोडबेस में फ़िट बैठे।
स्कोप छोटा रखें, बड़ा नहीं
AI-सहायता वाली डेवलपमेंट में सबसे नुकसानदेह आदतों में से एक है एक साथ बहुत ज़्यादा माँगना। "मेरे लिए पूरा authentication system बनाओ" जैसा प्रॉम्प्ट फूला हुआ, सामान्य आउटपुट देगा, जो आपकी architecture को ऐसे तरीकों से छुएगा जिनकी आपको उम्मीद नहीं होगी।
बड़े टास्क को छोटे, अविभाज्य हिस्सों में तोड़ें:
खराब प्रॉम्प्ट
बेहतर प्रॉम्प्ट
"एक पेमेंट सिस्टम बनाओ"
"create_payment_intent फ़ंक्शन लिखो"
"पूरे यूज़र मॉड्यूल को रीफ़ैक्टर करो"
"get_user_by_email को async/await इस्तेमाल करने के लिए रीफ़ैक्टर करो"
"ऐप में लॉगिंग जोड़ो"
"order_service.py में स्ट्रक्चर्ड लॉगिंग जोड़ो"
"API के लिए टेस्ट लिखो"
"POST /api/orders के लिए pytest यूनिट टेस्ट लिखो"
छोटा स्कोप, साफ़ आउटपुट। आप प्रॉम्प्ट को हमेशा एक के बाद एक जोड़ सकते हैं।
कॉन्टेक्स्ट ही सब कुछ है
कॉन्टेक्स्ट आपके पास सबसे ताकतवर लीवर है। ज़्यादा प्रासंगिक कॉन्टेक्स्ट लगभग हमेशा आउटपुट को बेहतर बनाता है। चुनौती यह जानने की है कि क्या शामिल करना है और क्या छोड़ना है।
हर प्रॉम्प्ट में क्या शामिल करें
कम से कम, हर गैर-सामान्य प्रॉम्प्ट में ये चीज़ें होनी चाहिए:
भाषा और वर्ज़न: Python 3.11, TypeScript 5.2, Go 1.22
प्रासंगिक मौजूदा कोड: जिस function, class या file को बदला जा रहा है, उसे पेस्ट करें
एरर मैसेज (डीबगिंग के समय): पूरा stack trace दें, सार नहीं
अपेक्षित व्यवहार: क्या होना चाहिए और अभी क्या हो रहा है
पहले से इस्तेमाल हो रही libraries: ताकि एजेंट नई libraries न गढ़े
इनमें से एक भी चीज़ छूटने पर आउटपुट में काफ़ी सुधार की ज़रूरत पड़ती है।
कॉन्टेक्स्ट कितना ज़्यादा है
टोकन की सीमाएँ होती हैं, और अपने प्रोजेक्ट की हर file प्रॉम्प्ट में ठूँसना उल्टा असर डालता है। जब एजेंट को बहुत ज़्यादा अप्रासंगिक सामग्री दी जाती है, तो वह असली काम पर ध्यान खोने लगता है।
एक व्यावहारिक नियम: सिर्फ़ वही शामिल करें जो बदलाव के सीधे आस-पास है। अगर कोई function बदल रहे हैं, तो function और उसकी तुरंत ज़रूरी dependencies पेस्ट करें। अगर route को डीबग कर रहे हैं, तो route handler और वह model पेस्ट करें जिसका वह इस्तेमाल करता है। असंबंधित modules छोड़ दें।
💡 प्रो टिप: जो कोड छोड़ा गया है, उसका काम comments में संक्षेप में लिखें। // The UserService class handles DB reads. It has find_by_id(id) and update(id, data) methods. इससे एजेंट को API की सतह मिल जाती है, और पूरी implementation पर टोकन खर्च नहीं होते।
AI एजेंट्स के साथ डीबगिंग
सही इनपुट मिलने पर AI एजेंट्स शानदार डीबगिंग पार्टनर बन जाते हैं। आम गलती है किसी एजेंट से कुछ ठीक करने को कहना, बिना उसे पूरी तस्वीर दिए।
"पहले बग दोबारा बनाएँ" नियम
किसी एजेंट से बग ठीक करवाने से पहले न्यूनतम reproduction case शामिल करें। पूरा कोडबेस नहीं, बग का सिर्फ़ विवरण भी नहीं। असली असफल कोड, वह इनपुट जो उसे ट्रिगर करता है, और सटीक एरर आउटपुट दें।
कमज़ोर प्रॉम्प्ट: "मेरा API कभी-कभी 500 error दे रहा है, क्या आप इसे ठीक कर सकते हैं?"
मज़बूत प्रॉम्प्ट:
This function throws a KeyError intermittently:

def process_webhook(payload: dict) -> None:
    user_id = payload['user']['id']   # crashes when 'user' is absent
    update_subscription(user_id)

Error: KeyError: 'user'
Input that triggered it: {"event": "payment.failed", "amount": 49.99}

Fix the function to handle missing 'user' gracefully. If 'user' is absent, log a warning and return early.
दूसरा प्रॉम्प्ट एजेंट को वह सब देता है जिसकी उसे ज़रूरत है। फ़िक्स सही होगा और आपके इरादे के मुताबिक़ होगा।
कब व्याख्या माँगें और कब फ़िक्स
हर बातचीत "इसे ठीक करो" पर खत्म होना ज़रूरी नहीं। कभी-कभी कोई कोड बदलने से पहले यह पढ़ना ज़रूरी होता है कि वह क्या करता है।
व्याख्या माँगें जब:
ऐसा कोड विरासत में मिला हो जो आपने नहीं लिखा
किसी अपरिचित library या framework में काम कर रहे हों
यह समझना हो कि कोई fix क्यों काम किया
फ़िक्स माँगें जब:
अपेक्षित व्यवहार पहले से साफ़ हो
आपके पास reproduction case हो
स्कोप इतना छोटा हो कि जल्दी जाँचा जा सके
एक ही प्रॉम्प्ट में दोनों मिलाने से अक्सर ऐसा लंबा टेक्स्ट बनता है जो सब कुछ समझाता है और कुछ बदलता नहीं। दोनों को अलग रखें।
कोड के लिए सही मॉडल चुनना
सभी लैंग्वेज मॉडल कोडिंग कार्यों पर एक जैसा प्रदर्शन नहीं करते। फ़र्क काफ़ी बड़ा है, और किसी टास्क के लिए गलत मॉडल चुनने से आपके वर्कफ़्लो में रुकावट आती है।
स्पीड बनाम सटीकता का समझौता
छोटे, तेज़ मॉडल इन कामों के लिए बेहतरीन हैं:
Autocomplete सुझाव
सरल utility functions
तेज़ फ़ॉर्मेट बदलाव
Boilerplate बनाना
बड़े और ज़्यादा सक्षम मॉडल इन कामों के लिए अतिरिक्त लेटेंसी के लायक हैं:
आर्किटेक्चर से जुड़े फ़ैसले
जटिल एल्गोरिदमिक समस्याएँ
बारीक race condition की डीबगिंग
सख़्त शर्तों के साथ रीफ़ैक्टरिंग
लक्ष्य है मॉडल की क्षमता को टास्क की जटिलता से मिलाना। एक variable का नाम बदलने के लिए फ़्रंटियर reasoning मॉडल इस्तेमाल करना फ़िज़ूलखर्ची है। और distributed caching strategy डिज़ाइन करने के लिए छोटा, तेज़ मॉडल इस्तेमाल करना गलती है।
कोडिंग कार्यों के लिए बने मॉडल
PicassoIA पर कई मॉडल खास तौर पर कोड जनरेशन और reasoning में मज़बूत हैं। Claude 4 Sonnet सटीक कोडिंग और निर्देश-पालन के लिए बना है, जिससे यह एजेंटिक कोडिंग वर्कफ़्लो के लिए सबसे अच्छे विकल्पों में से एक है। Claude 4.5 Sonnet इसे कई भाषाओं में बेहतर डीबगिंग क्षमता के साथ आगे ले जाता है।
जो डेवलपर्स कोड जनरेशन के साथ मज़बूत reasoning चाहते हैं, उनके लिए DeepSeek R1 आउटपुट देने से पहले चरण-दर-चरण समस्या को तोड़ने में अच्छा काम करता है। Kimi K2 Instruct एक और ठोस विकल्प है, जिसे reasoning और कोडिंग कार्यों के लिए अच्छी रेटिंग मिली है।
अगर आपको ऐसे कोड-विशेषज्ञ मॉडल चाहिए जो खास तौर पर प्रोग्रामिंग डेटासेट पर ट्रेन किए गए हों, तो IBM के Granite 8B Code Instruct 128K और Granite 20B Code Instruct 8K आज़माने लायक हैं। दोनों प्रोग्रामिंग संदर्भ में कोड कम्प्लीशन और निर्देशों का पालन करने के लिए ट्यून किए गए हैं।
लेखन, विश्लेषण और कोड जनरेशन को मिलाने वाले व्यापक टास्क के लिए, GPT 5.1 और Kimi K2.6 लचीली एजेंट-निर्माण क्षमताएँ देते हैं। Kimi K2.6 खास तौर पर उन मल्टी-स्टेप AI एजेंट टास्क के लिए बना है जहाँ reasoning और कोड आउटपुट साथ-साथ काम करने चाहिए।
असली उदाहरण जो साफ़ कोड देते हैं
सिर्फ़ सिद्धांत लागू करना कठिन होता है। ये ठोस पहले-और-बाद वाले उदाहरण दिखाते हैं कि प्रॉम्प्ट की गुणवत्ता सीधे कोड की गुणवत्ता को कैसे प्रभावित करती है।
एक function को refactor करना
पहले: "इस function को और साफ़ बनाने के लिए refactor करो"
बाद में:
Refactor the following Python function. Requirements:
1. Extract the database query into a separate helper called _fetch_user_records
2. Replace the nested if/else with early returns
3. Add type annotations to all parameters and return value
4. Do not change the external behavior or function signature

Current code:
[paste function here]
दूसरे प्रॉम्प्ट के आउटपुट को दोबारा लिखने की ज़रूरत नहीं पड़ती। वह आपकी बताई शर्तों को ठीक वैसे ही मानता है, क्योंकि आपने उन्हें साफ़ बताया।
शुरुआत से टेस्ट लिखना
सही तरीके से प्रॉम्प्ट करने पर टेस्ट वह जगह है जहाँ AI कोडिंग एजेंट बहुत मूल्य जोड़ते हैं। तरीका यह बताना है कि किन व्यवहारों की जाँच करनी है, सिर्फ़ यह नहीं कि किस file का टेस्ट करना है।
कमज़ोर: "user service के लिए tests लिखो"
मज़बूत:
Write pytest tests for UserService.create_user in src/services/user_service.py.

Test these specific cases:
1. Successful creation returns a user dict with 'id', 'email', and 'created_at' keys
2. Duplicate email raises DuplicateUserError
3. Invalid email format raises ValidationError
4. Missing required fields raises MissingFieldError

Mock the database with unittest.mock.patch. Do not write integration tests.
दूसरा प्रॉम्प्ट चार केंद्रित, सार्थक टेस्ट केस देता है, जो function की असली दुनिया की विफलता वाली स्थितियों को कवर करते हैं, और आपके अंत में किसी post-processing की ज़रूरत नहीं पड़ती।
बिना दोबारा शुरू किए बेहतर करते जाना
एक कम आँका गया कौशल है iterative prompting: बातचीत का कॉन्टेक्स्ट छोड़े बिना आउटपुट को परिष्कृत करते जाना। जब आउटपुट लगभग सही हो, तो उसे शुरू से दोबारा जेनरेट कराने के बजाय सुधार सीधे माँगें:
"फ़ंक्शन सही है, लेकिन एरर हैंडलिंग को बदलो ताकि बिल्ट-इन exceptions की जगह src/exceptions.py के कस्टम exceptions इस्तेमाल हों"
"बाकी सब वैसा ही रखो, लेकिन सभी वेरिएबल के नाम snake_case के अनुसार बदल दो"
"आपने जो भी फ़ंक्शन लिखे हैं, उन सबमें Google फ़ॉर्मेट में docstrings जोड़ें"
iterative सुधार वही बचाते हैं जो काम कर रहा था और सिर्फ़ वही बदलते हैं जो नहीं कर रहा था। जब भी आउटपुट कोई बारीकी चूके, तब हर बार नया सेशन शुरू करने से यह कई गुना तेज़ है।
टीमें कोडिंग एजेंट्स का असरदार इस्तेमाल कैसे करती हैं
अकेले इस्तेमाल करना एक बात है। जब टीम AI कोडिंग वर्कफ़्लो साझा करती है, तब कुछ आदतें ज़्यादा आउटपुट देने वाली टीमों को अव्यवस्थित टीमों से अलग करती हैं।
साझा प्रॉम्प्ट टेम्पलेट
सबसे अच्छी टीमें दोहराए जाने वाले टास्क के लिए दोबारा इस्तेमाल होने वाले प्रॉम्प्ट टेम्पलेट बनाती हैं। "एक नया API endpoint जोड़ें" के लिए एक टेम्पलेट में route path, HTTP method, request schema, response schema और authentication requirements के लिए प्लेसहोल्डर हो सकते हैं। नए टीम सदस्य खाली जगहें भर देते हैं और हर बार एक जैसा, पैटर्न के अनुसार आउटपुट पाते हैं।
इससे वह अंतर खत्म हो जाता है जो तब होता है जब पाँच डेवलपर्स पाँच बिल्कुल अलग तरीकों से "वही चीज़" माँगते हैं और पाँच संरचनात्मक रूप से अलग implementations पाते हैं।
मर्ज करने से पहले समीक्षा
AI से बने कोड की समीक्षा उतनी ही सख्ती से होनी चाहिए जितनी इंसान के लिखे कोड की। एजेंट को आपकी security की ज़रूरतें, आपके डेटा की संवेदनशीलता या आपके business के edge cases नहीं पता होते। वह ऐसा कोड लिखता है जो सही दिखता है। यह जाँचना आपका काम है कि वह सचमुच सही है।
💡 ज़रूरी आदत: AI से बने कोड को कभी भी अपने असली test suite पर चलाए बिना merge न करें। एजेंट ऐसा कोड बनाने के लिए अनुकूलित होता है जो पढ़ने में अच्छा लगे, न कि ऐसा कोड जो आपके खास production edge cases को संभाले।
टीम की संपत्ति के रूप में प्रॉम्प्ट लाइब्रेरी
जो प्रॉम्प्ट लगातार अच्छे नतीजे देते हैं, उन्हें दस्तावेज़ बनाएँ। उन्हें अपनी टीम के wiki या repository में साझा करें। ऐसा प्रॉम्प्ट जो आपके टूल्स के सेट के लिए सही database migrations भरोसे से बनाता है, उस हर अलग कोड से ज़्यादा मूल्यवान है जो वह बनाता है। प्रॉम्प्ट दोबारा इस्तेमाल होने वाली संपत्ति है। कोड उसका आउटपुट है।
PicassoIA पर ये पैटर्न आज़माएँ
इस आर्टिकल का हर टिप तुरंत लागू किया जा सकता है। आपको नए टूल्स की ज़रूरत नहीं है। अपना editor बदलने की ज़रूरत नहीं है। आपको बेहतर प्रॉम्प्ट लिखने हैं, और बेहतर प्रॉम्प्ट साफ़-साफ़ बताने, संरचना और कॉन्टेक्स्ट से शुरू होते हैं।
PicassoIA आपको यहाँ चर्चा किए गए मॉडल सीधे और एक-दूसरे के साथ, बिना प्लेटफ़ॉर्म बदले, उपलब्ध कराता है। चाहे आपको Claude 4 Sonnet की गहरी reasoning चाहिए, Granite 8B Code Instruct 128K की कोड-विशेष ट्रेनिंग, या Kimi K2.6 की एजेंट-निर्माण क्षमता, आप बिल्कुल वही प्रॉम्प्ट कई मॉडलों पर चलाकर सेकंडों में आउटपुट की गुणवत्ता की तुलना कर सकते हैं।
उस एक function से शुरू करें जिस पर आप अभी सचमुच काम कर रहे हैं। रोल + टास्क + कंस्ट्रेंट फ़ॉर्मेट लागू करें। प्रासंगिक मौजूदा कोड को कॉन्टेक्स्ट के रूप में शामिल करें। अपेक्षित आउटपुट का फ़ॉर्मेट बताएँ। फिर उस नतीजे की तुलना उस अस्पष्ट प्रॉम्प्ट से करें जो आपने पहले लिखा था। फ़र्क साफ़ दिखेगा, और यह आदत बन जाएगी।
आपका कोडिंग एजेंट उतना ही असरदार है जितने निर्देश आप उसे देते हैं। उसे बेहतर निर्देश दें, और बेहतर सॉफ़्टवेयर बनाएँ।