Dicas para fazer bons prompts para agentes de programação: o que realmente funciona em 2027
Você não está tirando o máximo do seu agente de programação porque seus prompts não são específicos o bastante. Este artigo detalha exatamente como estruturar prompts, escolher o contexto certo e escrever instruções que geram código que funciona na primeira tentativa.
Você já viu as demonstrações. A IA escreve código perfeito em segundos, o desenvolvedor se recosta na cadeira e pronto. A realidade que a maioria dos desenvolvedores enfrenta é outra: saída vaga, importações erradas, lógica que quase funciona e respostas que simplesmente não entendem o ponto. A distância entre essas demonstrações polidas e o uso diário real depende quase totalmente de como você faz o prompt. Entradas melhores produzem saídas muito melhores, e as regras não são óbvias.
Por que a maioria dos prompts de programação falha
O equívoco mais comum é achar que um agente de programação é "inteligente o bastante para descobrir sozinho". Não é. Um agente de programação é um motor de previsão, e ele prevê com base no que você fornece. Lixo entra, lixo sai: isso continua valendo, sem exceção, mesmo com os modelos de fronteira.
Instruções vagas geram código vago
Peça a um agente para "escrever uma função para processar dados de usuário" e ele vai escrever algo. Pode até parecer razoável. Mas vai processar os dados errados, no formato errado, sem tratamento de erros, e com nomes de variáveis que não significam nada para a sua base de código. O agente não falhou. Você falhou, ao fornecer uma especificação incompleta.
O agente não consegue ler sua mente. Ele não consegue ver sua base de código, a menos que você a mostre. Ele não sabe o que "processar" significa para a sua aplicação. Cada suposição que ele faz é um palpite.
O que os agentes realmente "ouvem"
Quando você envia um prompt, o modelo enxerga apenas tokens. Sem tom, sem intenção, sem conhecimento de domínio presumido. A diferença entre estes dois prompts é enorme:
Ruim: "Escreva uma função de login"
Bom: "Escreva uma função em Python chamada authenticate_user(email: str, password: str) -> dict que verifique credenciais em um banco de dados PostgreSQL usando bcrypt para comparar senhas. Retorne {success: True, user_id: int} em caso de sucesso ou {success: False, error: str} em caso de falha. Use o auxiliar db_connection() existente de src/database.py."
O segundo prompt elimina dezenas de suposições. Linguagem, assinatura da função, tipos de dados, tipo de banco de dados, biblioteca de hash, formato de retorno e estrutura do projeto estão todos especificados. A saída será utilizável sem reescrita.
Os 5 padrões de prompt que entregam código
Isto não é teoria. São padrões usados por desenvolvedores que obtêm código que funciona de agentes de IA de forma consistente, na primeira ou na segunda tentativa.
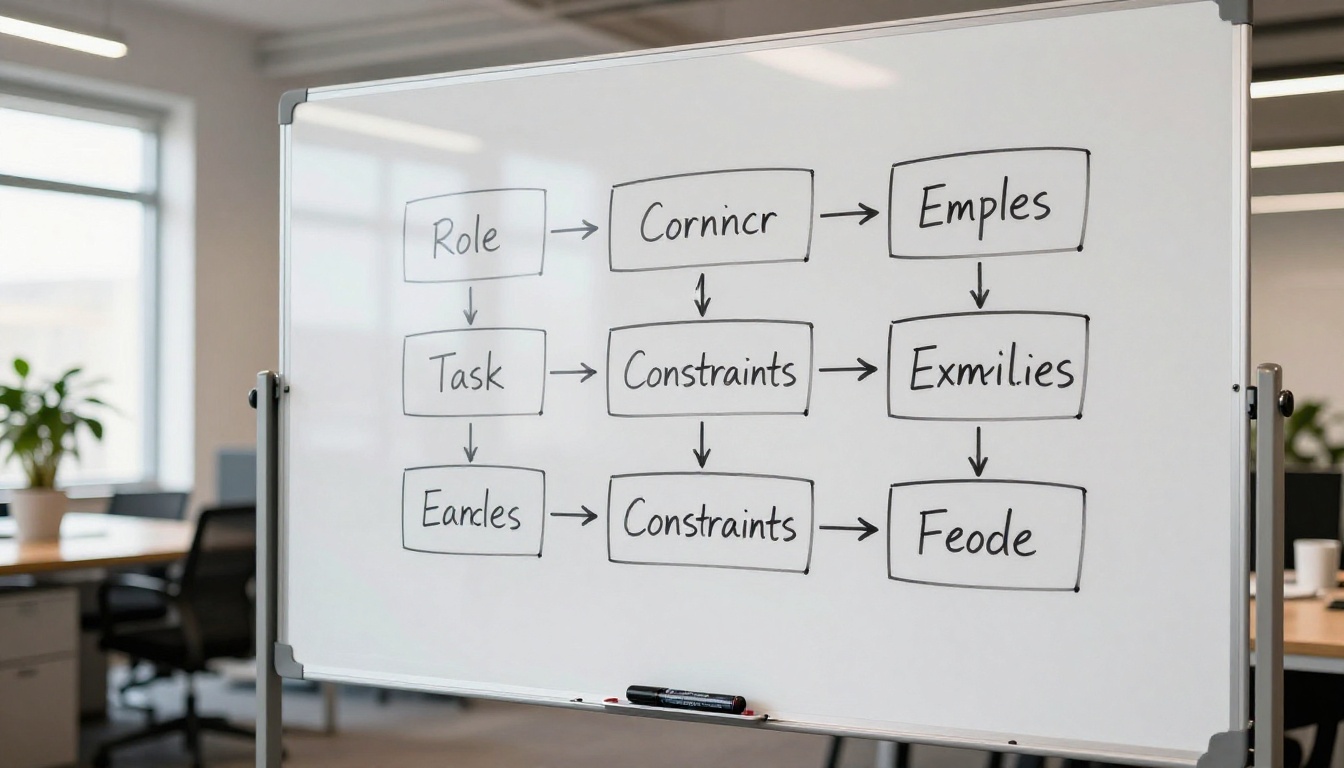
Formato papel + tarefa + restrição
Estruture todo prompt não trivial com três componentes:
Papel: diga ao agente que tipo de especialista ele está atuando como
Tarefa: descreva especificamente o que precisa ser construído
Restrições: liste o que ele não deve fazer, quais bibliotecas usar e qual é o formato da saída
💡 Exemplo: "Você é um engenheiro backend sênior em Python. Escreva um middleware de limitação de taxa para uma aplicação FastAPI. Use o Redis para armazenamento. Não use nenhuma biblioteca de terceiros para limitação de taxa. Retorne o middleware como uma classe que possa ser registrada com app.add_middleware()."
Só essa estrutura em três partes já melhora a qualidade da saída de forma mensurável.
Dê exemplos, não apenas instruções
O prompt com poucos exemplos (few-shot) é uma das abordagens mais subutilizadas em fluxos práticos de programação. Em vez de descrever o que você quer, mostre.
Se você quer uma função que siga um padrão específico da sua base de código, cole primeiro uma função semelhante existente como exemplo. Diga "siga exatamente este padrão" e, em seguida, descreva a nova. O agente vai replicar as convenções de nomenclatura, o estilo de tratamento de erros, os padrões de log e o formato da docstring sem que você precise listar todos esses requisitos explicitamente.
Sem exemplo: "Escreva uma função auxiliar para analisar datas a partir de strings"
Com exemplo:
Here is an existing helper in our codebase:

def parse_currency(value: str) -> Decimal:
    """Parses a currency string like '$1,234.56' into Decimal."""
    try:
        cleaned = value.replace('$', '').replace(',', '')
        return Decimal(cleaned)
    except InvalidOperation:
        raise ValueError(f"Cannot parse currency: {value!r}")

Write a similar helper called parse_date(value: str) -> date that handles formats:
'YYYY-MM-DD', 'MM/DD/YYYY', and 'DD-Mon-YYYY'.
A segunda versão vai produzir uma função que se encaixa na sua base de código já na primeira tentativa.
Limite o escopo, não o amplie
Um dos hábitos mais prejudiciais no desenvolvimento assistido por IA é pedir coisas demais de uma só vez. "Construa um sistema de autenticação completo" vai gerar uma saída inchada e genérica, que mexe na sua arquitetura de formas que você não espera.
Divida tarefas grandes em unidades atômicas:
Prompt ruim
Prompt melhor
"Construa um sistema de pagamento"
"Escreva a função create_payment_intent"
"Refatore todo o módulo de usuário"
"Refatore get_user_by_email para usar async/await"
"Adicione logs ao app"
"Adicione logs estruturados em order_service.py"
"Escreva testes para a API"
"Escreva testes unitários em pytest para POST /api/orders"
Escopo pequeno, saída específica. Você sempre pode encadear prompts.
O contexto é tudo
O contexto é a alavanca mais poderosa que você tem. Mais contexto relevante quase sempre melhora a saída. O desafio é saber o que incluir e o que deixar de fora.
O que incluir em todo prompt
No mínimo, todo prompt não trivial deve incluir:
A linguagem e a versão: Python 3.11, TypeScript 5.2, Go 1.22
Código existente relevante: cole a função, a classe ou o arquivo que está sendo modificado
A mensagem de erro (se estiver depurando): o stack trace completo, não um resumo
O comportamento esperado: o que deveria fazer versus o que faz
Bibliotecas já em uso: o que está disponível, para que ele não invente novas
Faltar apenas um desses itens já gera uma saída que precisa de correções significativas.
Quanto contexto é demais
Existem limites de tokens, e colocar todos os arquivos do projeto em um prompt é contraproducente. O agente começa a perder o foco na tarefa real quando recebe material irrelevante em excesso.
Uma regra prática: inclua apenas o que está diretamente ligado à mudança. Se estiver modificando uma função, cole a função e suas dependências imediatas. Se estiver depurando uma rota, cole o manipulador da rota e o modelo que ele usa. Deixe de fora os módulos não relacionados.
💡 Dica avançada: use comentários para resumir o que o código omitido faz. // The UserService class handles DB reads. It has find_by_id(id) and update(id, data) methods. Isso dá ao agente a superfície da API sem gastar tokens com a implementação completa.
Depurar com agentes de IA
Agentes de IA são parceiros de depuração excepcionais quando recebem a entrada certa. O erro típico é pedir a um agente que corrija algo sem dar a ele o quadro completo.
A regra do "reproduza primeiro"
Antes de pedir a um agente que corrija um bug, inclua o caso de reprodução mínimo. Não a base de código inteira, nem uma descrição do bug. O código que de fato falha, a entrada que o dispara e a saída de erro exata.
Prompt fraco: "Minha API às vezes retorna erro 500, você pode corrigir?"
Prompt forte:
This function throws a KeyError intermittently:

def process_webhook(payload: dict) -> None:
    user_id = payload['user']['id']   # crashes when 'user' is absent
    update_subscription(user_id)

Error: KeyError: 'user'
Input that triggered it: {"event": "payment.failed", "amount": 49.99}

Fix the function to handle missing 'user' gracefully. If 'user' is absent, log a warning and return early.
O segundo prompt dá ao agente tudo o que ele precisa. A correção estará certa e seguirá sua intenção.
Quando pedir explicação ou correção
Nem toda interação deve terminar com "corrija isto". Às vezes você precisa entender o que um trecho de código faz antes de alterá-lo.
Peça uma explicação quando:
Estiver herdando código que você não escreveu
Estiver trabalhando com uma biblioteca ou framework que você não conhece
Quiser entender por que uma correção funcionou
Peça uma correção quando:
O comportamento esperado já estiver claro
Você tiver um caso de reprodução
O escopo for pequeno o bastante para verificar rapidamente
Misturar as duas coisas no mesmo prompt costuma produzir um bloco de texto que explica tudo e não muda nada. Mantenha-as separadas.
Escolher o modelo certo para código
Nem todos os modelos de linguagem têm o mesmo desempenho em tarefas de programação. As diferenças são significativas, e usar o modelo errado para uma tarefa adiciona atrito ao seu fluxo de trabalho.
A contrapartida entre velocidade e precisão
Modelos menores e mais rápidos são excelentes para:
Sugestões de autocompletar
Funções utilitárias simples
Conversões rápidas de formato
Geração de código repetitivo (boilerplate)
Modelos maiores e mais capazes valem a latência extra para:
Decisões de arquitetura
Problemas algorítmicos complexos
Depuração de condições de corrida sutis
Refatoração com restrições rígidas
O objetivo é alinhar a capacidade do modelo à complexidade da tarefa. Usar um modelo de raciocínio de fronteira para renomear uma variável é desperdício. Usar um modelo pequeno e rápido para projetar uma estratégia de cache distribuído é um erro.
Modelos criados para tarefas de programação
Vários modelos disponíveis no PicassoIA são especialmente fortes em geração de código e raciocínio. O Claude 4 Sonnet foi criado para programação precisa e para seguir instruções, o que o torna uma das melhores escolhas para fluxos de programação com agentes. O Claude 4.5 Sonnet amplia isso com capacidades de depuração mais fortes em várias linguagens.
Para desenvolvedores que querem um raciocínio forte junto com a geração de código, o DeepSeek R1 lida bem com a decomposição passo a passo de problemas antes de produzir a saída. O Kimi K2 Instruct é outra opção sólida, bem avaliado em tarefas de raciocínio e programação.
Se você precisa de modelos especializados em código, treinados especificamente com conjuntos de dados de programação, vale testar o Granite 8B Code Instruct 128K e o Granite 20B Code Instruct 8K, ambos da IBM. Os dois são ajustados para completar código e seguir instruções em um contexto de programação.
Para tarefas amplas que combinam escrita, análise e geração de código, o GPT 5.1 e o Kimi K2.6 oferecem recursos flexíveis para criar agentes. O Kimi K2.6 é projetado especialmente para tarefas de agentes de IA em várias etapas, nas quais raciocínio e saída de código precisam funcionar juntos.
Exemplos reais que entregam código limpo
Conselhos abstratos são difíceis de aplicar. Estes são exemplos concretos de antes e depois que mostram como a qualidade do prompt afeta diretamente a qualidade do código.
Refatorar uma função
Antes: "Refatore esta função para deixá-la mais limpa"
Depois:
Refactor the following Python function. Requirements:
1. Extract the database query into a separate helper called _fetch_user_records
2. Replace the nested if/else with early returns
3. Add type annotations to all parameters and return value
4. Do not change the external behavior or function signature

Current code:
[paste function here]
A saída do segundo prompt não exige nenhuma reescrita. Ela segue exatamente os requisitos que você declarou, porque você os declarou.
Escrever testes do zero
Testes são onde agentes de programação com IA agregam um valor enorme, quando recebem o prompt certo. A abordagem é especificar quais comportamentos testar, não apenas qual arquivo testar.
Fraco: "Escreva testes para o serviço de usuário"
Forte:
Write pytest tests for UserService.create_user in src/services/user_service.py.

Test these specific cases:
1. Successful creation returns a user dict with 'id', 'email', and 'created_at' keys
2. Duplicate email raises DuplicateUserError
3. Invalid email format raises ValidationError
4. Missing required fields raises MissingFieldError

Mock the database with unittest.mock.patch. Do not write integration tests.
O segundo prompt produz quatro casos de teste focados e significativos, que cobrem os modos de falha reais da função, sem nenhum pós-processamento da sua parte.
Iterar sem recomeçar
Uma habilidade subestimada é o prompt iterativo: refinar a saída sem abandonar o contexto da conversa. Em vez de regenerar tudo do zero quando a saída está quase certa, peça a correção diretamente:
"A função está correta, mas mude o tratamento de erros para usar exceções personalizadas de src/exceptions.py em vez das integradas"
"Mantenha tudo igual, mas renomeie todas as variáveis para seguir snake_case"
"Adicione docstrings no formato Google a todas as funções que você escreveu"
Correções iterativas preservam o que funcionou e mudam apenas o que não funcionou. Isso é ordens de grandeza mais rápido do que iniciar uma nova sessão toda vez que a saída erra um detalhe.
Como as equipes usam agentes de programação com eficiência
Usar sozinho é uma coisa. Quando uma equipe compartilha fluxos de programação com IA, algumas práticas separam as equipes de alta produtividade das caóticas.
Modelos de prompt compartilhados
As melhores equipes criam modelos de prompt reutilizáveis para tarefas repetidas. Um modelo para "adicionar um novo endpoint de API" pode incluir campos para o caminho da rota, o método HTTP, o esquema da requisição, o esquema da resposta e os requisitos de autenticação. Novos membros da equipe preenchem as lacunas e recebem uma saída consistente e no padrão a cada vez.
Isso elimina a variação que acontece quando cinco desenvolvedores pedem a "mesma coisa" de cinco formas completamente diferentes e recebem cinco implementações estruturalmente distintas.
Revisar antes do merge
Código gerado por IA precisa ser revisado com o mesmo rigor do código escrito por humanos. O agente não conhece seus requisitos de segurança, a sensibilidade dos seus dados nem os casos-limite do seu negócio. Ele escreve código que parece correto. Seu trabalho é verificar se ele está correto.
💡 Hábito crítico: nunca faça merge de código gerado por IA sem executá-lo na sua suíte de testes real. O agente otimiza para produzir código que se lê bem, não código que trata os casos-limite específicos da sua produção.
Bibliotecas de prompts como ativo da equipe
Documente os prompts que produzem bons resultados de forma consistente. Compartilhe-os na wiki ou no repositório da equipe. Um prompt que gera de forma confiável migrações de banco de dados corretas para a sua stack vale mais do que qualquer trecho de código individual que ele produz. O prompt é o ativo reutilizável. O código é a saída.
Experimente estes padrões no PicassoIA
Cada dica deste artigo é aplicável de imediato. Você não precisa de novas ferramentas. Não precisa mudar seu editor. Precisa escrever prompts melhores, e prompts melhores começam com especificidade, estrutura e contexto.
O PicassoIA dá acesso direto aos modelos discutidos aqui, lado a lado, sem trocar de plataforma. Seja para o raciocínio profundo do Claude 4 Sonnet, o treinamento específico para código do Granite 8B Code Instruct 128K ou as capacidades de criação de agentes do Kimi K2.6, você pode rodar exatamente o mesmo prompt em vários modelos e comparar a qualidade da saída em segundos.
Comece com uma função em que você está trabalhando agora. Aplique o formato papel + tarefa + restrição. Inclua o código existente relevante como contexto. Especifique o formato de saída esperado. Depois compare esse resultado com o que o seu prompt vago anterior teria produzido. A diferença será óbvia, e o hábito vai ficar.
Seu agente de programação só é tão eficaz quanto as instruções que você dá a ele. Dê instruções melhores e entregue um software melhor.