Stable Diffusion est depuis des années le moteur de la génération d’images open source. Mais la sortie de Stable Diffusion 3.5 par Stability AI a complètement changé la donne. Il ne s’agit ni d’une simple mise à jour incrémentale ni d’un coup de peinture marketing. SD 3.5 repose sur une architecture fondamentalement différente, propose trois variantes aux forces réellement distinctes et atteint un niveau de photoréalisme qui réduit l’écart avec les modèles commerciaux fermés. Si vous attendiez que la génération d’images par IA open source rattrape les meilleurs outils propriétaires, c’est le moment.
Ce qu’est vraiment SD 3.5
Stable Diffusion 3.5 est une famille de modèles texte vers image publiés par Stability AI en octobre 2024. Le terme « famille » est important ici. Contrairement aux versions précédentes, livrées sous la forme d’un modèle unique, SD 3.5 existe en trois configurations conçues pour différentes configurations matérielles et différents usages. La base commune est l’architecture Multimodal Diffusion Transformer, ou MMDiT-X, qui traite ensemble les tokens de texte et d’image plutôt que séparément.
Ce traitement conjoint est ce qui distingue SD 3.5 des approches de diffusion antérieures. Dans des modèles comme SD 1.5 ou SDXL, l’encodeur de texte produisait un embedding, que le U-Net consultait à différentes étapes. Dans MMDiT-X, les tokens textuels et visuels interagissent simultanément dans les mêmes couches d’attention. Le résultat est un modèle qui répond plus directement au langage du prompt, gère mieux les prompts complexes à plusieurs sujets et génère du texte dans les images avec une précision bien supérieure.
De SD 1.x à SD 3.5
L’évolution des modèles Stable Diffusion raconte une histoire claire. SD 1.5 a démocratisé la génération open source, mais peinait à obtenir une anatomie cohérente et à gérer les prompts complexes. SDXL a nettement amélioré la résolution et le détail, et a servi de base à des dizaines de fine-tunings. SD 3 a introduit le backbone DiT (Diffusion Transformer). SD 3.5 affine ce backbone avec la variante MMDiT-X, améliore la qualité des données d’entraînement et livre des modèles réellement compétitifs face aux rendus de GPT-Image et de Midjourney.
Le saut de SDXL à SD 3.5 est plus grand que celui de SD 1.5 à SDXL. Il faut le dire clairement, car cela influe sur le choix des fine-tunings, des LoRA et des flux de travail qui valent la peine d’être développés à l’avenir.
Les trois variantes du modèle
SD 3.5 ne se présente pas comme un seul modèle, mais comme trois :
| Modèle | Paramètres | Idéal pour |
|---|
| SD 3.5 Large | 8B | Qualité maximale, prompts complexes |
| SD 3.5 Large Turbo | 8B (distillé) | Génération rapide, qualité proche de Large |
| SD 3.5 Medium | 2,5B | GPU grand public, fine-tuning facile |
La variante Medium est celle qui sera le plus probablement affinée en modèles spécialisés, car elle tient sans problème sur une carte de 10 Go de VRAM. Les variantes Large demandent un matériel plus conséquent, mais offrent des résultats nettement meilleurs sur les scènes complexes.
Les fonctionnalités de SD 3.5 qui comptent
Toutes les fonctionnalités annoncées pour un nouveau modèle ne sont pas réellement utiles en pratique. En voici celles qui le sont.
Une typographie qui fonctionne vraiment
Les modèles de diffusion précédents traitaient le texte dans les images comme un problème de texture. Ils parvenaient à approximer les lettres, mais déformaient systématiquement les mots au-delà de quelques caractères. SD 3.5 considère la génération de texte comme une compétence centrale plutôt que comme un détail ajouté après coup.
L’architecture MMDiT-X traite les tokens textuels du prompt au même niveau d’attention que les tokens spatiaux, ce qui donne au modèle une représentation interne bien plus fidèle de la forme des lettres et de leur emplacement. En pratique, vous pouvez demander à SD 3.5 Large d’inclure un panneau, une étiquette ou un titre avec une courte phrase, et obtenir un résultat lisible dès la première génération. Cela seul ouvre des cas d’usage commerciaux importants, jusqu’ici impraticables avec des modèles open source.
Un photoréalisme amélioré
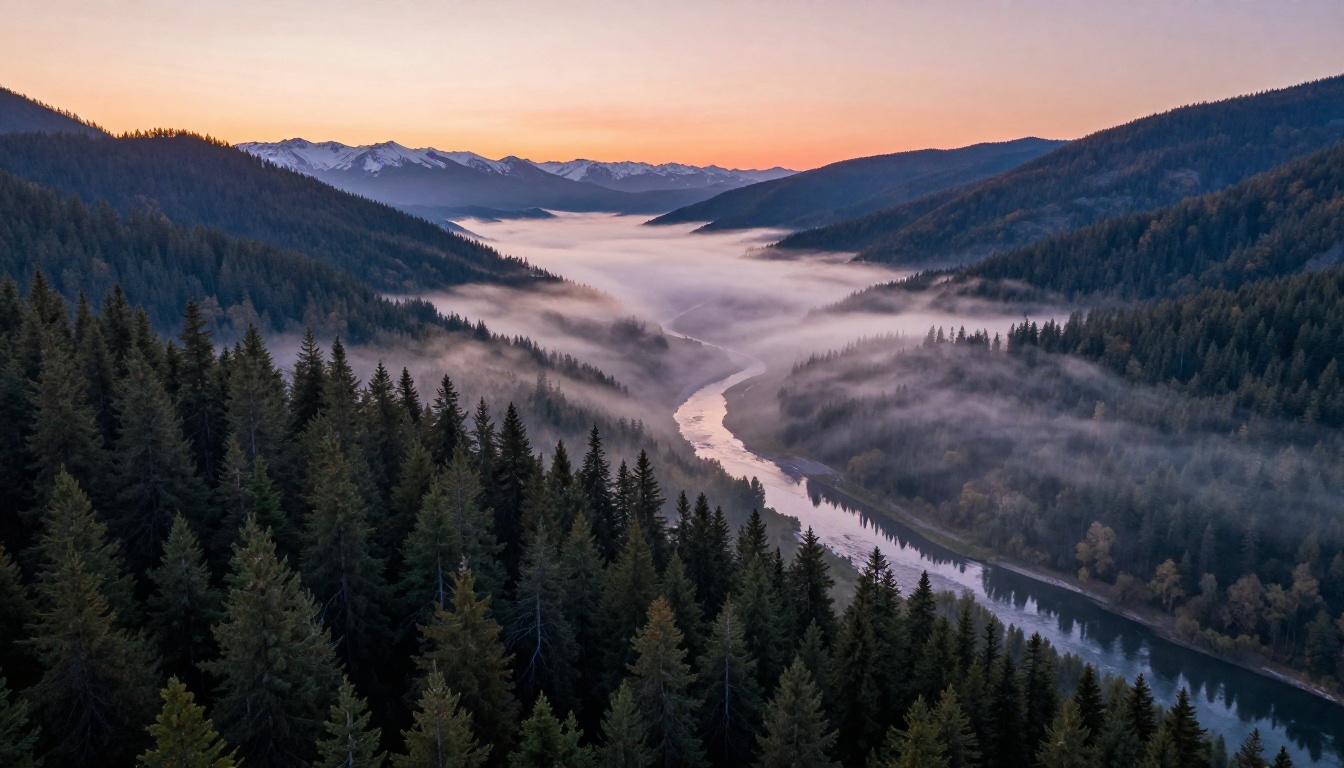
Le photoréalisme en génération d’images est une qualité bien précise. Ce n’est pas seulement la netteté ou la résolution. C’est la manière dont la lumière se comporte autour des surfaces, les subtils décalages de couleur dans les ombres, la micro-texture de la peau et du tissu, et la profondeur cohérente suggérée par les plans flous. SD 3.5 Large gère tous ces aspects nettement mieux que SDXL.
Le modèle a été entraîné sur un jeu de données de haute qualité soigneusement sélectionné, et le gain se voit dans les comparaisons. Les portraits montrent des détails de peau jusqu’au niveau du pore. Les prises de vue d’architecture ont une perspective correcte, sans artefacts de distorsion. Les images de produits présentent des propriétés de matière constantes sur l’ensemble du cadre. Pour les utilisateurs qui s’appuyaient sur des fine-tunings spécialisés comme RealVisXL v3.0 Turbo pour obtenir un rendu photoréaliste avec SDXL, le modèle de base SD 3.5 Large part d’un niveau nettement plus élevé.
L’architecture MMDiT-X
Les fondements techniques méritent un bref coup d’œil, même si vous ne construisez pas vous-même des modèles. Les modèles de diffusion classiques basés sur un U-Net encodent l’information spatiale de manière hiérarchique. Le Multimodal Diffusion Transformer utilise à la place des couches d’attention qui permettent aux patchs de texte et d’image de s’influencer mutuellement de façon équivalente tout au long du processus de débruitage.
Cela a deux effets pratiques. D’abord, le modèle maintient une cohérence bien plus forte entre ce qui est décrit et ce qui est généré, surtout pour les scènes à plusieurs objets. Si vous demandez « un sac rouge à gauche et un sac bleu à droite », le modèle a beaucoup moins de risques de confondre les positions ou les couleurs. Ensuite, le modèle gère plus solidement les structures de prompt inhabituelles ou complexes, en traitant avec bien plus de fiabilité les positions relatives, les descriptions superposées et les concepts niés.
Large ou Medium ou Turbo
Choisir la bonne variante est une décision davantage pratique que théorique.
Quelle version choisir
SD 3.5 Large est le modèle de référence en qualité. Utilisez-le lorsque la qualité de génération est la priorité et que le temps de calcul n’est pas une contrainte. Il produit le détail le plus fin, le meilleur respect du prompt et le rendu de texte le plus fiable.
SD 3.5 Large Turbo est distillé à partir du modèle Large par entraînement adversarial. Il peut produire des images de haute qualité en quatre à huit étapes, au lieu de vingt à trente. L’écart de qualité avec le modèle Large complet se voit à l’inspection rapprochée, mais reste minime pour la plupart des usages concrets. Utilisez-le lorsque vous avez besoin d’itérations plus rapides sans redescendre au niveau Medium.
SD 3.5 Medium est la cible idéale pour le fine-tuning. Son nombre de 2,5 milliards de paramètres permet de l’entraîner sur du matériel grand public, ce qui a déjà donné naissance à une vague de fine-tunings communautaires visant des styles, des visages et des catégories de produits précis. Sa qualité est nettement inférieure à celle des variantes Large sur les prompts complexes, mais pour des tâches spécialisées et ciblées, un fine-tuning Medium bien entraîné peut surpasser le modèle Large de base.
Compromis entre vitesse et qualité
💡 Recommandation pratique : pour les rendus finaux de production, utilisez SD 3.5 Large. Pour le prototypage rapide ou lorsque vous avez besoin de dizaines de variations, utilisez Large Turbo. Pour les modèles spécialisés affinés sur un matériel limité, utilisez Medium.
Le nombre d’étapes compte beaucoup avec ces modèles. Lancer SD 3.5 Large à 20 étapes donne un résultat nettement meilleur qu’à 10 étapes. Contrairement à certains modèles précédents dont la courbe de qualité s’aplatit rapidement, SD 3.5 profite de toute la plage d’étapes recommandée lorsque le détail maximal est visé.
Bien rédiger ses prompts pour SD 3.5
SD 3.5 traite les prompts différemment des modèles basés sur un U-Net. Les stratégies de prompting qui fonctionnaient bien avec SD 1.5 et SDXL restent en partie valables, mais la nouvelle architecture récompense d’autres habitudes.
Une structure de prompt efficace
SD 3.5 répond bien aux descriptions en langage naturel, plutôt qu’aux listes de tags séparés par des virgules qui dominaient le prompting de SDXL. Vous pouvez écrire une phrase comme « une femme debout dans une cuisine ensoleillée, regardant par la fenêtre, photoréaliste, lumière du matin venant de la gauche » et obtenir des résultats cohérents.
Cela dit, les modificateurs de qualité restent utiles. Les termes suivants améliorent de manière fiable la qualité du rendu :
- photoréaliste, hyperréaliste, 8K
- éclairage cinématographique, lumière volumétrique
- mise au point nette, grain de film, Kodak Portra 400
- objectif 85 mm, profondeur de champ f/1.8
- photo RAW, détail élevé
Pour les sujets dotés de détails physiques précis, décrivez-les tôt dans le prompt. Le modèle accorde davantage d’attention aux concepts qui apparaissent plus tôt dans la séquence de tokens. Vos éléments les plus importants doivent donc venir en premier.
Les prompts négatifs fonctionnent toujours
Malgré les changements d’architecture, les prompts négatifs restent efficaces. Les exclusions courantes comme deformed, blurry, low quality, cartoon, illustration, watermark continuent de supprimer ces qualités de manière fiable. Pour les portraits en particulier, ajouter plastic skin, airbrushed, smooth skin, uncanny valley au prompt négatif permet de garder une texture de visage naturelle plutôt que sur-traitée.
Une différence notable avec SDXL : SD 3.5 est nettement moins sujet aux erreurs d’anatomie, ce qui signifie que la liste de prompts négatifs concernant les parties du corps peut être plus courte, voire omise dans de nombreux cas.
Utiliser SD 3.5 sur PicassoIA
Stable Diffusion 3.5 Large est disponible directement sur PicassoIA, ce qui vous permet de l’utiliser sans installation locale, sans configuration GPU ni environnement Python.
Pas à pas avec SD 3.5 Large
Étape 1 : ouvrez la page du modèle
Rendez-vous sur Stable Diffusion 3.5 Large sur PicassoIA. L’interface se charge directement dans votre navigateur, sans compte nécessaire pour commencer.
Étape 2 : rédigez votre prompt
Dans le champ du prompt, décrivez votre image en langage naturel. Commencez par le sujet principal, puis l’environnement, puis l’éclairage, puis les modificateurs de style. Restez entre 50 et 150 mots pour de meilleurs résultats. Des prompts plus courts peuvent fonctionner, mais ils tendent à produire un rendu générique.
Étape 3 : réglez vos paramètres
Les paramètres à ajuster :
- Steps : réglez sur 28 à 40 pour une qualité maximale. Réglez sur 8 à 12 pour la vitesse avec Large Turbo.
- CFG Scale : 3,5 à 4,5 est la valeur idéale pour SD 3.5. Monter plus haut peut provoquer une saturation excessive et l’apparition d’artefacts.
- Format : 16:9 pour le paysage, 9:16 pour le portrait, 1:1 pour les formats carrés.
Étape 4 : ajoutez un prompt négatif
Même avec un prompt positif propre, ajoutez des exclusions de qualité de base : blurry, low quality, distorted, watermark, text, deformed
Étape 5 : générez et itérez
Lancez votre première génération. Si le résultat est proche sans être parfait, ajustez des descripteurs précis plutôt que de réécrire tout le prompt. De petites modifications, comme ajouter « éclairage de contour doux venant de la droite » ou remplacer « photoréaliste » par « photographie hyperréaliste », peuvent changer sensiblement le rendu.
Paramètres à ajuster
💡 Conseil CFG : SD 3.5 a été calibré pour des valeurs de CFG plus basses que SDXL. Si vos résultats sont sursaturés ou trop accentués, baissez votre CFG de 7 à 4 et relancez la génération.
Le paramètre seed vous permet de reproduire des résultats identiques. Lorsque vous obtenez une génération qui vous plaît, notez la valeur du seed. Vous pouvez la réutiliser avec de légères variations de prompt pour créer des variantes cohérentes d’une même scène. C’est utile pour des séries d’images de produits ou pour la cohérence des personnages sur plusieurs images.
Pour le sampler, DPM++ 2M Karras et Euler a fonctionnent bien avec SD 3.5. Le modèle est moins sensible au choix du sampler que ne l’était SD 1.5, mais DPM++ tend à produire des dégradés légèrement plus doux pour les portraits, tandis qu’Euler a peut donner des contours plus nets pour les photos d’architecture et de produits.
SD 3.5 face aux autres modèles
Choisir entre les modèles revient à adapter l’outil à la tâche. SD 3.5 n’est pas le meilleur choix pour tout.
SDXL a toujours sa place
SDXL Lightning 4Step et les fine-tunings SDXL spécialisés, construits autour d’esthétiques précises, produisent encore des rendus distinctifs que SD 3.5 ne reproduit pas exactement. L’écosystème SDXL compte des milliers de LoRA entraînés sur des styles artistiques, des visages et des types de produits précis. Si votre flux de travail dépend d’un LoRA spécifique qui n’a pas encore été porté sur SD 3.5, SDXL reste le choix pratique.
Stable Diffusion (le modèle original basé sur 1.5) conserve une communauté fidèle, grâce à ses caractéristiques esthétiques propres et au volume considérable de fine-tunings construits dessus. Pour les styles proches de l’animé et l’illustration artistique, l’écosystème 1.5 continue de produire des résultats compétitifs, malgré l’ancienneté de son modèle de base.
Là où Flux l’emporte
Flux Dev et Flux Pro, de Black Forest Labs, sont la principale alternative concurrente à SD 3.5 dans l’espace des poids ouverts. Flux tend à produire de meilleurs résultats pour la photographie d’architecture, les images de produits avec un détail géométrique précis et toute scène exigeant des relations spatiales très exactes. SD 3.5 Large conserve un avantage pour la photographie de portrait et les sujets humains, où la composition de ses données d’entraînement se traduit par une nette supériorité sur le détail du visage et la fidélité de la texture de la peau.
La comparaison honnête : aucun des deux modèles ne domine toutes les catégories. Utiliser les deux via PicassoIA ne demande aucune installation, donc tester les deux sur votre cas d’usage précis est la démarche la plus directe.
| Cas d’usage | Modèle recommandé |
|---|
| Photographie de portrait | SD 3.5 Large |
| Architecture et intérieurs | Flux Dev |
| Photos de produits | SD 3.5 Large ou Flux |
| Texte dans l’image | SD 3.5 Large |
| Itération rapide | SD 3.5 Large Turbo |
| Style animé / illustration | Fine-tunings SDXL |
| Fine-tuning sur GPU grand public | SD 3.5 Medium |
Cas d’usage concrets
Les fonctionnalités décrites ci-dessus se traduisent en applications créatives concrètes, difficiles ou impossibles à réaliser avec les modèles open source précédents.
Photographie de portrait
SD 3.5 Large produit des portraits dont les détails de peau, de cheveux et d’yeux rivalisent avec la photographie de studio. Le modèle gère bien les dispositifs d’éclairage difficiles : éclairage en split, contre-jour sur fond sombre, lumière naturelle de fenêtre avec ombres douces. Pour les usages commerciaux de portrait, comme les photos de profil pour les sites web, l’imagerie de mode ou les références de personnages, il produit des rendus directement utilisables sans retouche poussée.
La cohérence de l’anatomie d’une génération à l’autre est nettement meilleure qu’avec SDXL. Les mains, qui posaient des problèmes notoires aux modèles précédents, sont rendues avec le bon nombre de doigts et des poses naturelles dans une grande proportion de générations, sans contournement par prompt négatif.
Photos de produits
La photographie de produit est l’un des cas d’usage de la génération d’images par IA qui progressent le plus vite dans les flux de travail professionnels. Le photoréalisme amélioré de SD 3.5 fait que les images de produits paraissent placées dans de vrais environnements plutôt que composées après coup. Le modèle gère les surfaces réfléchissantes, les matériaux transparents et les environnements d’arrière-plan complexes, avec un éclairage constant sur la surface du produit.
Associées aux progrès du rendu de texte, les étiquettes de marque ou les enseignes peuvent figurer dans vos images de produits avec un résultat lisible. Une bouteille avec une étiquette, un livre avec un titre, un paquet avec un nom de marque : tout cela est réalisable avec SD 3.5 Large, là où les modèles précédents auraient produit des approximations illisibles.
Œuvres créatives
Pour les travaux créatifs non photoréalistes, SD 3.5 combiné à un prompting de style approprié produit des textures de peinture à l’huile, des esthétiques de photographie argentique et des styles d’illustration éditoriale à la fois de grande qualité et distinctifs. La meilleure adhésion aux prompts permet aux compositions de scènes complexes à plusieurs sujets en interaction de coller de près à l’intention décrite, ce qui ouvre la voie à des briefs créatifs plus ambitieux.
Le caractère à poids ouverts de SD 3.5 signifie aussi que la communauté créative a déjà commencé à affiner la variante Medium pour des styles artistiques précis, et cette bibliothèque de fine-tunings ne fera que s’étoffer à mesure que le modèle mûrira. Les artistes qui veulent une esthétique précise peuvent attendre un fine-tuning communautaire ou en entraîner un eux-mêmes à partir de la base Medium.
Commencez à générer avec SD 3.5 dès maintenant
Toutes les fonctionnalités décrites dans cet article sont immédiatement accessibles sur PicassoIA, sans installation locale, sans environnement Python et sans GPU. Le modèle Stable Diffusion 3.5 Large est prêt à l’emploi directement dans votre navigateur.
Au-delà de SD 3.5, PicassoIA vous donne accès à Stable Diffusion 3, Flux Dev, Flux Pro, RealVisXL v3.0 Turbo et plus de 90 autres modèles texte vers image, réunis au même endroit. Vous pouvez comparer les rendus de plusieurs modèles sans changer de plateforme, ce qui est le moyen le plus rapide de trouver ce qui fonctionne vraiment pour votre sujet et vos exigences de style.
Commencez par le prompt que vous avez en tête, lancez-le d’abord avec SD 3.5 Large, puis comparez avec une ou deux alternatives. Après quelques séries de tests, l’association entre modèle et tâche devient intuitive. Le plancher de qualité de la génération open source a nettement progressé avec SD 3.5, et la meilleure façon de le constater est de générer une image vous-même.


