सालों से Stable Diffusion ओपन-सोर्स इमेज जनरेशन की धड़कन रहा है। लेकिन Stability AI का Stable Diffusion 3.5 जारी होने से बातचीत पूरी तरह बदल गई। यह कोई छोटा सुधार या मार्केटिंग का नया रंग-रोगन नहीं है। SD 3.5 एक बिल्कुल अलग आर्किटेक्चर, तीन अलग मॉडल वर्ज़न, जिनकी ताकतें सच में अलग हैं, और ऐसा फोटोरियलिज़्म लाता है जो क्लोज़्ड-सोर्स कमर्शियल मॉडल्स के अंतर को कम कर देता है। अगर आप इंतज़ार कर रहे थे कि ओपन-सोर्स AI इमेज जनरेशन सबसे बेहतरीन प्रोप्राइटरी टूल्स के बराबर पहुँचे, तो यही वह पल है।
SD 3.5 असल में क्या है
Stable Diffusion 3.5 टेक्स्ट-टू-इमेज मॉडल्स का एक परिवार है, जिसे Stability AI ने अक्टूबर 2024 में जारी किया। यहाँ "परिवार" शब्द मायने रखता है। पहले के रिलीज़ एक ही मॉडल के रूप में आए थे, जबकि SD 3.5 तीन कॉन्फ़िगरेशन में आता है, जो अलग-अलग हार्डवेयर सेटअप और इस्तेमाल के लिए बने हैं। इसका साझा आधार Multimodal Diffusion Transformer आर्किटेक्चर है, या MMDiT-X, जो टेक्स्ट और इमेज टोकन को अलग-अलग नहीं, बल्कि एक साथ प्रोसेस करता है।
यही जॉइंट प्रोसेसिंग SD 3.5 को पिछले डिफ्यूज़न तरीकों से अलग करती है। SD 1.5 या SDXL जैसे मॉडल्स में टेक्स्ट एन्कोडर एक एम्बेडिंग बनाता था, और U-Net अलग-अलग चरणों में उस एम्बेडिंग को देखता था। MMDiT-X में टेक्स्ट और विज़ुअल टोकन एक ही attention लेयर्स के ज़रिए एक साथ एक-दूसरे पर असर डालते हैं। नतीजा यह है कि मॉडल प्रॉम्प्ट की भाषा पर ज़्यादा सीधे प्रतिक्रिया देता है, जटिल कई-सब्जेक्ट वाले प्रॉम्प्ट को कम उलझन के साथ संभालता है, और इमेज के अंदर टेक्स्ट को कहीं ज़्यादा सटीकता से जनरेट करता है।
SD 1.x से SD 3.5 तक
Stable Diffusion मॉडल्स का सफ़र एक साफ़ कहानी कहता है। SD 1.5 ने आसान ओपन-सोर्स जनरेशन दिया, लेकिन सुसंगत एनाटॉमी और जटिल प्रॉम्प्ट में उसे दिक्कत होती थी। SDXL ने रिज़ॉल्यूशन और डिटेल में काफ़ी सुधार किया और दर्जनों फ़ाइन-ट्यून्स की नींव रखी। SD 3 ने DiT (Diffusion Transformer) बैकबोन पेश किया। SD 3.5 उसी बैकबोन को MMDiT-X वर्ज़न से निखारता है, ट्रेनिंग डेटा की क्वालिटी सुधारता है, और ऐसे मॉडल देता है जो GPT-Image और Midjourney के आउटपुट से सच में टक्कर लेते हैं।
SDXL से SD 3.5 तक की छलांग, SD 1.5 से SDXL तक की छलांग से बड़ी है। यह साफ़ तौर पर कहना ज़रूरी है, क्योंकि इससे तय होता है कि आगे कौन से फ़ाइन-ट्यून्स, LoRA और वर्कफ़्लो बनाने लायक हैं।
तीन मॉडल वर्ज़न
SD 3.5 एक मॉडल की तरह नहीं, बल्कि तीन के रूप में आता है:
| मॉडल | पैरामीटर | सबसे अच्छा किसके लिए |
|---|
| SD 3.5 Large | 8B | सबसे अच्छी क्वालिटी, जटिल प्रॉम्प्ट |
| SD 3.5 Large Turbo | 8B (distilled) | तेज़ जनरेशन, Large के लगभग बराबर क्वालिटी |
| SD 3.5 Medium | 2.5B | कंज़्यूमर GPU, फ़ाइन-ट्यूनिंग के लिए अनुकूल |
Medium वर्ज़न वह है जिसे समय के साथ विशेष मॉडल्स में फ़ाइन-ट्यून किए जाने की सबसे ज़्यादा संभावना है, क्योंकि यह 10GB VRAM वाले कार्ड पर आराम से फ़िट हो जाता है। Large वर्ज़न को ज़्यादा मज़बूत हार्डवेयर चाहिए, लेकिन जटिल दृश्यों पर वे साफ़ तौर पर बेहतर नतीजे देते हैं।
SD 3.5 के वे फ़ीचर जो मायने रखते हैं
किसी नए मॉडल का हर सूचीबद्ध फ़ीचर व्यवहार में सच में अहम नहीं होता। ये वाले अहम होते हैं।
ऐसी टाइपोग्राफ़ी जो सच में काम करती है
पहले के डिफ्यूज़न मॉडल्स इमेज के अंदर टेक्स्ट को टेक्सचर की समस्या मानते थे। वे अक्षरों के आकार का अनुमान लगा सकते थे, लेकिन कुछ अक्षरों से आगे के शब्द लगातार बिगाड़ देते थे। SD 3.5 टेक्स्ट जनरेशन को बाद की सोच नहीं, बल्कि अपनी मुख्य क्षमता मानता है।
MMDiT-X आर्किटेक्चर प्रॉम्प्ट के टेक्स्ट टोकन को स्पेस वाले टोकन के उसी attention स्तर पर प्रोसेस करता है। इसका मतलब है कि मॉडल के पास इस बात का कहीं बेहतर आंतरिक प्रतिनिधित्व है कि अक्षर कैसे दिखने चाहिए और उन्हें कहाँ आना चाहिए। व्यवहार में, आप SD 3.5 Large से किसी साइन, लेबल या टाइटल कार्ड में एक छोटा वाक्य शामिल करने को कह सकते हैं और पहली ही जनरेशन में पढ़ने लायक नतीजा पा सकते हैं। यह अकेले ही उन कमर्शियल उपयोगों के दरवाज़े खोलता है, जो पहले ओपन-सोर्स मॉडल्स के साथ व्यावहारिक नहीं थे।
बेहतर फोटोरियलिज़्म
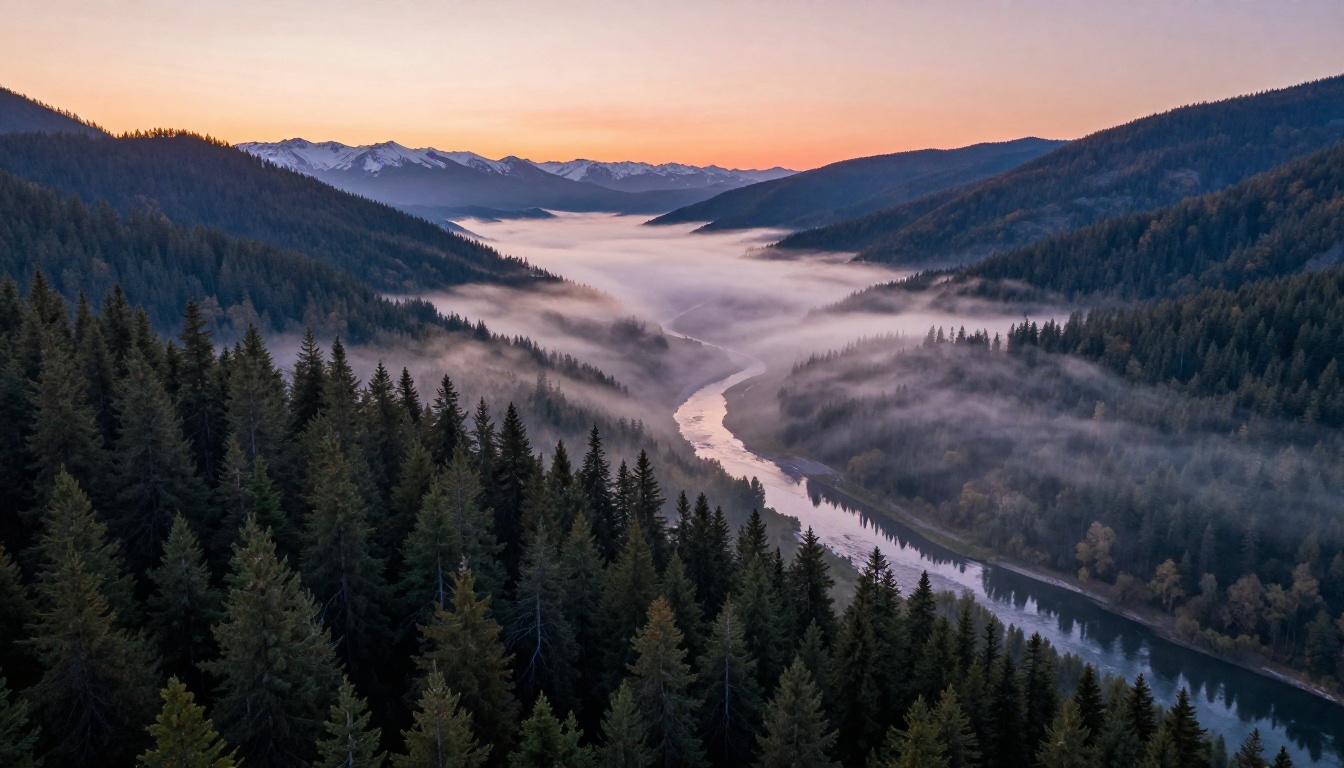
इमेज जनरेशन में फोटोरियलिज़्म एक खास गुण है। यह सिर्फ़ शार्पनेस या रिज़ॉल्यूशन नहीं है। यह इस बात में है कि सतहों के आसपास रोशनी कैसे बर्ताव करती है, परछाइयों में रंगों के सूक्ष्म बदलाव, त्वचा और कपड़े की माइक्रो-टेक्सचर, और आउट-ऑफ़-फ़ोकस हिस्सों से झलकती सुसंगत गहराई। SD 3.5 Large इन सबको SDXL से साफ़ तौर पर बेहतर संभालता है।
इस मॉडल को एक चुने हुए उच्च-गुणवत्ता डेटासेट पर ट्रेन किया गया है, और तुलनाओं में क्वालिटी में यह उछाल दिखता है। पोर्ट्रेट में त्वचा पर पोर-लेवल डिटेल दिखती है। आर्किटेक्चर शॉट्स में विकृति वाले आर्टिफ़ैक्ट्स के बिना सही परस्पेक्टिव है। प्रोडक्ट इमेज में पूरे फ़्रेम में मटेरियल के गुण एक समान दिखते हैं। जो यूज़र SDXL से फोटोरियलिस्टिक आउटपुट पाने के लिए RealVisXL v3.0 Turbo जैसे खास फ़ाइन-ट्यून्स पर निर्भर थे, उनके लिए SD 3.5 Large का बेस मॉडल कहीं ऊँचे स्तर से शुरू होता है।
MMDiT-X आर्किटेक्चर
तकनीकी आधार पर एक संक्षिप्त नज़र डालना उपयोगी है, भले ही आप खुद मॉडल न बना रहे हों। पारंपरिक U-Net आधारित डिफ्यूज़न मॉडल स्पेस की जानकारी को पदानुक्रमित तरीके से एन्कोड करते हैं। इसके उलट Multimodal Diffusion Transformer attention लेयर्स इस्तेमाल करता है, जो डीनॉइज़िंग प्रक्रिया के दौरान टेक्स्ट और इमेज पैच को एक-दूसरे को बराबर प्रभावित करने देते हैं।
इसके दो व्यावहारिक असर हैं। पहला, मॉडल जो वर्णित किया गया है और जो जनरेट होता है, उनके बीच कहीं मज़बूत सुसंगति बनाए रखता है, खासकर कई ऑब्जेक्ट वाले दृश्यों में। अगर आप "बाईं ओर एक लाल बैग और दाईं ओर एक नीला बैग" माँगते हैं, तो मॉडल के पोज़िशन या रंग गड़बड़ाने की संभावना काफ़ी कम होती है। दूसरा, मॉडल असामान्य या जटिल प्रॉम्प्ट संरचनाओं को ज़्यादा मज़बूती से संभालता है, जिसमें सापेक्ष पोज़िशनिंग, लेयर्ड विवरण और नकारात्मक अवधारणाएँ शामिल हैं, और इन सबमें कहीं ज़्यादा भरोसेमंद रहता है।
Large बनाम Medium बनाम Turbo
सही वर्ज़न चुनना सैद्धांतिक से ज़्यादा व्यावहारिक फ़ैसला है।
कौन सा वर्ज़न चुनें
SD 3.5 Large संदर्भ क्वालिटी वाला मॉडल है। इसे तब इस्तेमाल करें जब जनरेशन की क्वालिटी प्राथमिकता हो और कंप्यूट समय कोई बाधा न हो। यह सबसे तीखी डिटेल, सबसे बेहतर प्रॉम्प्ट अनुपालन और सबसे भरोसेमंद टेक्स्ट रेंडरिंग देता है।
SD 3.5 Large Turbo को adversarial training से Large मॉडल से distill किया गया है। यह बीस-तीस स्टेप्स के बजाय चार से आठ स्टेप्स में उच्च-गुणवत्ता वाली इमेज बना सकता है। पूरे Large मॉडल की तुलना में क्वालिटी का अंतर करीब से जाँचने पर दिखता है, लेकिन ज़्यादातर व्यावहारिक आउटपुट के लिए यह बहुत कम है। इसे तब इस्तेमाल करें जब आपको Medium टियर पर उतरे बिना तेज़ इटरेशन चाहिए।
SD 3.5 Medium फ़ाइन-ट्यूनिंग का लक्ष्य है। इसकी 2.5B पैरामीटर संख्या का मतलब है कि इसे कंज़्यूमर हार्डवेयर पर ट्रेन किया जा सकता है, जिससे पहले ही कम्युनिटी फ़ाइन-ट्यून्स की लहर आ चुकी है, जो खास स्टाइल, चेहरों और प्रोडक्ट श्रेणियों को लक्ष्य बनाते हैं। जटिल प्रॉम्प्ट पर यह Large वर्ज़न से साफ़ तौर पर कम क्वालिटी देता है, लेकिन केंद्रित विशेष कामों के लिए एक अच्छी तरह ट्रेन किया गया Medium फ़ाइन-ट्यून बेस Large मॉडल से बेहतर प्रदर्शन कर सकता है।
स्पीड बनाम क्वालिटी के समझौते
💡 व्यावहारिक दिशा-निर्देश: अंतिम प्रोडक्शन आउटपुट के लिए SD 3.5 Large का इस्तेमाल करें। त्वरित प्रोटोटाइपिंग या जब आपको दर्जनों वेरिएशन चाहिए, तब Large Turbo का इस्तेमाल करें। सीमित हार्डवेयर पर खास फ़ाइन-ट्यून्ड मॉडल्स के लिए Medium का इस्तेमाल करें।
इन मॉडल्स के साथ स्टेप काउंट का काफ़ी असर पड़ता है। SD 3.5 Large को 20 स्टेप पर चलाने से 10 स्टेप की तुलना में साफ़ तौर पर बेहतर आउटपुट मिलता है। कुछ पुराने मॉडल्स के उलट जहाँ क्वालिटी कर्व जल्दी समतल हो जाता है, SD 3.5 अधिकतम डिटेल का लक्ष्य होने पर अनुशंसित स्टेप रेंज का पूरा लाभ उठाता है।
SD 3.5 के लिए बेहतर प्रॉम्प्ट लिखना
SD 3.5 प्रॉम्प्ट को U-Net आधारित मॉडल्स से अलग तरीके से प्रोसेस करता है। SD 1.5 और SDXL के लिए जो प्रॉम्प्ट रणनीतियाँ अच्छी तरह काम करती थीं, वे आंशिक रूप से यहाँ भी लागू होती हैं, लेकिन नया आर्किटेक्चर अलग आदतों को पुरस्कृत करता है।
प्रॉम्प्ट की संरचना जो काम करती है
SD 3.5 प्राकृतिक भाषा के विवरण पर अच्छी प्रतिक्रिया देता है, न कि उन कॉमा-सेपरेटेड टैग सूचियों पर जो SDXL प्रॉम्प्टिंग पर हावी थीं। आप "धूप वाली रसोई में खिड़की से बाहर देखती एक महिला, फोटोरियलिस्टिक, बाईं ओर से सुबह की रोशनी" जैसा वाक्य लिख सकते हैं और सुसंगत नतीजे पा सकते हैं।
फिर भी, क्वालिटी मॉडिफ़ायर मदद करते हैं। ये शब्द भरोसेमंद रूप से आउटपुट की क्वालिटी बढ़ाते हैं:
- फोटोरियलिस्टिक, हाइपररियलिस्टिक, 8K
- सिनेमैटिक लाइटिंग, वॉल्यूमेट्रिक लाइट
- शार्प फ़ोकस, फ़िल्म ग्रेन, Kodak Portra 400
- 85mm लेंस, f/1.8 डेप्थ ऑफ़ फ़ील्ड
- RAW फ़ोटो, हाई डिटेल
जिन सब्जेक्ट्स के शारीरिक विवरण खास हैं, उन्हें प्रॉम्प्ट में जल्दी बताएँ। मॉडल टोकन सीक्वेंस में पहले आने वाली अवधारणाओं को ज़्यादा ध्यान देता है, इसलिए आपके सबसे ज़रूरी तत्व पहले आने चाहिए।
नेगेटिव प्रॉम्प्ट अब भी काम करते हैं
आर्किटेक्चर में बदलावों के बावजूद, नेगेटिव प्रॉम्प्ट असरदार हैं। deformed, blurry, low quality, cartoon, illustration, watermark जैसे सामान्य अपवर्जन अब भी उन गुणों को भरोसेमंद तरीके से दबाते हैं। खासकर पोर्ट्रेट के लिए, नेगेटिव प्रॉम्प्ट में plastic skin, airbrushed, smooth skin, uncanny valley जोड़ने से चेहरे की बनावट ज़्यादा प्रोसेस्ड दिखने के बजाय स्वाभाविक दिखती है।
SDXL से एक उल्लेखनीय अंतर: SD 3.5 शुरू से ही एनाटॉमी की गलतियाँ काफ़ी कम करता है, इसलिए शरीर के अंगों वाली नेगेटिव प्रॉम्प्ट सूची कई मामलों में छोटी की जा सकती है या पूरी तरह छोड़ी भी जा सकती है।
PicassoIA पर SD 3.5 कैसे इस्तेमाल करें
Stable Diffusion 3.5 Large सीधे PicassoIA पर उपलब्ध है, यानी आप इसे बिना किसी लोकल इंस्टॉलेशन, GPU आवश्यकताओं या Python एनवायरनमेंट सेटअप के चला सकते हैं।
SD 3.5 Large के साथ चरण-दर-चरण
चरण 1: मॉडल पेज खोलें
PicassoIA पर Stable Diffusion 3.5 Large पर जाएँ। इंटरफ़ेस सीधे आपके ब्राउज़र में लोड होता है, और शुरू करने के लिए किसी अकाउंट की ज़रूरत नहीं है।
चरण 2: अपना प्रॉम्प्ट लिखें
प्रॉम्प्ट फ़ील्ड में अपनी इमेज को प्राकृतिक भाषा में वर्णित करें। मुख्य सब्जेक्ट से शुरू करें, फिर वातावरण, फिर रोशनी, फिर स्टाइल मॉडिफ़ायर। सबसे अच्छे नतीजों के लिए इसे 50 से 150 शब्दों के बीच रखें। छोटे प्रॉम्प्ट भी काम कर सकते हैं, लेकिन वे आम तौर पर सामान्य आउटपुट देते हैं।
चरण 3: पैरामीटर सेट करें
ये पैरामीटर एडजस्ट करें:
- Steps: अधिकतम क्वालिटी के लिए 28-40 पर सेट करें। Large Turbo के साथ स्पीड के लिए 8-12 पर सेट करें।
- CFG Scale: SD 3.5 के लिए 3.5-4.5 सबसे अच्छा बिंदु है। इससे ज़्यादा जाने पर ओवर-सैचुरेशन और आर्टिफ़ैक्ट आ सकते हैं।
- आस्पेक्ट रेशियो: लैंडस्केप के लिए 16:9, पोर्ट्रेट के लिए 9:16, स्क्वायर फ़ॉर्मेट के लिए 1:1।
चरण 4: नेगेटिव प्रॉम्प्ट जोड़ें
साफ़ पॉज़िटिव प्रॉम्प्ट के साथ भी, बुनियादी क्वालिटी अपवर्जन जोड़ें: blurry, low quality, distorted, watermark, text, deformed
चरण 5: जनरेट करें और सुधारें
पहली जनरेशन चलाएँ। अगर नतीजा करीब है पर परफ़ेक्ट नहीं, तो पूरा प्रॉम्प्ट दोबारा लिखने के बजाय खास वर्णनकर्ता बदलें। "दाईं ओर से नरम रिम लाइटिंग" जोड़ने या "photorealistic" को "hyperrealistic photograph" में बदलने जैसे छोटे बदलाव आउटपुट को काफ़ी हद तक बदल सकते हैं।
बदलने लायक पैरामीटर
💡 CFG टिप: SD 3.5 को SDXL की तुलना में कम CFG मानों के लिए कैलिब्रेट किया गया था। अगर नतीजे ओवर-सैचुरेटेड या ज़्यादा शार्प दिखें, तो CFG को 7 से घटाकर 4 करें और दोबारा जनरेट करें।
सीड पैरामीटर से आप बिल्कुल वही आउटपुट दोबारा पा सकते हैं। जब आपको कोई जनरेशन पसंद आए, तो उसकी सीड वैल्यू नोट कर लें। प्रॉम्प्ट में छोटे बदलाव करके आप उसी सीड को दोबारा इस्तेमाल कर सकते हैं और एक ही सीन के एक जैसे वेरिएशन बना सकते हैं। यह प्रोडक्ट इमेज के सेट बनाने या कई इमेज में कैरेक्टर कंसिस्टेंसी बनाए रखने के लिए उपयोगी है।
sampler के लिए, DPM++ 2M Karras और Euler a, दोनों SD 3.5 के साथ अच्छी तरह काम करते हैं। यह मॉडल sampler चुनाव के प्रति SD 1.5 जितना संवेदनशील नहीं है, लेकिन DPM++ पोर्ट्रेट के लिए थोड़े चिकने ग्रेडिएंट देता है, जबकि Euler a आर्किटेक्चरल और प्रोडक्ट शॉट्स के लिए ज़्यादा तीखे किनारे दे सकता है।
SD 3.5 बनाम दूसरे मॉडल
मॉडल चुनना टूल को काम से मिलाने की बात है। SD 3.5 हर चीज़ के लिए सबसे अच्छा विकल्प नहीं है।
SDXL की अपनी जगह अब भी है
SDXL Lightning 4Step और खास स्टाइल के आसपास बने विशेष SDXL फ़ाइन-ट्यून्स ऐसे अलग आउटपुट देते हैं, जिन्हें SD 3.5 ठीक-ठीक दोहरा नहीं पाता। SDXL इकोसिस्टम में खास आर्टिस्टिक स्टाइल, चेहरों और प्रोडक्ट प्रकारों पर ट्रेन किए गए हज़ारों LoRA हैं। अगर आपका वर्कफ़्लो किसी ऐसे खास LoRA पर निर्भर है जो अभी SD 3.5 पर पोर्ट नहीं हुआ है, तो SDXL अब भी व्यावहारिक विकल्प है।
Stable Diffusion (मूल 1.5-आधारित मॉडल) अपनी खास एस्थेटिक विशेषताओं और उस पर बने विशाल फ़ाइन-ट्यून्स की संख्या के कारण अब भी लोकप्रिय है। एनीमे-से मिलते-जुलते और कलात्मक इलस्ट्रेशन स्टाइल के लिए, बेस मॉडल की आर्किटेक्चरल उम्र के बावजूद 1.5 इकोसिस्टम अब भी प्रतिस्पर्धी नतीजे दे रहा है।
जहाँ Flux आगे है
Black Forest Labs के Flux Dev और Flux Pro ओपन-वेट्स स्पेस में SD 3.5 के मुख्य प्रतिस्पर्धी विकल्प हैं। Flux आर्किटेक्चरल फ़ोटोग्राफ़ी, सटीक ज्यामितीय डिटेल वाली प्रोडक्ट इमेज, और बहुत सटीक स्पेस संबंधों वाले किसी भी दृश्य के लिए आम तौर पर बेहतर नतीजे देता है। पोर्ट्रेट फ़ोटोग्राफ़ी और मानव सब्जेक्ट्स में SD 3.5 Large की बढ़त है, जहाँ इसकी ट्रेनिंग डेटा की संरचना चेहरे की डिटेल और त्वचा की बनावट की सटीकता में साफ़ फ़ायदा दिखाती है।
ईमानदार तुलना यह है: कोई भी मॉडल हर श्रेणी में हावी नहीं है। PicassoIA के ज़रिए दोनों का इस्तेमाल सेटअप में कोई परेशानी नहीं लाता, इसलिए अपने खास उपयोग पर दोनों को आज़माना सबसे सीधा तरीका है।
| उपयोग का मामला | अनुशंसित मॉडल |
|---|
| पोर्ट्रेट फ़ोटोग्राफ़ी | SD 3.5 Large |
| आर्किटेक्चर और इंटीरियर | Flux Dev |
| प्रोडक्ट शॉट्स | SD 3.5 Large या Flux |
| इमेज में टेक्स्ट | SD 3.5 Large |
| तेज़ इटरेशन | SD 3.5 Large Turbo |
| एनीमे / इलस्ट्रेशन स्टाइल | SDXL फ़ाइन-ट्यून्स |
| कंज़्यूमर GPU पर फ़ाइन-ट्यूनिंग | SD 3.5 Medium |
वास्तविक उपयोग के मामले
ऊपर बताए गए फ़ीचर ऐसे व्यावहारिक रचनात्मक उपयोगों में बदलते हैं, जो पहले के ओपन-सोर्स मॉडल्स के साथ या तो मुश्किल थे या असंभव।
पोर्ट्रेट फ़ोटोग्राफ़ी
SD 3.5 Large ऐसे पोर्ट्रेट इमेज बनाता है जिनमें त्वचा, बाल और आँखों की डिटेल स्टूडियो फ़ोटोग्राफ़ी से टक्कर लेती है। मॉडल चुनौतीपूर्ण रोशनी सेटअप अच्छी तरह संभालता है: स्प्लिट लाइटिंग, गहरे बैकग्राउंड के साथ रिम लाइटिंग, और नरम परछाइयों वाली प्राकृतिक खिड़की की रोशनी। वेबसाइट हेडशॉट्स, फ़ैशन इमेज या कैरेक्टर रेफ़रेंस जैसे कमर्शियल पोर्ट्रेट उपयोगों के लिए, यह बिना बड़े पोस्ट-प्रोसेसिंग के सीधे इस्तेमाल होने लायक आउटपुट देता है।
जनरेशन के बीच एनाटॉमी की सुसंगति SDXL से कहीं बेहतर है। हाथ, जो पहले के मॉडल्स के लिए बेहद मुश्किल थे, अब ज़्यादातर जनरेशन में सही उँगलियों की संख्या और स्वाभाविक मुद्राओं के साथ रेंडर होते हैं, और इसके लिए नेगेटिव प्रॉम्प्ट के किसी जुगाड़ की ज़रूरत नहीं पड़ती।
प्रोडक्ट शॉट्स
प्रोफ़ेशनल वर्कफ़्लो में AI इमेज जनरेशन के सबसे तेज़ी से बढ़ते उपयोगों में से एक प्रोडक्ट फ़ोटोग्राफ़ी है। SD 3.5 के बेहतर फोटोरियलिज़्म का मतलब है कि प्रोडक्ट इमेज असली वातावरण में रखी हुई लगती हैं, न कि उनमें बाद में जोड़ी गई लगती हैं। मॉडल चमकदार सतहों, पारदर्शी मटेरियल और जटिल बैकग्राउंड वातावरण को प्रोडक्ट की सतह पर एक समान रोशनी के साथ संभालता है।
टेक्स्ट रेंडरिंग में सुधार के साथ मिलकर, आप प्रोडक्ट इमेज में ब्रांडेड लेबल या साइनेज शामिल कर सकते हैं और पढ़ने लायक नतीजे पा सकते हैं। लेबल वाली बोतल, शीर्षक वाली किताब, ब्रांड नाम वाला पैकेज: ये सभी SD 3.5 Large के व्यावहारिक आउटपुट हैं, जहाँ पहले के मॉडल्स बिगड़े हुए अनुमान ही देते थे।
क्रिएटिव आर्टवर्क
गैर-फोटोरियलिस्टिक क्रिएटिव काम के लिए, उपयुक्त स्टाइल प्रॉम्प्टिंग के साथ SD 3.5 ऑयल पेंटिंग टेक्सचर, फ़िल्म फ़ोटोग्राफ़ी एस्थेटिक और एडिटोरियल इलस्ट्रेशन स्टाइल बनाता है, जो उच्च-गुणवत्ता वाले और विशिष्ट दोनों हैं। मॉडल का मज़बूत प्रॉम्प्ट अनुपालन मतलब है कि कई एक-दूसरे पर असर डालने वाले सब्जेक्ट्स वाली जटिल दृश्य रचनाएँ भी वर्णित इरादे के काफ़ी करीब उतरती हैं, जिससे ज़्यादा महत्वाकांक्षी क्रिएटिव ब्रीफ़ संभव होते हैं।
SD 3.5 की ओपन-वेट प्रकृति का मतलब यह भी है कि क्रिएटिव कम्युनिटी ने खास आर्टिस्टिक स्टाइल के लिए Medium वर्ज़न को फ़ाइन-ट्यून करना पहले ही शुरू कर दिया है, और मॉडल परिपक्व होने के साथ फ़ाइन-ट्यून्स की वह लाइब्रेरी और बढ़ेगी। जो आर्टिस्ट कोई खास एस्थेटिक चाहते हैं, वे या तो कम्युनिटी फ़ाइन-ट्यून का इंतज़ार कर सकते हैं या Medium बेस पर अपना खुद का ट्रेन कर सकते हैं।
अभी से SD 3.5 के साथ जनरेट करना शुरू करें
इस लेख में बताया गया हर फ़ीचर PicassoIA के ज़रिए आपको तुरंत उपलब्ध है, जिसमें कोई लोकल इंस्टॉलेशन, Python एनवायरनमेंट या GPU ज़रूरी नहीं है। Stable Diffusion 3.5 Large मॉडल आपके ब्राउज़र में सीधे इस्तेमाल के लिए तैयार है।
SD 3.5 के अलावा, PicassoIA आपको Stable Diffusion 3, Flux Dev, Flux Pro, RealVisXL v3.0 Turbo और एक ही जगह पर 90 से ज़्यादा अन्य टेक्स्ट-टू-इमेज मॉडल्स तक पहुँच देता है। आप प्लेटफ़ॉर्म बदले बिना मॉडल्स के आउटपुट की तुलना कर सकते हैं, जो आपके खास विषय और स्टाइल की ज़रूरतों के लिए वास्तव में काम करने वाला मॉडल खोजने का सबसे तेज़ तरीका है।
जो प्रॉम्प्ट आपके मन में है, उसी से शुरुआत करें, पहले उसे SD 3.5 Large पर चलाएँ, फिर एक या दो विकल्पों से तुलना करें। कुछ दौर की जाँच के बाद, मॉडल और काम का मेल अपने आप सहज लगने लगता है। SD 3.5 के साथ ओपन-सोर्स जनरेशन का क्वालिटी फ़्लोर काफ़ी ऊपर आ गया है, और इस बदलाव को देखने का सबसे अच्छा तरीका है खुद कुछ जनरेट करके देखना।


