O Stable Diffusion está no centro da geração de imagens de código aberto há anos. Mas o lançamento do Stable Diffusion 3.5, da Stability AI, mudou a conversa por completo. Esta não é uma correção incremental nem uma renovação de marketing. O SD 3.5 traz uma arquitetura fundamentalmente diferente, três variantes de modelo com pontos fortes genuinamente distintos e um nível de fotorrealismo que fecha a distância para os modelos comerciais de código fechado. Se você estava esperando que a geração de imagens por IA de código aberto alcançasse as melhores ferramentas proprietárias, este é o momento.
O que é o SD 3.5, de fato
O Stable Diffusion 3.5 é uma família de modelos de texto para imagem lançada pela Stability AI em outubro de 2024. O termo "família" importa aqui. Diferentemente de lançamentos anteriores, que vieram como um único modelo, o SD 3.5 chega em três configurações pensadas para diferentes configurações de hardware e casos de uso. A base compartilhada é a arquitetura Multimodal Diffusion Transformer, ou MMDiT-X, que processa tokens de texto e de imagem juntos, em vez de separadamente.
Esse processamento conjunto é o que separa o SD 3.5 de abordagens de difusão anteriores. Em modelos como o SD 1.5 ou o SDXL, o codificador de texto produzia um embedding, e a U-Net consultava esse embedding em diferentes etapas. Na MMDiT-X, tokens de texto e visuais interagem simultaneamente pelas mesmas camadas de atenção. O resultado é um modelo que responde de forma mais direta à linguagem do prompt, lida com prompts complexos de vários sujeitos com menos confusão e gera textos dentro das imagens com precisão muito maior.
Do SD 1.x ao SD 3.5
A evolução dos modelos Stable Diffusion conta uma história clara. O SD 1.5 trouxe geração de código aberto acessível, mas tinha dificuldade com anatomia coerente e prompts complexos. O SDXL melhorou resolução e detalhe de forma substancial, criando a base para dezenas de fine-tunes. O SD 3 introduziu o backbone DiT (Diffusion Transformer). O SD 3.5 refina esse backbone com a variante MMDiT-X, melhora a qualidade dos dados de treinamento e entrega modelos que são genuinamente competitivos com os resultados do GPT Image e do Midjourney.
O salto do SDXL para o SD 3.5 é maior que o salto do SD 1.5 para o SDXL. Vale dizer isso com clareza, porque afeta decisões sobre quais fine-tunes, LoRAs e fluxos de trabalho compensa construir daqui para frente.
As três variantes do modelo
O SD 3.5 não chega como um modelo único. Chega como três:
| Modelo | Parâmetros | Melhor para |
|---|
| SD 3.5 Large | 8B | Qualidade máxima, prompts complexos |
| SD 3.5 Large Turbo | 8B (destilado) | Geração rápida, qualidade próxima do Large |
| SD 3.5 Medium | 2,5B | GPUs de consumo, bom para fine-tuning |
A variante Medium é a mais propensa a ser ajustada em modelos especializados com o tempo, já que cabe com folga em uma placa de 10GB de VRAM. As variantes Large exigem hardware mais robusto, mas entregam resultados sensivelmente melhores em cenas intrincadas.
Os recursos do SD 3.5 que importam
Nem todo recurso listado de um modelo novo é de fato relevante na prática. Estes são.
Tipografia que realmente funciona
Os modelos de difusão anteriores tratavam o texto dentro das imagens como um problema de textura. Conseguiam aproximar formas de letras, mas embaralhavam palavras com frequência além de poucos caracteres. O SD 3.5 trata a geração de texto como parte de sua competência central, e não como um detalhe posterior.
A arquitetura MMDiT-X processa os tokens de texto do prompt no mesmo nível de atenção dos tokens espaciais, o que significa que o modelo tem uma representação interna muito melhor de como as letras devem ser e onde devem aparecer. Na prática, você pode pedir ao SD 3.5 Large que inclua uma placa, um rótulo ou um cartaz com uma frase curta e obter resultados legíveis já na primeira geração. Só isso abre casos de uso comerciais significativos que antes eram pouco práticos com modelos de código aberto.
Fotorrealismo melhorado
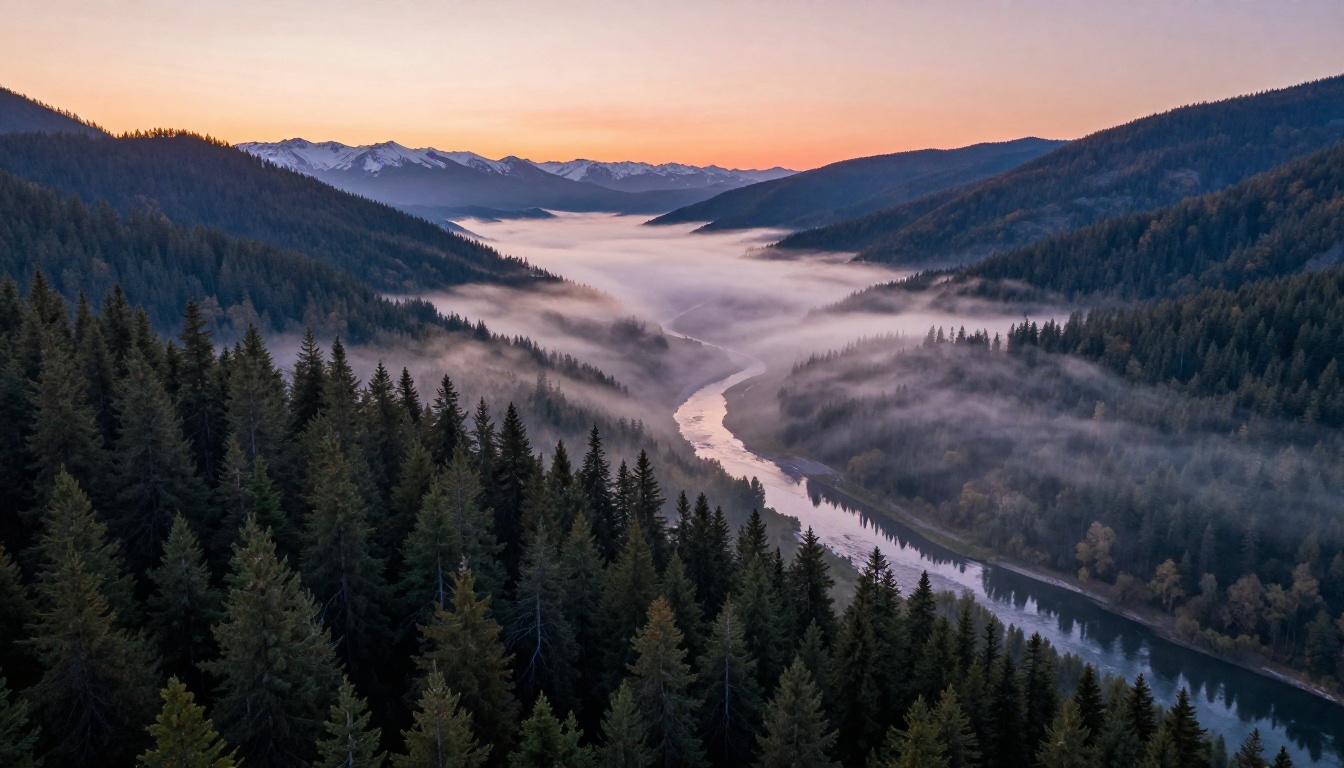
Fotorrealismo na geração de imagens é uma qualidade específica. Não é só nitidez ou resolução. É a forma como a luz se comporta sobre as superfícies, as sutis mudanças de cor nas sombras, a microtextura da pele e do tecido e a profundidade coerente sugerida pelos planos fora de foco. O SD 3.5 Large lida com todos esses aspectos de forma claramente melhor que o SDXL.
O modelo foi treinado com um conjunto de dados curado e de alta qualidade, e o ganho de qualidade aparece nas comparações. Os retratos mostram a pele com detalhe em nível de poros. As fotos de arquitetura têm perspectiva correta, sem artefatos de distorção. As imagens de produtos mostram propriedades de material consistentes em todo o quadro. Para quem dependia de fine-tunes especializados como o RealVisXL v3.0 Turbo para obter resultados fotorrealistas com o SDXL, o modelo base SD 3.5 Large parte de um patamar bem mais alto.
A arquitetura MMDiT-X
A base técnica vale um breve olhar, mesmo que você não esteja construindo modelos. Os modelos de difusão tradicionais baseados em U-Net codificam informação espacial de forma hierárquica. O Multimodal Diffusion Transformer, por outro lado, usa camadas de atenção que permitem que os patches de texto e de imagem se influenciem igualmente ao longo de todo o processo de remoção de ruído.
Isso tem dois efeitos práticos. Primeiro, o modelo mantém uma consistência muito mais forte entre o que é descrito e o que é gerado, especialmente em cenas com vários objetos. Se você pedir "uma bolsa vermelha à esquerda e uma bolsa azul à direita", o modelo tem muito menos chance de trocar as posições ou as cores. Segundo, o modelo lida de forma mais robusta com estruturas de prompt incomuns ou complexas, tratando posicionamento relativo, descrições em camadas e conceitos negados com confiabilidade muito maior.
Large, Medium ou Turbo
Escolher a variante certa é mais uma decisão prática do que teórica.
Qual versão escolher
O SD 3.5 Large é o modelo de referência em qualidade. Use-o quando a qualidade da geração for a prioridade e o tempo de processamento não for uma restrição. Ele produz o detalhe mais nítido, a melhor aderência ao prompt e a renderização de texto mais confiável.
O SD 3.5 Large Turbo é destilado do modelo Large por meio de treinamento adversarial. Ele consegue produzir imagens de alta qualidade em quatro a oito passos, em vez de vinte a trinta. A diferença de qualidade em relação ao Large completo é visível sob inspeção de perto, mas mínima para a maioria dos resultados práticos. Use-o quando precisar iterar mais rápido sem descer para o nível Medium.
O SD 3.5 Medium é o alvo ideal para fine-tuning. Sua contagem de 2,5B parâmetros significa que pode ser treinado em hardware de consumo, o que já gerou uma onda de fine-tunes da comunidade voltados a estilos, rostos e categorias de produtos específicos. Ele entrega qualidade sensivelmente inferior às variantes Large em prompts complexos, mas, para tarefas especializadas e focadas, um Medium bem treinado pode superar o modelo Large base.
Contrapartidas entre velocidade e qualidade
💡 Diretriz prática: para resultados finais de produção, use o SD 3.5 Large. Para prototipagem rápida ou quando precisar de dezenas de variações, use o Large Turbo. Para modelos especializados com fine-tuning em hardware limitado, use o Medium.
A contagem de passos importa bastante com esses modelos. Rodar o SD 3.5 Large com 20 passos produz resultados visivelmente melhores do que com 10 passos. Ao contrário de alguns modelos anteriores, nos quais a curva de qualidade se estabiliza rápido, o SD 3.5 se beneficia de toda a faixa de passos recomendada quando o objetivo é o máximo de detalhe.
Como escrever prompts melhores para o SD 3.5
O SD 3.5 processa prompts de forma diferente dos modelos baseados em U-Net. As estratégias de prompt que funcionavam bem com o SD 1.5 e o SDXL se aplicam em parte, mas a nova arquitetura recompensa hábitos diferentes.
Estrutura de prompt que funciona
O SD 3.5 responde bem a descrições em linguagem natural, em vez das listas de tags separadas por vírgula que dominavam os prompts do SDXL. Você pode escrever uma frase como "uma mulher em pé em uma cozinha ensolarada, olhando pela janela, fotorrealista, luz da manhã vindo da esquerda" e obter resultados coerentes.
Dito isso, os modificadores de qualidade ainda ajudam. Os termos a seguir melhoram a qualidade da saída de forma confiável:
- fotorrealista, hiperrealista, 8K
- iluminação cinematográfica, luz volumétrica
- foco nítido, granulação de filme, Kodak Portra 400
- lente de 85mm, profundidade de campo f/1.8
- foto RAW, alto nível de detalhe
Para sujeitos com detalhes físicos específicos, descreva-os logo no início do prompt. O modelo dá mais atenção aos conceitos que aparecem antes na sequência de tokens, então seus elementos mais importantes devem vir primeiro.
Prompts negativos ainda funcionam
Apesar das mudanças de arquitetura, os prompts negativos continuam eficazes. Exclusões padrão como deformed, blurry, low quality, cartoon, illustration, watermark ainda suprimem essas qualidades de forma confiável. Para retratos especificamente, adicionar plastic skin, airbrushed, smooth skin, uncanny valley ao prompt negativo mantém a textura facial com aparência natural, em vez de excessivamente processada.
Uma diferença notável em relação ao SDXL: o SD 3.5 tem muito menos tendência a erros de anatomia, o que significa que a lista de prompt negativo para partes do corpo pode ser menor ou, em muitos casos, omitida por completo.
Como usar o SD 3.5 no PicassoIA
O Stable Diffusion 3.5 Large está disponível diretamente no PicassoIA, o que significa que você pode usá-lo sem nenhuma instalação local, requisitos de GPU ou configuração de ambiente Python.
Passo a passo com o SD 3.5 Large
Passo 1: abra a página do modelo
Acesse Stable Diffusion 3.5 Large no PicassoIA. A interface carrega direto no navegador, sem necessidade de conta para começar.
Passo 2: escreva seu prompt
No campo de prompt, descreva sua imagem em linguagem natural. Comece pelo sujeito principal, depois pelo ambiente, depois pela iluminação e, por fim, pelos modificadores de estilo. Mantenha entre 50 e 150 palavras para melhores resultados. Prompts mais curtos podem funcionar, mas tendem a produzir resultados genéricos.
Passo 3: defina seus parâmetros
Os parâmetros para ajustar:
- Steps: defina entre 28 e 40 para qualidade máxima. Defina entre 8 e 12 para velocidade com o Large Turbo.
- CFG Scale: 3,5 a 4,5 é o ponto ideal para o SD 3.5. Valores mais altos podem causar supersaturação e introduzir artefatos.
- Proporção (Aspect Ratio): 16:9 para paisagem, 9:16 para retrato, 1:1 para formatos quadrados.
Passo 4: adicione um prompt negativo
Mesmo com um prompt positivo limpo, adicione exclusões básicas de qualidade: blurry, low quality, distorted, watermark, text, deformed
Passo 5: gere e itere
Rode sua primeira geração. Se o resultado estiver próximo, mas não perfeito, ajuste descritores específicos em vez de reescrever o prompt inteiro. Pequenas mudanças, como acrescentar "luz de contorno suave vindo da direita" ou trocar "photorealistic" por "hyperrealistic photograph", podem alterar bastante o resultado.
Parâmetros para ajustar
💡 Dica sobre CFG: o SD 3.5 foi calibrado para valores de CFG mais baixos do que o SDXL. Se você estiver obtendo resultados supersaturados ou com nitidez exagerada, reduza seu CFG de 7 para 4 e gere de novo.
O parâmetro seed permite reproduzir resultados exatos. Quando encontrar uma geração de que você goste, anote o valor da seed. Você pode reutilizá-lo com pequenas variações no prompt para criar variações coerentes da mesma cena. Isso é útil para conjuntos de imagens de produtos ou para a consistência de personagem em várias imagens.
Para o sampler, DPM++ 2M Karras e Euler a funcionam bem com o SD 3.5. O modelo não é tão sensível à escolha do sampler quanto o SD 1.5 era, mas o DPM++ tende a produzir gradientes um pouco mais suaves em retratos, enquanto o Euler a pode gerar bordas mais nítidas em fotos de arquitetura e produtos.
Escolher entre modelos é uma questão de associar a ferramenta à tarefa. O SD 3.5 não é a melhor escolha para tudo.
O SDXL ainda tem seu lugar
O SDXL Lightning 4Step e os fine-tunes especializados de SDXL construídos em torno de estéticas específicas ainda produzem resultados distintivos que o SD 3.5 não reproduz exatamente. O ecossistema do SDXL tem milhares de LoRAs treinados em estilos artísticos, rostos e tipos de produto específicos. Se o seu fluxo de trabalho depende de um LoRA específico que ainda não foi portado para o SD 3.5, o SDXL continua sendo a escolha prática.
O Stable Diffusion (o modelo original baseado no 1.5) conserva um público fiel por causa de suas características estéticas específicas e do enorme volume de fine-tunes construídos sobre ele. Para estilos de ilustração próximos ao anime e ao artístico, o ecossistema 1.5 ainda produz resultados competitivos, apesar da idade arquitetural do modelo base.
Onde o Flux leva vantagem
O Flux Dev e o Flux Pro, da Black Forest Labs, são a principal alternativa competitiva ao SD 3.5 no espaço de pesos abertos. O Flux tende a produzir resultados mais fortes em fotografia de arquitetura, imagens de produtos com detalhe geométrico preciso e qualquer cena que exija relações espaciais muito exatas. O SD 3.5 Large tem vantagem em retratos e sujeitos humanos, nos quais a composição dos seus dados de treinamento mostra ganhos claros em detalhe facial e fidelidade da textura da pele.
A comparação honesta: nenhum dos dois modelos domina todas as categorias. Usar ambos pelo PicassoIA não exige nenhum esforço de configuração, então testar os dois no seu caso de uso específico é a abordagem mais direta.
| Caso de uso | Modelo recomendado |
|---|
| Fotografia de retratos | SD 3.5 Large |
| Arquitetura e interiores | Flux Dev |
| Fotos de produto | SD 3.5 Large ou Flux |
| Texto na imagem | SD 3.5 Large |
| Iteração rápida | SD 3.5 Large Turbo |
| Estilo anime / ilustração | Fine-tunes de SDXL |
| Fine-tuning em GPU de consumo | SD 3.5 Medium |
Casos de uso reais
Os recursos descritos acima se traduzem em aplicações criativas práticas que eram difíceis ou impossíveis com os modelos de código aberto anteriores.
Fotografia de retratos
O SD 3.5 Large produz imagens de retrato com detalhes de pele, cabelo e olhos que competem com a fotografia de estúdio. O modelo lida bem com configurações de iluminação desafiadoras: luz dividida, luz de contorno com fundo escuro, luz natural de janela com sombras suaves. Para aplicações comerciais de retrato, como fotos de perfil para sites, imagens de moda ou referências de personagens, ele produz resultados prontos para uso sem muito pós-processamento.
A consistência da anatomia entre gerações é muito melhor do que no SDXL. As mãos, que eram notoriamente difíceis para os modelos anteriores, são renderizadas com a quantidade correta de dedos e poses naturais em uma grande proporção das gerações, sem nenhum artifício de prompt negativo.
Fotos de produto
A fotografia de produtos é um dos casos de uso de geração de imagens por IA que mais crescem em fluxos de trabalho profissionais. O fotorrealismo aprimorado do SD 3.5 faz com que as imagens de produtos pareçam estar em ambientes reais, e não coladas sobre eles. O modelo lida com superfícies reflexivas, materiais transparentes e ambientes de fundo complexos, com iluminação consistente na superfície do produto.
Combinadas com as melhorias na renderização de texto, você pode incluir rótulos ou placas com marca nas imagens de produto e obter resultados legíveis. Uma garrafa com rótulo, um livro com título, uma embalagem com nome de marca: todas essas são saídas viáveis do SD 3.5 Large, onde modelos anteriores produziriam aproximações ilegíveis.
Arte criativa
Para trabalhos criativos não fotorrealistas, o SD 3.5 com prompts de estilo adequados produz texturas de pintura a óleo, estéticas de fotografia analógica e estilos de ilustração editorial que são ao mesmo tempo de alta qualidade e distintivos. A maior aderência ao prompt do modelo significa que composições de cena complexas com vários sujeitos interagindo chegam de fato perto da intenção descrita, o que abre espaço para briefings criativos mais ambiciosos.
A natureza de pesos abertos do SD 3.5 também significa que a comunidade criativa já começou a fazer fine-tuning da variante Medium para estilos artísticos específicos, e essa biblioteca de fine-tunes só vai crescer conforme o modelo amadurecer. Artistas que querem uma estética específica podem esperar por um fine-tune da comunidade ou treinar o seu próprio sobre a base Medium.
Todos os recursos descritos neste artigo estão disponíveis para você imediatamente pelo PicassoIA, sem instalação local, sem ambiente Python e sem GPU. O modelo Stable Diffusion 3.5 Large está pronto para uso diretamente no seu navegador.
Além do SD 3.5, o PicassoIA dá acesso ao Stable Diffusion 3, ao Flux Dev, ao Flux Pro, ao RealVisXL v3.0 Turbo e mais de 90 outros modelos de texto para imagem em um só lugar. Você pode comparar resultados entre modelos sem trocar de plataforma, que é o caminho mais rápido para descobrir o que realmente funciona para o seu tema específico e para os seus requisitos de estilo.
Comece com o prompt que você tem em mente, rode-o primeiro no SD 3.5 Large e depois compare com uma ou duas alternativas. Depois de algumas rodadas de teste, a combinação entre modelo e tarefa se torna intuitiva. O piso de qualidade da geração de código aberto subiu bastante com o SD 3.5, e a melhor forma de ver essa mudança é gerar algo você mesmo.


