حدث تحوّل ما في توليد الصور بالذكاء الاصطناعي نحو أواخر 2025، وبحلول وصول 2026 أصبحت الأدوات التي كانت تبدو تجريبية جاهزة فعلًا للإنتاج. الصور التي تخرج من أفضل النماذج اليوم ليست أفضل فحسب من تلك التي كانت قبل عامين؛ بل مختلفة اختلافًا جذريًا في طريقة تعاملها مع الضوء والملمس وتشريح جسم الإنسان وتعقيد المشهد. إن كانت آخر مرة تابعت فيها حالة توليد الصور بالذكاء الاصطناعي قبل ستة أشهر، فعليك أن تلحق بما فاتك.
يستعرض هذا المقال ما الذي تغيّر فعلًا في 2026، وأي النماذج أحدثت الفرق، وأين ما زالت التقنية تواجه صعوبات، وكيف يمكنك أن تبدأ التوليد بهذا المستوى الجديد من الجودة الآن.
قبل 2026: الأساس الذي ينساه الجميع
من السهل أن تنظر إلى نتائج اليوم وتفترض أن التقدم كان دائمًا بهذا الخط المستقيم. لم يكن الأمر كذلك.
الدقة كانت امتيازًا
في 2023 و2024، كان توليد صور واقعية بجودة 1080p بشكل ثابت يتطلب وصولًا مكلفًا إلى واجهة API، وصياغة دقيقة للأوامر النصية، وغالبًا معالجة لاحقة عبر نماذج رفع دقة منفصلة. كانت نتيجة تحويل النص إلى صورة المتوسطة في الفئة الميسورة تبدو باهتة، وتفتقر إلى التفاصيل الدقيقة، وتتطلب محاولات متعددة للحصول على شيء مقبول.
كانت الفجوة بين ما هو ممكن تقنيًا وما هو متاح عمليًا هائلة. يمكنك الحصول على نتائج مذهلة، لكن فقط إن عرفت بالضبط الإعدادات التي تستخدمها، وكان لديك الوصول إلى العتاد أو مستوى واجهة API المناسب، وكنت مستعدًا لقضاء وقت في التكرار. ولم يكن معظم المبدعين يفعلون أيًا من ذلك.
المفتوح المصدر مقابل المغلق المصدر غيّر الأدوار
في 2024، كانت السردية بسيطة: النماذج المغلقة المصدر من OpenAI تتمتع بجودة أعلى، بينما توفّر النماذج المفتوحة المصدر تحكمًا وتخصيصًا أكبر. وقد تلاشى هذا الفصل كثيرًا منذ ذلك الحين.
قرّب Stable Diffusion 3 الجانب المفتوح المصدر بشكل ملحوظ من جودة النماذج المغلقة المصدر. وفي الوقت نفسه، بدأت المنصات المغلقة المصدر في دمج الضبط الدقيق عبر أساليب على غرار LoRA. وبدأت الحواجز بين "التحكم" و"الجودة" تنهار، مما مهّد الطريق لكل ما تلا ذلك في 2026.
ما الذي قدّمه 2026 فعلًا
القصة الحقيقية لعام 2026 ليست اختراقًا واحدًا. إنها عدة تحسينات متداخلة وصلت في غضون أشهر من بعضها البعض، ورفعت مجتمعةً الحد الأدنى لما يُعدّ مخرجًا "مقبولًا".
GPT Image 2 غيّر خط الأساس
وصل GPT Image 2 بفلسفة مختلفة عن سلفه. فبدلًا من التركيز على الابتكار الإبداعي الخام، ركّز على دقة اتباع التعليمات والواقعية الفوتوغرافية بطريقة جعلته يبدو أقل كأداة إبداعية وأكثر كمولّد لأصول الإنتاج. اطلب منه صورة منتج على خلفية بيضاء بزاوية ظل محددة، وسيقدّمها. اطلب بورتريهًا بإعداد إضاءة معيّن، وستكون النتيجة أقرب بشكل ملحوظ إلى ما وصفته.
كانت هذه الموثوقية هي الاختراق، لا الدقة ولا نطاق الأسلوب. فعندما يفعل النموذج ما وصفته فعلًا، بدلًا من تفسير وصفك على أنه يعنيه، يتغيّر سير العمل بالكامل.
💡 يستجيب GPT Image 2 بشكل جيد بصفة خاصة للغة المتخصصة في التصوير الفوتوغرافي. أشِر إلى أنواع العدسات، وf-stop، وISO، واتجاه الإضاءة في أوامرك النصية للحصول على نتائج أكثر تحكمًا بشكل ملحوظ.
Seedream 4.5 ومعيار 4K
جعل Seedream 4.5 من ByteDance دقة 4K توقّعًا واقعيًا للمخرجات، بدلًا من كونها ميزة متميزة. يولّد النموذج صورًا بدقة تظهر فيها مسام البشرة الفردية، ونسيج الأقمشة، وملمس الأسطح دون الحاجة إلى رفع الدقة. بالنسبة إلى المصورين ومصممي المنتجات وفرق التسويق، أزال هذا خطوة كاملة من مسار المعالجة اللاحقة.
ما يجعل Seedream 4.5 لافتًا بشكل خاص هو طريقة تعامله مع المشاهد المعقدة. فالتركيبات متعددة الأشخاص مع عرض عمق مجال واقعي، وإسقاط دقيق للظلال عبر عدة أجسام، وإضاءة متماسكة من مصدر واحد عبر الإطار كله، كانت تاريخيًا غير موثوقة في نماذج تحويل النص إلى صورة. يحقق Seedream 4.5 ذلك بشكل أكثر اتساقًا بكثير من أي شيء متاح في 2024.
Wan 2.7 يرفع سقف التفاصيل
وضع Wan 2.7 Image Pro من Wan Video معيارًا جديدًا لعرض التفاصيل الدقيقة في الصور المولّدة بالذكاء الاصطناعي. يتعامل النموذج مع ملمس الأسطح بطريقة تبدو مادية حقًا. فالحجر والقماش والبشرة والمعدن تتصرف بشكل مختلف تحت الضوء في مخرجات Wan 2.7، وهو ما كان نقطة ضعف كبيرة في النماذج السابقة التي كانت تميل إلى تطبيق لمعان موحّد على الأسطح بغض النظر عن نوع المادة.
يقدّم النموذج القياسي Wan 2.7 Image مخرجات بدقة 2K بخصائص جودة مشابهة، ولكن بسرعة توليد أعلى، مما يجعله أنسب لسير العمل التكراري الذي تحتاج فيه إلى عدة اختلافات بسرعة.
Hunyuan Image 2.1 يتقن الواقعية
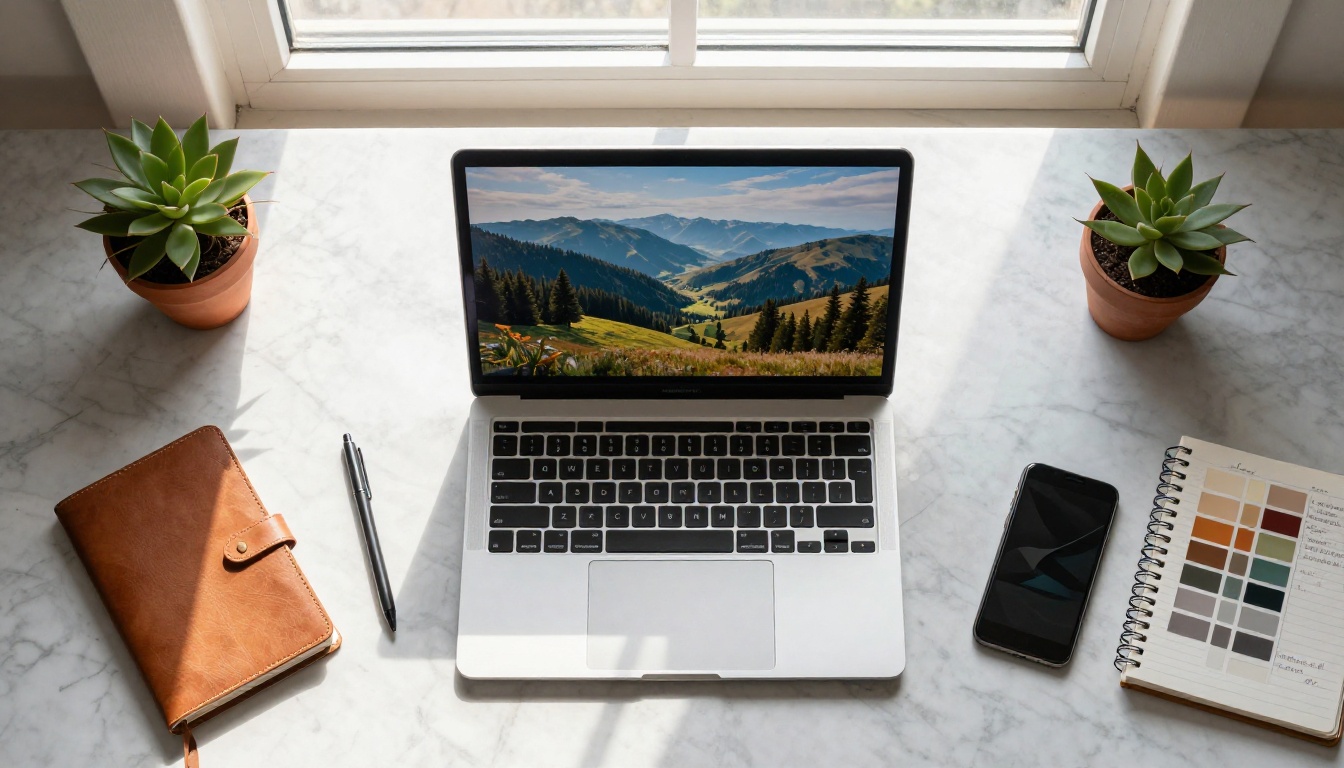
يقترب Hunyuan Image 2.1 من Tencent من الواقعية من زاوية مختلفة عن النماذج الغربية. فبينما يُحسّن GPT Image 2 دقة التعليمات، ويحسّن Seedream 4.5 الدقة الخام، يركّز Hunyuan Image 2.1 بشدة على الأشخاص: درجات بشرة طبيعية، ونسب جسم واقعية، وتعابير وجه لا تبدو متجمدة أو مصطنعة.
بالنسبة لفئات المحتوى التي تتضمن أشخاصًا وصور البورتريه وصور أنماط الحياة، يعمل Hunyuan Image 2.1 بمستوى ينافس بشكل مباشر التصوير في الاستوديو بجزء من التكلفة. كما يتعامل النموذج مع درجات البشرة المتنوعة بانحياز أقل بكثير من النماذج السابقة، وهو ما يمثّل خطوة حقيقية إلى الأمام في قابلية الاستخدام العملي.
الكتابة بالأوامر النصية في 2026 مختلفة
من التغييرات الأقل حديثًا بين 2025 و2026 مدى السهولة التي أصبحت عليها كتابة الأوامر النصية. ليس لأن الناس أصبحوا أفضل فيها، بل لأن النماذج أصبحت أفضل في تفسير اللغة الطبيعية.
عمل أقل، نتائج أفضل
إن انضباط هندسة الأوامر الذي تطوّر بين 2022 و2024، بقوائم المعدِّلات والأوامر النصية السلبية وحيل الصياغة المعقدة، يصبح أقل ضرورة مع الجيل الحالي من النماذج. يستجيب كل من Reve Create وGPT Image 2 بشكل جيد للأوصاف الحوارية بدلًا من الأوامر المحشوّة بالكلمات المفتاحية.
هذا لا يعني أن مهارة الكتابة بالأوامر النصية لا قيمة لها. فمعرفة كيفية وصف الإضاءة والتكوين والأجواء بمصطلحات محددة ما زالت تنتج نتائج أفضل بشكل ملموس. لكن الحد الأدنى لمفهوم "مخرجات مقبولة بأقل جهد" ارتفع بشكل كبير. فوصف من جملة واحدة كان سينتج نتائج متوسطة في 2023 أصبح ينتج الآن شيئًا قابلًا للاستخدام فعلًا.
أسلوب دون كلمات إضافية
كانت النماذج الأسبق تتطلب معدِّلات أسلوب صريحة لتجنب الانزلاق نحو مظهر عام: "photorealistic, 8K, cinematic, Kodak Portra" وما إلى ذلك. أما النماذج الرائدة الحالية مثل Fibo وRecraft 20B فقد استوعبت نطاقًا أوسع من الجماليات وتطبّقها بحسب السياق وفق موضوع الصورة. صِف منتجًا، وستحصل على تصوير منتجات. صِف منظرًا طبيعيًا، وستحصل على شيء يُقرأ كتصوير للمناظر الطبيعية، لا كرسم توضيحي مرسوم.
هذا الاستدلال الأسلوبي المرتبط بالسياق من التحولات الهادئة لكنها الأكثر تأثيرًا في 2026. فهو يعني أن توليد الصور بالذكاء الاصطناعي يصبح متاحًا حقًا لمن ليست لديهم خلفية في التصوير الفوتوغرافي أو هندسة الأوامر النصية.
ضبط LoRA الدقيق للجميع
إذا كان عام 2024 هو العام الذي أصبح فيه LoRA شائعًا لدى المستخدمين المتقدمين، فإن 2026 هو العام الذي أصبح فيه عمليًا لأي شخص. فقد جعلت أوقات التدريب الأسرع، والمتطلبات الحسابية الأقل، والتوثيق الأفضل، من ضبط النموذج المخصّص خيارًا واقعيًا للاستوديوهات الصغيرة والمبدعين الأفراد.
ماذا يعني التدريب المخصّص الآن
يتيح الضبط الدقيق بتقنية LoRA تدريب نموذج على أسلوب بصري أو موضوع أو هوية علامة تجارية محددة، ثم تطبيق ذلك الأسلوب على أي مخرج مولّد. عمليًا، يعني هذا أن علامة تجارية لمنتج يمكنها تدريب نموذج على 20 إلى 30 صورة مرجعية، ثم توليد صور تسويقية متسقة دون إعادة وصف جماليات المنتج في كل أمر نصي على حدة.
انخفض كثيرًا حاجز التكلفة والوقت الذي جعل هذا غير عملي في 2024. فما كان يتطلب وحدة GPU قوية وساعات من التدريب يمكن أن يعمل الآن في دقائق عبر مسارات سحابية.
نماذج LoRA لنموذج Flux 2 Klein
يمثّل Flux 2 Klein 9B Base LoRA وFlux 2 Klein 4B Base LoRA من Black Forest Labs المعيار الحالي للتخصيص القائم على LoRA. يوفّر الإصدار 9B دقة أسلوبية أعلى على حساب سرعة التوليد، بينما يحقق النموذج 4B توازنًا أفضل لسير العمل التكراري.
يدعم كلا النموذجين التدريب على مجموعات بيانات صغيرة (ابتداءً من 15 إلى 20 صورة)، وينتجان مخرجات متسقة تطابق أسلوب بيانات التدريب بشكل وثيق، ويندمجان مع أدوات سير العمل الحالية دون الحاجة إلى إعداد تقني كبير. يضيف Flux Redux Dev قدرة توليد الاختلافات للصور فوق ذلك، مما يتيح لك توليد عدة تفسيرات لصورة مرجعية مع الحفاظ على اتساق الأسلوب.
💡 لتدريب LoRA، انتقِ صور التدريب بعناية. فالتنوع في الزوايا والإضاءة داخل مجموعة التدريب ينتج سلوكًا أكثر مرونة من الصور المتشابهة أكثر من اللازم.
الفجوات الحقيقية بين النماذج
مع وجود خيارات قوية كثيرة متاحة الآن، لم يعد الاختيار بين النماذج يدور حول إيجاد "الأفضل" بالمعنى المطلق. بل حول مطابقة نقاط قوة النموذج مع حالة الاستخدام المحددة لديك.
| النموذج | الأفضل في | دقة المخرجات | السرعة |
|---|
| GPT Image 2 | مخرجات دقيقة في اتباع التعليمات | حتى 4K | متوسطة |
| Seedream 4.5 | واقعية 4K، مشاهد معقدة | 4K | متوسطة |
| Wan 2.7 Image Pro | التفاصيل الدقيقة، ملمس الأسطح | 4K | أبطأ |
| Hunyuan Image 2.1 | الموضوعات البشرية، البورتريهات | 2K | سريعة |
| Flux 2 Klein 9B LoRA | ضبط الأسلوب المخصّص الدقيق | حتى 4K | بطيئة |
| Recraft 20B | الاستدلال الأسلوبي المرتبط بالسياق | متغيرة | سريعة |
المفاضلة بين السرعة والجودة
أسرع النماذج في 2026، بما في ذلك Flux Schnell LoRA، ليست الأعلى جودة. هذه المفاضلة كانت موجودة دائمًا، لكن الفجوة تضاءلت. فالنماذج السريعة في 2026 تنتج مخرجات كانت ستُعدّ عالية الجودة في 2024. إن كنت تحتاج إلى حجم كبير، فإن نماذج الفئة السريعة أصبحت قابلة للاستخدام فعلًا في أعمال الإنتاج بطرق لم تكن كذلك قبل عامين.
اتساق المخرجات ما زال متفاوتًا
حيث ما زالت النماذج تختلف بشكل كبير هو في اتساق المخرجات. شغّل الأمر النصي نفسه 10 مرات على أي نموذج، وستحصل على نتائج مختلفة بشكل ملحوظ في كل مرة. بعض هذا التباين مرغوب في العمل الإبداعي، لكن بالنسبة لسير عمل الإنتاج الذي يتطلب اتساقًا بصريًا عبر مجموعة من الصور، يبقى قيدًا حقيقيًا.
تعالج نماذج مثل Qwen Image Edit Plus هذا جزئيًا عبر سير عمل وضع التعديل، حيث تبدأ بصورة مرجعية وتعدّلها بدلًا من التوليد من الصفر في كل مرة. يُنتج هذا النهج نتائج أكثر اتساقًا لأن النموذج لديه مرساة بصرية يعمل انطلاقًا منها.
ما الذي ما زال غير محلول
كان التقدم في 2026 حقيقيًا ومهمًا. لكن النظرة الواقعية تتطلب الاعتراف بالمواضع التي ما زال فيها توليد تحويل النص إلى صورة يفشل باستمرار.
الأيدي والنصوص والتفاصيل الدقيقة
تبقى الأيدي أكثر نقاط الفشل تكرارًا في توليد الصور بالذكاء الاصطناعي، ولم يحل 2026 هذه المشكلة بالكامل. تنتج جميع النماذج الحالية أيدي بأخطاء تشريحية عرضية: أصابع زائدة، ومفاصل ملتحمة، أو زوايا مفاصل غير منطقية. انخفض معدل الخطأ مقارنة بعام 2023، لكنه لم يصل إلى مستوى موثوقية الوجوه أو الأقمشة.
والنصوص القابلة للقراءة داخل الصور غير موثوقة بالدرجة نفسها. فمعظم النماذج تنتج نصوصًا تبدو مقبولة طباعيًا من بعيد، لكنها تنهار عند الفحص عن قرب. وتوليد صور يجب أن تكون فيها كلمات أو جمل محددة واضحة ودقيقة ما زال غير سير عمل موثوق مع أي نموذج حالي.
ثبات الشخصيات عبر الصور
أصعب مشكلة لم تُحل في 2026 هي اتساق الشخصيات عبر عدة صور مولّدة. إن كنت تحتاج إلى ظهور الشخص نفسه في عشرة مشاهد مختلفة، فليس لديك حاليًا أي طريقة موثوقة لضمان أن يبدو ذلك الشخص متطابقًا في كل منها، دون معالجة لاحقة مكثفة أو سير عمل تعديل من صورة إلى صورة.
يساعد Qwen Image Edit ونماذج وضع التعديل المشابهة في الاحتفاظ بشخصية مرجعية وتغيير البيئة فقط، لكن حتى هذا النهج يُنتج انحرافًا عبر عدة تكرارات. وهذه هي المشكلة التي تعمل الجيل القادم من النماذج على حلّها بأكبر قدر من النشاط.
كيف تولّد بهذا المستوى الآن
لا تحتاج إلى إعداد بنية تحتية محلية أو إدارة توكنات واجهة API من عدة مزودين للوصول إلى كل هذه النماذج. فجميع النماذج التي يناقشها هذا المقال متاحة مباشرة عبر PicassoIA.
تتيح المنصة الوصول إلى أكثر من 90 نموذجًا لتحويل النص إلى صورة عبر واجهة واحدة، لتتمكن من اختبار GPT Image 2 وSeedream 4.5 وWan 2.7 Image Pro وHunyuan Image 2.1 جنبًا إلى جنب بالأمر النصي نفسه، لترى أيّها يناسب حالة استخدامك. وإلى جانب تحويل النص إلى صورة، ستجد أيضًا أدوات لإزالة الخلفية، ورفع الدقة الفائق، وتعديل الصور بأوامر نصية، وضبط LoRA الدقيق، جميعها متاحة دون التنقل بين المنصات أو إدارة حسابات منفصلة.
إليك سير عمل بداية مباشر:
- اختر نموذجًا بحسب نوع محتواك. للبورتريهات والموضوعات البشرية، ابدأ مع Hunyuan Image 2.1. للمشاهد المعقدة أو تصوير المنتجات، جرّب Seedream 4.5 أو Wan 2.7 Image Pro.
- اكتب أمرًا نصيًا وصفيًا باستخدام لغة التصوير: اذكر اتجاه الإضاءة، وزاوية الكاميرا، والمسافة إلى الشخص، وأي تفاصيل للمادة أو الملمس مهمة للّقطة.
- ولّد من 3 إلى 5 اختلافات قبل أن تقرر الاتجاه. فالتباين بين التوليدات ميزة وليس عيبًا، والنتيجة الثانية أو الثالثة غالبًا ما تكون أقوى من الأولى.
- كرّر التحسين بالتعديل باستخدام Qwen Image Edit Plus إن أردت تحسين صورة محددة بدلًا من إعادة التوليد من الصفر.
- طبّق LoRA إن احتجت إلى اتساق أسلوبي عبر مجموعة. يُعد Flux 2 Klein 9B Base LoRA المعيار الحالي لسير العمل هذا.
الجزء الذي يستحق الانتباه
لم يعد توليد الصور بالذكاء الاصطناعي في 2026 مجرد جديد. فجودة المخرجات من نماذج مثل GPT Image 2 وSeedream 4.5 وWan 2.7 Image Pro بمستوى الإنتاج لقائمة متنامية من الحالات. ما زالت التقنية تواجه قيودًا حقيقية، خاصة فيما يتعلق بالاتساق والتفاصيل الدقيقة، لكن هذه القيود تتقلص مع كل إصدار جديد من النماذج.
أهم تحوّل هو سهولة الوصول. فما كان يتطلب خبرة كبيرة وموارد وفيرة في 2024 أصبح في متناول أي شخص لديه فكرة واضحة ووصف جيد الصياغة. لقد ارتفع السقف، وارتفع الحد الأدنى معه أيضًا.
إن لم تجرّب الجيل الحالي من النماذج بعد، فالوقت مناسب للبدء. اختر صورة واحدة تحتاجها لمشروع ما، واكتب وصفًا مركّزًا، وشغّله عبر ثلاثة أو أربعة من النماذج المتاحة على PicassoIA. ستخبرك النتائج بأكثر مما قد يخبرك به أي مقال مقارنة.


