Algo mudou na geração de imagens por IA por volta do fim de 2025, e, quando 2026 chegou, as ferramentas que antes pareciam experimentais já estavam realmente prontas para produção. As imagens que saem dos melhores modelos hoje não são apenas melhores do que as de dois anos atrás; elas são categoricamente diferentes na forma como tratam luz, textura, anatomia humana e complexidade de cena. Se você verificou pela última vez o estado da geração de imagens por IA há seis meses, precisa se atualizar um pouco.
Este artigo explica o que realmente mudou em 2026, quais modelos fizeram diferença, onde a tecnologia ainda tropeça e como você pode começar a gerar nesse novo nível de qualidade agora mesmo.
Antes de 2026: a base que todo mundo esquece
É fácil olhar para os resultados de hoje e imaginar que o progresso sempre foi tão linear. Não foi.
Resolução era privilégio
Em 2023 e 2024, gerar de forma consistente imagens fotorrealistas com qualidade de 1080p exigia acesso de API caro, um cuidadoso trabalho de elaboração de prompt e, muitas vezes, pós-processamento com modelos de upscaling separados. O resultado médio de texto para imagem na faixa acessível ficava suave, sem micro-detalhes, e exigia várias tentativas até sair algo apresentável.
A distância entre o que era tecnicamente possível e o que era praticamente acessível era enorme. Você conseguia resultados impressionantes, mas só se soubesse exatamente quais configurações usar, tivesse acesso ao hardware ou ao nível de API certo e estivesse disposto a gastar tempo com iterações. A maioria dos criadores não fazia nada disso.
Código aberto ou código fechado: os papéis mudaram
Em 2024, a narrativa era simples: os modelos de código fechado da OpenAI tinham melhor qualidade, enquanto os de código aberto ofereciam mais controle e personalização. Essa divisão se diluiu bastante desde então.
Stable Diffusion 3 aproximou bastante o lado de código aberto da qualidade dos modelos fechados. Enquanto isso, as plataformas fechadas começaram a integrar fine-tuning por meio de abordagens no estilo LoRA. As barreiras entre "controle" e "qualidade" começaram a cair, o que preparou o terreno para tudo o que veio em 2026.
O que 2026 realmente entregou
A história real de 2026 não é um único avanço. São várias melhorias sobrepostas que chegaram com poucos meses de diferença umas das outras e, juntas, elevaram o piso do que se considera um resultado "aceitável".
O GPT Image 2 mudou a base
O GPT Image 2 chegou com uma filosofia diferente da de seu antecessor. Em vez de focar na novidade criativa bruta, ele otimizou a precisão em seguir instruções e o fotorrealismo de um jeito que o aproxima menos de uma ferramenta criativa e mais de um gerador de ativos para produção. Peça uma foto de produto sobre um fundo branco com um ângulo de sombra específico, e ele entrega. Peça um retrato com uma configuração de iluminação determinada, e o resultado fica mensuravelmente mais próximo do que você descreveu.
Essa confiabilidade foi o verdadeiro avanço, não a resolução nem a variedade de estilos. Quando um modelo faz o que você de fato descreveu, em vez do que ele interpreta que sua descrição quer dizer, os fluxos de trabalho mudam por completo.
💡 O GPT Image 2 responde especialmente bem a uma linguagem específica de fotografia. Cite tipos de lente, abertura, ISO e direção da luz nos seus prompts para resultados bem mais controlados.
Seedream 4.5 e o padrão 4K
O Seedream 4.5 da ByteDance estabeleceu o 4K como uma expectativa realista de saída, e não como um recurso premium. O modelo gera imagens em resoluções nas quais poros individuais, tramas de tecido e texturas de superfície ficam visíveis sem upscaling. Para fotógrafos, designers de produto e equipes de marketing, isso eliminou uma etapa inteira do pipeline de pós-processamento.
O que torna o Seedream 4.5 particularmente notável é como ele lida com cenas complexas. Composições com vários sujeitos, com renderização de profundidade de campo realista, sombras projetadas com precisão sobre vários objetos e iluminação coerente vinda de uma única fonte em todo o quadro eram historicamente pouco confiáveis em modelos de texto para imagem. O Seedream 4.5 acerta isso com muito mais consistência do que qualquer opção disponível em 2024.
O Wan 2.7 eleva a barra dos detalhes
O Wan 2.7 Image Pro da Wan Video estabeleceu um novo padrão para a renderização de micro-detalhes em imagens geradas por IA. O modelo trata texturas de superfície de um jeito que parece genuinamente físico. Pedra, tecido, pele e metal se comportam de forma diferente sob a luz nas saídas do Wan 2.7, o que era uma fraqueza considerável nos modelos da geração anterior, que tendiam a aplicar um brilho uniforme às superfícies independentemente do tipo de material.
O modelo padrão Wan 2.7 Image entrega saída em 2K com características de qualidade semelhantes, mas com velocidade de geração maior, o que o torna mais adequado a fluxos de trabalho iterativos em que você precisa de várias variações rapidamente.
O Hunyuan Image 2.1 acerta no realismo
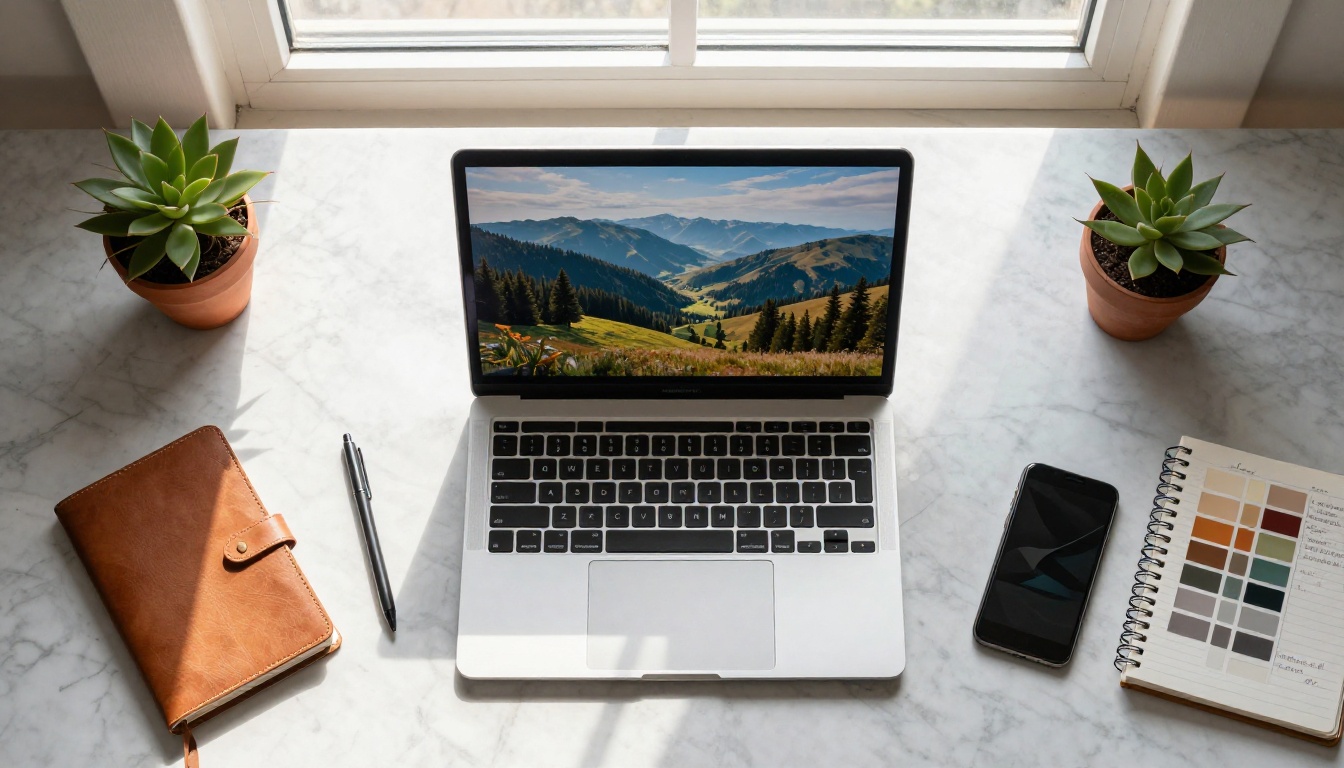
O Hunyuan Image 2.1 da Tencent aborda o realismo por um ângulo diferente dos modelos ocidentais. Enquanto o GPT Image 2 otimiza a precisão nas instruções e o Seedream 4.5 a resolução bruta, o Hunyuan Image 2.1 se concentra fortemente em sujeitos humanos: tons de pele naturais, proporções corporais realistas e expressões faciais que não parecem congeladas ou artificiais.
Para categorias de conteúdo que envolvem pessoas, retratos e imagens de estilo de vida, o Hunyuan Image 2.1 tem um desempenho que compete diretamente com a fotografia de estúdio a uma fração do custo. O modelo também lida com diferentes tons de pele com um viés notavelmente menor do que os modelos anteriores, o que representa um avanço real em usabilidade prática.
Escrever prompts em 2026 é diferente
Uma das mudanças menos comentadas entre 2025 e 2026 é o quanto a elaboração de prompts ficou mais fácil. Não porque as pessoas ficaram melhores nisso, mas porque os modelos ficaram melhores em interpretar a linguagem natural.
Menos trabalho, melhores resultados
A disciplina de engenharia de prompts que se desenvolveu entre 2022 e 2024, com suas listas de modificadores, prompts negativos e truques sintáticos elaborados, está se tornando menos necessária com a geração atual de modelos. O Reve Create e o GPT Image 2 respondem bem a descrições conversacionais, e não a prompts recheados de palavras-chave.
Isso não quer dizer que a habilidade de escrever prompts não tenha valor nenhum. Saber descrever iluminação, composição e atmosfera em termos específicos ainda produz resultados mensuravelmente melhores. Mas o piso para "saída aceitável com esforço mínimo" subiu muito. Uma descrição de uma frase que teria produzido resultados medianos em 2023 agora gera algo realmente utilizável.
Estilo sem palavras extras
Os modelos anteriores exigiam modificadores de estilo explícitos para não cair em uma estética genérica: "fotorrealista, 8K, cinematográfico, Kodak Portra" e assim por diante. Os modelos de ponta atuais, como o Fibo e o Recraft 20B, internalizaram uma faixa mais ampla de estéticas e as aplicam de acordo com o contexto do assunto. Descreva um produto e você recebe fotografia de produto. Descreva uma paisagem e você recebe algo que se lê como fotografia de paisagem, e não como uma ilustração pintada.
Essa inferência contextual de estilo é uma das mudanças mais discretas, mas de maior impacto, em 2026. Ela significa que a geração de imagens por IA está se tornando genuinamente acessível a pessoas sem formação em fotografia nem em engenharia de prompts.
LoRA fine-tuning para todos
Se 2024 foi o ano em que o LoRA ficou popular entre os usuários avançados, 2026 é o ano em que ele se tornou prático para qualquer pessoa. A combinação de tempos de treinamento menores, requisitos computacionais mais baixos e documentação melhor tornou o fine-tuning de modelos personalizados uma opção realista para pequenos estúdios e criadores individuais.
O que o treinamento personalizado significa agora
O fine-tuning com LoRA permite treinar um modelo com um estilo visual, sujeito ou identidade de marca específicos e, em seguida, aplicar esse estilo a qualquer saída gerada. Na prática, isso significa que uma marca de produtos pode treinar um modelo com 20 a 30 fotos de referência e depois gerar imagens de marketing consistentes sem precisar descrever a estética do produto em cada prompt.
A barreira de custo e tempo que tornava isso impraticável em 2024 caiu bastante. O que antes exigia uma GPU potente e horas de treinamento pode agora rodar em minutos por meio de pipelines em nuvem.
Modelos LoRA do Flux 2 Klein
O Flux 2 Klein 9B Base LoRA e o Flux 2 Klein 4B Base LoRA, da Black Forest Labs, representam o padrão atual para a personalização baseada em LoRA. A variante de 9B oferece mais fidelidade de estilo ao custo de velocidade de geração, enquanto o modelo de 4B alcança um equilíbrio melhor para fluxos de trabalho iterativos.
Ambos os modelos aceitam treinamento com conjuntos de dados pequenos (com apenas 15 a 20 imagens), produzem saídas consistentes que se aproximam de perto do estilo dos dados de treinamento e se integram às ferramentas de fluxo de trabalho existentes sem exigir uma configuração técnica significativa. O Flux Redux Dev acrescenta, além disso, a capacidade de variação de imagem, permitindo gerar várias interpretações de uma imagem de referência mantendo a consistência de estilo.
💡 Para o treinamento de LoRA, faça uma curadoria cuidadosa das suas imagens de treino. A diversidade de ângulo e de iluminação no conjunto de treino gera um comportamento de LoRA mais flexível do que imagens muito parecidas entre si.
As lacunas reais entre os modelos
Com tantas opções fortes disponíveis agora, a escolha entre modelos não é sobre encontrar "o melhor" em termos absolutos. É sobre alinhar os pontos fortes do modelo ao seu caso de uso específico.
| Modelo | Melhor para | Resolução de saída | Velocidade |
|---|
| GPT Image 2 | Saídas com precisão nas instruções | Até 4K | Média |
| Seedream 4.5 | Fotorrealismo em 4K, cenas complexas | 4K | Média |
| Wan 2.7 Image Pro | Micro-detalhes, texturas de superfície | 4K | Mais lenta |
| Hunyuan Image 2.1 | Sujeitos humanos, retratos | 2K | Rápida |
| Flux 2 Klein 9B LoRA | Fine-tuning de estilo personalizado | Até 4K | Lenta |
| Recraft 20B | Inferência contextual de estilo | Variável | Rápida |
Contrapartidas entre velocidade e qualidade
Os modelos mais rápidos de 2026, incluindo o Flux Schnell LoRA, não são os de maior qualidade. Essa contrapartida sempre existiu, mas a diferença diminuiu. Os modelos rápidos de 2026 produzem saídas que seriam consideradas de alta qualidade em 2024. Se você precisa de volume, os modelos da faixa rápida agora são genuinamente viáveis para trabalho de produção, de um jeito que simplesmente não eram dois anos atrás.
A consistência das saídas ainda varia
Onde os modelos ainda divergem de forma significativa é na consistência das saídas. Rode o mesmo prompt 10 vezes em qualquer modelo e você terá resultados visivelmente diferentes a cada vez. Parte dessa variação é desejável para trabalho criativo, mas, para fluxos de produção que exigem consistência visual em um lote de imagens, continua sendo uma limitação relevante.
Modelos como o Qwen Image Edit Plus reduzem isso em parte com fluxos de trabalho em modo de edição, nos quais você começa com uma imagem de referência e a modifica, em vez de gerar do zero a cada vez. Essa abordagem produz resultados mais consistentes porque o modelo tem uma âncora visual em que se basear.
O que ainda não foi resolvido
O progresso de 2026 foi real e significativo. Mas o panorama honesto exige reconhecer onde a geração de texto para imagem ainda falha de forma confiável.
Mãos, texto e detalhes finos
As mãos continuam sendo o ponto de falha mais citado na geração de imagens por IA, e 2026 não resolveu isso por completo. Todos os modelos atuais produzem mãos com erros anatômicos ocasionais: dedos extras, nós dos dedos fundidos ou ângulos de articulação implausíveis. A taxa de erro caiu em relação a 2023, mas ainda não chegou ao nível de confiabilidade de rostos ou tecidos.
O texto legível dentro das imagens é igualmente pouco confiável. A maioria dos modelos produz textos que parecem tipograficamente plausíveis à distância, mas se desmancham quando observados de perto. Gerar imagens em que palavras ou frases específicas precisem ser legíveis e exatas ainda não é um fluxo de trabalho confiável com nenhum modelo atual.
Consistência de personagem entre imagens
O problema mais difícil ainda sem solução em 2026 é a consistência de personagem entre várias imagens geradas. Se você precisa que a mesma pessoa apareça em dez cenas diferentes, hoje não há como garantir de forma confiável que ela continue parecida em cada uma sem pós-processamento significativo ou fluxos de edição de imagem para imagem.
O Qwen Image Edit e modelos semelhantes de modo de edição ajudam ao permitir manter um personagem de referência e mudar apenas o ambiente, mas mesmo essa abordagem apresenta desvio ao longo de várias iterações. Este é o problema que a próxima geração de modelos mais se empenha em resolver.
Como gerar nesse nível agora mesmo
Você não precisa montar infraestrutura local nem gerenciar tokens de API de vários provedores para acessar todos esses modelos. Todos os modelos discutidos neste artigo estão disponíveis diretamente pelo PicassoIA.
A plataforma dá acesso a mais de 90 modelos de texto para imagem por meio de uma única interface, então você pode testar o GPT Image 2, o Seedream 4.5, o Wan 2.7 Image Pro e o Hunyuan Image 2.1 lado a lado com o mesmo prompt para ver qual atende ao seu caso de uso específico. Além da geração de texto para imagem, você também encontra ferramentas de remoção de fundo, upscaling de super-resolução, edição de imagens com prompts de texto e fine-tuning com LoRA, tudo acessível sem trocar de plataforma nem gerenciar contas separadas.
Aqui está um ponto de partida simples para o fluxo de trabalho:
- Escolha um modelo de acordo com o tipo de conteúdo. Para retratos e sujeitos humanos, comece com o Hunyuan Image 2.1. Para cenas complexas ou fotografia de produto, experimente o Seedream 4.5 ou o Wan 2.7 Image Pro.
- Escreva um prompt descritivo usando linguagem de fotografia: mencione a direção da luz, o ângulo da câmera, a distância do sujeito e quaisquer detalhes de material ou textura que importem para a foto.
- Gere de 3 a 5 variações antes de decidir um rumo. A variação entre gerações é um recurso, não um defeito. O segundo ou o terceiro resultado costuma ser mais forte que o primeiro.
- Itere por meio de edição usando o Qwen Image Edit Plus se quiser refinar uma imagem específica em vez de gerar tudo de novo do zero.
- Aplique LoRA se precisar de consistência de estilo em um lote. O Flux 2 Klein 9B Base LoRA é o padrão atual para esse fluxo de trabalho.
A parte que merece atenção
A geração de imagens por IA em 2026 não é mais uma novidade. A qualidade de saída de modelos como o GPT Image 2, o Seedream 4.5 e o Wan 2.7 Image Pro é de nível de produção para uma lista crescente de casos de uso. A tecnologia ainda tem limitações reais, especialmente em consistência e detalhes finos, mas essas limitações diminuem a cada novo lançamento de modelo.
A mudança mais importante é a acessibilidade. O que exigia muita experiência e recursos em 2024 agora está ao alcance de qualquer pessoa com uma ideia clara e uma boa descrição. O teto subiu, mas o piso também.
Se você ainda não testou a geração atual de modelos, agora é a hora de começar. Escolha uma imagem de que precisa para um projeto, escreva uma descrição focada e rode-a em três ou quatro dos modelos disponíveis no PicassoIA. Os resultados vão te dizer mais do que qualquer artigo de comparação.


