Algo cambió en la generación de imágenes con IA a finales de 2025, y para cuando llegó 2026, las herramientas que antes parecían experimentales ya estaban listas para producción de verdad. Las imágenes que salen de los mejores modelos de hoy no solo son mejores que las de hace dos años: son diferentes en la forma de tratar la luz, la textura, la anatomía humana y la complejidad de la escena. Si revisaste el estado de la generación de imágenes con IA hace seis meses, tienes que ponerte al día.
Este artículo analiza qué cambió de verdad en 2026, qué modelos marcaron la diferencia, dónde la tecnología todavía tiene problemas y cómo puedes empezar a generar con este nivel de calidad ahora mismo.
Antes de 2026: la referencia que todos olvidan
Es fácil mirar los resultados de hoy y suponer que el progreso siempre fue así de lineal. No lo fue.
La resolución era un privilegio
En 2023 y 2024, generar de forma constante imágenes fotorrealistas con calidad 1080p requería acceso a una API costosa, un prompt muy trabajado y, a menudo, un posprocesado con modelos de escalado separados. El resultado de texto a imagen en el nivel asequible se veía borroso, carecía de microdetalle y exigía varios intentos para conseguir algo presentable.
La distancia entre lo que era técnicamente posible y lo que era realmente accesible era enorme. Podías obtener resultados espectaculares, pero solo si sabías qué ajustes usar, tenías acceso al hardware o al nivel de API adecuados y estabas dispuesto a dedicar tiempo a iterar. La mayoría de los creadores no hacían nada de eso.
El código abierto frente al código cerrado cambió de papel
En 2024, la narrativa era sencilla: los modelos de código cerrado de OpenAI tenían mejor calidad, mientras que los de código abierto ofrecían más control y personalización. Esa división se ha difuminado bastante desde entonces.
Stable Diffusion 3 acercó mucho el lado del código abierto a la calidad de los modelos cerrados. Mientras tanto, las plataformas cerradas empezaron a integrar el ajuste fino con enfoques al estilo LoRA. Los muros entre "control" y "calidad" comenzaron a caer, y eso preparó el terreno para todo lo que vino en 2026.
Lo que 2026 trajo de verdad
La historia real de 2026 no es un único avance. Son varias mejoras que se solaparon en cuestión de meses y que, en conjunto, elevaron el nivel mínimo de lo que se considera un resultado aceptable.
GPT Image 2 cambió el punto de partida
GPT Image 2 llegó con una filosofía distinta a la de su predecesor. En lugar de centrarse en la novedad creativa pura, optimizó la precisión al seguir instrucciones y el fotorrealismo, de una forma que lo hace parecer menos una herramienta creativa y más un generador de activos de producción. Pídele una foto de producto sobre fondo blanco con un ángulo de sombra concreto y la cumple. Pídele un retrato con un montaje de iluminación determinado y el resultado está notablemente más cerca de lo que describiste.
Esa fiabilidad fue el verdadero avance, no la resolución ni la variedad de estilos. Cuando un modelo hace lo que describiste de verdad, en lugar de lo que interpreta que quisiste decir, los flujos de trabajo cambian por completo.
💡 GPT Image 2 responde especialmente bien al lenguaje propio de la fotografía. Menciona tipos de objetivo, número f, ISO y dirección de la luz en tus prompts para obtener resultados mucho más controlados.
Seedream 4.5 y el estándar 4K
Seedream 4.5 de ByteDance estableció el 4K como una expectativa realista de resultado, en lugar de una función premium. El modelo genera imágenes con resoluciones en las que se ven los poros individuales, los tejidos de la tela y las texturas de superficie sin necesidad de escalado. Para fotógrafos, diseñadores de producto y equipos de marketing, esto eliminó un paso completo del proceso de posproducción.
Lo que hace especialmente notable a Seedream 4.5 es cómo maneja las escenas complejas. Las composiciones con varios sujetos, con un render de profundidad de campo realista, sombras proyectadas con precisión sobre varios objetos y una iluminación coherente desde una única fuente en todo el encuadre, han sido históricamente poco fiables en los modelos de texto a imagen. Seedream 4.5 lo consigue con mucha más constancia que cualquier opción disponible en 2024.
Wan 2.7 eleva el listón del detalle
Wan 2.7 Image Pro de Wan Video marcó un nuevo estándar en el render de microdetalle en imágenes generadas con IA. El modelo trata las texturas de superficie de una forma que resulta realmente física. La piedra, la tela, la piel y el metal reaccionan de manera distinta a la luz en los resultados de Wan 2.7, algo que había sido una debilidad importante en los modelos de la generación anterior, que solían aplicar un brillo uniforme a todas las superficies sin importar el material.
El modelo estándar Wan 2.7 Image entrega resultados de 2K con características de calidad similares, pero con una generación más rápida, lo que lo hace más adecuado para flujos de trabajo iterativos en los que necesitas varias variaciones con rapidez.
Hunyuan Image 2.1 domina el realismo
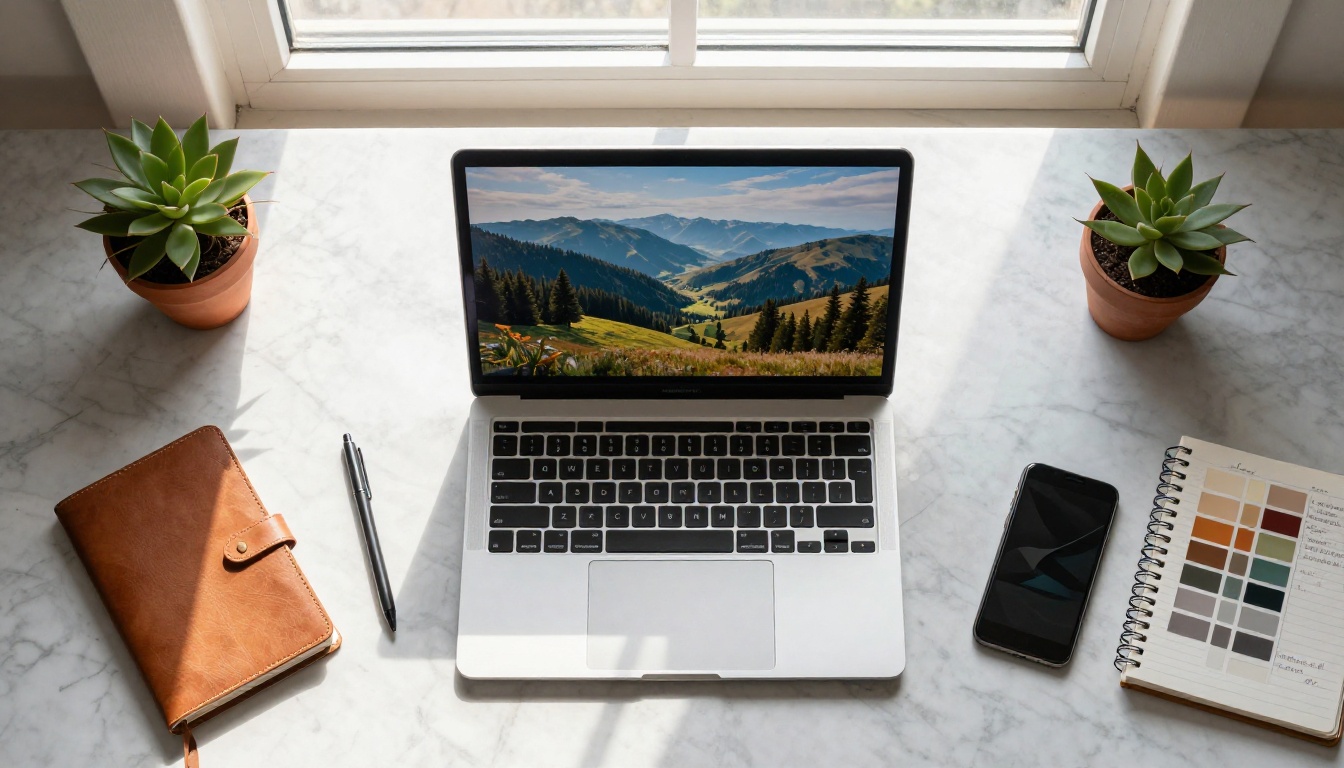
Hunyuan Image 2.1 de Tencent aborda el realismo desde un ángulo distinto al de los modelos occidentales. Mientras GPT Image 2 optimiza la precisión de las instrucciones y Seedream 4.5 la resolución bruta, Hunyuan Image 2.1 se centra en gran medida en los sujetos humanos: tonos de piel naturales, proporciones corporales realistas y expresiones faciales que no parecen congeladas ni artificiales.
Para las categorías de contenido con personas, retratos e imágenes de estilo de vida, Hunyuan Image 2.1 rinde a un nivel que compite directamente con la fotografía de estudio a una fracción del costo. Además, el modelo maneja los distintos tonos de piel con un sesgo notablemente menor que los modelos anteriores, lo que supone un avance real en la utilidad práctica.
El prompting en 2026 es diferente
Uno de los cambios menos comentados entre 2025 y 2026 es lo mucho más fácil que se ha vuelto el prompting. No porque la gente se haya vuelto más hábil, sino porque los modelos mejoraron al interpretar el lenguaje natural.
Menos trabajo, mejores resultados
La disciplina de ingeniería de prompts que se desarrolló entre 2022 y 2024, con sus listas de modificadores, sus prompts negativos y sus trucos de sintaxis elaborados, es cada vez menos necesaria con la generación actual de modelos. Reve Create y GPT Image 2 responden bien a descripciones conversacionales en lugar de prompts cargados de palabras clave.
Esto no quiere decir que la habilidad para escribir prompts no valga nada. Saber describir la iluminación, la composición y la atmósfera con términos concretos sigue dando resultados medibles mejores. Pero el mínimo para obtener "un resultado aceptable con poco esfuerzo" ha subido muchísimo. Una descripción de una sola frase que en 2023 habría dado resultados mediocres ahora produce algo realmente utilizable.
Estilo sin palabras extra
Los modelos anteriores necesitaban modificadores de estilo explícitos para no caer en una estética genérica: "photorealistic, 8K, cinematic, Kodak Portra" y así sucesivamente. Los mejores modelos actuales, como Fibo y Recraft 20B, han interiorizado una gama más amplia de estéticas y las aplican según el tema. Describe un producto y obtendrás fotografía de producto. Describe un paisaje y obtendrás algo que se lee como fotografía de paisaje, no como una ilustración pintada.
Esta inferencia contextual del estilo es uno de los cambios más silenciosos pero más influyentes de 2026. Significa que la generación de imágenes con IA se está volviendo realmente accesible para personas sin formación en fotografía ni en ingeniería de prompts.
El ajuste fino con LoRA para todos
Si 2024 fue el año en que LoRA se popularizó entre los usuarios avanzados, 2026 es el año en que se volvió práctico para cualquiera. La combinación de tiempos de entrenamiento más cortos, menores requisitos computacionales y mejor documentación ha hecho que el ajuste fino de modelos personalizados sea una opción realista para pequeños estudios y creadores independientes.
Qué significa ahora el entrenamiento personalizado
El ajuste fino con LoRA te permite entrenar un modelo con un estilo visual, un sujeto o una identidad de marca concretos, y después aplicar ese estilo a cualquier resultado generado. En la práctica, una marca de productos puede entrenar un modelo con 20 a 30 fotos de referencia y generar después imágenes de marketing coherentes, sin tener que describir de nuevo la estética del producto en cada prompt.
La barrera de costo y tiempo que hacía esto poco práctico en 2024 ha bajado mucho. Lo que antes requería una GPU potente y horas de entrenamiento ahora puede ejecutarse en minutos mediante flujos de trabajo en la nube.
Modelos LoRA de Flux 2 Klein
Flux 2 Klein 9B Base LoRA y Flux 2 Klein 4B Base LoRA, de Black Forest Labs, representan el estándar actual para la personalización con LoRA. La variante de 9B ofrece más fidelidad de estilo a costa de la velocidad de generación, mientras que el modelo de 4B logra un mejor equilibrio para los flujos de trabajo iterativos.
Ambos modelos admiten el entrenamiento con conjuntos de datos pequeños (con tan solo 15 a 20 imágenes), producen resultados coherentes que se ajustan de cerca al estilo de los datos de entrenamiento e integran con las herramientas de flujo de trabajo existentes sin necesidad de una configuración técnica compleja. Flux Redux Dev añade a esto la capacidad de crear variaciones de imagen, lo que permite generar varias interpretaciones de una imagen de referencia manteniendo la coherencia de estilo.
💡 Para entrenar con LoRA, selecciona tus imágenes con cuidado. Una variedad de ángulos e iluminación en tu conjunto de entrenamiento produce un comportamiento de LoRA más flexible que las imágenes demasiado parecidas entre sí.
Las diferencias reales entre modelos
Con tantas opciones sólidas disponibles, elegir un modelo no consiste en encontrar "el mejor" en términos absolutos. Consiste en ajustar los puntos fuertes del modelo a tu caso de uso concreto.
| Modelo | Mejor para | Resolución de salida | Velocidad |
|---|
| GPT Image 2 | Resultados precisos en las instrucciones | Hasta 4K | Media |
| Seedream 4.5 | Fotorrealismo 4K, escenas complejas | 4K | Media |
| Wan 2.7 Image Pro | Microdetalle, texturas de superficie | 4K | Más lenta |
| Hunyuan Image 2.1 | Sujetos humanos, retratos | 2K | Rápida |
| Flux 2 Klein 9B LoRA | Ajuste fino de estilo personalizado | Hasta 4K | Lenta |
| Recraft 20B | Inferencia contextual del estilo | Variable | Rápida |
Velocidad frente a calidad: las contrapartidas
Los modelos más rápidos de 2026, incluido Flux Schnell LoRA, no son los de mayor calidad. Esta contrapartida siempre ha existido, pero la diferencia se ha reducido. Los modelos rápidos de 2026 producen resultados que en 2024 se habrían considerado de alta calidad. Si necesitas volumen, los modelos de gama rápida ya son realmente viables para trabajo de producción, algo que hace dos años no lo eran.
La coherencia de los resultados sigue variando
Donde los modelos todavía divergen de forma notable es en la coherencia de los resultados. Ejecuta el mismo prompt 10 veces con cualquier modelo y obtendrás resultados claramente distintos cada vez. Parte de esa variación es deseable en el trabajo creativo, pero en los flujos de producción que requieren coherencia visual en un lote de imágenes, sigue siendo una limitación importante.
Modelos como Qwen Image Edit Plus lo solucionan en parte con flujos de modo edición, en los que partes de una imagen de referencia y la modificas en lugar de generar desde cero cada vez. Este enfoque produce resultados más coherentes porque el modelo tiene un ancla visual sobre la que trabajar.
Lo que todavía no está resuelto
El progreso de 2026 ha sido real y significativo. Pero para tener una visión honesta hay que reconocer dónde sigue fallando de forma fiable la generación de texto a imagen.
Manos, texto y detalles finos
Las manos siguen siendo el fallo más citado en la generación de imágenes con IA, y 2026 no lo ha resuelto del todo. Todos los modelos actuales producen manos con errores anatómicos ocasionales: dedos de más, nudillos fusionados o ángulos de articulación imposibles. La tasa de error ha bajado frente a 2023, pero no ha llegado al nivel de fiabilidad de los rostros o las telas.
El texto legible dentro de las imágenes es igual de poco fiable. La mayoría de los modelos producen texto que parece tipográficamente plausible a distancia, pero que se desmorona al mirarlo de cerca. Generar imágenes en las que palabras o frases concretas deban leerse con exactitud sigue sin ser un flujo de trabajo fiable con ningún modelo actual.
Coherencia de personajes entre imágenes
El problema sin resolver más difícil de 2026 es la coherencia de personajes entre varias imágenes generadas. Si necesitas que la misma persona aparezca en diez escenas distintas, hoy no tienes una forma fiable de garantizar que se vea igual en cada una sin un posprocesado importante o flujos de edición de imagen a imagen.
Qwen Image Edit y modelos similares de modo edición ayudan al permitirte mantener un personaje de referencia y cambiar solo el entorno, pero incluso este enfoque produce desviaciones a lo largo de varias iteraciones. Este es el problema en el que la siguiente generación de modelos trabaja con más empeño.
Cómo generar a este nivel ahora mismo
No necesitas montar una infraestructura local ni gestionar tokens de API de varios proveedores para acceder a todos estos modelos. Todos los modelos que se analizan en este artículo están disponibles directamente en PicassoIA.
La plataforma te da acceso a más de 90 modelos de texto a imagen a través de una única interfaz, así que puedes probar GPT Image 2, Seedream 4.5, Wan 2.7 Image Pro y Hunyuan Image 2.1 uno junto a otro con el mismo prompt para ver cuál se adapta mejor a tu caso de uso. Más allá del texto a imagen, también encontrarás herramientas para eliminar fondos, escalar la resolución con superresolución, editar imágenes con prompts de texto y ajustar modelos con LoRA, todo ello accesible sin cambiar de plataforma ni gestionar cuentas separadas.
Este es un flujo de trabajo inicial sencillo:
- Elige un modelo según el tipo de contenido. Para retratos y sujetos humanos, empieza con Hunyuan Image 2.1. Para escenas complejas o fotografía de producto, prueba Seedream 4.5 o Wan 2.7 Image Pro.
- Escribe un prompt descriptivo con lenguaje fotográfico: menciona la dirección de la luz, el ángulo de cámara, la distancia al sujeto y cualquier detalle de material o textura que importe para la toma.
- Genera de 3 a 5 variaciones antes de decidir una dirección. La variación entre generaciones es una característica, no un fallo. El segundo o tercer resultado suele ser más sólido que el primero.
- Itera mediante edición con Qwen Image Edit Plus si quieres refinar una imagen concreta en lugar de volver a generarla desde cero.
- Aplica LoRA si necesitas coherencia de estilo en un lote. Flux 2 Klein 9B Base LoRA es el estándar actual para este flujo de trabajo.
La parte a la que vale la pena prestar atención
La generación de imágenes con IA en 2026 ya no es una novedad. La calidad de salida de modelos como GPT Image 2, Seedream 4.5 y Wan 2.7 Image Pro es de nivel de producción para una lista creciente de casos de uso. La tecnología sigue teniendo limitaciones reales, sobre todo en coherencia y detalle fino, pero esas limitaciones se reducen con cada nueva versión de modelo.
El cambio más importante es la accesibilidad. Lo que antes exigía mucha experiencia y recursos en 2024 hoy está al alcance de cualquiera que tenga una idea clara y una descripción bien escrita. El techo ha subido, pero también el mínimo.
Si todavía no has probado la generación actual de modelos, ahora es el momento de empezar. Elige una imagen que necesites para un proyecto, escribe una descripción concreta y pruébala con tres o cuatro de los modelos disponibles en PicassoIA. Los resultados te dirán más que cualquier artículo comparativo.


