Quelque chose a basculé dans la génération d’images par IA vers la fin de 2025, et à l’arrivée de 2026, les outils qui semblaient encore expérimentaux étaient devenus réellement prêts pour la production. Les images produites aujourd’hui par les meilleurs modèles ne sont pas seulement meilleures qu’il y a deux ans : elles sont radicalement différentes dans la façon dont elles gèrent la lumière, la texture, l’anatomie humaine et la complexité des scènes. Si vous avez suivi l’état de la génération d’images par IA pour la dernière fois il y a six mois, il vous faut un peu de rattrapage.
Cet article fait le point sur ce qui a réellement changé en 2026, sur les modèles qui ont fait avancer les choses, sur les points où la technologie peine encore, et sur la manière de commencer dès maintenant à générer à ce nouveau niveau de qualité.
Avant 2026 : la référence que tout le monde oublie
Il est facile de regarder les résultats d’aujourd’hui et de supposer que les progrès ont toujours été aussi linéaires. Ce n’était pas le cas.
La résolution était un privilège
En 2023 et 2024, obtenir de manière régulière des images photoréalistes de qualité 1080p demandait un accès API coûteux, un travail minutieux sur le prompt et, souvent, un post-traitement passant par des modèles d’upscaling séparés. Le résultat moyen de texte vers image, à un tarif abordable, paraissait flou, manquait de micro-détails et exigeait plusieurs tentatives avant d’obtenir quelque chose de présentable.
L’écart entre ce qui était techniquement possible et ce qui était réellement accessible était énorme. On pouvait obtenir des résultats saisissants, mais seulement à condition de savoir exactement quels réglages utiliser, de disposer du bon matériel ou du bon niveau d’API, et d’accepter de passer du temps à itérer. La plupart des créateurs ne faisaient rien de tout cela.
Open source face au code fermé : les rôles ont changé
En 2024, le discours était simple : les modèles fermés d’OpenAI offraient une meilleure qualité, tandis que les modèles open source offraient davantage de contrôle et de personnalisation. Cette opposition s’est nettement estompée depuis.
Stable Diffusion 3 a considérablement rapproché le côté open source de la qualité des modèles fermés. Dans le même temps, les plateformes fermées ont commencé à intégrer le fine-tuning via des approches de type LoRA. Les frontières entre « contrôle » et « qualité » ont commencé à tomber, ce qui a préparé tout ce qui a suivi en 2026.
Ce que 2026 a réellement apporté
L’histoire réelle de 2026 ne tient pas à une percée unique. Elle tient à plusieurs améliorations qui se sont succédé à quelques mois d’intervalle et qui ont, ensemble, relevé le niveau minimal de ce qui est considéré comme acceptable.
GPT Image 2 a changé la référence
GPT Image 2 est arrivé avec une philosophie différente de celle de son prédécesseur. Plutôt que de privilégier la nouveauté créative brute, il a été optimisé pour la précision dans le suivi des instructions et le photoréalisme, au point de ressembler davantage à un générateur de visuels de production qu’à un outil créatif. Demandez-lui une photo de produit sur fond blanc avec un angle d’ombre précis, et il la fournira. Demandez-lui un portrait avec un dispositif d’éclairage particulier, et le résultat correspondra nettement plus à ce que vous avez décrit.
Cette fiabilité a été la véritable percée, et non la résolution ni la variété des styles. Lorsqu’un modèle fait ce que vous avez réellement décrit, et non ce qu’il interprète de votre description, les flux de travail changent complètement.
💡 GPT Image 2 répond particulièrement bien au vocabulaire propre à la photographie. Mentionnez les types d’objectifs, l’ouverture, la sensibilité ISO et la direction de la lumière dans vos prompts pour obtenir des résultats nettement mieux contrôlés.
Seedream 4.5 et le standard 4K
Seedream 4.5 de ByteDance a fait du 4K une attente réaliste en matière de résultat, et non plus une fonctionnalité premium. Le modèle génère des images à des résolutions où les pores individuels, les tissages des tissus et les textures de surface sont visibles sans upscaling. Pour les photographes, les designers produit et les équipes marketing, cela a supprimé une étape entière du post-traitement.
Ce qui rend Seedream 4.5 particulièrement remarquable, c’est sa gestion des scènes complexes. Les compositions à plusieurs sujets avec un rendu réaliste de la profondeur de champ, des ombres portées précises sur plusieurs objets et un éclairage cohérent provenant d’une seule source sur l’ensemble de l’image étaient, historiquement, peu fiables dans les modèles de texte vers image. Seedream 4.5 réussit ces aspects beaucoup plus régulièrement que tout ce qui existait en 2024.
Wan 2.7 relève la barre du détail
Wan 2.7 Image Pro de Wan Video a fixé un nouveau standard pour le rendu des micro-détails dans les images générées par IA. Le modèle traite les textures de surface d’une manière qui paraît réellement physique. La pierre, le tissu, la peau et le métal réagissent tous différemment à la lumière avec Wan 2.7, ce qui constituait une faiblesse majeure des modèles de la génération précédente, qui appliquaient souvent un reflet uniforme aux surfaces quel que soit le matériau.
Le modèle standard Wan 2.7 Image fournit une sortie en 2K aux caractéristiques de qualité comparables, mais avec une vitesse de génération plus élevée, ce qui le rend plus adapté aux flux de travail itératifs où vous avez besoin de plusieurs variantes rapidement.
Hunyuan Image 2.1 maîtrise le réalisme
Hunyuan Image 2.1 de Tencent aborde le réalisme sous un angle différent de celui des modèles occidentaux. Là où GPT Image 2 optimise la précision des instructions et Seedream 4.5 la résolution brute, Hunyuan Image 2.1 se concentre fortement sur les sujets humains : des teintes de peau naturelles, des proportions corporelles réalistes et des expressions faciales qui ne paraissent ni figées ni artificielles.
Pour les catégories de contenus mettant en scène des personnes, des portraits et des visuels de style de vie, Hunyuan Image 2.1 atteint un niveau qui rivalise directement avec la photographie de studio, pour une fraction du coût. Le modèle gère également les différentes teintes de peau avec nettement moins de biais que les modèles antérieurs, ce qui représente un réel progrès en matière d’utilisation concrète.
Le prompting en 2026 est différent
L’un des changements moins évoqués entre 2025 et 2026 tient à la facilité accrue du prompting. Non pas parce que les utilisateurs se sont améliorés, mais parce que les modèles sont devenus meilleurs pour interpréter le langage naturel.
Moins de travail, de meilleurs résultats
La discipline d’ingénierie des prompts qui s’est développée entre 2022 et 2024, avec ses listes de modificateurs, ses prompts négatifs et ses astuces de syntaxe élaborées, devient moins nécessaire avec la génération actuelle de modèles. Reve Create et GPT Image 2 répondent tous deux bien à des descriptions conversationnelles plutôt qu’à des prompts bourrés de mots-clés.
Cela ne signifie pas que la maîtrise du prompting n’a plus aucune valeur. Savoir décrire l’éclairage, la composition et l’ambiance en termes précis produit toujours des résultats nettement meilleurs. Mais le seuil de « résultat acceptable avec un effort minimal » a considérablement monté. Une description d’une seule phrase qui aurait donné un résultat médiocre en 2023 produit aujourd’hui quelque chose de réellement utilisable.
Le style sans mots supplémentaires
Les modèles précédents exigeaient des modificateurs de style explicites pour éviter de tomber dans une esthétique générique : « photoréaliste, 8K, cinématographique, Kodak Portra » et ainsi de suite. Les meilleurs modèles actuels, comme Fibo et Recraft 20B, ont intégré une gamme d’esthétiques plus large et les appliquent de façon contextuelle selon le sujet. Décrivez un produit et vous obtenez une photographie de produit. Décrivez un paysage et vous obtenez quelque chose qui se lit comme une photographie de paysage, et non comme une illustration peinte.
Cette inférence contextuelle du style est l’un des changements les plus discrets, mais aussi les plus marquants, de 2026. Elle signifie que la génération d’images par IA devient réellement accessible aux personnes qui n’ont de formation ni en photographie ni en ingénierie des prompts.
Le LoRA fine-tuning pour tous
Si 2024 a été l’année où le LoRA s’est popularisé auprès des utilisateurs avancés, 2026 est l’année où il est devenu pratique pour tout le monde. La combinaison de temps d’entraînement plus courts, de besoins de calcul plus faibles et d’une documentation de meilleure qualité a fait du fine-tuning personnalisé d’un modèle une option réaliste pour les petits studios et les créateurs indépendants.
Ce que signifie aujourd’hui l’entraînement personnalisé
Le LoRA fine-tuning vous permet d’entraîner un modèle sur un style visuel, un sujet ou une identité de marque précis, puis d’appliquer ce style à n’importe quel résultat généré. Concrètement, une marque peut entraîner un modèle sur 20 à 30 photos de référence, puis générer des visuels marketing cohérents sans redécrire l’esthétique du produit dans chaque prompt.
Le coût et la contrainte de temps qui rendaient cette démarche peu praticable en 2024 ont nettement diminué. Ce qui exigeait autrefois un GPU puissant et des heures d’entraînement peut désormais tourner en quelques minutes grâce à des pipelines dans le cloud.
Les modèles LoRA de Flux 2 Klein
Les Flux 2 Klein 9B Base LoRA et Flux 2 Klein 4B Base LoRA de Black Forest Labs représentent le standard actuel de la personnalisation par LoRA. La variante 9B offre une meilleure fidélité stylistique au prix d’une vitesse de génération plus faible, tandis que le modèle 4B trouve un meilleur équilibre pour les flux de travail itératifs.
Les deux modèles acceptent l’entraînement sur de petits jeux de données (à partir de 15 à 20 images seulement), produisent des résultats cohérents qui reproduisent fidèlement le style des données d’entraînement, et s’intègrent aux outils de flux de travail existants sans configuration technique importante. Flux Redux Dev ajoute à cela la possibilité de créer des variations d’image, ce qui permet de générer plusieurs interprétations d’une image de référence tout en conservant la cohérence du style.
💡 Pour l’entraînement LoRA, sélectionnez soigneusement vos images d’entraînement. La diversité des angles et de l’éclairage au sein de votre jeu d’entraînement donne un comportement LoRA plus souple que des images trop semblables entre elles.
Les véritables écarts entre les modèles
Avec autant d’options solides disponibles aujourd’hui, le choix d’un modèle ne consiste pas à trouver « le meilleur » en valeur absolue. Il s’agit de faire correspondre les points forts du modèle à votre cas d’usage précis.
| Modèle | Idéal pour | Résolution de sortie | Vitesse |
|---|
| GPT Image 2 | Résultats fidèles aux instructions | Jusqu’à 4K | Moyenne |
| Seedream 4.5 | Photoréalisme 4K, scènes complexes | 4K | Moyenne |
| Wan 2.7 Image Pro | Micro-détails, textures de surface | 4K | Plus lente |
| Hunyuan Image 2.1 | Sujets humains, portraits | 2K | Rapide |
| Flux 2 Klein 9B LoRA | Fine-tuning de style personnalisé | Jusqu’à 4K | Lente |
| Recraft 20B | Inférence contextuelle du style | Variable | Rapide |
Compromis entre vitesse et qualité
Les modèles les plus rapides de 2026, y compris Flux Schnell LoRA, ne sont pas ceux qui offrent la meilleure qualité. Ce compromis a toujours existé, mais l’écart s’est réduit. Les modèles rapides de 2026 produisent des résultats qui auraient été jugés de haute qualité en 2024. Si vous avez besoin de volume, les modèles de gamme rapide sont désormais réellement viables pour un travail de production, ce qu’ils n’étaient tout simplement pas il y a deux ans.
La constance des résultats varie toujours
Là où les modèles divergent encore nettement, c’est dans la constance des résultats. Lancez le même prompt 10 fois avec n’importe quel modèle et vous obtiendrez à chaque fois des résultats sensiblement différents. Une part de cette variation est souhaitable pour un travail créatif, mais pour les flux de travail de production qui exigent une cohérence visuelle sur un lot d’images, cela reste une limite importante.
Des modèles comme Qwen Image Edit Plus répondent en partie à ce problème grâce à des flux de travail en mode édition, où vous partez d’une image de référence et la modifiez au lieu de tout générer à partir de zéro à chaque fois. Cette approche produit des résultats plus cohérents, car le modèle dispose d’un point d’ancrage visuel sur lequel s’appuyer.
Ce qui n’est toujours pas réglé
Les progrès réalisés en 2026 sont réels et significatifs. Mais un bilan honnête exige de reconnaître les domaines dans lesquels la génération de texte vers image échoue encore de façon fiable.
Mains, texte et détails fins
Les mains restent le point de défaillance le plus souvent cité dans la génération d’images par IA, et 2026 n’a pas entièrement réglé ce problème. Tous les modèles actuels produisent parfois des erreurs anatomiques sur les mains : doigts en trop, jointures fusionnées ou angles d’articulation invraisemblables. Le taux d’erreur a baissé par rapport à 2023, mais il n’a pas atteint le niveau de fiabilité des visages ou des tissus.
Le texte lisible dans les images est tout aussi peu fiable. La plupart des modèles produisent un texte qui paraît typographiquement plausible de loin, mais qui se désagrège à l’examen de près. Générer des images où des mots ou des phrases précises doivent être lisibles et exacts n’est toujours pas un flux de travail fiable avec aucun modèle actuel.
La cohérence des personnages d’une image à l’autre
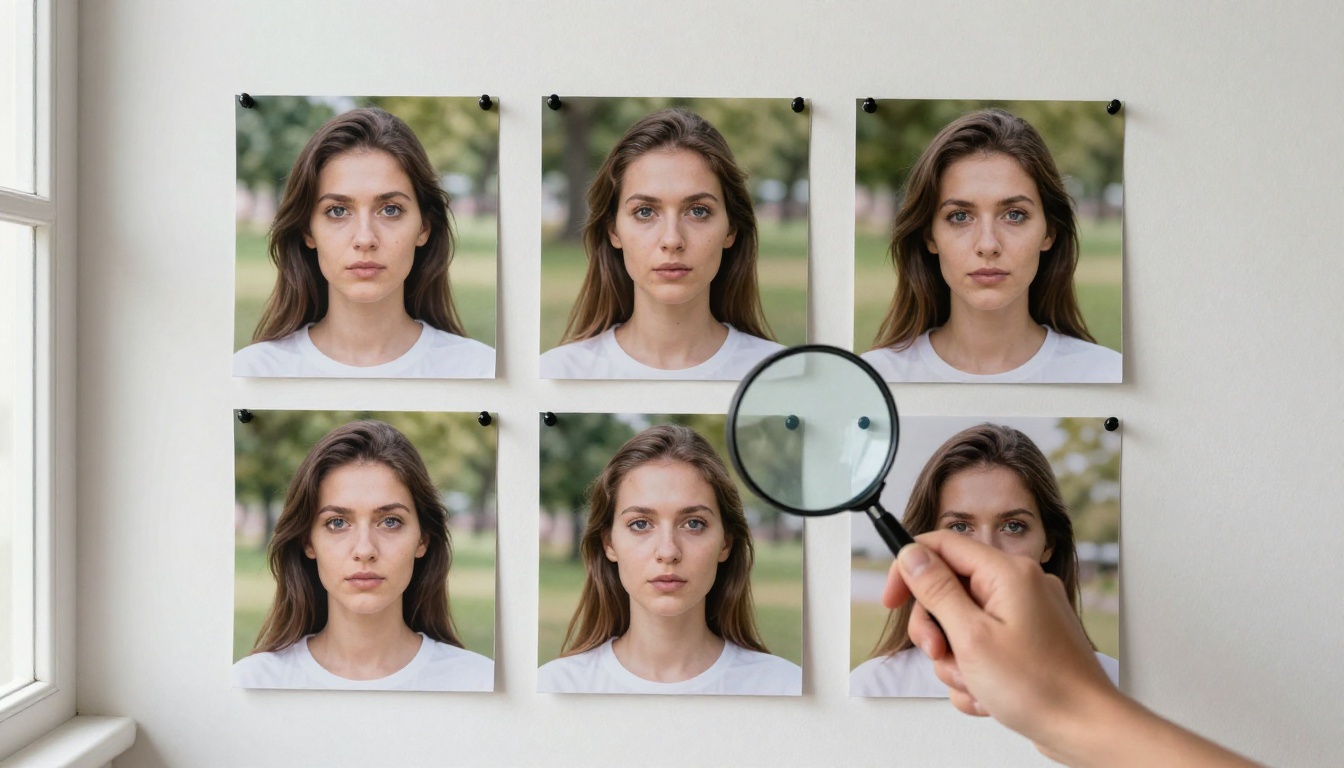
Le problème non résolu le plus difficile en 2026 est la cohérence des personnages sur plusieurs images générées. Si vous avez besoin que la même personne apparaisse dans dix scènes différentes, vous n’avez actuellement aucun moyen fiable de garantir qu’elle ressemble à elle-même dans chacune sans un post-traitement important ou des flux de retouche image vers image.
Qwen Image Edit et des modèles similaires en mode édition aident en vous permettant de conserver un personnage de référence et de ne changer que l’environnement, mais même cette approche produit une dérive au fil de plusieurs itérations. C’est le problème que la prochaine génération de modèles cherche le plus activement à résoudre.
Comment générer à ce niveau dès maintenant
Vous n’avez pas besoin de mettre en place une infrastructure locale ni de gérer des tokens API auprès de plusieurs fournisseurs pour accéder à tous ces modèles. Tous les modèles évoqués dans cet article sont disponibles directement sur PicassoIA.
La plateforme vous donne accès à plus de 90 modèles de texte vers image via une interface unique, ce qui vous permet de tester GPT Image 2, Seedream 4.5, Wan 2.7 Image Pro et Hunyuan Image 2.1 côte à côte avec le même prompt pour voir lequel correspond à votre cas d’usage. Au-delà du texte vers image, vous trouverez aussi des outils de suppression d’arrière-plan, d’upscaling en super-résolution, d’édition d’images par prompts textuels et de fine-tuning LoRA, tous accessibles sans changer de plateforme ni gérer des comptes séparés.
Voici un point de départ simple pour votre flux de travail :
- Choisissez un modèle selon le type de contenu. Pour les portraits et les sujets humains, commencez par Hunyuan Image 2.1. Pour les scènes complexes ou la photographie de produit, essayez Seedream 4.5 ou Wan 2.7 Image Pro.
- Rédigez un prompt descriptif en utilisant le vocabulaire de la photographie : précisez la direction de la lumière, l’angle de prise de vue, la distance au sujet et tous les détails de matière ou de texture qui comptent pour la prise de vue.
- Générez 3 à 5 variantes avant de choisir une direction. La variation entre les générations est une fonctionnalité, non un défaut. Le deuxième ou le troisième résultat est souvent plus réussi que le premier.
- Itérez par l’édition avec Qwen Image Edit Plus si vous souhaitez affiner une image précise plutôt que de la générer à nouveau depuis zéro.
- Appliquez un LoRA si vous avez besoin d’une cohérence stylistique sur un lot. Flux 2 Klein 9B Base LoRA est le standard actuel pour ce flux de travail.
La partie qui mérite votre attention
La génération d’images par IA en 2026 n’est plus une nouveauté. La qualité des résultats produits par des modèles comme GPT Image 2, Seedream 4.5 et Wan 2.7 Image Pro est de niveau production pour une liste croissante de cas d’usage. La technologie présente encore de réelles limites, notamment en matière de cohérence et de détails fins, mais ces limites se réduisent à chaque nouvelle version de modèle.
Le changement le plus important tient à l’accessibilité. Ce qui exigeait une expertise et des moyens considérables en 2024 est aujourd’hui à la portée de quiconque a une idée claire et une description bien écrite. Le plafond s’est élevé, mais le plancher aussi.
Si vous n’avez pas encore testé la génération actuelle de modèles, c’est le moment de commencer. Choisissez une image dont vous avez besoin pour un projet, rédigez une description ciblée et lancez-la dans trois ou quatre des modèles disponibles sur PicassoIA. Les résultats vous en diront plus que n’importe quel article comparatif.


