2025 के आखिरी हिस्से के आसपास AI इमेज जनरेशन में कुछ बदलाव आया, और 2026 आते-आते जो टूल कभी प्रयोग जैसे लगते थे, वे सच में प्रोडक्शन के लिए तैयार हो गए। आज के टॉप मॉडल से निकलने वाली इमेज सिर्फ़ दो साल पहले से बेहतर नहीं हैं; वे रोशनी, टेक्सचर, इंसानी शरीर रचना और सीन की जटिलता को संभालने में मूल रूप से अलग हैं। अगर आपने छह महीने पहले AI इमेज जनरेशन की स्थिति देखी थी, तो आपको कुछ नया जानना बाकी है।
यह लेख बताता है कि 2026 में वास्तव में क्या बदला, कौन से मॉडल ने असली फ़र्क डाला, तकनीक अब भी कहाँ लड़खड़ाती है, और आप इस नई क्वालिटी के स्तर पर अभी से जनरेट करना कैसे शुरू कर सकते हैं।
2026 से पहले: वह बेसलाइन जिसे सब भूल जाते हैं
आज के नतीजों को देखकर यह मान लेना आसान है कि प्रगति हमेशा इतनी ही सीधी रेखा में रही होगी। ऐसा नहीं था।
रेज़ोल्यूशन एक विशेषाधिकार था
2023 और 2024 में 1080p क्वालिटी की फ़ोटोरियलिस्टिक इमेज लगातार बनाने के लिए महँगे API एक्सेस, सावधानी से लिखे गए प्रॉम्प्ट और अक्सर अलग अपस्केलिंग मॉडल से पोस्ट-प्रोसेसिंग की ज़रूरत पड़ती थी। सस्ते टियर पर औसत टेक्स्ट-टू-इमेज नतीजा धुंधला दिखता था, उसमें माइक्रो-डिटेल नहीं होता था, और कुछ दिखाने लायक पाने के लिए कई बार दोबारा कोशिश करनी पड़ती थी।
जो तकनीकी रूप से संभव था और जो व्यावहारिक रूप से उपलब्ध था, उनके बीच का फ़ासला बहुत बड़ा था। शानदार नतीजे मिल सकते थे, लेकिन तभी जब आप ठीक-ठीक जानते हों कि कौन सी सेटिंग इस्तेमाल करनी है, आपके पास सही हार्डवेयर या API टियर हो, और आप इटरेशन में समय लगाने को तैयार हों। ज़्यादातर क्रिएटर यह सब नहीं कर रहे थे।
ओपन सोर्स बनाम क्लोज़्ड सोर्स ने भूमिकाएँ बदल दीं
2024 में कहानी सीधी थी: OpenAI के क्लोज़्ड सोर्स मॉडल की क्वालिटी बेहतर थी, जबकि ओपन सोर्स मॉडल ज़्यादा कंट्रोल और कस्टमाइज़ेशन देते थे। वह बँटवारा अब काफ़ी धुंधला हो गया है।
Stable Diffusion 3 ने ओपन सोर्स पक्ष को क्लोज़्ड-सोर्स क्वालिटी के काफ़ी करीब ला दिया। इसी बीच क्लोज़्ड सोर्स प्लेटफ़ॉर्म LoRA-स्टाइल तरीकों से फाइन-ट्यूनिंग देने लगे। "कंट्रोल" और "क्वालिटी" के बीच की दीवारें गिरने लगीं, और इसी ने 2026 में आगे आने वाली हर चीज़ की ज़मीन तैयार की।
2026 ने असल में क्या दिया
2026 की असली कहानी कोई एक ब्रेकथ्रू नहीं है। यह कई आपस में जुड़े सुधार हैं, जो कुछ ही महीनों के अंतर पर आए और सामूहिक रूप से "स्वीकार्य" आउटपुट के न्यूनतम स्तर को ऊपर ले गए।
GPT Image 2 ने बेसलाइन बदल दी
GPT Image 2 अपने पिछले वर्ज़न से अलग दर्शन लेकर आया। कच्ची रचनात्मक नवीनता पर ध्यान देने के बजाय इसने इंस्ट्रक्शन-फ़ॉलोइंग की सटीकता और फ़ोटोरियलिज़्म को अनुकूलित किया, जिससे यह कम क्रिएटिव टूल और ज़्यादा प्रोडक्शन एसेट जनरेटर जैसा लगने लगा। अगर आप इससे सफ़ेद बैकग्राउंड पर किसी प्रोडक्ट फ़ोटो के लिए खास शैडो एंगल माँगें, तो यह वैसा ही देता है। किसी पोर्ट्रेट के लिए खास लाइटिंग सेटअप माँगें, तो नतीजा आपके बताए विवरण के नापने योग्य रूप से ज़्यादा करीब होता है।
यह भरोसेमंदी ही असली ब्रेकथ्रू थी, न कि रेज़ोल्यूशन या स्टाइल की रेंज। जब मॉडल वही करता है जो आपने असल में बताया था, न कि वह जो आपके विवरण का अपने हिसाब से मतलब निकालता है, तब वर्कफ़्लो पूरी तरह बदल जाते हैं।
💡 GPT Image 2 फ़ोटोग्राफ़ी-विशिष्ट भाषा पर खासतौर पर अच्छी प्रतिक्रिया देता है। ज़्यादा नियंत्रित नतीजों के लिए अपने प्रॉम्प्ट में लेंस के प्रकार, f-stop, ISO और लाइट की दिशा का ज़िक्र करें।
Seedream 4.5 और 4K का मानक
ByteDance के Seedream 4.5 ने 4K को प्रीमियम फ़ीचर नहीं, बल्कि एक वास्तविक आउटपुट अपेक्षा बना दिया। यह मॉडल ऐसे रेज़ोल्यूशन पर इमेज बनाता है जहाँ अलग-अलग रोमछिद्र, फ़ैब्रिक की बुनाई और सतह के टेक्सचर बिना अपस्केलिंग के दिखते हैं। फ़ोटोग्राफ़र, प्रोडक्ट डिज़ाइनर और मार्केटिंग टीमों के लिए इससे पोस्ट-प्रोसेसिंग पाइपलाइन का एक पूरा चरण हट गया।
Seedream 4.5 को खास बनाने वाली बात यह है कि यह जटिल सीन कैसे संभालता है। एक से ज़्यादा सब्जेक्ट वाली कंपोज़िशन, फ़ोटोरियलिस्टिक डेप्थ-ऑफ़-फ़ील्ड रेंडरिंग, कई वस्तुओं पर सटीक शैडो, और एक ही स्रोत से पूरे फ़्रेम में एकसार रोशनी, ये सब टेक्स्ट-टू-इमेज मॉडल में ऐतिहासिक रूप से भरोसेमंद नहीं थे। 2024 में उपलब्ध किसी भी चीज़ की तुलना में यह इन्हें कहीं ज़्यादा लगातार सही करता है।
Wan 2.7 ने डिटेल का स्तर ऊँचा किया
Wan Video का Wan 2.7 Image Pro AI-जनरेटेड इमेज में माइक्रो-डिटेल रेंडरिंग के लिए नया मानक बना। यह मॉडल सतह के टेक्सचर को इस तरह संभालता है कि वे सच में भौतिक लगते हैं। Wan 2.7 के आउटपुट में पत्थर, फ़ैब्रिक, त्वचा और धातु, सब रोशनी के नीचे अलग तरह से बर्ताव करते हैं। पिछली पीढ़ी के मॉडल की यह बड़ी कमज़ोरी थी, जो सामग्री के प्रकार की परवाह किए बिना सतहों पर एक जैसी चमक लगा देते थे।
स्टैंडर्ड Wan 2.7 Image मॉडल 2K आउटपुट देता है, जिसकी क्वालिटी की विशेषताएँ भी लगभग वैसी ही हैं, लेकिन जनरेशन की गति तेज़ है। इसलिए यह उन इटरेटिव वर्कफ़्लो के लिए ज़्यादा उपयुक्त है जहाँ आपको जल्दी-जल्दी कई वैरिएशन चाहिए।
Hunyuan Image 2.1 ने रियलिज़्म को सही पकड़ा
Tencent का Hunyuan Image 2.1 रियलिज़्म तक एक अलग रास्ते से पहुँचता है, जो पश्चिमी मॉडल से अलग है। जहाँ GPT Image 2 इंस्ट्रक्शन की सटीकता पर और Seedream 4.5 कच्चे रेज़ोल्यूशन पर ज़ोर देता है, वहीं Hunyuan Image 2.1 इंसानी सब्जेक्ट पर गहरा ध्यान देता है: प्राकृतिक त्वचा के रंग, वास्तविक शरीर अनुपात, और ऐसे चेहरे के भाव जो जमे हुए या नकली न लगें।
लोगों, पोर्ट्रेट और लाइफ़स्टाइल इमेज से जुड़ी श्रेणियों में Hunyuan Image 2.1 ऐसे स्तर पर काम कर रहा है जो स्टूडियो फ़ोटोग्राफ़ी से सीधे मुकाबला करता है, और लागत उसकी तुलना में बहुत कम पड़ती है। मॉडल विभिन्न त्वचा के रंगों को पिछले मॉडलों की तुलना में काफ़ी कम पूर्वाग्रह के साथ संभालता है, जो व्यावहारिक उपयोग में एक असली कदम है।
2026 में प्रॉम्प्टिंग अलग है
2025 से 2026 के बीच के कम चर्चित बदलावों में से एक यह है कि प्रॉम्प्टिंग कितनी आसान हो गई है। ऐसा इसलिए नहीं कि लोग इसमें बेहतर हो गए, बल्कि इसलिए कि मॉडल प्राकृतिक भाषा समझने में बेहतर हो गए।
कम मेहनत, बेहतर नतीजे
2022 से 2024 के बीच विकसित हुई प्रॉम्प्ट इंजीनियरिंग की विधा, जिसमें मॉडिफ़ायर की सूचियाँ, नेगेटिव प्रॉम्प्ट और जटिल सिंटैक्स की तरकीबें शामिल थीं, मौजूदा पीढ़ी के मॉडल के साथ कम ज़रूरी होती जा रही है। Reve Create और GPT Image 2 दोनों कीवर्ड से भरे प्रॉम्प्ट के बजाय बातचीत जैसे विवरणों पर अच्छी प्रतिक्रिया देते हैं।
इसका मतलब यह नहीं कि प्रॉम्प्टिंग का कौशल बेकार हो गया है। लाइटिंग, कंपोज़िशन और वातावरण को खास शब्दों में बताना अब भी नापने योग्य रूप से बेहतर नतीजे देता है। लेकिन "कम से कम मेहनत में स्वीकार्य आउटपुट" की न्यूनतम सीमा बहुत ऊपर उठ गई है। एक वाक्य का विवरण, जो 2023 में औसत नतीजे देता, अब कुछ ऐसा देता है जो सच में इस्तेमाल लायक है।
बिना अतिरिक्त शब्दों के स्टाइल
पहले के मॉडल को एक सामान्य लुक में फिसलने से रोकने के लिए साफ़ स्टाइल मॉडिफ़ायर चाहिए थे: "photorealistic, 8K, cinematic, Kodak Portra" और इसी तरह की दूसरी चीज़ें। आज के टॉप मॉडल जैसे Fibo और Recraft 20B विभिन्न प्रकार की एस्थेटिक्स को आत्मसात कर चुके हैं और उन्हें सब्जेक्ट के आधार पर संदर्भ के हिसाब से लागू करते हैं। किसी प्रोडक्ट का वर्णन करें तो प्रोडक्ट फ़ोटोग्राफ़ी मिलती है। किसी लैंडस्केप का वर्णन करें तो नतीजा लैंडस्केप फ़ोटोग्राफ़ी जैसा पढ़ा जाता है, पेंटेड इलस्ट्रेशन जैसा नहीं।
संदर्भ के आधार पर स्टाइल का यह अनुमान 2026 के सबसे शांत लेकिन सबसे प्रभावशाली बदलावों में से एक है। इसका मतलब है कि AI इमेज जनरेशन उन लोगों के लिए भी सच में सुलभ हो रही है जिनकी न फ़ोटोग्राफ़ी में पृष्ठभूमि है और न प्रॉम्प्ट इंजीनियरिंग में।
सबके लिए LoRA फाइन-ट्यूनिंग
अगर 2024 वह साल था जब LoRA पावर यूज़र्स में लोकप्रिय हुआ, तो 2026 वह साल है जब यह हर किसी के लिए व्यावहारिक हो गया। तेज़ ट्रेनिंग समय, कम कंप्यूटेशनल ज़रूरतों और बेहतर डॉक्यूमेंटेशन के मेल ने कस्टम मॉडल की फाइन-ट्यूनिंग को छोटे स्टूडियो और व्यक्तिगत क्रिएटर के लिए एक वास्तविक विकल्प बना दिया है।
अब कस्टम ट्रेनिंग का मतलब क्या है
LoRA फाइन-ट्यूनिंग आपको किसी खास विज़ुअल स्टाइल, सब्जेक्ट या ब्रांड पहचान पर मॉडल को ट्रेन करने देती है, और फिर उस स्टाइल को किसी भी जनरेट की गई इमेज पर लागू करने देती है। व्यवहार में इसका मतलब है कि कोई प्रोडक्ट ब्रांड मॉडल को 20 से 30 रेफ़रेंस फ़ोटो पर ट्रेन कर सकता है, और फिर हर प्रॉम्प्ट में प्रोडक्ट की एस्थेटिक्स दोबारा लिखे बिना लगातार एक जैसी मार्केटिंग इमेज बना सकता है।
जिस बाधा ने 2024 में इसे अव्यावहारिक बनाए रखा था, उसे लागत और समय दोनों के हिसाब से काफ़ी कम कर दिया गया है। जो कभी एक शक्तिशाली GPU और घंटों की ट्रेनिंग माँगता था, वह अब क्लाउड-आधारित पाइपलाइन पर मिनटों में चल सकता है।
Flux 2 Klein LoRA मॉडल
Black Forest Labs के Flux 2 Klein 9B Base LoRA और Flux 2 Klein 4B Base LoRA LoRA-आधारित कस्टमाइज़ेशन के मौजूदा मानक हैं। 9B वर्ज़न जेनरेशन की गति की कीमत पर ज़्यादा स्टाइल फ़िडेलिटी देता है, जबकि 4B मॉडल इटरेटिव वर्कफ़्लो के लिए बेहतर संतुलन देता है।
दोनों मॉडल छोटे डेटासेट पर ट्रेनिंग सपोर्ट करते हैं (सिर्फ़ 15 से 20 इमेज तक), ऐसे सुसंगत आउटपुट देते हैं जो ट्रेनिंग डेटा की स्टाइल से करीब मेल खाते हैं, और बिना बड़े तकनीकी सेटअप के मौजूदा वर्कफ़्लो टूल्स के साथ जुड़ जाते हैं। Flux Redux Dev इसके ऊपर इमेज वैरिएशन की क्षमता जोड़ता है, जिससे आप एक रेफ़रेंस इमेज की कई व्याख्याएँ जनरेट कर सकते हैं और फिर भी स्टाइल की एकरूपता बनी रहती है।
💡 LoRA ट्रेनिंग के लिए अपनी ट्रेनिंग इमेज सावधानी से चुनें। ट्रेनिंग सेट में एंगल और रोशनी में विविधता ऐसी LoRA व्यवहार देती है जो ज़्यादा लचीली होती है, बनिस्बत उन इमेज के जो एक-दूसरे से बहुत मिलती-जुलती हों।
मॉडलों के बीच असली फ़र्क
अब इतने मज़बूत विकल्प मौजूद हैं कि मॉडल चुनना "सबसे अच्छा" ढूँढने का मामला नहीं है। यह मॉडल की ताकतों को अपने खास उपयोग के मामले से मिलाने का मामला है।
| मॉडल | सबसे अच्छा किसके लिए | आउटपुट रेज़ोल्यूशन | गति |
|---|
| GPT Image 2 | इंस्ट्रक्शन के हिसाब से सटीक आउटपुट | 4K तक | मध्यम |
| Seedream 4.5 | 4K फ़ोटोरियलिज़्म, जटिल सीन | 4K | मध्यम |
| Wan 2.7 Image Pro | माइक्रो-डिटेल, सतह के टेक्सचर | 4K | धीमा |
| Hunyuan Image 2.1 | इंसानी सब्जेक्ट, पोर्ट्रेट | 2K | तेज़ |
| Flux 2 Klein 9B LoRA | कस्टम स्टाइल फाइन-ट्यूनिंग | 4K तक | धीमा |
| Recraft 20B | संदर्भ के अनुसार स्टाइल अनुमान | अलग-अलग | तेज़ |
गति बनाम क्वालिटी का समझौता
2026 के सबसे तेज़ मॉडल, जिनमें Flux Schnell LoRA भी शामिल है, सबसे उच्च क्वालिटी वाले नहीं हैं। यह समझौता हमेशा से रहा है, लेकिन फ़ासला कम हो गया है। 2026 के तेज़ मॉडल ऐसा आउटपुट देते हैं जिसे 2024 में उच्च क्वालिटी माना जाता। अगर आपको बड़ी मात्रा चाहिए, तो फ़ास्ट-टियर मॉडल अब प्रोडक्शन काम के लिए सच में व्यवहार्य हैं, जैसा दो साल पहले वे बिल्कुल नहीं थे।
आउटपुट की सुसंगतता अब भी बदलती है
जहाँ मॉडल अब भी काफ़ी अलग दिखते हैं, वह है आउटपुट की सुसंगतता। किसी भी मॉडल पर एक ही प्रॉम्प्ट 10 बार चलाएँ, और हर बार नतीजे साफ़ तौर पर अलग मिलेंगे। इस विविधता का कुछ हिस्सा क्रिएटिव काम के लिए वांछनीय है, लेकिन जिन प्रोडक्शन वर्कफ़्लो में एक बैच की इमेज में विज़ुअल एकरूपता चाहिए, उनके लिए यह अब भी एक असली सीमा है।
Qwen Image Edit Plus जैसे मॉडल इसे आंशिक रूप से हल करते हैं, एडिट-मोड वर्कफ़्लो के ज़रिए जहाँ आप एक रेफ़रेंस इमेज से शुरू करते हैं और हर बार शून्य से जनरेट करने के बजाय उसे बदलते हैं। यह तरीका ज़्यादा सुसंगत नतीजे देता है, क्योंकि मॉडल के पास काम करने के लिए एक विज़ुअल एंकर होता है।
अब भी क्या ठीक नहीं हुआ
2026 में प्रगति असली और महत्वपूर्ण रही है। लेकिन ईमानदार तस्वीर के लिए यह मानना ज़रूरी है कि टेक्स्ट-टू-इमेज जनरेशन अब भी भरोसेमंद रूप से कहाँ विफल होता है।
हाथ, टेक्स्ट और बारीक डिटेल
हाथ AI इमेज जनरेशन में सबसे ज़्यादा बताई जाने वाली विफलता बने हुए हैं, और 2026 ने इसे पूरी तरह हल नहीं किया है। सभी मौजूदा मॉडल हाथों में कभी-कभी शारीरिक गड़बड़ियाँ बनाते हैं: अतिरिक्त उँगलियाँ, जुड़े हुए पोर, या असंभव जोड़ों के कोण। 2023 की तुलना में गड़बड़ी की दर घटी है, लेकिन यह चेहरों या फ़ैब्रिक जितनी भरोसेमंदी तक नहीं पहुँची है।
इमेज के भीतर पढ़ने लायक टेक्स्ट भी उतना ही अविश्वसनीय है। ज़्यादातर मॉडल ऐसा टेक्स्ट बनाते हैं जो दूर से टाइपोग्राफ़िक रूप से सही लगता है, लेकिन करीब से देखने पर बिखर जाता है। ऐसी इमेज बनाना जिनमें कुछ खास शब्द या वाक्य पढ़ने लायक और सटीक होने चाहिए, अब भी किसी भी मौजूदा मॉडल के साथ भरोसेमंद वर्कफ़्लो नहीं है।
इमेज के बीच कैरेक्टर कंसिस्टेंसी
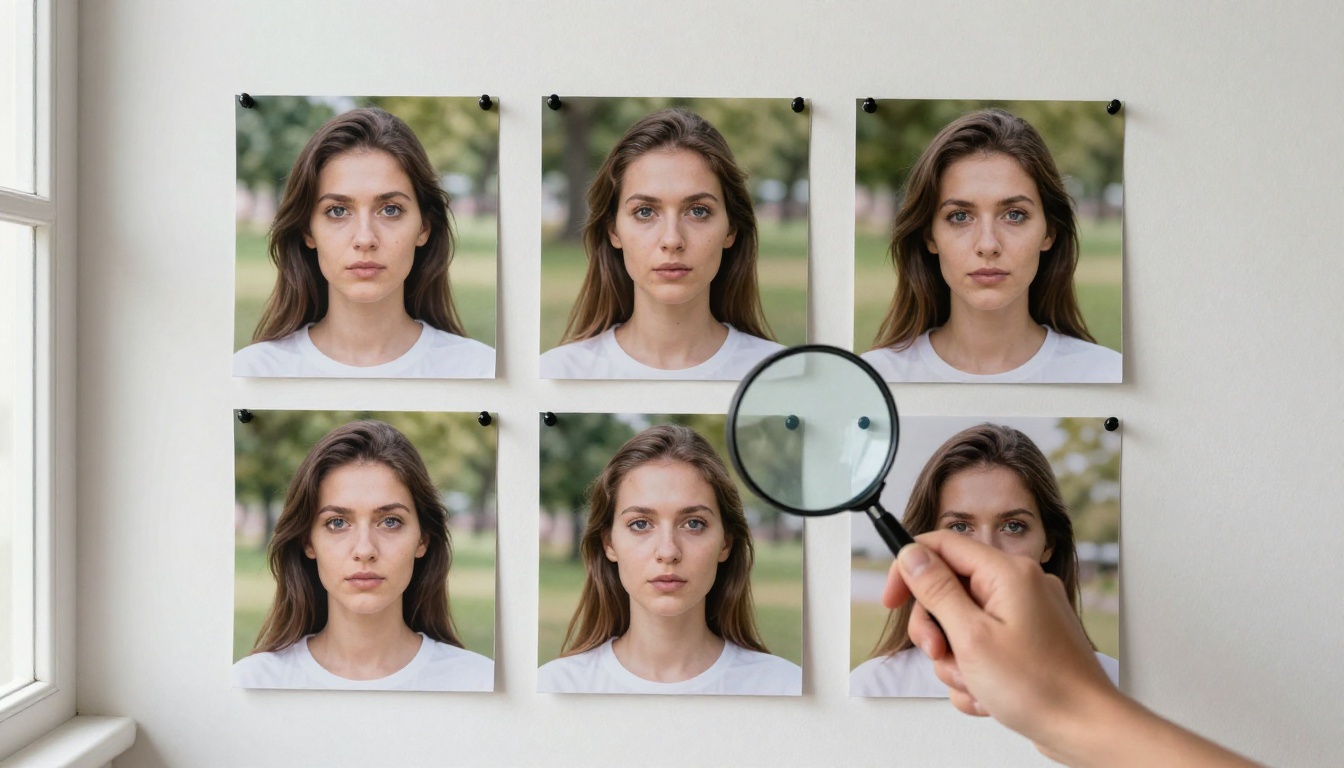
2026 की सबसे कठिन अनसुलझी समस्या कई जनरेट की गई इमेज में कैरेक्टर की कंसिस्टेंसी है। अगर किसी एक ही व्यक्ति को दस अलग-अलग दृश्यों में दिखाना है, तो फ़िलहाल कोई भरोसेमंद तरीका नहीं है जो गारंटी दे कि वह हर एक में एक जैसा दिखेगा, बिना काफ़ी पोस्ट-प्रोसेसिंग या इमेज-टू-इमेज एडिटिंग वर्कफ़्लो के।
Qwen Image Edit और ऐसे ही एडिट-मोड मॉडल मदद करते हैं, क्योंकि ये आपको एक रेफ़रेंस कैरेक्टर रखने और सिर्फ़ परिवेश बदलने देते हैं। लेकिन यह तरीका भी कई इटरेशन में बहाव पैदा करता है। अगली पीढ़ी के मॉडल जिस समस्या को हल करने पर सबसे सक्रियता से काम कर रहे हैं, यही वह है।
अभी इस स्तर पर कैसे जनरेट करें
इन सभी मॉडलों तक पहुँचने के लिए आपको लोकल इन्फ़्रास्ट्रक्चर सेट करने या कई प्रोवाइडरों के API टोकन संभालने की ज़रूरत नहीं है। इस लेख में चर्चा किए गए सभी मॉडल सीधे PicassoIA पर उपलब्ध हैं।
प्लेटफ़ॉर्म एक ही इंटरफ़ेस से 90 से ज़्यादा टेक्स्ट-टू-इमेज मॉडल देता है, इसलिए आप एक ही प्रॉम्प्ट के साथ GPT Image 2, Seedream 4.5, Wan 2.7 Image Pro और Hunyuan Image 2.1 को साथ-साथ आज़मा सकते हैं और देख सकते हैं कि कौन सा आपके खास उपयोग के मामले के लिए ठीक है। टेक्स्ट-टू-इमेज के अलावा, आपको बैकग्राउंड हटाना, सुपर-रेज़ोल्यूशन अपस्केलिंग, टेक्स्ट प्रॉम्प्ट से इमेज एडिटिंग और LoRA फाइन-ट्यूनिंग के टूल भी मिलेंगे, जो सब बिना प्लेटफ़ॉर्म बदले या अलग-अलग अकाउंट संभाले उपलब्ध हैं।
यहाँ एक सीधा शुरुआती वर्कफ़्लो है:
- मॉडल चुनें अपने कंटेंट प्रकार के आधार पर। पोर्ट्रेट और इंसानी सब्जेक्ट के लिए Hunyuan Image 2.1 से शुरू करें। जटिल सीन या प्रोडक्ट फ़ोटोग्राफ़ी के लिए Seedream 4.5 या Wan 2.7 Image Pro आज़माएँ।
- एक विस्तृत प्रॉम्प्ट लिखें फ़ोटोग्राफ़ी की भाषा में: लाइट की दिशा, कैमरा एंगल, सब्जेक्ट की दूरी, और शॉट के लिए मायने रखने वाले कोई भी मटीरियल या टेक्सचर के विवरण बताएँ।
- फ़ैसला करने से पहले 3 से 5 वैरिएशन जनरेट करें। जनरेशनों के बीच विविधता एक फ़ीचर है, बग नहीं। दूसरा या तीसरा नतीजा अक्सर पहले से मज़बूत होता है।
- एडिटिंग के ज़रिए इटरेट करें अगर आप किसी खास इमेज को शून्य से दोबारा जनरेट करने के बजाय सुधारना चाहते हैं, तो Qwen Image Edit Plus इस्तेमाल करें।
- LoRA लागू करें अगर किसी बैच में स्टाइल की एकरूपता चाहिए। इस वर्कफ़्लो के लिए Flux 2 Klein 9B Base LoRA मौजूदा मानक है।
वह हिस्सा जिस पर ध्यान देना चाहिए
2026 में AI इमेज जनरेशन अब नवीनता नहीं रही। GPT Image 2, Seedream 4.5 और Wan 2.7 Image Pro जैसे मॉडल की आउटपुट क्वालिटी कई बढ़ते उपयोग के मामलों के लिए प्रोडक्शन-ग्रेड है। तकनीक की असली सीमाएँ अब भी हैं, खासकर कंसिस्टेंसी और बारीक डिटेल के संदर्भ में, लेकिन हर नए मॉडल रिलीज़ के साथ वे सीमाएँ सिकुड़ रही हैं।
सबसे अहम बदलाव पहुँच का है। जो 2024 में काफ़ी विशेषज्ञता और संसाधन माँगता था, वह अब किसी भी ऐसे व्यक्ति के लिए संभव है जिसके पास साफ़ विचार और अच्छी तरह लिखा विवरण हो। ऊँचाई बढ़ी है, लेकिन न्यूनतम स्तर भी ऊपर उठा है।
अगर आपने मौजूदा पीढ़ी के मॉडल आज़माए नहीं हैं, तो अब शुरू करने का समय है। किसी प्रोजेक्ट के लिए एक इमेज चुनें, एक केंद्रित विवरण लिखें, और उसे PicassoIA पर उपलब्ध तीन या चार मॉडल से चलाएँ। नतीजे आपको किसी भी तुलना लेख से ज़्यादा बता देंगे।


