كان السؤال في الماضي نظريًا. "هل يستطيع الذكاء الاصطناعي إنتاج فيديو يبدو حقيقيًا تمامًا؟" كان موضوعًا يناقشه الباحثون في المؤتمرات، بينما يضحك عامة الناس على النتائج المشوّشة والمخيفة المنتشرة على الإنترنت. لقد تغيّر هذا الحديث تمامًا. في 2027، الجواب هو نعم، تحت الظروف المناسبة، وباستخدام النماذج الصحيحة، ولنوع المحتوى الملائم. لقد تقلّصت الفجوة بين الفيديو الاصطناعي والفيديو الأصلي إلى حدّ يخدع فيه محترفون مدرَّبون كل يوم، ولا يستطيع الناس العاديون التمييز بينهما على الإطلاق.
هذا ليس احتمالًا بعيدًا. إنه يحدث الآن، على نطاق واسع، وعلى منصات يستطيع أي شخص الوصول إليها.
كيف تطوّر فيديو الذكاء الاصطناعي فعلًا
من المقاطع المتقطعة إلى الواقعية بدقة 1080p
كانت أولى أدوات فيديو الذكاء الاصطناعي المتاحة على نطاق واسع تنتج مقاطع قصيرة منخفضة الدقة، واضحة الاصطناعية. الوجوه تتشوّه عند الحواف، والشعر يرتعش بين الإطارات، والفيزياء تتجاهل الجاذبية. كان بالإمكان كشفها خلال ثوانٍ. كان ذلك في 2022.
بحلول أوائل 2024، تغيّر الوضع بشكل ملحوظ. بدأت النماذج تنتج فيديوهات بإضاءة متسقة عبر الإطارات، ووجوه تحافظ على بنيتها أثناء الحركة، وضبابية حركة طبيعية تحاكي سلوك الكاميرا الحقيقية. وبحلول منتصف 2025، كانت عدة نماذج من الصف الأول تنتج لقطات تجتاز المراجعة البشرية العابرة بانتظام.
جاءت القفزة التقنية من تقاطع عدة تطورات: مجموعات بيانات تدريب أكبر من الفيديوهات الحقيقية، وتحسينات معمارية في توليد الفيديو القائم على الانتشار (diffusion)، وتركيز جديد على الاتساق الزمني، أي القدرة على إبقاء كل عنصر في المشهد متسقًا منطقيًا من إطار إلى ما يليه.
ما الذي تغيّر في 2024 و2025
ثلاثة أمور سرّعت الواقعية بشكل كبير:
- نماذج الفيديو القائمة على الانتشار حلّت محل الأساليب السابقة القائمة على GAN. نماذج الانتشار تتعامل مع التعقيد عالي الأبعاد للفيديو بكفاءة أكبر، فتنتج ملمسًا أكثر طبيعية وتشوهات أقل.
- التوليد المدرك للفيزياء أصبح ميزة حقيقية. بدأت النماذج تلتقط كيف يتحرك الشعر تحت الريح، وكيف يتصرف الماء بفعل التوتر السطحي، وكيف تتبع الظلال حركة مصدر الضوء.
- دمج الصوت الأصلي ظهر. نماذج مثل Veo 3 من Google وSeedance 1.5 Pro من ByteDance تولّد الآن صوتًا متزامنًا كجزء من المخرجات نفسها، لا كخطوة معالجة لاحقة. أصوات المحيط وخطوات الأقدام والضوضاء الخلفية المتوافقة مع المشهد البصري تضيف طبقة من المصداقية لم يملكها فيديو الذكاء الاصطناعي الصامت أبدًا.
💡 أكثر فيديوهات الذكاء الاصطناعي إقناعًا ليست تلك ذات البشرة المثالية. بل تلك ذات الصوت المثالي. الصوت المحيطي المتزامن هو أحدث إشارة واقعية وأقواها.
ما الذي يجعل الفيديو يبدو حقيقيًا
الحركة والاتساق الزمني
كانت الحركة في الماضي أكبر دليل على الاصطناعية في فيديو الذكاء الاصطناعي. الأجسام تنزلق بدل أن تتحرك، والأيدي تتشوّه بين الإطارات، والأشخاص يغيّرون وضعياتهم بطرق غير طبيعية. تعالج النماذج الحديثة هذه المشكلة عبر تكييف التدفق البصري (optical flow) ونوافذ توليد بسياق أطول تسمح للنموذج بمعالجة 30 إطارًا أو أكثر في آن واحد عند تحديد شكل الإطار التالي.
والنتيجة: الشخصيات التي تمشي تُظهر الآن ثقل وقع أقدامها الحقيقي. الشعر يتبع الزخم. الرؤوس تدور بسرعات زاوية معقولة. عندما تشاهد لقطات من Kling v3 Video أو Veo 3.1، لا تبدو الحركة اصطناعية إلا إذا كنت تبحث عن ذلك تحديدًا.
البشرة والملمس والتعابير الدقيقة
البشر بارعون جدًا في اكتشاف الوجوه المزيفة. لقد طوّرنا حساسية حادة تجاه هندسة الوجه وجودة البشرة والتعابير الدقيقة، لأن الوجوه هي واجهتنا الاجتماعية الأساسية. هذه أصعب مشكلة في فيديو الذكاء الاصطناعي، ولم تُحَل بقدر من الاتساق إلا مؤخرًا.
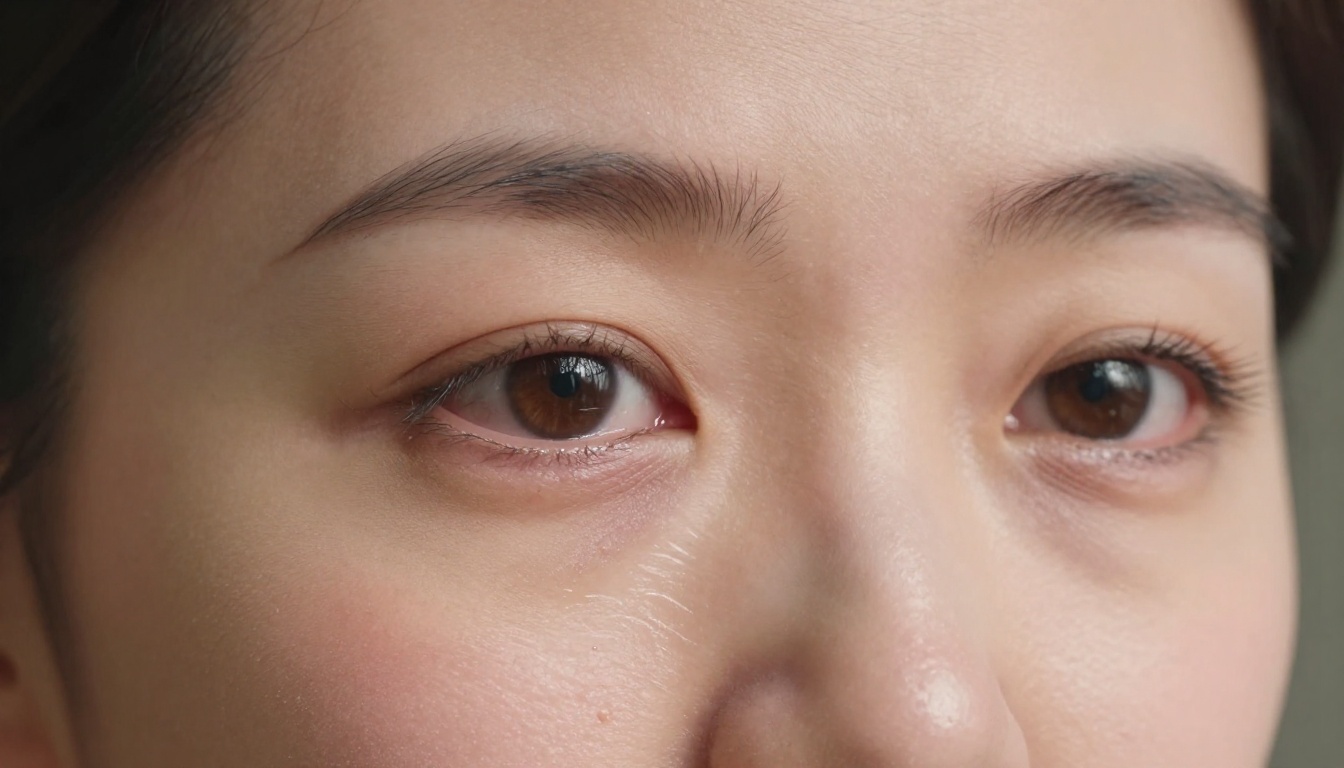
تعرض النماذج الرائدة حاليًا البشرة بالخصائص التالية:
- التشتت تحت السطح (Sub-surface scattering): الطريقة التي ينفذ بها الضوء عبر طبقات الجلد فيخلق دفئًا قرب الأوعية الدموية
- ملمس على مستوى المسام يتغيّر بشكل طبيعي مع تغيّر المنظور
- التعابير الدقيقة: حركات العين اللاإرادية، وتوسّع فتحات الأنف، وانضغاط الشفاه تحت الضغط
- عدم التماثل الطبيعي: الوجوه الحقيقية ليست متماثلة تمامًا، وقد اضطرت نماذج الذكاء الاصطناعي إلى إعادة إنتاج ذلك بإقناع
من أفضل النماذج في هذا حاليًا Sora 2 Pro من OpenAI وHailuo 02 من MiniMax، وكلاهما ينتج لقطات مقرّبة للوجه تخدع الناس بانتظام في الدراسات المضبوطة.
فيزياء الضوء واتساق المشهد
الكاميرات الحقيقية تتصرف بطرق محددة. تظهر وهجات العدسة عندما يصطدم مصدر ضوء بزوايا معينة. عمق الميدان يموّه الخلفية. ضبابية الحركة تترك أثرًا خلف الأجسام السريعة. الانحراف اللوني يخلق أهدابًا لونية خفيفة عند الحواف عالية التباين.
نجحت النماذج الآن في محاكاة كل هذه السلوكيات، لا كحيل معالجة لاحقة، بل كجزء من عملية التوليد نفسها. شخص يمشي بجانب نافذة في مخرجات Wan 2.7 T2V سيحمل نمط الظل الصحيح على وجهه أثناء مروره عبر شريط الضوء. هذا ليس سهلًا. إنه يتطلب من النموذج استيعاب فيزياء الضوء، لا مجرد نسخ الأنماط البصرية.
النماذج التي تدفع الواقعية إلى الأمام الآن
أفضل نماذج تحويل النص إلى فيديو في 2027
تحرك المجال بسرعة كبيرة. هذه النماذج التي تضع المعيار حاليًا لتوليد فيديو الذكاء الاصطناعي الواقعي:
كيف تقارن بينها في لمحة
ليست كل النماذج متساوية في كل مهمة. Veo 3.1 يتصدر في اتساق الوجوه عبر التسلسلات الطويلة. Sora 2 Pro يتعامل مع المشاهد المعقدة متعددة الشخصيات بعمق خلفية جيد. Kling v3 ينتج الحركة الأقرب إلى الإحساس السينمائي. LTX 2 Pro يخرج بدقة 4K، وهذا مهم للتطبيقات الاحترافية. Seedance 1.5 Pro هو الخيار المناسب عندما تكون مزامنة الصوت أولوية.
النتيجة العملية: لا يفوز نموذج واحد في كل الفئات. أكثر النتائج إقناعًا تأتي من اختيار الأداة المناسبة لنوع المحتوى المحدد.
💡 للمحتوى الواقعي الذي يركّز على الأشخاص، Veo 3.1 و Hailuo 02 هما أقوى الخيارات. للّقطات السينمائية الواسعة، يصعب تجاوز Kling v3 و Sora 2 Pro.
كيف تكشف فيديو الذكاء الاصطناعي المزيف
5 علامات يمكنك اكتشافها بنفسك
حتى مع النماذج الحديثة، توجد أنماط تكشف الأصل الاصطناعي. معرفتها هي الخطوة الأولى لحماية نفسك من الخداع.
1. عدم استقرار الخلفية
الكاميرات الحقيقية تلتقط بيئة مستقرة. نماذج الذكاء الاصطناعي تسمح أحيانًا لعناصر الخلفية بالتحرك أو الارتعاش أو التغيّر بين اللقطات. انظر إلى الأجسام الثابتة: هل تبقى في مكانها تمامًا طوال المقطع؟
2. هندسة اليد والأصابع
تبقى الأيدي من أصعب أجزاء الجسم التي يعرضها الذكاء الاصطناعي بشكل صحيح أثناء الحركة. الأصابع الزائدة، وانحناء المفاصل بشكل غير معتاد، والأيدي التي تتشوّه عند اقترابها من الوجه، كلها علامات متكررة.
3. النص داخل المشهد
أي نص مرئي في الخلفية، على اللافتات أو الملابس، يكون تقريبًا دائمًا مشوّهًا في فيديو الذكاء الاصطناعي. الحروف تكون متداخلة أو مكتوبة بشكل خاطئ أو تتغيّر بين الإطارات.
4. فيزياء الشعر عند حافة الظل
المكان الذي يلتقي فيه الشعر بالخلفية منطقة عالية التعقيد. في الفيديو الاصطناعي، غالبًا ما تُظهر الخصلات الفردية عند حافة الظل تشوهات دمج خفيفة أو حوافًا ناعمة بشكل غير طبيعي على خلفية مزدحمة.
5. الرمش وحركة العين
كان المزيّفون العميقون المبكرون نادرًا ما يرمشون بشكل طبيعي. تحسّنت النماذج الحالية، لكن توقيت الرمش وسرعته ما زالا غالبًا غير دقيقين قليلًا. انتبه للرمش المتزامن أكثر من اللازم، أو السريع جدًا، أو الذي يتزامن بشكل مريب مع القطع.
طرق الكشف الآلي
الكشف البشري غير موثوق. هناك عدة أساليب تقنية تحاول أتمتته:
- فحص الإشارات الحيوية: يحتوي الفيديو الحقيقي على إشارات بيولوجية دقيقة، تشمل حركات الرأس الصغيرة الناتجة عن ضربات القلب، واستجابة حدقة العين للإضاءة، وإيقاع التنفس. هذه الإشارات غائبة أو غير متسقة في الفيديو الاصطناعي.
- تحليل بصمات الضغط: لفيديو الذكاء الاصطناعي والفيديو الحقيقي بصمات إحصائية مختلفة في صيغهما المضغوطة.
- تحليل الضوضاء الزمنية: مستشعرات الكاميرات الحقيقية تنتج أنماط ضوضاء متسقة مكانيًا. ضوضاء توليد الذكاء الاصطناعي لها توقيع إحصائي مختلف.
المشكلة أن طرق الكشف تتأخر دائمًا خطوة عن أدوات التوليد. فكلما تحسّنت النماذج في الواقعية الفوتوغرافية، تحسّنت دون قصد في تجاوز الكشف الآلي.
لماذا تمثّل التزييفات العميقة مشكلة حقيقية
ما وراء الترفيه: المخاطر
بدأ الفيديو الاصطناعي كلعبة تسلية عابرة. ثم تحول إلى سلاح سياسي وأداة احتيال ووسيلة لنشر صور حميمة دون موافقة أصحابها، وقد تسبب ذلك في أضرار موثقة لآلاف الأشخاص الحقيقيين. إن القدرة على توليد فيديو مقنع لأي شخص يقول أو يفعل أي شيء لها تبعات واضحة وفورية:
- التضليل السياسي: فيديوهات ملفقة لمرشحين أو مسؤولين يدلون بتصريحات لم يقولوها قط
- الاحتيال المالي: انتحال شخصية المدير التنفيذي عبر مكالمات الفيديو للموافقة على تحويلات مصرفية (حدث هذا بالفعل على نطاق واسع، مع خسائر موثقة بعشرات الملايين)
- الإضرار بالسمعة: محتوى حميمي اصطناعي يستهدف أفرادًا عاديين دون موافقتهم
- فبركة الأدلة: لقطات تبدو موثقة لأحداث لم تقع أبدًا
تسارع الواقعية يجعل كل هذه التهديدات أشد خطورة. التزييف العميق الضبابي من 2020 كان سهل التجاهل. أما فيديو اصطناعي بدقة 1080p من 2025، بإضاءة صحيحة وصوت متزامن وتعابير دقيقة طبيعية، فليس كذلك.
حالات انتشرت كأنها حقيقية
وقد أظهرت عدة حوادث بارزة الأثر الواقعي لهذه الظاهرة. استُخدم مقطع صوت وفيديو اصطناعي لمسؤول مالي أوروبي في احتيال على عدة شركات في مخطط واحد بعشرات ملايين الدولارات. وتداولت تزييفات عميقة سياسية في سياقات انتخابية في عدة دول خلال دورة انتخابات 2024، مع تأثير موثّق على تصورات الرأي العام في بيانات استطلاعات الرأي.
النمط ثابت: كلما كان الفيديو الاصطناعي أكثر واقعية، طالت مدة تداوله قبل أن يُكشف، وزاد الضرر الذي يُلحقه خلال تلك الفترة.
💡 ينتشر المحتوى الفيروسي قبل أن يتم تفنيده. وبحلول الوقت الذي يكتشف فيه المدققون التزييف العميق المتقن، يكون قد شوهد ملايين المرات.
كيف تصنع فيديو ذكاء اصطناعي واقعيًا على PicassoIA
أي النماذج تعمل بشكل أفضل
يتيح لك PicassoIA الوصول إلى أكثر نماذج توليد الفيديو قدرة المتاحة حاليًا، كلها في مكان واحد. للحصول على مخرجات واقعية، تنتج النماذج التالية أقوى النتائج:
للأشخاص والوجوه الواقعية:
- Veo 3.1 يقدم فيديو بدقة 1080p مع اتساق ممتاز في الوجوه وتوليد صوت أصلي
- Hailuo 02 ينتج فيديو 1080p نظيفًا مع تصيير قوي للوجوه
- Kling v2.6 يتعامل مع المشاهد السينمائية التي تقودها الشخصيات بحركة واقعية
للمشاهد الواسعة والبيئات:
- Sora 2 يتعامل مع المشاهد المعقدة متعددة العناصر بمحاكاة فيزيائية قوية
- Wan 2.7 T2V ينتج مخرجات 1080p مع اتساق ممتاز للمشهد
- Pixverse v5 سريع وموثوق للفيديو الواقعي متعدد الاستخدامات
للدقة 4K والمستوى الاحترافي:
- LTX 2 Pro يخرج بدقة 4K، وهو النموذج الوحيد بهذه الدقة مع دعم واسع للمحتوى
نصائح لواقعية أفضل
الحصول على مخرجات مقنعة حقًا من أي من هذه النماذج يتطلب أكثر من كتابة أمر نصي. هذه الممارسات تحسّن الواقعية بثبات:
كن دقيقًا بشأن سلوك الكاميرا. عبارات مثل "كاميرا محمولة مع اهتزاز خفيف" أو "عمق ميدان ضحل بعدسة 85 ملم" أو "تقريب بطيء أثناء الحوار" توجّه النموذج إلى محاكاة التصوير السينمائي الحقيقي، لا مجرد توليد صور.
صف مصادر الإضاءة بوضوح. "ضوء الشمس بعد الظهر من النافذة اليمنى" يمنح النموذج مرجعًا فيزيائيًا. أما "مضاء جيدًا" فلا يمنحه شيئًا. كلما كان وصفك للإضاءة أدق، كانت الظلال أكثر اتساقًا عبر المقطع.
أبقِ التسلسلات قصيرة ومركّزة. كل النماذج الحالية تفقد الاتساق في المقاطع الأطول. مقطع مدته 5 ثوانٍ لشخص واحد في مكان واحد سيكون أكثر إقناعًا من مقطع مدته 15 ثانية بعدة شخصيات وانتقالات بين المشاهد.
استخدم الصور المرجعية عند توفرها. النماذج التي تقبل مدخلات تحويل الصورة إلى فيديو، مثل Wan 2.7 I2V أو Kling v2.6 Motion Control، يمكنها أن تبدأ من صورة ثابتة واقعية وتحريكها. هذا يتجاوز كثيرًا من تحديات توليد الوجوه تمامًا.
💡 أسهل طريق إلى فيديو ذكاء اصطناعي واقعي هو البدء من صورة ثابتة واقعية. ولّد إطارك أولًا بنموذج صور، ثم حرّكه. النتيجة تكون في الغالب أكثر إقناعًا من تحويل النص إلى فيديو الخالص.
ابدأ في صنع شيء حقيقي
لم يعد الخط الفاصل بين فيديو الذكاء الاصطناعي والفيديو الحقيقي موثوقًا. بالنسبة لمن ينتج المحتوى، هذه فرصة إبداعية حقيقية. أما بالنسبة لمن يستهلك المحتوى، فهي تعني تطوير عادات جديدة فيما تثق به ولماذا.
النماذج المتاحة الآن قادرة فعلًا على إنتاج لقطات تجتاز التدقيق البشري. هذا ليس تحذيرًا، بل حقيقة عن اللحظة التي نعيشها. ما تفعله بذلك، سواء استخدمته لرواية القصص أو بناء المحتوى أو مجرد البقاء أكثر يقظة كمشاهد، فالقرار لك.
جميع النماذج المذكورة في هذا المقال متاحة على PicassoIA. يمكنك تجربة Veo 3.1 وKling v3 وSora 2، وعشرات غيرها، دون الحاجة إلى حسابات منفصلة على منصات متعددة. اختر مشهدًا، واكتب أمرًا نصيًا بتفاصيل دقيقة عن الإضاءة والكاميرا، وشاهد بنفسك أين تقع الحدود اليوم.
إنه أقرب إلى الواقع مما تظن.


