A pergunta era teórica. "Uma IA consegue criar um vídeo que pareça totalmente real?" era algo que pesquisadores debatiam em congressos, enquanto o público em geral ria dos resultados com falhas e estranhos que circulavam na internet. Essa conversa mudou por completo. Em 2027, a resposta é sim, sob as condições certas, com os modelos certos e para o tipo certo de conteúdo. A distância entre vídeo sintético e autêntico diminuiu a ponto de profissionais treinados serem enganados todos os dias, e pessoas comuns simplesmente não conseguirem notar a diferença.
Essa não é uma possibilidade distante. Está acontecendo agora, em escala, em plataformas que qualquer pessoa pode acessar.
Como o vídeo de IA realmente evoluiu
De clipes pixelados ao realismo em 1080p
As primeiras ferramentas de vídeo com IA amplamente acessíveis geravam clipes curtos e de baixa resolução, claramente artificiais. Rostos se distorciam nas bordas. O cabelo tremia entre um quadro e outro. A física ignorava a gravidade. Dava para identificá-los em segundos. Isso foi em 2022.
No início de 2024, a situação já tinha mudado de forma significativa. Os modelos começaram a produzir vídeos com iluminação consistente entre os quadros, rostos que mantinham sua geometria durante o movimento e um desfoque de movimento natural, que imitava o comportamento de uma câmera real. Em meados de 2025, vários modelos de ponta já produziam vídeos que passavam por uma análise casual feita por uma pessoa.
O salto técnico veio de alguns avanços convergentes: conjuntos de dados de treinamento maiores, com vídeos reais; melhorias de arquitetura na geração de vídeo baseada em difusão; e um novo foco na coerência temporal, a capacidade de manter todos os elementos de uma cena logicamente consistentes de um quadro para o seguinte.
O que mudou em 2024 e 2025
Três fatores aceleraram o realismo de forma dramática:
- Modelos de vídeo por difusão substituíram as abordagens anteriores baseadas em GANs. Os modelos de difusão lidam muito melhor com a complexidade de alta dimensão do vídeo, produzindo texturas mais naturais e menos artefatos.
- Geração com consciência física tornou-se um recurso real. Os modelos passaram a capturar como o cabelo se move com o vento, como a água se comporta com a tensão superficial e como as sombras acompanham o movimento de uma fonte de luz.
- Integração nativa de áudio chegou. Modelos como o Veo 3, do Google, e o Seedance 1.5 Pro, da ByteDance, agora geram áudio sincronizado como parte do próprio resultado, e não como uma etapa de pós-produção. Sons ambientes, passos e ruídos de fundo que combinam com a cena visual acrescentam uma camada de credibilidade que o vídeo de IA sem som nunca teve.
💡 Os vídeos de IA mais convincentes não são os que têm pele perfeita. São os que têm som perfeito. O áudio ambiente sincronizado é o sinal de realismo mais novo e mais poderoso.
O que faz um vídeo parecer real
Movimento e coerência temporal
A maior pista de um vídeo de IA costumava ser o movimento. Objetos deslizavam em vez de se mover. As mãos se deformavam entre um quadro e outro. As pessoas mudavam de posição de maneiras não naturais. Os modelos atuais resolvem isso com condicionamento por fluxo óptico e janelas de geração com contexto mais longo, que permitem ao modelo processar 30 ou mais quadros ao mesmo tempo na hora de decidir como será o quadro seguinte.
O resultado: personagens que caminham agora mostram o peso do pé ao tocar o chão. O cabelo acompanha o impulso. As cabeças giram em velocidades angulares plausíveis. Ao assistir a imagens do Kling v3 Video ou do Veo 3.1, o movimento só parece sintético se você estiver procurando especificamente por isso.
Pele, textura e microexpressões
Os seres humanos são extraordinariamente bons em detectar rostos falsos. Desenvolvemos uma sensibilidade aguçada à geometria facial, à qualidade da pele e às microexpressões, porque o rosto é nossa principal interface social. Este é o problema mais difícil do vídeo com IA, e só recentemente ele começou a ser resolvido com alguma consistência.
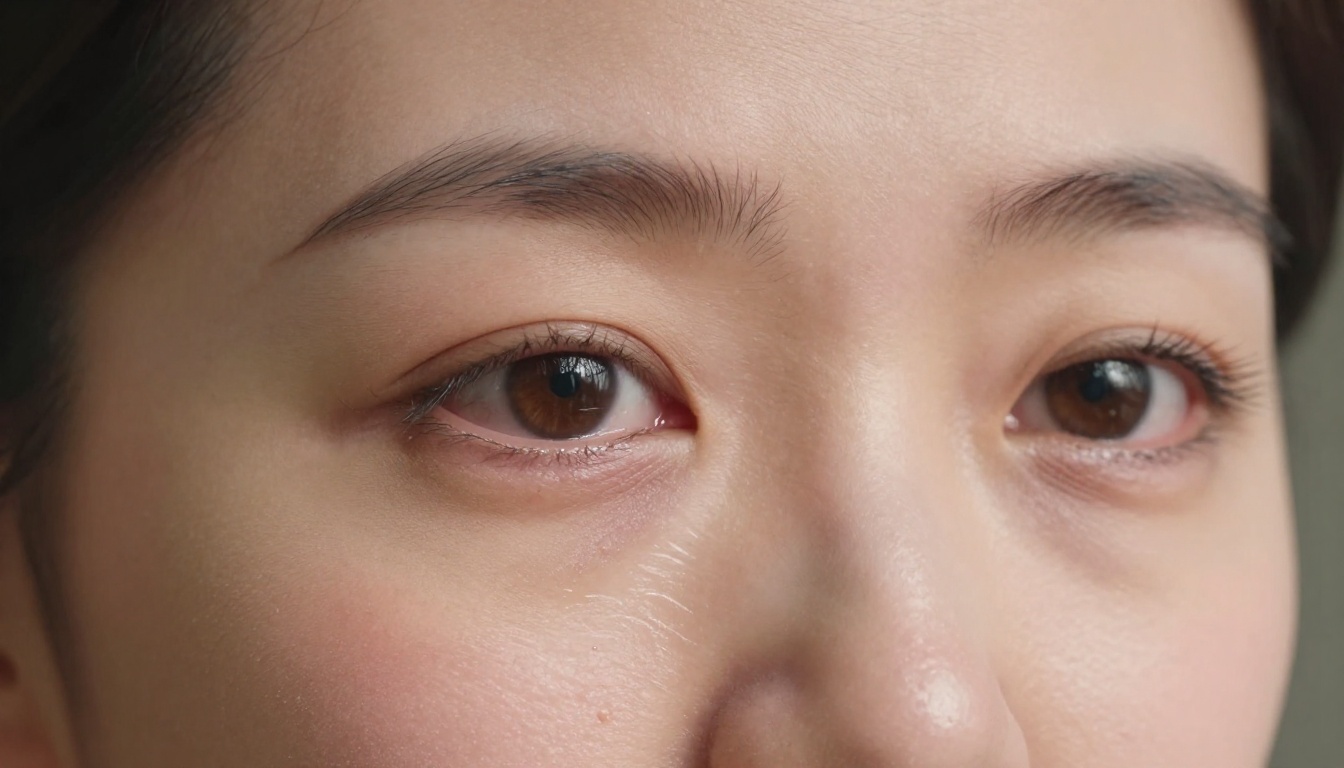
Os modelos de ponta atuais já renderizam a pele com:
- Dispersão subsuperficial: a forma como a luz atravessa as camadas da pele e cria um calor próximo aos vasos sanguíneos
- Textura de poros que muda naturalmente com as mudanças de perspectiva
- Microexpressões: movimentos involuntários dos olhos, dilatação das narinas, compressão dos lábios sob tensão
- Assimetria natural: rostos reais não são perfeitamente simétricos, e os modelos de IA precisaram reproduzir isso de forma convincente
Os modelos que fazem isso melhor atualmente incluem o Sora 2 Pro, da OpenAI, e o Hailuo 02, da MiniMax, ambos capazes de produzir closes de rosto que enganam pessoas com regularidade em estudos controlados.
Física da luz e consistência da cena
As câmeras reais se comportam de maneiras específicas. Reflexos de lente aparecem quando uma fonte de luz atinge a lente em certos ângulos. A profundidade de campo desfoca o fundo. O desfoque de movimento deixa rastros em objetos que se deslocam rápido. A aberração cromática cria franjas sutis de cor nas bordas de alto contraste.
Os modelos de IA agora replicam todos esses comportamentos, não como truques de pós-produção, mas como parte da própria geração. Uma pessoa passando por uma janela em um vídeo gerado pelo Wan 2.7 T2V terá o padrão de sombra correto no rosto ao atravessar a faixa de luz. Isso não é fácil. Exige que o modelo internalize a física da luz, e não apenas copie padrões visuais.
Os modelos que estão ampliando o realismo agora
Os melhores modelos de texto para vídeo em 2027
O setor evoluiu rápido. Estes são os modelos que atualmente estabelecem o padrão para a geração de vídeo fotorrealista com IA:
| Modelo | Desenvolvedor | Resolução máxima | Áudio | Ponto forte em realismo |
|---|
| Veo 3.1 | Google | 1080p | Nativo | Coerência facial, movimento |
| Sora 2 Pro | OpenAI | 1080p | Sim | Cenas complexas, física |
| Kling v3 Video | Kwai | 1080p | Não | Movimento, cinematografia |
| Seedance 1.5 Pro | ByteDance | 1080p | Nativo | Sincronia áudio-visual |
| Hailuo 02 | MiniMax | 1080p | Não | Realismo de rosto |
| LTX 2 Pro | Lightricks | 4K | Não | Resolução, detalhe |
| Gen 4.5 | RunwayML | 1080p | Não | Movimento cinematográfico |
| Wan 2.7 T2V | Wan Video | 1080p | Não | Consistência de cena |
Como eles se comparam de relance
Nem todos os modelos são iguais para todas as tarefas. O Veo 3.1 lidera em coerência facial ao longo de sequências longas. O Sora 2 Pro lida bem com cenas complexas com vários personagens e profundidade de fundo. O Kling v3 produz o movimento com sensação mais cinematográfica. O LTX 2 Pro entrega resolução 4K, o que importa em aplicações profissionais. O Seedance 1.5 Pro é a escolha certa quando o áudio sincronizado é prioridade.
A implicação prática: nenhum modelo vence em todas as categorias. Os resultados mais convincentes vêm de escolher a ferramenta certa para o tipo específico de conteúdo que você tem em mãos.
💡 Para conteúdo mais realista com pessoas, o Veo 3.1 e o Hailuo 02 são as escolhas mais fortes. Para planos abertos cinematográficos, o Kling v3 e o Sora 2 Pro são difíceis de superar.
Como identificar um vídeo falso de IA
5 sinais que você mesmo pode identificar
Mesmo com os modelos modernos, existem padrões que denunciam a origem sintética. Conhecê-los é o primeiro passo para se proteger de ser enganado.
1. Instabilidade do fundo
Câmeras reais captam um ambiente estável. Os modelos de IA às vezes deixam elementos do fundo mudarem de posição, tremularem ou se alterarem entre os cortes. Observe objetos parados: eles permanecem exatamente no lugar durante todo o clipe?
2. Geometria de mãos e dedos
As mãos continuam sendo uma das partes do corpo mais difíceis de renderizar corretamente pela IA em movimento. Dedos extras, dobras de articulação incomuns ou mãos que se deformam quando se aproximam do rosto são sinais consistentes.
3. Textos na cena
Qualquer texto visível no fundo, em placas, em roupas, quase sempre sai corrompido em vídeos de IA. As letras ficam embaralhadas, com erros de grafia ou mudam entre os quadros.
4. Física do cabelo na borda da silhueta
O ponto em que o cabelo encontra o fundo é uma área de alta complexidade. No vídeo sintético, fios individuais na borda da silhueta costumam mostrar artefatos de mistura sutis ou bordas suaves demais contra um fundo movimentado.
5. Piscadas e movimento dos olhos
Os primeiros deepfakes raramente piscavam de forma natural. Os modelos atuais melhoraram, mas o tempo e a velocidade das piscadas ainda costumam estar um pouco errados. Preste atenção em piscadas sincronizadas demais, rápidas demais ou que coincidem de forma suspeita com cortes.
Métodos de detecção automatizada
A detecção humana não é confiável. Várias abordagens técnicas tentam automatizá-la:
- Varredura de sinais biométricos: o vídeo real contém sinais biológicos sutis, incluindo micromovimentos da cabeça causados pelo batimento cardíaco, resposta da pupila à luz e ritmo da respiração. Esses sinais estão ausentes ou são inconsistentes no vídeo sintético.
- Perfil de artefatos de compressão: vídeos de IA e vídeos reais têm assinaturas estatísticas diferentes em seus formatos comprimidos.
- Perfil de ruído temporal: sensores de câmeras reais produzem padrões de ruído consistentes no espaço. O ruído da geração por IA tem uma assinatura estatística diferente.
O problema é que os métodos de detecção estão sempre um passo atrás das ferramentas de geração. À medida que os modelos melhoram no fotorrealismo, também melhoram, sem querer, em driblar a detecção automatizada.
Por que os deepfakes são um problema real
Além do entretenimento: o que está em jogo
O vídeo sintético começou como uma simples diversão de festa. Virou uma arma política, um instrumento de fraude e um veículo de imagens íntimas não consensuais que já causaram danos documentados a milhares de pessoas reais. A capacidade de gerar um vídeo convincente de qualquer pessoa dizendo ou fazendo qualquer coisa tem implicações claras e imediatas:
- Desinformação política: vídeos fabricados de candidatos ou autoridades fazendo declarações que nunca fizeram
- Fraude financeira: falsificação da identidade de um CEO em videochamadas para autorizar transferências bancárias (isso já aconteceu em grande escala, com perdas documentadas de dezenas de milhões)
- Danos à reputação: conteúdo íntimo sintético que tem como alvo pessoas comuns sem o consentimento delas
- Fabricação de provas: imagens aparentemente verificadas de eventos que nunca ocorreram
A aceleração do realismo torna todas essas ameaças mais graves. Um deepfake borrado de 2020 era fácil de descartar. Um vídeo sintético em 1080p de 2025, com iluminação correta, áudio sincronizado e microexpressões naturais, não é.
Casos que viralizaram como se fossem reais
Vários incidentes de grande repercussão demonstraram o impacto no mundo real. Um clipe sintético de áudio e vídeo de um funcionário financeiro europeu foi usado para defraudar várias empresas em um único esquema que envolveu dezenas de milhões de dólares. Deepfakes políticos circularam em contextos eleitorais em vários países durante o ciclo eleitoral de 2024, com influência documentada na percepção pública captada em pesquisas de opinião.
O padrão é consistente: quanto mais realista o vídeo sintético, mais tempo ele circula antes de ser sinalizado, e mais dano causa nessa janela.
💡 A disseminação viral acontece antes do desmentido. Quando os checadores de fatos identificam um deepfake sofisticado, ele já foi visto milhões de vezes.
Como criar vídeo de IA realista no PicassoIA
Quais modelos funcionam melhor
O PicassoIA dá acesso aos modelos de geração de vídeo mais capazes disponíveis atualmente, tudo em um só lugar. Para resultados fotorrealistas, os modelos a seguir produzem os melhores resultados:
Para pessoas e rostos realistas:
- O Veo 3.1 gera vídeo em 1080p com excelente coerência facial e geração de áudio nativa
- O Hailuo 02 produz vídeo limpo em 1080p com renderização forte de rostos
- O Kling v2.6 lida com cenas cinematográficas centradas em personagens e com movimento realista
Para cenas amplas e ambientes:
- O Sora 2 lida com cenas complexas de vários elementos e com forte simulação de física
- O Wan 2.7 T2V produz saída em 1080p com excelente consistência de cena
- O Pixverse v5 é rápido e confiável para vídeo realista de uso geral
Para 4K e resolução profissional:
- O LTX 2 Pro entrega 4K, o único modelo nessa resolução com amplo suporte a conteúdo
Dicas para mais realismo
Obter um resultado realmente convincente com qualquer um desses modelos exige mais do que apenas escrever um prompt. Estas práticas melhoram o realismo de forma consistente:
Seja específico sobre o comportamento da câmera. Frases como "câmera na mão com leve tremor", "profundidade de campo rasa com lente de 85mm" ou "zoom lento durante o diálogo" levam o modelo a replicar a cinematografia real, e não apenas a gerar imagens.
Descreva as fontes de luz explicitamente. "Luz do sol da tarde vinda da janela da direita" dá ao modelo uma âncora física. "Bem iluminado" não dá nada. Quanto mais específica for a descrição da luz, mais consistentes serão as sombras ao longo do clipe.
Mantenha as sequências curtas e focadas. Todos os modelos atuais perdem consistência em clipes mais longos. Um clipe de 5 segundos com uma pessoa em um único cenário será mais convincente do que um de 15 segundos com vários personagens e transições de cena.
Use imagens de referência quando possível. Modelos que aceitam imagem para vídeo como entrada, como o Wan 2.7 I2V ou o Kling v2.6 Motion Control, podem partir de uma imagem fixa fotorrealista e animá-la. Isso contorna por completo muitos dos desafios de geração de rostos.
💡 O caminho mais fácil para um vídeo de IA fotorrealista é começar com uma imagem fixa fotorrealista. Gere seu quadro com um modelo de imagem primeiro e depois anime-o. O resultado quase sempre é mais convincente do que o texto para vídeo puro.
Comece a criar algo real
A linha entre vídeo de IA e vídeo real não é mais confiável. Para quem cria conteúdo, isso é uma oportunidade criativa genuína. Para quem consome conteúdo, significa desenvolver novos hábitos sobre aquilo em que confia e por quê.
Os modelos disponíveis agora são genuinamente capazes de produzir vídeos que passam pelo escrutínio humano. Isso não é um alerta, é um fato sobre o momento em que estamos. O que você faz com isso, seja para contar histórias, criar conteúdo ou simplesmente ficar mais atento como espectador, cabe a você.
Todos os modelos mencionados neste artigo estão disponíveis no PicassoIA. Você pode experimentar o Veo 3.1, o Kling v3, o Sora 2 e dezenas de outros sem precisar de contas em várias plataformas. Escolha uma cena, escreva um prompt com detalhes específicos de iluminação e câmera e veja por si mesmo exatamente onde está a fronteira hoje.
Está mais perto do real do que você imagina.


