यह सवाल पहले सैद्धांतिक था। "क्या AI ऐसा वीडियो बना सकता है जो पूरी तरह असली लगे?" यह ऐसा सवाल था जिस पर रिसर्चर कॉन्फ़्रेंसों में बहस करते थे, जबकि आम लोग ऑनलाइन गड़बड़ और अजीब दिखने वाले नतीजों पर हँसते थे। अब यह बातचीत पूरी तरह बदल चुकी है। 2027 में जवाब है: हाँ, सही परिस्थितियों में, सही मॉडल के साथ, और सही तरह के कंटेंट के लिए। सिंथेटिक और असली वीडियो के बीच का फ़र्क इतना कम हो गया है कि प्रशिक्षित प्रोफ़ेशनल रोज़ाना धोखा खा रहे हैं, और आम लोग इनमें बिल्कुल फ़र्क नहीं कर पाते।
यह कोई दूर की संभावना नहीं है। यह अभी हो रहा है, बड़े पैमाने पर, ऐसे प्लेटफ़ॉर्म पर जहाँ कोई भी पहुँच सकता है।
AI वीडियो वास्तव में कितना आगे आ चुका है
ब्लॉकी क्लिप्स से 1080p रियलिज़्म तक
पहले व्यापक रूप से उपलब्ध AI वीडियो टूल छोटे, कम रेज़ोल्यूशन वाले क्लिप बनाते थे जो साफ़ तौर पर नकली लगते थे। चेहरे किनारों पर विकृत हो जाते थे। बाल फ़्रेम-दर-फ़्रेम झिलमिलाते थे। फ़िज़िक्स में गुरुत्वाकर्षण का कोई असर नहीं होता था। आप इन्हें सेकंडों में पहचान सकते थे। यह 2022 था।
2024 की शुरुआत तक इसमें उल्लेखनीय बदलाव आ गया। मॉडल ऐसे वीडियो बनाने लगे जिनमें फ़्रेम-दर-फ़्रेम एक जैसी लाइटिंग थी, चेहरे मूवमेंट के दौरान अपनी बनावट बनाए रखते थे, और नैचुरल मोशन ब्लर असली कैमरे के व्यवहार जैसा दिखता था। 2025 के मध्य तक, कई टॉप-टियर मॉडल नियमित रूप से ऐसे फ़ुटेज देने लगे जो आम इंसानी जाँच में पास हो जाते हैं।
इस तकनीकी छलांग के पीछे कुछ एक साथ आई प्रगतियाँ थीं: असली वीडियो के बड़े ट्रेनिंग डेटासेट, डिफ़्यूज़न-आधारित वीडियो जनरेशन में आर्किटेक्चर के सुधार, और टेम्पोरल कोहेरेंस पर नया फ़ोकस, यानी एक फ़्रेम से अगले फ़्रेम तक सीन के हर तत्व को तार्किक रूप से एक जैसा रखने की क्षमता।
2024 और 2025 में क्या बदला
तीन चीज़ों ने रियलिज़्म को नाटकीय रूप से तेज़ किया:
- डिफ़्यूज़न वीडियो मॉडल ने पहले के GAN-आधारित तरीकों की जगह ले ली। डिफ़्यूज़न मॉडल वीडियो की हाई-डायमेंशनल जटिलता को कहीं बेहतर तरीके से संभालते हैं, जिससे ज़्यादा नैचुरल टेक्सचर बनते हैं और आर्टिफ़ैक्ट कम होते हैं।
- फ़िज़िक्स-अवेयर जनरेशन एक असली फ़ीचर बन गया। मॉडल यह कैप्चर करने लगे कि हवा में बाल कैसे हिलते हैं, सरफ़ेस टेंशन के साथ पानी कैसे व्यवहार करता है, और रोशनी के स्रोत की गति के साथ परछाईं कैसे बदलती है।
- नेटिव ऑडियो इंटीग्रेशन आया। Veo 3 (Google की) और ByteDance के Seedance 1.5 Pro जैसे मॉडल अब आउटपुट के हिस्से के रूप में ही सिंक्रोनाइज़्ड ऑडियो बनाते हैं, किसी पोस्ट-प्रोसेसिंग स्टेप के रूप में नहीं। दृश्य से मेल खाती परिवेश की आवाज़ें, कदमों की आहट और बैकग्राउंड शोर एक ऐसी विश्वसनीयता जोड़ते हैं जो साइलेंट AI वीडियो में कभी नहीं थी।
💡 सबसे विश्वसनीय AI वीडियो वे नहीं हैं जिनकी त्वचा परफ़ेक्ट है। वे हैं जिनकी आवाज़ परफ़ेक्ट है। सिंक्रोनाइज़्ड परिवेश ऑडियो रियलिज़्म का सबसे नया और सबसे शक्तिशाली संकेत है।
कोई वीडियो असली कैसे दिखता है
मोशन और टेम्पोरल कोहेरेंस
AI वीडियो में सबसे बड़ा संकेत पहले मोशन हुआ करता था। चीज़ें चलने के बजाय खिसकती थीं। हाथ फ़्रेम-दर-फ़्रेम बदलते हुए विकृत हो जाते थे। लोग अस्वाभाविक तरीके से अपनी जगह बदलते थे। आज के मॉडल ऑप्टिकल फ़्लो कंडीशनिंग और लंबी-कॉन्टेक्स्ट जनरेशन विंडो से इसे हल करते हैं, जिससे मॉडल यह तय करते समय एक साथ 30 या उससे ज़्यादा फ़्रेम प्रोसेस कर पाता है कि अगला फ़्रेम कैसा दिखेगा।
नतीजा: चलते हुए किरदारों में अब पैर ज़मीन पर पड़ने का विश्वसनीय वज़न दिखता है। बाल मोमेंटम के साथ चलते हैं। सिर विश्वसनीय कोणीय वेग से घूमते हैं। Kling v3 Video या Veo 3.1 का फ़ुटेज देखने पर मोशन तब तक सिंथेटिक नहीं लगता जब तक आप ख़ास तौर पर उसे पकड़ने की कोशिश न करें।
त्वचा, टेक्सचर और माइक्रो-एक्सप्रेशन
इंसान नकली चेहरे पहचानने में असाधारण रूप से माहिर होते हैं। हमने चेहरे की ज्यामिति, त्वचा की गुणवत्ता और माइक्रो-एक्सप्रेशन के प्रति गहरी संवेदनशीलता विकसित की है, क्योंकि चेहरे ही हमारा प्राथमिक सामाजिक इंटरफ़ेस हैं। AI वीडियो में यह सबसे कठिन समस्या है, और इसे लगातार हल करने में कामयाबी हाल ही में मिली है।
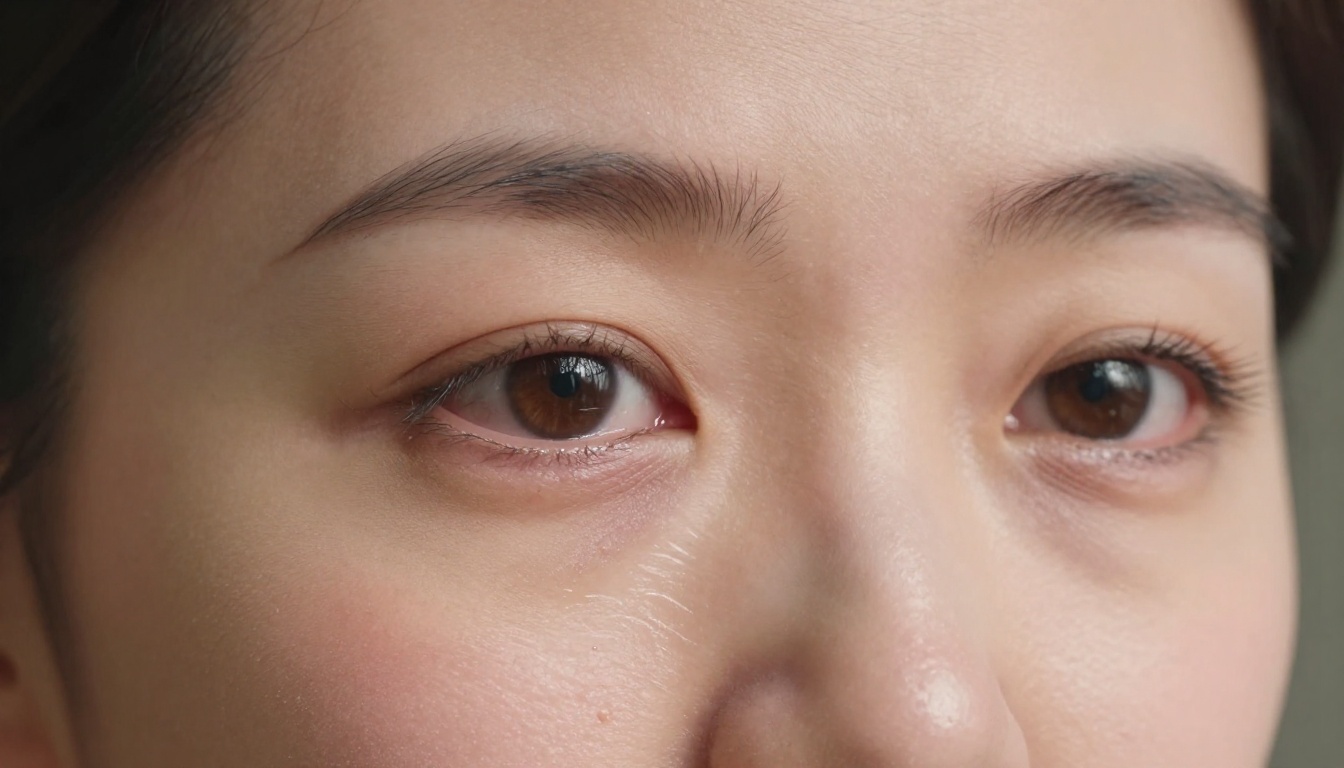
आज के टॉप-टियर मॉडल त्वचा को इन चीज़ों के साथ रेंडर करते हैं:
- सब-सरफ़ेस स्कैटरिंग: रोशनी त्वचा की परतों से कैसे गुज़रती है और रक्त वाहिकाओं के पास गर्माहट कैसे बनाती है
- पोर-लेवल टेक्सचर जो परिप्रेक्ष्य बदलने पर नैचुरल तरीके से बदलता है
- माइक्रो-एक्सप्रेशन: अनैच्छिक आँख की हरकतें, नथुनों का फड़कना, तनाव में होंठों का दबना
- नैचुरल असममितता: असली चेहरे पूरी तरह सममित नहीं होते, और AI मॉडलों को इसे विश्वसनीय रूप से दोहराना पड़ा है
इसे अभी सबसे अच्छी तरह करने वाले मॉडलों में OpenAI का Sora 2 Pro और MiniMax का Hailuo 02 शामिल हैं, जो दोनों ऐसे चेहरे के क्लोज़-अप बनाते हैं जो नियंत्रित अध्ययनों में नियमित रूप से लोगों को धोखा देते हैं।
लाइट फ़िज़िक्स और सीन कंसिस्टेंसी
असली कैमरे कुछ ख़ास तरीकों से व्यवहार करते हैं। जब रोशनी का स्रोत कुछ कोणों से पड़ता है तो लेंस फ़्लेयर दिखते हैं। डेप्थ ऑफ़ फ़ील्ड बैकग्राउंड को ब्लर करता है। मोशन ब्लर तेज़ गति वाली चीज़ों के पीछे एक निशान छोड़ता है। क्रोमैटिक एबरेशन हाई-कॉन्ट्रास्ट किनारों पर हल्की रंग-किनारी बनाता है।
AI मॉडल अब इन सभी व्यवहारों को दोहरा चुके हैं, पोस्ट-प्रोसेसिंग की चालों के रूप में नहीं, बल्कि जनरेशन के हिस्से के रूप में। Wan 2.7 T2V के आउटपुट में खिड़की के पास से गुज़रता कोई व्यक्ति, रोशनी की पट्टी से गुज़रते हुए, अपने चेहरे पर सही परछाईं पैटर्न के साथ दिखेगा। यह आसान नहीं है। इसके लिए मॉडल को सिर्फ़ विज़ुअल पैटर्न कॉपी करने के बजाय लाइट फ़िज़िक्स को आत्मसात करना पड़ता है।
वे मॉडल जो अभी रियलिज़्म की सीमा बढ़ा रहे हैं
2027 में टॉप टेक्स्ट-टू-वीडियो मॉडल
यह क्षेत्र तेज़ी से आगे बढ़ा है। ये वे मॉडल हैं जो अभी फ़ोटोरियलिस्टिक AI वीडियो जनरेशन का मानक तय कर रहे हैं:
एक नज़र में तुलना
हर काम के लिए सभी मॉडल एक जैसे नहीं हैं। Veo 3.1 लंबे सीक्वेंस में चेहरे की कोहेरेंस में आगे है। Sora 2 Pro बैकग्राउंड की गहराई के साथ जटिल मल्टी-कैरेक्टर सीन अच्छे से संभालता है। Kling v3 सबसे सिनेमैटिक लगने वाला मोशन देता है। LTX 2 Pro 4K रेज़ोल्यूशन देता है, जो प्रोफ़ेशनल उपयोग के लिए मायने रखता है। जब सिंक्रोनाइज़्ड ऑडियो प्राथमिकता हो, तो Seedance 1.5 Pro सही विकल्प है।
व्यावहारिक निष्कर्ष यह है: कोई एक मॉडल हर श्रेणी में नहीं जीतता। सबसे विश्वसनीय नतीजे तब आते हैं जब किसी ख़ास प्रकार के कंटेंट के लिए सही टूल चुना जाए।
💡 लोगों पर केंद्रित सबसे रियलिस्टिक कंटेंट के लिए, Veo 3.1 और Hailuo 02 सबसे मज़बूत विकल्प हैं। सिनेमैटिक वाइड शॉट्स के लिए, Kling v3 और Sora 2 Pro को हराना मुश्किल है।
नकली AI वीडियो कैसे पहचानें
5 संकेत जिन्हें आप खुद पहचान सकते हैं
आधुनिक मॉडलों के साथ भी कुछ पैटर्न ऐसे हैं जो सिंथेटिक मूल को उजागर कर देते हैं। इन्हें जानना ख़ुद को धोखा खाने से बचाने का पहला कदम है।
1. बैकग्राउंड की अस्थिरता
असली कैमरे एक स्थिर वातावरण कैप्चर करते हैं। AI मॉडल कभी-कभी बैकग्राउंड के तत्वों को खिसकने, झिलमिलाने या कट्स के बीच बदलने देते हैं। स्थिर चीज़ों को देखें: क्या वे पूरे क्लिप में बिल्कुल अपनी जगह पर रहती हैं?
2. हाथ और उँगलियों की ज्यामिति
मोशन के दौरान हाथों को सही तरीके से रेंडर करना AI के लिए शरीर के सबसे कठिन हिस्सों में से एक है। अतिरिक्त उँगलियाँ, जोड़ों का असामान्य मुड़ना, या चेहरे के पास आने पर विकृत होते हाथ लगातार संकेत हैं।
3. सीन में लिखा टेक्स्ट
बैकग्राउंड में दिखने वाला कोई भी टेक्स्ट, साइनबोर्ड पर या कपड़ों पर, AI वीडियो में लगभग हमेशा बिगड़ा हुआ होता है। अक्षर गड़बड़ाए हुए, गलत लिखे हुए होंगे, या फ़्रेम-दर-फ़्रेम बदलते रहेंगे।
4. सिल्हूट के किनारे पर बालों की फ़िज़िक्स
जहाँ बाल बैकग्राउंड से मिलते हैं, वह उच्च-जटिलता वाला इलाका है। सिंथेटिक वीडियो में सिल्हूट के किनारे पर अलग-अलग बाल अक्सर हल्के ब्लेंडिंग आर्टिफ़ैक्ट दिखाते हैं, या किसी भीड़भाड़ वाले बैकग्राउंड के सामने असामान्य रूप से चिकने किनारे दिखते हैं।
5. पलक झपकना और आँखों की हरकत
शुरुआती डीपफ़ेक शायद ही कभी नैचुरली पलक झपकाते थे। मौजूदा मॉडलों में सुधार हुआ है, लेकिन पलक झपकने का समय और गति अब भी अक्सर थोड़ी गड़बड़ होती है। ऐसी पलकों पर ध्यान दें जो बहुत ज़्यादा सिंक्रोनाइज़्ड हों, बहुत तेज़ हों, या कट्स के साथ संदिग्ध रूप से मेल खाती हों।
ऑटोमेटेड डिटेक्शन के तरीके
इंसानी पहचान भरोसेमंद नहीं है। कई तकनीकी तरीके इसे ऑटोमेट करने की कोशिश करते हैं:
- बायोमेट्रिक सिग्नल स्कैनिंग: असली वीडियो में सूक्ष्म जैविक संकेत होते हैं, जिनमें हृदय की धड़कन से सिर की सूक्ष्म हरकतें, रोशनी पर पुतली की प्रतिक्रिया और सांस की लय शामिल हैं। ये सिंथेटिक वीडियो में या तो गायब होते हैं या असंगत होते हैं।
- कंप्रेशन आर्टिफ़ैक्ट प्रोफ़ाइलिंग: AI वीडियो और असली वीडियो के कंप्रेस्ड फ़ॉर्मेट में अलग-अलग सांख्यिकीय फ़िंगरप्रिंट होते हैं।
- टेम्पोरल नॉइज़ प्रोफ़ाइलिंग: असली कैमरा सेंसर स्थानिक रूप से एक जैसे नॉइज़ पैटर्न बनाते हैं। AI जनरेशन के नॉइज़ का सांख्यिकीय सिग्नेचर अलग होता है।
समस्या यह है कि डिटेक्शन के तरीके हमेशा जनरेशन टूल से एक कदम पीछे रहते हैं। जैसे-जैसे मॉडल फ़ोटोरियलिज़्म में बेहतर होते हैं, वे अनजाने में ऑटोमेटेड डिटेक्शन को चकमा देने में भी बेहतर हो जाते हैं।
डीपफ़ेक एक असली समस्या क्यों हैं
मनोरंजन से आगे: दांव पर क्या है
सिंथेटिक वीडियो की शुरुआत एक पार्टी ट्रिक के रूप में हुई थी। यह एक राजनीतिक हथियार, धोखाधड़ी का साधन और बिना सहमति वाली अंतरंग इमेजरी का ज़रिया बन गया, जिससे हज़ारों असली लोगों को प्रमाणित नुकसान पहुँचा है। किसी के भी बारे में ऐसा विश्वसनीय वीडियो बना पाना, जिसमें वह कुछ भी कहता या करता दिखे, इसके स्पष्ट और तात्कालिक नतीजे हैं:
- राजनीतिक गलत सूचना: उम्मीदवारों या अधिकारियों के ऐसे बयानों के गढ़े हुए वीडियो, जो उन्होंने कभी दिए ही नहीं
- वित्तीय धोखाधड़ी: वायर ट्रांसफ़र को मंज़ूरी दिलाने के लिए वीडियो कॉल पर CEO की नकल (यह बड़े पैमाने पर पहले ही हो चुका है, जिसमें करोड़ों डॉलर के दर्ज नुकसान हुए हैं)
- प्रतिष्ठा को नुकसान: बिना सहमति के निजी व्यक्तियों को निशाना बनाने वाला सिंथेटिक अंतरंग कंटेंट
- सबूत गढ़ना: उन घटनाओं की ऐसी फ़ुटेज, जो प्रथम दृष्टया सत्यापित लगती है, जबकि वे घटनाएँ कभी हुई ही नहीं
रियलिज़्म की तेज़ी इन सभी खतरों को और गंभीर बना देती है। 2020 का धुंधला डीपफ़ेक आसानी से खारिज किया जा सकता था। 2025 का 1080p सिंथेटिक वीडियो, जिसमें सही लाइटिंग, सिंक्रोनाइज़्ड ऑडियो और नैचुरल माइक्रो-एक्सप्रेशन हों, वैसा नहीं है।
असली बताकर वायरल हुए मामले
कई हाई-प्रोफ़ाइल घटनाओं ने असली दुनिया पर पड़ने वाला असर दिखाया है। एक यूरोपीय वित्तीय अधिकारी की सिंथेटिक ऑडियो-वीडियो क्लिप का इस्तेमाल एक ही योजना में कई कंपनियों से धोखाधड़ी के लिए किया गया, जिसमें कई करोड़ डॉलर शामिल थे। 2024 के चुनाव चक्र के दौरान कई देशों में चुनावी संदर्भों में राजनीतिक डीपफ़ेक घूमे, और पोलिंग डेटा में सार्वजनिक धारणा पर उनके असर के दस्तावेज़ी सबूत मिले।
पैटर्न लगातार एक जैसा है: सिंथेटिक वीडियो जितना ज़्यादा असली लगता है, उसे फ़्लैग होने से पहले उतनी ही देर तक घूमता है, और उस खिड़की में उतना ही ज़्यादा नुकसान करता है।
💡 वायरल होना खंडन से पहले होता है। जब तक फ़ैक्ट-चेकर किसी परिष्कृत डीपफ़ेक को पकड़ते हैं, वह पहले ही लाखों बार देखा जा चुका होता है।
PicassoIA पर असली दिखने वाला AI वीडियो कैसे बनाएँ
कौन से मॉडल सबसे अच्छा काम करते हैं
PicassoIA आपको अभी उपलब्ध सबसे सक्षम वीडियो जनरेशन मॉडल एक ही जगह पर देता है। फ़ोटोरियलिस्टिक आउटपुट के लिए, ये मॉडल सबसे मज़बूत नतीजे देते हैं:
असली लोगों और चेहरों के लिए:
- Veo 3.1 बेहतरीन चेहरे की कोहेरेंस और नेटिव ऑडियो जनरेशन के साथ 1080p आउटपुट देता है
- Hailuo 02 मज़बूत फ़ेस रेंडरिंग के साथ साफ़ 1080p वीडियो बनाता है
- Kling v2.6 किरदार-केंद्रित सिनेमैटिक सीन को नैचुरल मोशन के साथ संभालता है
वाइड सीन और वातावरण के लिए:
- Sora 2 मज़बूत फ़िज़िक्स सिमुलेशन के साथ जटिल मल्टी-एलिमेंट सीन संभालता है
- Wan 2.7 T2V उत्कृष्ट सीन कंसिस्टेंसी के साथ 1080p आउटपुट देता है
- Pixverse v5 सामान्य-उद्देश्य वाले असली दिखने वाले वीडियो के लिए तेज़ और भरोसेमंद है
4K और प्रोफ़ेशनल रेज़ोल्यूशन के लिए:
- LTX 2 Pro 4K आउटपुट देता है, इस रेज़ोल्यूशन पर व्यापक कंटेंट सपोर्ट वाला अकेला मॉडल
बेहतर रियलिज़्म के लिए सुझाव
इनमें से किसी भी मॉडल से सचमुच विश्वसनीय नतीजा पाने के लिए सिर्फ़ प्रॉम्प्ट लिखना काफ़ी नहीं है। ये तरीके लगातार रियलिज़्म बढ़ाते हैं:
कैमरे के व्यवहार के बारे में साफ़-साफ़ बताएँ। "हल्के हिलते हाथ वाला कैमरा," "85mm लेंस के साथ शैलो डेप्थ ऑफ़ फ़ील्ड," या "डायलॉग के दौरान धीमा ज़ूम" जैसे वाक्यांश मॉडल को असली सिनेमैटोग्राफ़ी दोहराने का इशारा देते हैं, सिर्फ़ इमेजरी बनाने का नहीं।
लाइट के स्रोत साफ़ तौर पर बताएँ। "दाईं खिड़की से दोपहर की धूप" मॉडल को फ़िज़िक्स का एक ठोस आधार देती है। "अच्छी रोशनी" से उसे कुछ नहीं मिलता। आपका लाइटिंग वर्णन जितना विशिष्ट होगा, क्लिप में परछाइयाँ उतनी ही एक जैसी रहेंगी।
सीक्वेंस छोटे और केंद्रित रखें। सभी मौजूदा मॉडल लंबी क्लिप्स में कंसिस्टेंसी खोते हैं। एक ही सेटिंग में एक व्यक्ति की 5 सेकंड की क्लिप, कई किरदारों और सीन ट्रांज़िशन वाली 15 सेकंड की क्लिप से ज़्यादा विश्वसनीय लगेगी।
जहाँ संभव हो रेफ़रेंस इमेज इस्तेमाल करें। Wan 2.7 I2V या Kling v2.6 Motion Control जैसे मॉडल, जो इमेज-टू-वीडियो इनपुट स्वीकार करते हैं, किसी फ़ोटोरियलिस्टिक स्टिल से शुरू करके उसे एनिमेट कर सकते हैं। इससे चेहरा बनाने की कई चुनौतियाँ पूरी तरह दरकिनार हो जाती हैं।
💡 फ़ोटोरियलिस्टिक AI वीडियो तक पहुँचने का सबसे आसान रास्ता किसी फ़ोटोरियलिस्टिक स्टिल इमेज से शुरू करना है। पहले किसी इमेज मॉडल से अपना फ़्रेम बनाएँ, फिर उसे एनिमेट करें। नतीजा लगभग हमेशा शुद्ध टेक्स्ट-टू-वीडियो से ज़्यादा विश्वसनीय होता है।
कुछ असली बनाना शुरू करें
AI वीडियो और असली वीडियो के बीच की रेखा अब भरोसेमंद नहीं रही। जो लोग कंटेंट बनाते हैं, उनके लिए यह एक वास्तविक रचनात्मक अवसर है। जो लोग कंटेंट देखते हैं, उनके लिए इसका मतलब है कि उन्हें नई आदतें विकसित करनी होंगी, ताकि वे तय कर सकें कि किस पर भरोसा करते हैं और क्यों।
अभी उपलब्ध मॉडल सचमुच ऐसे फ़ुटेज बनाने में सक्षम हैं जो इंसानी जाँच पास कर लेते हैं। यह कोई चेतावनी नहीं है, यह उस समय का एक तथ्य है जिसमें हम जी रहे हैं। इसका आप क्या करते हैं, चाहे कहानियाँ सुनाने के लिए, कंटेंट बनाने के लिए, या बस एक दर्शक के रूप में और सतर्क रहने के लिए, यह आपके ऊपर है।
इस लेख में बताए गए सभी मॉडल PicassoIA पर उपलब्ध हैं। आप Veo 3.1, Kling v3, Sora 2 और दर्जनों अन्य को आज़मा सकते हैं, बिना कई प्लेटफ़ॉर्म पर अलग-अलग अकाउंट बनाए। कोई सीन चुनें, लाइटिंग और कैमरे के विवरण के साथ प्रॉम्प्ट लिखें, और खुद देखें कि आज सीमा कहाँ है।
यह आपकी सोच से कहीं ज़्यादा असली के करीब है।


