La pregunta antes era teórica. "¿Puede la IA crear un video que parezca completamente real?" era algo que los investigadores debatían en congresos, mientras el público general se reía de los resultados torpes y inquietantes que circulaban en internet. Esa conversación ha cambiado por completo. En 2027, la respuesta es sí, en las condiciones adecuadas, con los modelos adecuados y para el contenido adecuado. La diferencia entre el video sintético y el auténtico se ha reducido hasta el punto de que profesionales entrenados se dejan engañar a diario y las personas corrientes no distinguen la diferencia en absoluto.
Esto no es una posibilidad lejana. Está ocurriendo ahora, a gran escala, en plataformas a las que cualquiera puede acceder.
Hasta dónde ha llegado realmente el video de IA
De clips toscos al realismo en 1080p
Las primeras herramientas de video de IA accesibles para todos generaban clips cortos y de baja resolución que eran obviamente artificiales. Los rostros se distorsionaban en los bordes. El pelo parpadeaba entre fotogramas. La física ignoraba la gravedad. Se podían detectar en segundos. Eso fue en 2022.
A comienzos de 2024, la situación había cambiado de forma notable. Los modelos empezaron a producir videos con iluminación constante entre fotogramas, rostros que mantenían su geometría durante el movimiento y un desenfoque de movimiento natural que imitaba el comportamiento de una cámara real. A mediados de 2025, varios de los mejores modelos ya generaban videos que superan una revisión casual por parte de personas.
El salto técnico llegó gracias a unos pocos avances que convergieron: conjuntos de entrenamiento más grandes con video real, mejoras en la arquitectura de la generación de video por difusión y un nuevo enfoque en la coherencia temporal, es decir, la capacidad de mantener cada elemento de una escena lógicamente coherente de un fotograma al siguiente.
Qué cambió en 2024 y 2025
Tres cosas aceleraron el realismo de forma notable:
- Los modelos de video por difusión reemplazaron a los enfoques anteriores basados en GAN. Los modelos de difusión manejan mucho mejor la complejidad de alta dimensión del video, producen texturas más naturales y generan menos artefactos.
- La generación con conciencia de la física se convirtió en una función real. Los modelos empezaron a captar cómo se mueve el pelo con el viento, cómo se comporta el agua con la tensión superficial y cómo las sombras siguen el movimiento de una fuente de luz.
- Llegó la integración de audio nativo. Modelos como Veo 3 de Google y Seedance 1.5 Pro de ByteDance generan ahora audio sincronizado como parte del propio resultado, no como un paso de posproducción. El sonido ambiente, las pisadas y el ruido de fondo que coinciden con la escena visual añaden una capa de credibilidad que el video de IA sin sonido nunca tuvo.
💡 Los videos de IA más convincentes no son los que tienen la piel perfecta. Son los que tienen el sonido perfecto. El audio ambiente sincronizado es la señal de realismo más nueva y más potente.
Qué hace que un video parezca real
Movimiento y coherencia temporal
La señal más delatora del video de IA solía ser el movimiento. Los objetos se deslizaban en lugar de moverse. Las manos se deformaban entre fotogramas. Las personas cambiaban de posición de maneras antinaturales. Los modelos actuales abordan este problema mediante el condicionamiento por flujo óptico y ventanas de generación con contexto más largo, que les permiten procesar 30 o más fotogramas a la vez al decidir cómo será el siguiente.
El resultado: los personajes que caminan ahora tienen el peso del pie al apoyarse. El pelo sigue el impulso. Las cabezas giran a velocidades angulares creíbles. Cuando ves imágenes de Kling v3 Video o Veo 3.1, el movimiento ya no parece sintético a menos que busques específicamente ese detalle.
Piel, textura y microexpresiones
Los seres humanos somos extraordinariamente buenos detectando rostros falsos. Hemos desarrollado una sensibilidad muy aguda a la geometría facial, la calidad de la piel y las microexpresiones, porque el rostro es nuestra principal interfaz social. Este es el problema más difícil del video de IA, y solo hace poco se está resolviendo con cierta constancia.
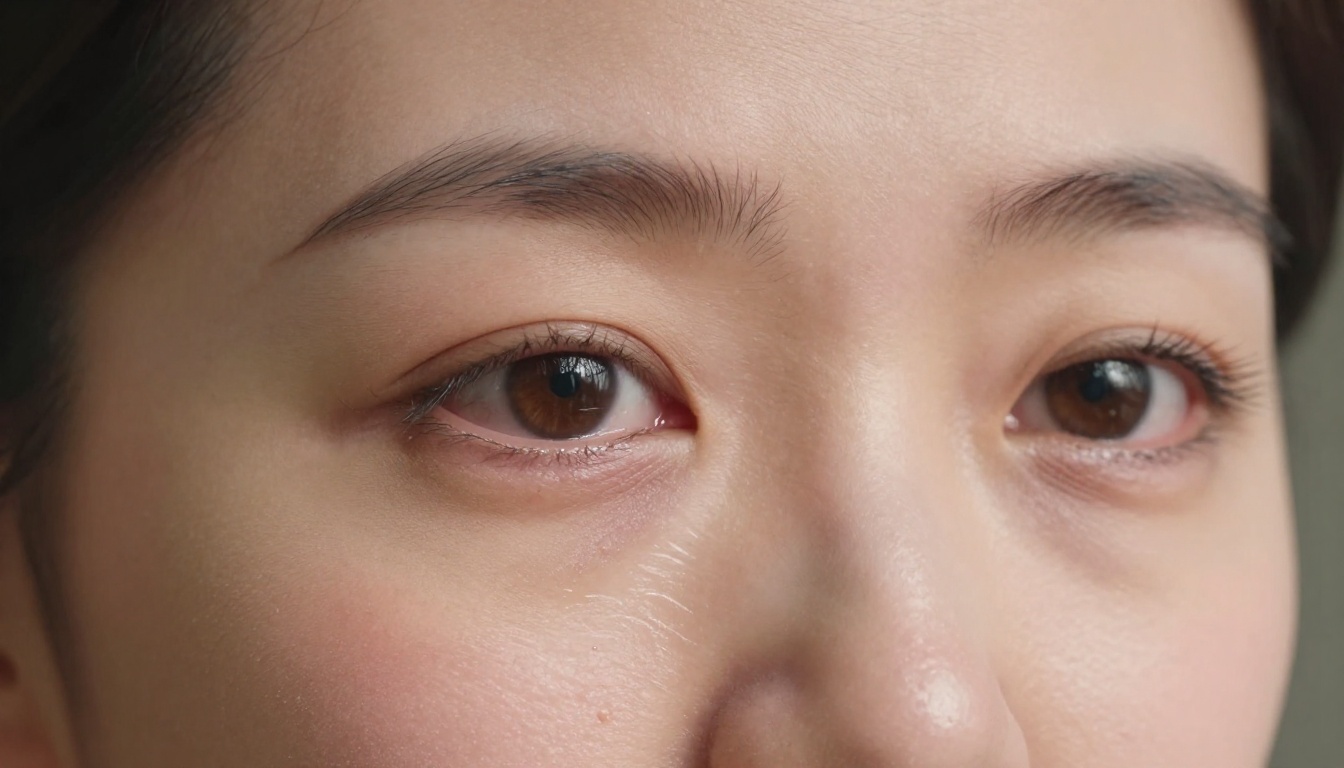
Los mejores modelos actuales ya representan la piel con:
- Dispersión subsuperficial: la forma en que la luz atraviesa las capas de la piel y crea calidez cerca de los vasos sanguíneos
- Textura a nivel de poro que cambia de forma natural con los cambios de perspectiva
- Microexpresiones: movimientos involuntarios de los ojos, aleteo de las fosas nasales, compresión de los labios bajo estrés
- Asimetría natural: los rostros reales no son perfectamente simétricos, y los modelos de IA han tenido que reproducir esto de forma convincente
Los modelos que mejor lo hacen en este momento incluyen Sora 2 Pro de OpenAI y Hailuo 02 de MiniMax, ambos capaces de producir primeros planos faciales que engañan con regularidad a personas en estudios controlados.
Física de la luz y coherencia de escenas
Las cámaras reales se comportan de maneras concretas. Los destellos de lente aparecen cuando una fuente de luz incide en ciertos ángulos. La profundidad de campo desenfoca el fondo. El desenfoque de movimiento deja estelas en los objetos que se desplazan rápido. La aberración cromática crea sutiles franjas de color en los bordes de alto contraste.
Los modelos de IA ya replican todos estos comportamientos, no como trucos de posproducción sino como parte de la propia generación. Una persona que pasa junto a una ventana en el resultado de Wan 2.7 T2V tendrá el patrón de sombra correcto en el rostro mientras atraviesa la franja de luz. Eso no es fácil. Requiere que el modelo interiorice la física de la luz, no solo que copie patrones visuales.
Los modelos que empujan el realismo ahora mismo
Los mejores modelos de texto a video en 2027
El sector ha avanzado rápido. Estos son los modelos que actualmente marcan el estándar para la generación de video de IA fotorrealista:
| Modelo | Desarrollador | Resolución máxima | Audio | Punto fuerte de realismo |
|---|
| Veo 3.1 | Google | 1080p | Nativo | Coherencia facial, movimiento |
| Sora 2 Pro | OpenAI | 1080p | Sí | Escenas complejas, física |
| Kling v3 Video | Kwai | 1080p | No | Movimiento, cinematografía |
| Seedance 1.5 Pro | ByteDance | 1080p | Nativo | Sincronización audiovisual |
| Hailuo 02 | MiniMax | 1080p | No | Realismo facial |
| LTX 2 Pro | Lightricks | 4K | No | Resolución, detalle |
| Gen 4.5 | RunwayML | 1080p | No | Movimiento cinematográfico |
| Wan 2.7 T2V | Wan Video | 1080p | No | Coherencia de escenas |
Cómo se comparan de un vistazo
No todos los modelos sirven igual para cada tarea. Veo 3.1 destaca en coherencia facial en secuencias largas. Sora 2 Pro maneja bien escenas complejas con varios personajes y profundidad de fondo. Kling v3 produce el movimiento de aspecto más cinematográfico. LTX 2 Pro genera resolución 4K, lo que importa en aplicaciones profesionales. Seedance 1.5 Pro es la opción adecuada cuando el audio sincronizado es una prioridad.
La consecuencia práctica: ningún modelo gana en todas las categorías. Los resultados más convincentes llegan al elegir la herramienta adecuada para el tipo de contenido concreto que tienes entre manos.
💡 Para el contenido más realista centrado en personas, Veo 3.1 y Hailuo 02 son las opciones más sólidas. Para planos generales cinematográficos, Kling v3 y Sora 2 Pro son difíciles de superar.
Cómo detectar un video de IA falso
5 señales que puedes detectar tú mismo
Incluso con los modelos modernos, hay patrones que delatan el origen sintético. Conocerlos es el primer paso para protegerte de que te engañen.
1. Inestabilidad del fondo
Las cámaras reales captan un entorno estable. Los modelos de IA a veces dejan que los elementos del fondo cambien de posición, parpadeen o se transformen entre cortes. Fíjate en los objetos inmóviles: ¿se mantienen exactamente en su sitio durante todo el clip?
2. Geometría de manos y dedos
Las manos siguen siendo una de las partes del cuerpo más difíciles de representar correctamente con movimiento. Dedos de más, articulaciones que se doblan de forma rara o manos que se deforman al acercarse al rostro son señales constantes.
3. Texto en la escena
Cualquier texto visible en el fondo, en carteles o en la ropa, casi siempre aparece corrompido en el video de IA. Las letras estarán revueltas, mal escritas o cambiarán entre fotogramas.
4. Física del pelo en el borde de la silueta
Donde el pelo se encuentra con el fondo es una zona de alta complejidad. En el video sintético, los mechones individuales en el borde de la silueta suelen mostrar sutiles artefactos de mezcla o bordes demasiado suaves sobre un fondo cargado.
5. Parpadeo y movimiento de los ojos
Los primeros deepfakes rara vez parpadeaban de forma natural. Los modelos actuales han mejorado, pero el ritmo y la velocidad de los parpadeos sigue siendo a menudo algo irregular. Fíjate en los parpadeos demasiado sincronizados, demasiado rápidos o que coinciden de forma sospechosa con los cortes.
Métodos de detección automatizados
La detección humana no es fiable. Varios enfoques técnicos intentan automatizarla:
- Escaneo de señales biométricas: el video real contiene señales biológicas sutiles, como microdesplazamientos de la cabeza causados por el latido, la respuesta de la pupila a la luz y el ritmo de la respiración. Estas están ausentes o son irregulares en el video sintético.
- Perfilado de artefactos de compresión: el video de IA y el real tienen huellas estadísticas diferentes en sus formatos comprimidos.
- Perfilado del ruido temporal: los sensores de cámara reales producen patrones de ruido espacialmente constantes. El ruido de la generación con IA tiene una firma estadística distinta.
El problema es que los métodos de detección siempre van un paso por detrás de las herramientas de generación. A medida que los modelos mejoran en fotorrealismo, también mejoran sin querer en eludir la detección automatizada.
Por qué los deepfakes son un problema real
Más allá del entretenimiento: lo que está en juego
El video sintético empezó como un truco de salón. Se convirtió en un arma política, un instrumento de fraude y un vehículo de imágenes íntimas sin consentimiento que ha causado daños documentados a miles de personas reales. La capacidad de generar un video convincente de cualquier persona diciendo o haciendo cualquier cosa tiene implicaciones claras e inmediatas:
- Desinformación política: videos falsificados de candidatos o funcionarios haciendo declaraciones que nunca hicieron
- Fraude financiero: suplantación de directores ejecutivos en videollamadas para autorizar transferencias bancarias (ya ha ocurrido a gran escala, con pérdidas documentadas de decenas de millones)
- Daño a la reputación: contenido íntimo sintético dirigido a particulares sin su consentimiento
- Fabricación de pruebas: imágenes aparentemente verificadas de hechos que nunca ocurrieron
La aceleración del realismo hace que todas estas amenazas sean más graves. Un deepfake borroso de 2020 era fácil de descartar. Un video sintético en 1080p de 2025, con iluminación correcta, audio sincronizado y microexpresiones naturales, no lo es.
Casos que se hicieron virales como si fueran reales
Varios incidentes de alto perfil han demostrado el impacto en el mundo real. Un clip de audio y video sintético de un funcionario financiero europeo se utilizó para estafar a varias empresas en un mismo esquema que involucró decenas de millones de dólares. Durante el ciclo electoral de 2024, circularon deepfakes políticos en contextos electorales de varios países, con una influencia documentada en la percepción pública según datos de encuestas.
El patrón se repite con constancia: cuanto más realista es el video sintético, más tiempo circula antes de que lo marquen y más daño causa en ese intervalo.
💡 La difusión viral ocurre antes que el desmentido. Cuando los verificadores de datos detectan un deepfake sofisticado, ya se ha visto millones de veces.
Cómo crear video de IA realista en PicassoIA
Qué modelos funcionan mejor
PicassoIA te da acceso a los modelos de generación de video más capaces disponibles actualmente, todos en un solo lugar. Para un resultado fotorrealista, los siguientes modelos ofrecen los mejores resultados:
Para personas y rostros realistas:
- Veo 3.1 ofrece resultados en 1080p con excelente coherencia facial y generación de audio nativa
- Hailuo 02 produce video limpio en 1080p con una buena representación de rostros
- Kling v2.6 maneja escenas cinematográficas centradas en personajes con movimiento realista
Para escenas amplias y entornos:
- Sora 2 maneja escenas complejas con muchos elementos y una sólida simulación de física
- Wan 2.7 T2V produce resultados en 1080p con excelente coherencia de escenas
- Pixverse v5 es rápido y fiable para video realista de uso general
Para 4K y resolución profesional:
- LTX 2 Pro genera 4K, el único modelo a esta resolución con un soporte amplio de contenido
Consejos para un mayor realismo
Para obtener un resultado realmente convincente con cualquiera de estos modelos, hace falta algo más que escribir un prompt. Estas prácticas mejoran el realismo con regularidad:
Sé específico sobre el comportamiento de la cámara. Frases como "cámara en mano con una leve vibración", "poca profundidad de campo con objetivo de 85 mm" o "zoom lento durante el diálogo" indican al modelo que replique la cinematografía real, no solo que genere imágenes.
Describe las fuentes de luz de forma explícita. "Luz de la tarde que entra por la ventana derecha" le da al modelo un anclaje físico. "Bien iluminado" no le da nada. Cuanto más concreta sea tu descripción de la luz, más coherentes serán las sombras a lo largo del clip.
Mantén las secuencias cortas y centradas. Todos los modelos actuales pierden coherencia en clips más largos. Un clip de 5 segundos con una sola persona en un solo escenario resultará más convincente que uno de 15 segundos con varios personajes y cambios de escena.
Usa imágenes de referencia cuando las tengas. Los modelos que aceptan imagen a video, como Wan 2.7 I2V o Kling v2.6 Motion Control, pueden partir de una imagen fija fotorrealista y animarla. Esto evita por completo muchos de los problemas de generación de rostros.
💡 El camino más fácil hacia el video de IA fotorrealista es partir de una imagen fija fotorrealista. Genera primero el fotograma con un modelo de imágenes y luego anímalo. El resultado casi siempre es más convincente que el texto a video puro.
Empieza a crear algo real
La línea entre el video de IA y el video real ya no es fiable. Para quien crea contenido, eso supone una auténtica oportunidad creativa. Para quien consume contenido, significa desarrollar nuevos hábitos sobre en qué confiar y por qué.
Los modelos disponibles ahora mismo son realmente capaces de producir imágenes que superan el escrutinio humano. No es una advertencia, es un hecho sobre el momento en el que estamos. Lo que hagas con eso, ya sea para contar historias, crear contenido o simplemente estar más alerta como espectador, depende de ti.
Todos los modelos mencionados en este artículo están disponibles en PicassoIA. Puedes probar Veo 3.1, Kling v3, Sora 2 y decenas más sin necesidad de crear cuentas en varias plataformas. Elige una escena, escribe un prompt con detalles específicos de luz y cámara y comprueba por ti mismo dónde está hoy la frontera.
Está más cerca de lo real de lo que crees.


