La question était autrefois théorique. « Une IA peut-elle créer une vidéo parfaitement réelle ? » était un sujet de débat entre chercheurs lors de conférences, tandis que le grand public se moquait des résultats bancals et étranges publiés en ligne. Cette conversation a complètement changé. En 2027, la réponse est oui, dans les bonnes conditions, avec les bons modèles et pour le bon type de contenu. L’écart entre vidéo de synthèse et vidéo authentique s’est tellement réduit que des professionnels formés se laissent piéger au quotidien, et que les personnes ordinaires ne perçoivent absolument pas la différence.
Il ne s’agit pas d’une possibilité lointaine. C’est une réalité aujourd’hui, à grande échelle, sur des plateformes accessibles à tous.
Le chemin parcouru par la vidéo IA
Des clips pixelisés au réalisme en 1080p
Les premiers outils de vidéo IA accessibles au grand public produisaient de courts clips à faible résolution, manifestement artificiels. Les visages se déformaient sur les bords. Les cheveux scintillaient d’une image à l’autre. La physique ignorait la gravité. On les repérait en quelques secondes. C’était en 2022.
Dès le début 2024, la situation avait nettement évolué. Les modèles ont commencé à produire des vidéos à l’éclairage constant d’une image à l’autre, des visages conservant leur géométrie pendant le mouvement, et un flou de bougé naturel imitant le comportement d’une vraie caméra. Au milieu de 2025, plusieurs modèles haut de gamme produisaient régulièrement des séquences capables de passer un examen humain superficiel.
Ce bond technique résulte de plusieurs avancées convergentes : des jeux de données d’entraînement vidéo réelle plus volumineux, des améliorations architecturales dans la génération vidéo par diffusion, et une attention nouvelle portée à la cohérence temporelle, c’est-à-dire la capacité à garder chaque élément d’une scène logiquement cohérent d’une image à la suivante.
Ce qui a changé en 2024 et 2025
Trois éléments ont fortement accéléré le réalisme :
- Les modèles vidéo par diffusion ont remplacé les approches antérieures fondées sur les GAN. Les modèles de diffusion gèrent bien mieux la complexité à haute dimension de la vidéo, produisant des textures plus naturelles et moins d’artefacts.
- La génération sensible à la physique est devenue une véritable fonctionnalité. Les modèles ont commencé à capturer la façon dont les cheveux bougent sous l’effet du vent, le comportement de l’eau sous l’effet de la tension superficielle, et la manière dont les ombres suivent le mouvement d’une source de lumière.
- L’intégration native de l’audio est arrivée. Des modèles comme Veo 3 de Google et Seedance 1.5 Pro de ByteDance génèrent désormais un son synchronisé dans la vidéo elle-même, et non lors d’une étape de post-traitement. Les ambiances sonores, les bruits de pas et le bruit de fond qui correspondent à la scène visuelle ajoutent une couche de crédibilité que la vidéo IA muette n’a jamais eue.
💡 Les vidéos IA les plus convaincantes ne sont pas celles à la peau parfaite. Ce sont celles au son parfait. Le son ambiant synchronisé est le signal de réalisme le plus récent et le plus puissant.
Ce qui rend une vidéo réaliste
Mouvement et cohérence temporelle
Le principal indice trahissant la vidéo IA était autrefois le mouvement. Les objets glissaient au lieu de se déplacer. Les mains se déformaient d’une image à l’autre. Les personnes changeaient de position de manière peu naturelle. Les modèles actuels répondent à ce problème grâce au conditionnement par flux optique et à des fenêtres de contexte plus longues, qui leur permettent de traiter 30 images ou plus simultanément pour décider à quoi ressemblera l’image suivante.
Résultat : les personnages qui marchent ont désormais un poids crédible à chaque appui de pied au sol. Les cheveux suivent l’élan. Les têtes tournent à des vitesses angulaires crédibles. Lorsque vous regardez des images de Kling v3 Video ou de Veo 3.1, le mouvement ne paraît plus synthétique, sauf si vous cherchez précisément à le remarquer.
Peau, texture et micro-expressions
Les êtres humains sont extraordinairement doués pour détecter les faux visages. Nous avons développé une sensibilité aiguë à la géométrie du visage, à la qualité de la peau et aux micro-expressions, car le visage est notre principale interface sociale. C’est le problème le plus difficile de la vidéo IA à résoudre, et il ne commence à être résolu de façon régulière que depuis peu.
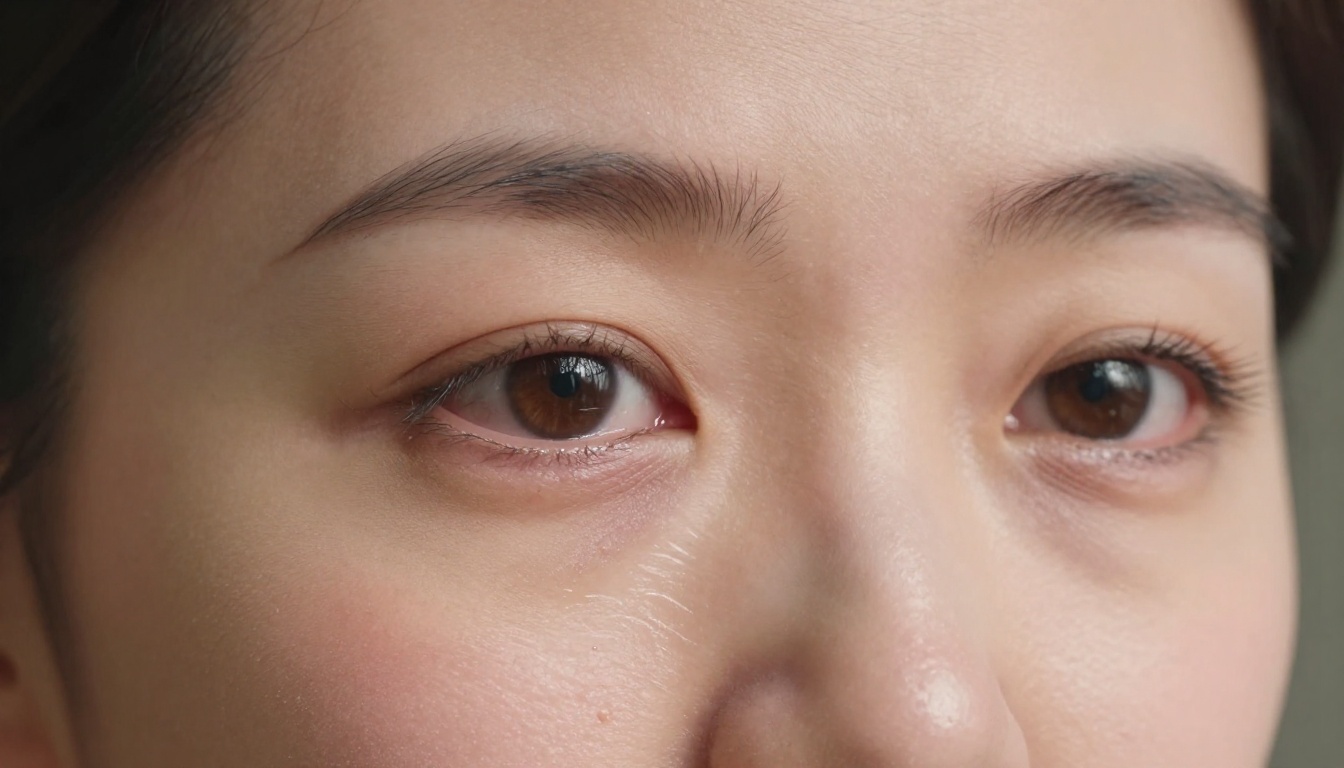
Les modèles haut de gamme actuels rendent la peau avec :
- La diffusion sous la surface : la façon dont la lumière traverse les couches de la peau et crée une chaleur près des vaisseaux sanguins
- Une texture au niveau des pores qui change naturellement avec les variations de perspective
- Les micro-expressions : mouvements involontaires des yeux, dilatations des narines, contraction des lèvres sous l’effet du stress
- Une asymétrie naturelle : les vrais visages ne sont pas parfaitement symétriques, et les modèles d’IA ont dû reproduire cette irrégularité de façon convaincante
Les modèles les plus performants sur ce point sont actuellement Sora 2 Pro d’OpenAI et Hailuo 02 de MiniMax, qui produisent tous deux des gros plans de visages capables de tromper régulièrement des personnes lors d’études contrôlées.
Physique de la lumière et cohérence de la scène
Les vraies caméras se comportent de façons précises. Des reflets de lentille apparaissent lorsqu’une source lumineuse frappe l’objectif sous certains angles. La profondeur de champ floute l’arrière-plan. Le flou de bougé traîne derrière les objets rapides. L’aberration chromatique crée de légères franges de couleur sur les contours très contrastés.
Les modèles d’IA reproduisent désormais tous ces comportements, non pas comme des astuces de post-traitement, mais dans la génération elle-même. Une personne qui passe devant une fenêtre dans une vidéo de Wan 2.7 T2V aura le bon motif d’ombre sur le visage lorsqu’elle traverse la bande de lumière. Ce n’est pas facile. Cela exige que le modèle intègre la physique de la lumière, et pas seulement qu’il copie des motifs visuels.
Les modèles qui repoussent aujourd’hui les limites du réalisme
Les meilleurs modèles texte vers vidéo en 2027
Le domaine a évolué rapidement. Voici les modèles qui fixent actuellement la norme de la génération de vidéos photoréalistes par IA :
| Modèle | Développeur | Résolution max | Audio | Point fort en réalisme |
|---|
| Veo 3.1 | Google | 1080p | Natif | Cohérence du visage, mouvement |
| Sora 2 Pro | OpenAI | 1080p | Oui | Scènes complexes, physique |
| Kling v3 Video | Kwai | 1080p | Non | Mouvement, cinématographie |
| Seedance 1.5 Pro | ByteDance | 1080p | Natif | Synchronisation audio-visuelle |
| Hailuo 02 | MiniMax | 1080p | Non | Réalisme des visages |
| LTX 2 Pro | Lightricks | 4K | Non | Résolution, détail |
| Gen 4.5 | RunwayML | 1080p | Non | Mouvement cinématographique |
| Wan 2.7 T2V | Wan Video | 1080p | Non | Cohérence de la scène |
Comparaison rapide
Tous les modèles ne sont pas égaux selon les tâches. Veo 3.1 l’emporte en matière de cohérence du visage sur de longues séquences. Sora 2 Pro gère bien les scènes complexes à plusieurs personnages avec une profondeur d’arrière-plan. Kling v3 produit le mouvement le plus cinématographique. LTX 2 Pro produit de la 4K, ce qui compte pour les usages professionnels. Seedance 1.5 Pro est le bon choix lorsque la synchronisation audio est une priorité.
Concrètement, aucun modèle ne gagne dans toutes les catégories. Les résultats les plus convaincants viennent du choix de l’outil adapté au type de contenu à réaliser.
💡 Pour les contenus les plus réalistes centrés sur les personnes, Veo 3.1 et Hailuo 02 sont les choix les plus solides. Pour les plans larges cinématographiques, Kling v3 et Sora 2 Pro sont difficiles à battre.
5 indices que vous pouvez repérer vous-même
Même avec les modèles récents, certains schémas trahissent une origine synthétique. Les connaître est la première étape pour vous protéger d’une tromperie.
1. Instabilité de l’arrière-plan
Les vraies caméras captent un environnement stable. Les modèles d’IA laissent parfois des éléments de l’arrière-plan se déplacer, scintiller ou changer entre deux plans. Observez les objets immobiles : restent-ils exactement à leur place tout au long de la séquence ?
2. Géométrie des mains et des doigts
Les mains restent l’une des parties du corps les plus difficiles à restituer correctement en mouvement. Des doigts en trop, une flexion articulaire inhabituelle ou des mains qui se déforment lorsqu’elles s’approchent du visage sont des signaux révélateurs.
3. Texte présent dans la scène
Tout texte visible en arrière-plan, sur des panneaux ou des vêtements, est presque toujours altéré dans la vidéo IA. Les lettres sont brouillées, mal orthographiées ou changent d’une image à l’autre.
4. Physique des cheveux au bord de la silhouette
La zone où les cheveux rencontrent l’arrière-plan est très complexe. Dans une vidéo de synthèse, les mèches isolées au bord de la silhouette présentent souvent de subtils artefacts de fusion ou des contours anormalement lisses sur un arrière-plan chargé.
5. Clignements et mouvements des yeux
Les premiers deepfakes clignaient rarement des yeux de manière naturelle. Les modèles actuels ont progressé, mais le rythme et la vitesse des clignements sont encore souvent légèrement décalés. Méfiez-vous des clignements trop synchronisés, trop rapides ou qui coïncident de façon suspecte avec les coupures.
Méthodes de détection automatisée
La détection humaine n’est pas fiable. Plusieurs approches techniques tentent de l’automatiser :
- Analyse des signaux biométriques : une vraie vidéo contient de subtils signaux biologiques, dont de micro-mouvements de la tête liés au rythme cardiaque, la réaction de la pupille à la lumière et le rythme de la respiration. Ceux-ci sont absents ou incohérents dans la vidéo de synthèse.
- Profilage des artefacts de compression : la vidéo IA et la vidéo réelle présentent des empreintes statistiques différentes dans leurs formats compressés.
- Profilage du bruit temporel : les capteurs de caméras réelles produisent des motifs de bruit cohérents dans l’espace. Le bruit de génération de l’IA a une signature statistique différente.
Le problème est que les méthodes de détection sont toujours en retard d’un pas sur les outils de génération. À mesure que les modèles progressent en photoréalisme, ils progressent aussi, sans le vouloir, dans l’art de déjouer la détection automatisée.
Pourquoi les deepfakes posent un vrai problème
Au-delà du divertissement : les enjeux
La vidéo de synthèse a commencé comme un simple tour de passe-passe de soirée. Elle est devenue une arme politique, un instrument de fraude et un vecteur d’images intimes non consenties, qui ont causé des préjudices documentés à des milliers de personnes réelles. La capacité de générer une vidéo convaincante de n’importe qui disant ou faisant n’importe quoi a des implications claires et immédiates :
- Désinformation politique : des vidéos fabriquées de candidats ou de responsables faisant des déclarations qu’ils n’ont jamais faites
- Fraude financière : usurpation d’identité de PDG lors d’appels vidéo pour autoriser des virements bancaires (cela s’est déjà produit à grande échelle, avec des pertes documentées de plusieurs dizaines de millions)
- Atteinte à la réputation : du contenu intime synthétique visant des particuliers sans leur consentement
- Fabrication de preuves : des images apparemment vérifiées d’événements qui n’ont jamais eu lieu
L’accélération du réalisme aggrave chacune de ces menaces. Un deepfake flou de 2020 était facile à écarter. Une vidéo de synthèse en 1080p de 2025, avec un éclairage correct, un son synchronisé et des micro-expressions naturelles, ne l’est pas.
Des cas devenus viraux comme s’ils étaient réels
Plusieurs incidents très médiatisés ont démontré l’impact concret de ces technologies. Un clip audio-vidéo de synthèse représentant un responsable financier européen a servi à escroquer plusieurs entreprises dans un même stratagème, pour des dizaines de millions de dollars. Des deepfakes politiques ont circulé dans des contextes électoraux dans plusieurs pays pendant le cycle électoral de 2024, avec une influence documentée sur l’opinion publique dans les données de sondages.
Le schéma est constant : plus la vidéo de synthèse est réaliste, plus elle circule longtemps avant d’être signalée, et plus elle fait de dégâts pendant ce laps de temps.
💡 La diffusion virale précède le démenti. Lorsque les vérificateurs de faits repèrent un deepfake sophistiqué, celui-ci a déjà été vu des millions de fois.
Quels modèles fonctionnent le mieux
PicassoIA vous donne accès aux modèles de génération vidéo les plus performants disponibles actuellement, réunis en un seul endroit. Pour un rendu photoréaliste, les modèles suivants produisent les meilleurs résultats :
Pour les personnes et les visages réalistes :
- Veo 3.1 offre un rendu en 1080p avec une excellente cohérence du visage et une génération audio native
- Hailuo 02 produit une vidéo nette en 1080p avec un rendu de visage solide
- Kling v2.6 gère des scènes cinématographiques centrées sur des personnages avec un mouvement réaliste
Pour les plans larges et les environnements :
- Sora 2 gère les scènes complexes à plusieurs éléments avec une simulation physique solide
- Wan 2.7 T2V produit un rendu en 1080p avec une excellente cohérence de scène
- Pixverse v5 est rapide et fiable pour une vidéo réaliste polyvalente
Pour la 4K et les résolutions professionnelles :
- LTX 2 Pro produit de la 4K, seul modèle à cette résolution à prendre en charge un large éventail de contenus
Conseils pour un meilleur réalisme
Obtenir un résultat vraiment convaincant avec l’un de ces modèles demande plus que la rédaction d’un prompt. Les pratiques suivantes améliorent systématiquement le réalisme :
Soyez précis sur le comportement de la caméra. Des formulations comme « caméra à l’épaule avec une légère vibration », « faible profondeur de champ avec un objectif de 85 mm » ou « lent zoom pendant le dialogue » incitent le modèle à reproduire une vraie cinématographie, et pas seulement à générer une image.
Décrivez explicitement les sources de lumière. « Lumière de l’après-midi venant de la fenêtre de droite » donne au modèle un point d’ancrage physique. « Bien éclairé » ne lui donne rien. Plus votre description de l’éclairage est précise, plus les ombres resteront cohérentes tout au long de la séquence.
Gardez des séquences courtes et ciblées. Tous les modèles actuels perdent en cohérence sur les clips longs. Un clip de 5 secondes avec une personne dans un seul décor sera plus convaincant qu’un clip de 15 secondes avec plusieurs personnages et des changements de scène.
Utilisez des images de référence lorsque c’est possible. Les modèles qui acceptent une image en entrée pour générer une vidéo, comme Wan 2.7 I2V ou Kling v2.6 Motion Control, peuvent partir d’une image fixe photoréaliste et l’animer. Cela contourne entièrement de nombreuses difficultés liées à la génération de visages.
💡 Le chemin le plus simple vers une vidéo IA photoréaliste consiste à partir d’une image fixe photoréaliste. Générez d’abord votre image avec un modèle d’image, puis animez-la. Le résultat est presque toujours plus convaincant qu’une génération pure à partir de texte.
Commencez à créer quelque chose de réel
La frontière entre vidéo IA et vidéo réelle n’est plus fiable. Pour ceux qui créent du contenu, c’est une véritable opportunité créative. Pour ceux qui consomment du contenu, cela impose de développer de nouvelles habitudes quant à ce qu’on croit et pourquoi.
Les modèles disponibles aujourd’hui sont réellement capables de produire des séquences vidéo qui passent l’examen humain. Ce n’est pas un avertissement, c’est un constat sur le moment que nous vivons. Ce que vous en faites, que vous l’utilisiez pour raconter des histoires, créer du contenu ou simplement rester plus vigilant en tant que spectateur, vous appartient.
Tous les modèles mentionnés dans cet article sont disponibles sur PicassoIA. Vous pouvez essayer Veo 3.1, Kling v3, Sora 2 et des dizaines d’autres sans avoir à créer de compte sur plusieurs plateformes. Choisissez une scène, rédigez un prompt avec des détails précis sur la lumière et la caméra, et constatez par vous-même où se situe aujourd’hui la frontière.
Elle est plus proche du réel que vous ne le pensez.


