عندما تسحب صورة إلى تطبيق تحرير بالذكاء الاصطناعي وتراه يصحح الإضاءة ويوضّح الوجوه ويفصل الخلفية في لحظة، قد يبدو الأمر سحرًا. لكنه ليس كذلك. ما يحدث عملية حسابية دقيقة ومتعددة الطبقات تمر عبر صورتك بطرق لا يفكر فيها معظم الناس.
أدوات التحرير بالذكاء الاصطناعي لا ترى الصور كما تراها أنت. إنها ترى البيانات: شبكات من الأرقام، وتوزيعات احتمالية، وعلاقات مكانية، ومطابقات للأنماط مستخلصة من ملايين الصور التدريبية. وعندما تفهم ما يجري فعلًا خلف الكواليس، ستستفيد أكثر من كل أداة تستخدمها.
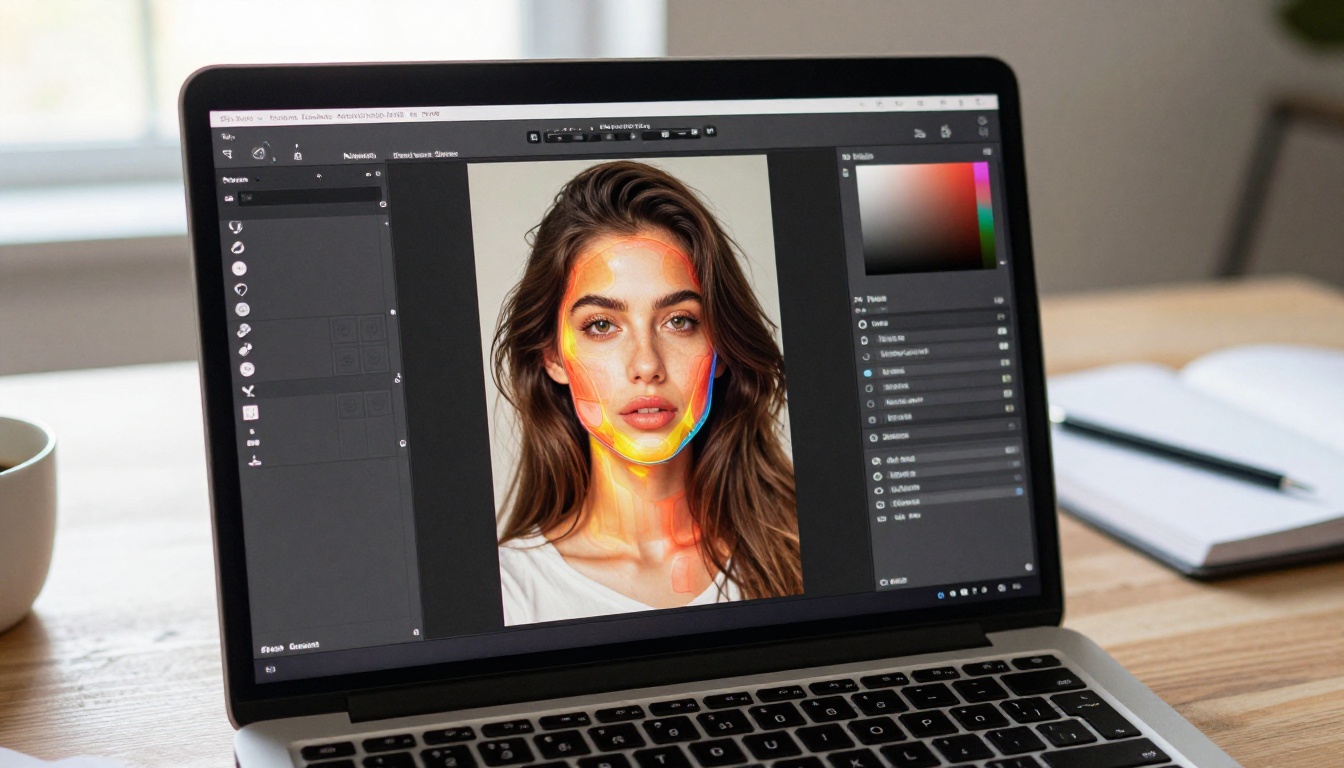
ما تلتقطه كاميرتك مقابل ما يراه الذكاء الاصطناعي
الصورة ليست صورةً بالنسبة إلى الذكاء الاصطناعي. إنها مصفوفة.
تُخزَّن كل صورة على شكل شبكة من البكسلات، ويحمل كل بكسل قيمًا عددية للقنوات الحمراء والخضراء والزرقاء. تحتوي صورة قياسية بدقة 24 ميغابكسل على 24 مليون بكسل، وعند عمق لون 8 بت فهذا يعني ثلاثة أرقام بين 0 و255 لكل بكسل. أي 72 مليون قيمة فردية قبل أن تبدأ أي معالجة. أما ملفات RAW فتذهب أعمق، إذ يبلغ عمق البت غالبًا 14 بت، أي أن كل قناة يمكن أن تخزّن حتى 16,384 قيمة مميزة بدلًا من 256.
البكسلات الخام ليست سوى أرقام
لا يقرأ الذكاء الاصطناعي هذه المصفوفة بمعزل عن غيرها، بل يقرؤها خريطةً مكانية. فالبكسلات المجاورة تحمل سياقًا: البكسل الساطع المحاط ببكسلات داكنة يدل غالبًا على حافة. وتجمّع من البكسلات ذات الدرجات المتقاربة يمثل سطحًا أو جسمًا. أما المنطقة التي تتغير قيمها بسرعة فتدل على الملمس أو التفاصيل. وهذه القراءة المكانية هي ما يتيح لأدوات الذكاء الاصطناعي اكتشاف أين ينتهي الشخص وتبدأ الخلفية، دون أن ترسم أنت أي تحديد يدوي.
تنزلق الهندسات الحديثة للذكاء الاصطناعي، وبخاصة الشبكات العصبونية التلافيفية (CNNs)، بنوافذ مرشحات صغيرة عبر شبكة البكسلات، وتكشف الأنماط على مقاييس متزايدة. تبدأ من تفاصيل الحواف الدقيقة على مستوى البكسل، وصولًا إلى الملامح البنيوية الكبيرة مثل الوجوه أو خطوط الأفق على مستوى الصورة كاملة. تبني كل طبقة من المرشحات على ما قبلها، فتحوّل الأرقام الخام تدريجيًا إلى تمثيلات أكثر تجريدًا لما تحتويه الصورة فعلًا.
البيانات الوصفية تروي القصة الخفية
قبل معالجة أي بكسل، تقرأ معظم أدوات الذكاء الاصطناعي بيانات EXIF الوصفية للملف. تشمل هذه البيانات المضمّنة طراز الكاميرا، والبعد البؤري، وفتحة العدسة، وحساسية ISO، وسرعة الغالق، وغالبًا إحداثيات GPS. فالصورة الملتقطة عند ISO 6400 تُعلَّم لتطبيق خفض قوي للضوضاء قبل بدء أي معالجة بصرية. والصورة الشخصية المسجلة بالبعد البؤري 85 ملم تُشغّل منطق اكتشاف الوجوه. والصورة المؤرخة عند شروق الشمس تُقيَّم بوصفها ذات إضاءة دافئة واتجاهية.
تعمل هذه البيانات الوصفية كموجز مسبق للمعالجة يشكّل مسار المعالجة بأكمله، ما يجعل قرارات الذكاء الاصطناعي أدق بكثير منذ الخطوة الأولى.
كيف يغيّر رسم العمق كل شيء
من أقوى ما تفعله أداة الذكاء الاصطناعي بصورتك أنها تُنشئ خريطة عمق: تمثيل بتدرج الرمادي لمدى بُعد كل منطقة في الصورة عن عدسة الكاميرا. تدل المناطق الأفتح في الخريطة على أجسام قريبة من الكاميرا، والمناطق الأغمق على أجسام بعيدة.
استنتاج العمق من صورة مسطحة
الجزء الصعب هنا أن معظم الصور مسطحة. لا توجد كاميرا ستيريو، ولا مستشعر LiDAR، ولا بيانات زمن الطيران مرفقة بها. تستنتج أدوات الذكاء الاصطناعي العمق من صورة ثنائية الأبعاد واحدة باستخدام الإشارات البصرية نفسها التي يعالجها الدماغ البشري تلقائيًا: علاقات الحجم (فالأجسام الأصغر تميل إلى أن تكون أبعد)، وضباب الغلاف الجوي، وتلاشي حدة الحواف، وتدرجات كثافة الملمس، والحجب (عندما يحجب جسم آخر، فالجسم المحجوب يكون خلفه).
تتعلم الشبكات العصبونية التلافيفية المدرَّبة على مجموعات كبيرة من الصور المقترنة ببيانات عمق معروفة، مثل إطارات من بيئات ثلاثية الأبعاد أو صور التُقطت بمستشعرات عمق مخصصة، توقّع هذه العلاقات المكانية بدقة لافتة. والناتج تقدير للعمق لكل بكسل تستخدمه الأداة في اتخاذ كل قرارات التحرير المكاني.
ما الذي تتيحه بيانات العمق
مع خريطة عمق موثوقة، يمكن لأدوات الذكاء الاصطناعي أن:
- تفصل المقدمة عن الخلفية دون تقنيع يدوي أو مسارات تحديد
- تطبّق تأثيرات التركيز الانتقائي التي تحاكي عمق المجال الضحل لعدسة ثابتة سريعة
- تضبط الإضاءة بشكل مستقل عبر مستويات العمق، فتُسطع الشخص مع إبقاء الخلفية أخفت
- تستبدل الخلفيات أو تُموّهها مع الحفاظ على سلامة حواف الشخص في الشعر والأقمشة الناعمة
- تطبّق التظليل بالتفريغ (Vignetting) على أبعد المناطق في الإطار فقط
ولهذا تستطيع أدوات الصور الشخصية بالذكاء الاصطناعي إنتاج فصل للخلفية كان سيستغرق من محرر ماهر 20 أو 30 دقيقة لإنجازه يدويًا.
التعرف على الأجسام والتجزئة الدلالية
معرفة أن هناك شخصًا في صورتك هي الخطوة الأولى. أما معرفة أن هذا الشخص له وجه وعينان وشعر وملابس، وأنه يقف أمام نوع محدد من الخلفيات، فهي مشكلة مختلفة تمامًا، ويحلّها الذكاء الاصطناعي اليوم بشكل روتيني.
التجزئة الدلالية في العمل
تُسند التجزئة الدلالية تسمية فئة إلى كل بكسل في الصورة. قد تصنّف صورة شخصية مجزّأة بالكامل البكسلات على أنها: جلد، وشعر، وعيون، وشفاه، وأسنان، ونسيج ملابس، وخلفية سماء، وخلفية أوراق شجر، وأرضية أمامية، وإكسسوارات.
وهذا مهم لأن لكل فئة معاملة مختلفة. يجب أن ينال الجلد تنعيمًا دون تحديد للحواف. ويُحدّد الشعر بخصلاته الفردية لكن لا يُصحَّح لونه كالجلد. ويمكن تحويل درجة لون سماء الخلفية إلى أزرق أغنى دون التأثير في الشخص إطلاقًا. ومن دون التجزئة، سيكون كل تعديل عمليةً فجّة تطال الإطار كله.
تُدرَّب نماذج على مجموعات بيانات مثل COCO (Common Objects in Context) وADE20K، وتستطيع تجزئة أكثر من 150 فئة مختلفة من الأجسام على مستوى البكسل، وتذهب النماذج المخصصة للصور الشخصية إلى أبعد من ذلك بفئات فرعية مفصّلة لتشريح الوجه.
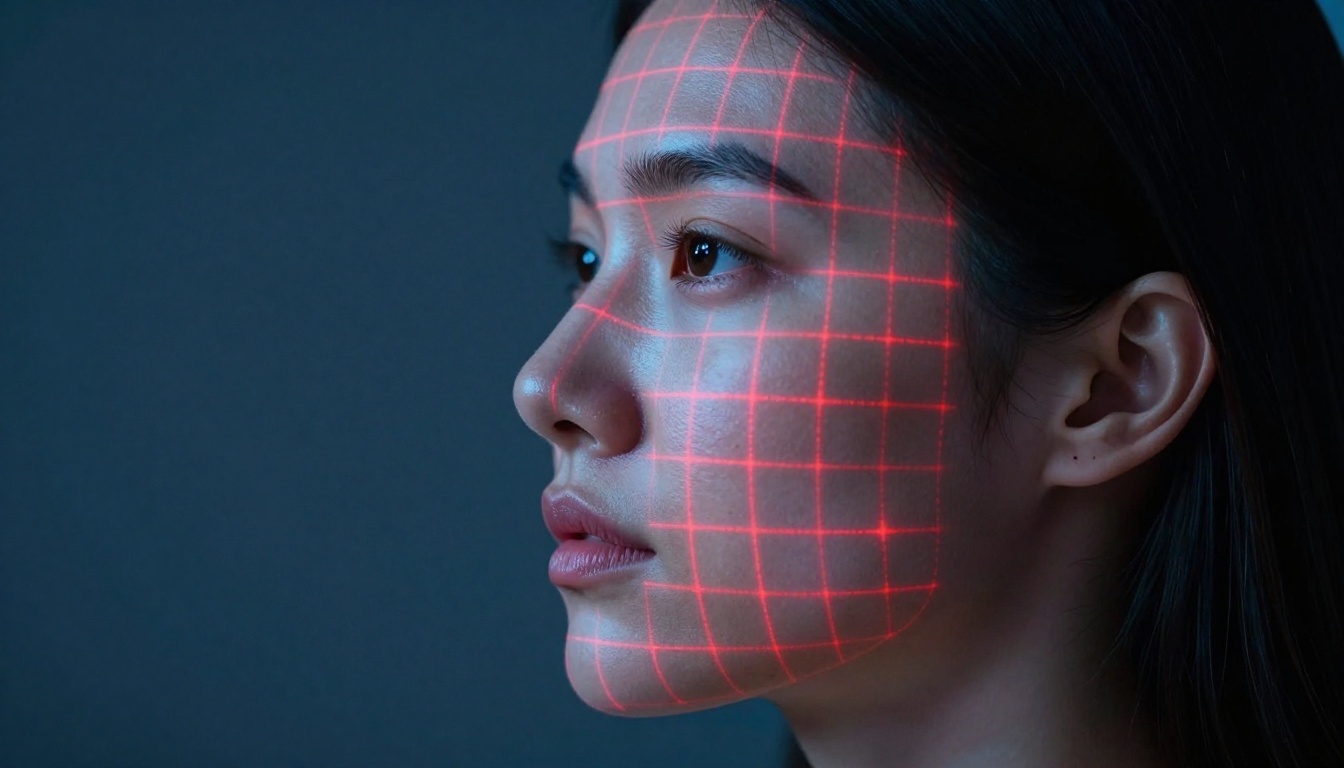
نقاط ملامح الوجه: خريطة الـ68 نقطة
في تحرير الصور الشخصية تحديدًا، تكتشف نماذج الذكاء الاصطناعي حتى 68 نقطة ملامح للوجه: نقاط إحداثية موضوعة بدقة تحدد زوايا كل عين، وحواف الحاجبين، وكفاف كل شفة، وطرف الأنف وجسره، وتقوّس خط الفك كاملًا.
تتيح خرائط النقاط هذه:
- ترميم انتقائي للبشرة يتوقف بدقة عند حدود الحاجب وتجويف العين
- تبييض الأسنان يبقى داخل كفاف الشفة دون التأثير في لون الشفاه
- تعديلات لشكل الوجه تحافظ على هندسة طبيعية وتوازن متناسب
- تحريك الصور الشخصية في أدوات مزامنة الشفاه وتبديل الوجوه، حيث يجب أن تنطبق هندسة الوجه المصدر على الهدف بدقة
💡 تستخدم أدوات تبديل الوجوه على PicassoIA خرائط نقاط ملامح الوجه نفسها لمحاذاة الوجوه ومزجها بدقة هندسية عالية. ويبدو الناتج مقنعًا لأن المحاذاة المكانية كانت صحيحة من البداية.
علم الألوان: أعمق مما يبدو للعين
اللون في التصوير ليس مجرد قيم مخزّنة في قنوات كل بكسل. إنه سياق، وتوازن إدراكي، وخصائص فيزيائية لمصدر الضوء الذي أنتج الصورة أصلًا.
كيف يقرأ الذكاء الاصطناعي حرارة اللون
تحدد أدوات الذكاء الاصطناعي خصائص مصدر الضوء بالبحث عن الصبغات اللونية على أسطح محايدة بصريًا في الإطار: جدران بيضاء، وملابس رمادية، وأسقف فاتحة. فالسطح الرمادي الذي يحمل صبغة زرقاء خفيفة يدل على ضوء طبيعي بارد وملبّد بالغيوم، في حدود 6500 إلى 7500 كلفن. أما السطح نفسه بصبغة كهرمانية دافئة فيوحي بضوء التنغستن أو ضوء ما بعد الظهر المتأخر، في حدود 2700 إلى 3500 كلفن.
تعمل عملية التصحيح بتحويل الصورة من RGB إلى فضاء لوني إدراكي مثل CIE LAB، حيث تتولى قناة واحدة الإضاءة بشكل مستقل عن قناتين للكروما. وتغيير توازن الأبيض في LAB يعني تغيير اللون دون المساس بالسطوع المُدرَك، وهذا ما يجعل تصحيح توازن الأبيض بالذكاء الاصطناعي يبدو طبيعيًا لا باهتًا أو مصبوغًا.
| مصدر الضوء | حرارة اللون | الصبغة الشائعة |
|---|
| سماء ملبّدة بالغيوم | 6500-7500 كلفن | أزرق بارد |
| ضوء الشمس المباشر | 5000-5500 كلفن | محايد |
| الساعة الذهبية | 2500-3500 كلفن | برتقالي دافئ |
| تنغستن داخلي | 2700-3200 كلفن | كهرماني/أصفر |
| الفلورسنت | 4000-4500 كلفن | يميل إلى الأخضر |
تعديل النغمات تلقائيًا
تصحيح التعريض ليس مجرد ضرب قيم البكسلات في ثابت. تتصرف الإبرازات والظلال في الصورة الفوتوغرافية بشكل مختلف، والأدوات الجيدة بالذكاء الاصطناعي تعالجها كقنوات منفصلة بمنطق مختلف.
يقيّم الذكاء الاصطناعي مخطط الهستوغرام للصورة: فيحدد الإبرازات المقصوصة حيث تضيع التفاصيل عند القيم القصوى، والظلال المسحوقة حيث تختفي التفاصيل في السواد التام، وتوزيع أنصاف النغمات عبر بقية المدى. ثم يطبّق تعديلات منحنيات بارامترية تستعيد تفاصيل الإبرازات القريبة من القص، مع ترك أنصاف النغمات المعرّضة بشكل جيد دون مساس. والنتيجة تبدو غالبًا كتعديل يدوي ماهر، لا كرفع فج للسطوع.
إزالة الضوضاء: النمط مقابل العشوائية
الضوضاء الرقمية تباين عشوائي في قيم البكسلات ينتج عن حرارة المستشعر والتداخل الكهربائي، وخاصة عند إعدادات ISO العالية. بالنسبة إلى العين تبدو كحبيبات الفيلم. أما بالنسبة إلى الذكاء الاصطناعي فهي تباين ذو تردد عالٍ لا يتبع الأنماط الإحصائية للملمس السطحي الحقيقي.
كيف يميّز الذكاء الاصطناعي الملمس عن الضوضاء
للجلد البشري ملمس طبيعي: مسام مرئية، وخطوط دقيقة، وتباينات مجهرية في السطح تتبع أنماطًا اتجاهية متسقة ومترابطة مكانيًا. والضوضاء الرقمية تحاكي ذلك بصريًا، ولهذا محت خوارزميات إزالة الضوضاء القديمة تفاصيل الجلد مع الحبيبات التي كانت تستهدفها.
تستطيع أدوات الذكاء الاصطناعي المدرَّبة خصيصًا على التمييز بين الملمس الحقيقي وضوضاء المستشعر أن تفصل بينهما على مستوى مجهري. تُحفظ الأنماط الاتجاهية المترابطة مكانيًا، مثل نسيج القماش وألياف الخشب وخصلات الشعر. أما التباين العشوائي غير المترابط مكانيًا فيُنعَّم ويزول. والنتيجة تبدو كملمس حقيقي لا كتأثير "البشرة البلاستيكية" الناتج عن المعالجة المفرطة في أدوات إزالة الضوضاء التقليدية العدوانية.
معايرة العتبة
خلل إزالة الضوضاء بالذكاء الاصطناعي الشائع هو التنعيم المفرط. فعندما تُضبط عتبات الثقة مرتفعة جدًا، يزيل النموذج تفاصيل دقيقة ما كان ينبغي أن يمسّها. وتعرض أفضل الأدوات ذلك كمعامل قابل للضبط، فتتيح لك موازنة إزالة الضوضاء مع الحفاظ على الملمس بحسب احتياجات الصورة المحددة ودقة الإخراج.
الدقة الفائقة: التنبؤ ببكسلات لم تكن موجودة
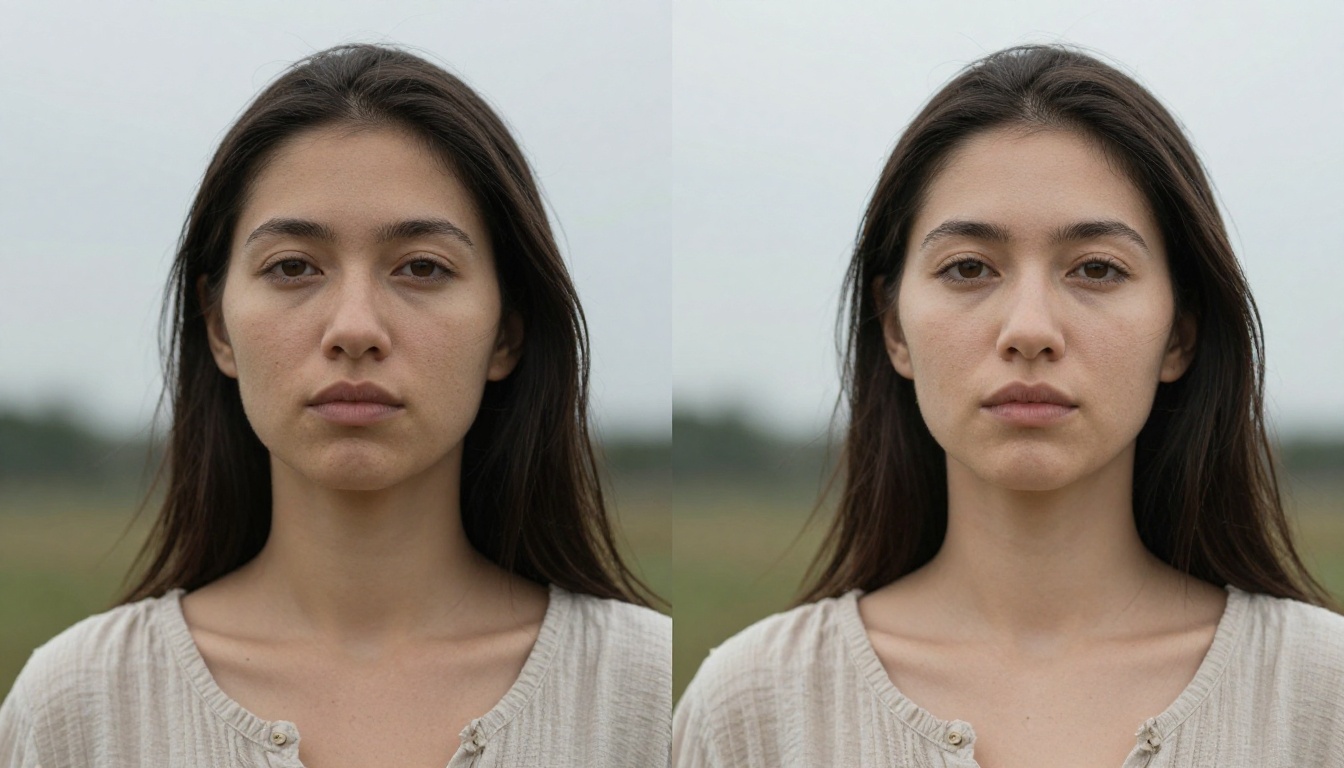
عندما ترفع أداة الذكاء الاصطناعي دقة صورتك، فإنها لا تمدّ البكسلات الموجودة أو تستكملها. بل تتنبأ ببكسلات جديدة استنادًا إلى أنماط تعلّمتها من ملايين أزواج الصور المتطابقة.
ما الذي تفعله نماذج رفع الدقة فعلًا
تُدرَّب أدوات مثل Real ESRGAN وClarity Pro Upscaler على أزواج متطابقة من الصور منخفضة الدقة وعالية الدقة. يطوّر النموذج علاقات إحصائية بين شكل الصورة الصغيرة المتدهورة وما يجب أن تحتويه النسخة المفصّلة بالكامل من المشهد نفسه.
عندما ترفع دقة صورة شخصية، يستعين الذكاء الاصطناعي بأنماط من ملايين أمثلة الصور الشخصية ليتنبأ بما يجب أن يبدو عليه ملمس الجلد والشعر والقماش عند دقة تعادل ضعف أو أربعة أضعاف الدقة الأصلية. بالنسبة إلى الجلد، يعني ذلك إضافة بنية مسام معقولة وظلال مجهرية. وبالنسبة إلى الشعر، يعني ذلك تصيير فصل الخصلات الفردية. وبالنسبة إلى القماش، يعني ذلك إعادة بناء تردد النسيج بدقة أعلى.
💡 وبالنسبة إلى الصور الشخصية تحديدًا، تطبّق Crystal Upscaler معالجة مدركة للوجوه تضيف تفاصيل دقيقة للجلد والشعر بشكل انتقائي، مع الحفاظ على تماسك ملمس الخلفية مكانيًا وخلوّه من القطع والعيوب الناتجة عن الهلوسة.
اختيار أداة رفع الدقة المناسبة
تختلف أدوات رفع الدقة في تركيزها على التدريب وخصائص الإخراج:
إزالة الخلفية: حيث تصبح الحواف صعبة
يبدو إزالة الخلفية من أبسط مهام الذكاء الاصطناعي. لكنه ليس كذلك. الجزء الصعب دائمًا هو الحواف: شعر متطاير على سماء ساطعة، وقماش شفاف جزئيًا قرب حافة الإطار، وأذرع ضبابية الحركة عند حد الشخص.
عملية الفصل من مرحلتين
تجمع أدوات إزالة الخلفية بين تقدير خريطة العمق والتجزئة الدلالية لتحديد حدود الشخص بدقة. وبمجرد تحديد منطقة الحد، تحسب خوارزمية التقنيع لكل بكسل قريب من ذلك الحد احتمال انتمائه إلى المقدمة أو الخلفية.
والناتج هو قناع ألفا: قناع بتدرج الرمادي حيث البكسلات البيضاء مقدمة كاملة، والبكسلات السوداء خلفية كاملة، والبكسلات الرمادية شفافة جزئيًا. وهذا التدرج هو ما يحفظ المظهر الرقيق للشعر المتطاير والحافة الناعمة لطرف القماش، بدلًا من إنتاج القصاصات الحادة المقطوعة بقالب كعك التي تنتجها أدوات التحديد القديمة.
عندما يفشل الفصل
أكثر حالات الفشل شيوعًا: شعر داكن أمام خلفية داكنة أو منخفضة التباين. فعندما يكون تباين العمق وتباين اللون منخفضين معًا، يجد النموذج صعوبة في تحديد الحد بشكل صحيح. ويمنح تصوير الأشخاص أمام خلفيات ذات تباين واضح في الدرجات، سواء أفتح أم أغمق من الشخص، الذكاء الاصطناعي إشارات أكثر يستند إليها، وينتج أقنعة أنظف بشكل ملحوظ.
استعادة الصور التالفة والقديمة
هنا تظهر ميزة بيانات التدريب التي يملكها الذكاء الاصطناعي بوضوح أكبر. فترميم صورة تالفة بشدة يدويًا يتطلب محررًا ماهرًا وساعات من العمل الدقيق. أما الذكاء الاصطناعي المدرَّب على آلاف أزواج الترميم فيمكنه إنتاج نتيجة مقنعة في ثوانٍ.
التعبئة: ملء ما هو مفقود
عندما تعاني الصورة من تلف مادي، أو خدوش، أو بقع ماء، أو مناطق مفقودة، يستخدم الذكاء الاصطناعي التعبئة (inpainting): يقرأ البكسلات المحيطة بحثًا عن أدلة السياق (الألوان القريبة، والملمس، والحواف البنيوية، وحدود الأجسام) ويتنبأ بما يجب أن تحتويه المنطقة المفقودة.
بالنسبة إلى الوجوه، تعمل التعبئة بشكل جيد بصفة خاصة لأن النموذج رأى ملايين صور الوجوه، ويستطيع إعادة بناء جزء مفقود من الخد، أو عين مخفية جزئيًا، أو جزء تالف من خط الشعر من السياق المرئي المحيط. أما الخلفيات المعقدة ذات الأنماط غير المنتظمة أو الفريدة، فتختلف النتائج فيها بحسب مقدار السياق المتسق المحيط بالمنطقة التالفة.
تلوين الصور الفوتوغرافية بالأبيض والأسود
التلوين مهمة نموذج منفصلة. تُدرَّب هذه النماذج على نسخ ملوّنة ورمادية مقترنة للصور نفسها، لتتعلم التنبؤ باللون من بيانات الإضاءة مع التصنيف الدلالي للأجسام. وتقرأ أفضل أدوات التلوين كلًا من الملمس وفئة الجسم، فلا تطلي كل الأسطح الخشبية بالدرجة البنية الواحدة نفسها، ولا تطلي كل البشرة بالنغمة المسطحة نفسها. إنها تنتج لونًا متمايزًا وسياقيًا يبدو طبيعيًا لا مصبوغًا بشكل مصطنع.
خط المعالجة الكامل في العمل
سبب شعور أدوات الصور الحديثة بالذكاء الاصطناعي بالقوة أنها لا تشغّل خوارزمية واحدة. بل تشغّل مسار معالجة متكاملًا تُغذّي فيه كل خطوة الخطوة التالية.
قد تمر صورة واحدة عبر:
- قراءة البيانات الوصفية لتحديد سياق الكاميرا وضبط معاملات المعالجة الأولية
- تقييم الضوضاء لتحديد قوة إزالة الضوضاء قبل بدء أي عمل مكاني
- تقدير العمق لبناء الخريطة المكانية لكل بكسل في المشهد
- التجزئة الدلالية لإسناد تسميات الفئات إلى كل بكسل في الإطار
- اكتشاف نقاط ملامح الوجه لتحديد مناطق التحرير الدقيقة على أي وجوه موجودة
- تحويل فضاء الألوان للمعالجة الدقيقة للنغمات والألوان
- النمذجة الخاصة بالمهمة لرفع الدقة، أو التعبئة، أو إزالة الخلفية، أو الترميم
تُشكّل كل خطوة الخطوة التالية. تُحدد خريطة العمق أين ينبغي أن تقع حدود التجزئة. وتُخبر التجزئة نموذج الضوضاء بالمناطق التي هي جلد (فيُحفظ الملمس) مقابل الجدران المسطحة (فتُزال الضوضاء بقوة). وتحدد نقاط ملامح الوجه بدقة أين يُطبَّق تنعيم البشرة وأين يتوقف.
هذا الخط هو ما يجعل تحرير الصور بالذكاء الاصطناعي يبدو مدركًا للسياق لا آليًا، وهو السبب في أن النتائج تصمد عندما تكبّر الوجه إلى 100 في المئة.
الآن، شغّل خط المعالجة
كل ما ورد في هذا المقال، من رسم العمق إلى الدقة الفائقة إلى فصل الخلفية والتعبئة، يعمل على PicassoIA الآن. يمكنك رفع دقة صورة شخصية إلى 6 أضعاف دقتها الأصلية باستخدام Topaz Labs Image Upscale، أو إزالة خلفية معقدة مع تقنيع دقيق باستخدام Bria Background Removal، أو استعادة التفاصيل الدقيقة في صورة متدهورة باستخدام Clarity Pro Upscaler، أو دفع الدقة أبعد باستخدام Recraft Crisp Upscale.
التقنية الموصوفة في هذا المقال ليست نظرية. اختر صورة، واختر أداة، وشاهد خط المعالجة يعمل في الوقت الفعلي. وحين ترى ما يفعله، ستعرف بالضبط كيف تزوّده بصور تنتج أفضل نتيجة ممكنة.


