जब आप किसी फ़ोटो को AI एडिटिंग ऐप में खींचकर लाते हैं और वह तुरंत लाइटिंग ठीक कर देती है, चेहरों को शार्प कर देती है और बैकग्राउंड अलग कर देती है, तो यह जादू जैसा लग सकता है। पर यह जादू नहीं है। इसके पीछे एक सटीक, कई परतों वाली कम्प्यूटेशनल प्रक्रिया चलती है, जो आपकी इमेज को ऐसे तरीकों से परखती है जिनके बारे में ज़्यादातर लोग कभी नहीं सोचते।
AI एडिटिंग टूल फ़ोटो को वैसे नहीं देखते जैसे आप देखते हैं। वे डेटा देखते हैं: संख्याओं के ग्रिड, प्रायिकता वितरण, स्थानिक संबंध और लाखों ट्रेनिंग इमेज से मिले पैटर्न मैच। एक बार आप समझ लेंगे कि अंदर असल में क्या हो रहा है, तो आप हर टूल से और ज़्यादा फ़ायदा उठा पाएँगे।
आपका कैमरा क्या कैप्चर करता है बनाम AI क्या देखता है
AI के लिए आपकी फ़ोटो एक तस्वीर नहीं है। यह एक मैट्रिक्स है।
हर इमेज पिक्सेल के ग्रिड के रूप में स्टोर होती है, और हर पिक्सेल में लाल, हरे और नीले चैनल के संख्यात्मक मान होते हैं। एक स्टैंडर्ड 24-मेगापिक्सेल फ़ोटो में 24 मिलियन पिक्सेल होते हैं, और 8-बिट कलर डेप्थ पर हर पिक्सेल के लिए 0 से 255 के बीच तीन संख्याएँ। यानी प्रोसेसिंग शुरू होने से पहले ही 72 मिलियन अलग-अलग मान होते हैं। RAW फ़ाइलें और गहराई में जाती हैं, अक्सर 14-बिट, यानी हर चैनल 256 के बजाय 16,384 तक अलग-अलग मान स्टोर कर सकता है।
रॉ पिक्सेल सिर्फ़ संख्याएँ हैं
AI इस मैट्रिक्स को अलग-थलग नहीं, बल्कि एक स्थानिक मैप की तरह पढ़ता है। आस-पास के पिक्सेल संदर्भ देते हैं: अंधेरे पिक्सेल से घिरा एक चमकीला पिक्सेल संभवतः किनारे का संकेत है। मिलते-जुलते टोन वाले पिक्सेल का समूह किसी सतह या वस्तु को दर्शाता है। जहाँ मान तेज़ी से बदलते हैं, वहाँ टेक्सचर या डिटेल का संकेत होता है। इसी स्थानिक पढ़ाई से AI टूल बिना आपके कोई मैन्युअल सिलेक्शन बनाए पता लगा लेते हैं कि सब्जेक्ट कहाँ खत्म होता है और बैकग्राउंड कहाँ शुरू होता है।
आधुनिक AI आर्किटेक्चर, खासकर कन्वोल्यूशनल न्यूरल नेटवर्क (CNNs), इस पिक्सेल ग्रिड पर छोटी फ़िल्टर विंडो घुमाते हैं और बढ़ते पैमानों पर पैटर्न पहचानते हैं। पिक्सेल स्तर के बारीक किनारों से लेकर पूरी इमेज स्तर पर चेहरों या क्षितिज रेखाओं जैसी बड़ी संरचनाओं तक, हर फ़िल्टर परत पिछली परत पर आधारित होती है, और कच्चे नंबरों को इमेज में मौजूद चीज़ों के धीरे-धीरे ज़्यादा अमूर्त प्रतिनिधित्व में बदलती है।
मेटाडेटा छिपी कहानी बताता है
एक भी पिक्सेल प्रोसेस करने से पहले, ज़्यादातर AI टूल फ़ाइल का EXIF मेटाडेटा पढ़ते हैं। इस एम्बेडेड डेटा में कैमरा मॉडल, फ़ोकल लेंथ, अपर्चर, ISO संवेदनशीलता, शटर स्पीड और अक्सर GPS कोऑर्डिनेट शामिल होते हैं। ISO 6400 पर ली गई शॉट को विज़ुअल प्रोसेसिंग शुरू होने से पहले ही आक्रामक नॉइज़ रिडक्शन के लिए चिह्नित कर दिया जाता है। 85mm फ़ोकल लेंथ वाली पोर्ट्रेट फ़ोटो चेहरा-पहचान लॉजिक चालू कर देती है। सूर्योदय के समय की टाइमस्टैम्प वाली फ़ोटो को गर्म, दिशात्मक लाइटिंग स्थितियों के लिए जाँचा जाता है।
यह मेटाडेटा एक प्री-प्रोसेसिंग ब्रीफ़ की तरह काम करता है, जो पूरी आगे की पाइपलाइन को आकार देता है और पहले ही कदम से AI के फ़ैसलों को कहीं ज़्यादा सटीक बनाता है।
डेप्थ मैपिंग सब कुछ कैसे बदल देती है
AI टूल आपकी फ़ोटो के साथ जो सबसे शक्तिशाली काम करता है, वह है डेप्थ मैप बनाना: यह ग्रेस्केल प्रतिनिधित्व है कि इमेज का हर हिस्सा कैमरा लेंस से कितनी दूर है। मैप में चमकीले क्षेत्र कैमरे के नज़दीक की वस्तुओं को दर्शाते हैं; गहरे क्षेत्र दूर की वस्तुओं को।
सपाट इमेज से गहराई का अनुमान
मुश्किल हिस्सा यह है: ज़्यादातर फ़ोटो सपाट होती हैं। वहाँ कोई स्टीरियो कैमरा, कोई LiDAR सेंसर, कोई टाइम-ऑफ़-फ़्लाइट डेटा नहीं जुड़ा होता। AI टूल एक 2D इमेज से गहराई का अनुमान उन्हीं विज़ुअल संकेतों से लगाते हैं जिन्हें मानव मस्तिष्क अपने-आप प्रोसेस करता है: आकार के संबंध (छोटी वस्तुएँ आम तौर पर दूर होती हैं), वायुमंडलीय धुंध, किनारों की तीक्ष्णता में गिरावट, टेक्सचर घनत्व की ढाल और ओक्लूज़न (जब एक वस्तु दूसरी को ढकती है, तो ढकी हुई वस्तु पीछे होती है)।
बड़े डेटासेट पर ट्रेन किए गए CNNs, जिनमें इमेज को ज्ञात डेप्थ डेटा के साथ जोड़ा गया होता है, जैसे 3D वातावरण के फ़्रेम या समर्पित डेप्थ सेंसर से ली गई फ़ोटो, इन स्थानिक संबंधों का अनुमान बेहद सटीकता से लगाना सीख लेते हैं। नतीजा एक पिक्सेल-दर-पिक्सेल डेप्थ अनुमान होता है, जिसे टूल अपने सभी स्थानिक एडिटिंग फ़ैसलों के लिए इस्तेमाल करता है।
डेप्थ डेटा क्या संभव बनाता है
एक भरोसेमंद डेप्थ मैप के साथ AI टूल यह कर सकते हैं:
- मैन्युअल मास्किंग या सिलेक्शन पाथ के बिना फ़ोरग्राउंड और बैकग्राउंड अलग करना
- तेज़ प्राइम लेंस की शैलो डेप्थ-ऑफ़-फ़ील्ड की नकल करने वाले सेलेक्टिव फ़ोकस इफ़ेक्ट लगाना
- डेप्थ प्लेन में लाइटिंग अलग-अलग एडजस्ट करना, जिससे सब्जेक्ट चमके और बैकग्राउंड धुंधला रहे
- बाल और मुलायम कपड़े पर सब्जेक्ट के किनारों की अखंडता बनाए रखते हुए बैकग्राउंड बदलना या ब्लर करना
- फ़्रेम के सबसे दूर के हिस्सों पर ही विग्नेटिंग लगाना
इसीलिए AI पोर्ट्रेट टूल ऐसे बैकग्राउंड सेपरेशन बना सकते हैं जिन्हें किसी कुशल रीटचर को हाथ से बनाने में 20 से 30 मिनट लगते।
ऑब्जेक्ट रिकग्निशन और सिमेंटिक सेगमेंटेशन
यह पहचानना कि आपकी फ़ोटो में कोई व्यक्ति है, पहला कदम है। यह जानना कि उस व्यक्ति का चेहरा, दो आँखें, बाल और कपड़े हैं और वह किसी खास तरह के बैकग्राउंड के सामने खड़ा है, बिल्कुल अलग समस्या है, और AI टूल अब इसे नियमित रूप से हल कर लेते हैं।
सिमेंटिक सेगमेंटेशन काम में
सिमेंटिक सेगमेंटेशन इमेज के हर एक पिक्सेल को एक श्रेणी लेबल देता है। पूरी तरह सेगमेंट की गई पोर्ट्रेट में पिक्सेल को त्वचा, बाल, आँखें, होंठ, दाँत, कपड़े का फ़ैब्रिक, बैकग्राउंड का आसमान, बैकग्राउंड की पत्तियाँ, फ़ोरग्राउंड की ज़मीन और एक्सेसरीज़ में बाँटा जा सकता है।
यह इसलिए मायने रखता है क्योंकि हर श्रेणी को अलग तरह के ट्रीटमेंट की ज़रूरत होती है। त्वचा को स्मूदिंग मिलनी चाहिए, एज शार्पनिंग नहीं। बाल को अलग-अलग स्ट्रैंड पर शार्प किया जाना चाहिए, पर त्वचा जैसा कलर करेक्शन नहीं। बैकग्राउंड के आसमान का ह्यू बिना सब्जेक्ट को छुए ज़्यादा समृद्ध नीले रंग में बदला जा सकता है। सेगमेंटेशन के बिना हर एडजस्टमेंट पूरे फ़्रेम पर एक मोटा, सामान्य ऑपरेशन होता।
COCO (Common Objects in Context) और ADE20K जैसे डेटासेट पर ट्रेन किए गए मॉडल पिक्सेल स्तर पर 150 से ज़्यादा अलग-अलग ऑब्जेक्ट श्रेणियाँ सेगमेंट कर सकते हैं, और पोर्ट्रेट-विशिष्ट मॉडल चेहरे की शारीरिक रचना की विस्तृत उप-श्रेणियों में और गहराई तक जाते हैं।
फ़ेशियल लैंडमार्क: 68-पॉइंट मैप
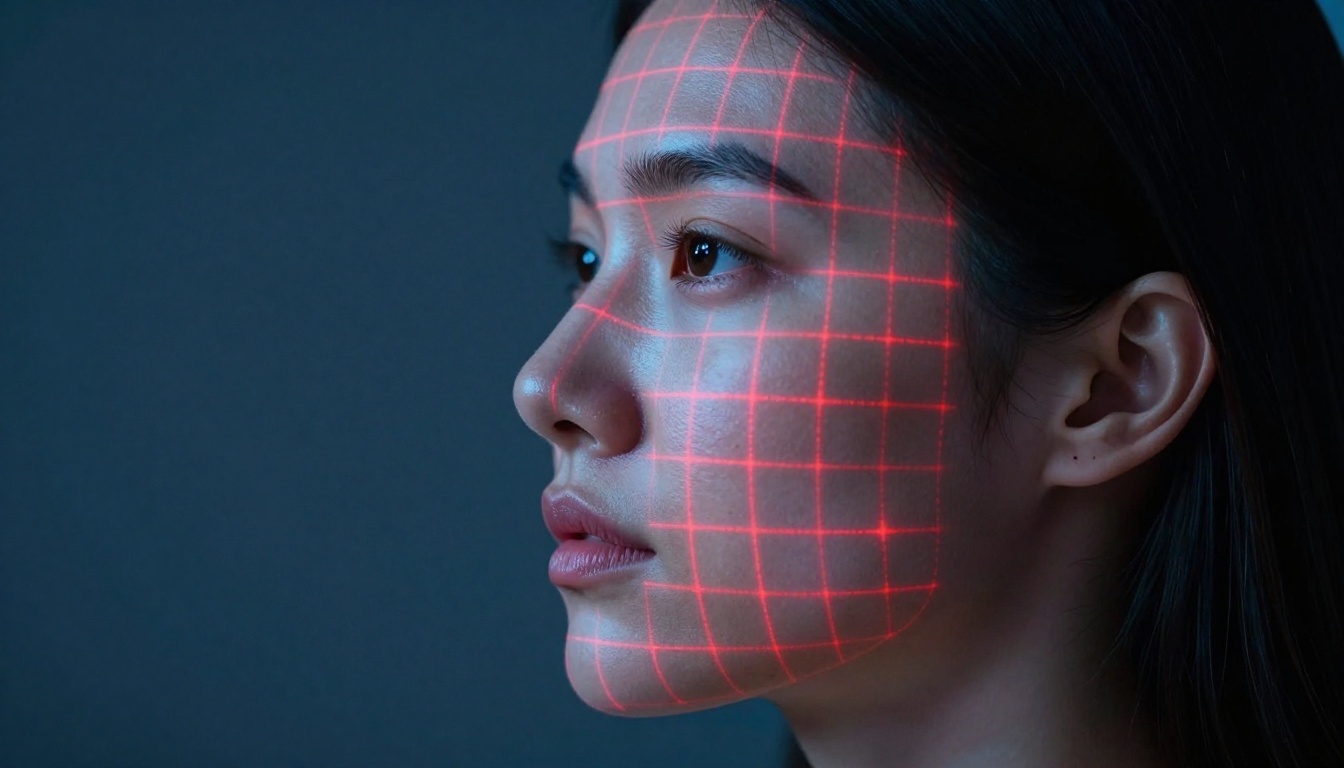
खास तौर पर पोर्ट्रेट एडिटिंग के लिए, AI मॉडल 68 फ़ेशियल लैंडमार्क तक पहचानते हैं: सटीक रूप से रखे गए कोऑर्डिनेट बिंदु, जो हर आँख के कोने, दोनों भौंहों के किनारे, हर होंठ का कंटूर, नाक की नोक और पुल, और पूरे जबड़े की रेखा को चिह्नित करते हैं।
ये लैंडमार्क मैप इन चीज़ों को संभव बनाते हैं:
- सेलेक्टिव स्किन रीटचिंग जो भौंह और आँख के गड्ढे की सीमा पर ठीक रुक जाए
- दाँत चमकाना जो होंठ के कंटूर के भीतर रहे और होंठ का रंग न बदले
- चेहरे का आकार एडजस्ट करना जो प्राकृतिक ज्यामिति और अनुपातिक संतुलन बनाए रखे
- लिप सिंक और फ़ेस-स्वैप टूल में पोर्ट्रेट एनिमेशन, जहाँ सोर्स चेहरे की ज्यामिति टारगेट पर बिल्कुल सटीक बैठनी चाहिए
💡 Picasso IA के फ़ेस-स्वैप टूल चेहरों को सटीक ज्यामितीय सटीकता के साथ संरेखित और ब्लेंड करने के लिए इन्हीं फ़ेशियल लैंडमार्क मैप का इस्तेमाल करते हैं। नतीजा विश्वसनीय लगता है, क्योंकि स्थानिक संरेखण शुरू से ही सही था।
कलर साइंस: जो दिखता है उससे कहीं ज़्यादा
फ़ोटोग्राफ़ी में रंग सिर्फ़ हर पिक्सेल चैनल में स्टोर मानों के बारे में नहीं है। यह संदर्भ, धारणात्मक संतुलन और उस प्रकाश स्रोत के भौतिक गुणों के बारे में है जिसने इमेज को बनाया।
AI कलर टेम्परेचर कैसे पढ़ता है
AI टूल फ़्रेम की दृश्यतः न्यूट्रल सतहों पर रंग की झलक खोजकर प्रकाश स्रोत की विशेषताएँ पहचानते हैं: सफ़ेद दीवारें, ग्रे कपड़े, हल्के रंग की छतें। हल्की नीली झलक वाली ग्रे सतह लगभग 6500-7500K के ठंडे, बादल वाले प्राकृतिक प्रकाश का संकेत देती है। उसी सतह पर गर्म एंबर झलक टंगस्टन या शाम की ढलती रोशनी, 2700-3500K, का संकेत देती है।
करेक्शन प्रक्रिया इमेज को RGB से CIE LAB जैसे धारणात्मक कलर स्पेस में बदलकर काम करती है, जहाँ एक चैनल चमक को दो क्रोमिनेंस चैनलों से अलग संभालता है। LAB में व्हाइट बैलेंस बदलने का मतलब है रंग बदलना बिना दिखने वाली चमक बदले, और यही AI व्हाइट बैलेंस करेक्शन को धुला हुआ या टिंटेड दिखने के बजाय प्राकृतिक दिखाता है।
| लाइट सोर्स | कलर टेम्परेचर | आम कास्ट |
|---|
| ओवरकास्ट आसमान | 6500-7500K | ठंडा नीला |
| सीधी धूप | 5000-5500K | न्यूट्रल |
| गोल्डन आवर | 2500-3500K | गर्म नारंगी |
| इनडोर टंगस्टन | 2700-3200K | एंबर/पीला |
| फ़्लोरेसेंट | 4000-4500K | हरे की ओर झुकाव |
ऑटोमेटिक टोन मैपिंग
एक्सपोज़र करेक्शन सिर्फ़ पिक्सेल मानों को किसी स्थिरांक से गुणा करना नहीं है। फ़ोटो में हाइलाइट और शैडो अलग तरह से व्यवहार करते हैं, और अच्छे AI टूल उन्हें अलग-अलग लॉजिक के साथ अलग चैनल की तरह प्रोसेस करते हैं।
AI इमेज के हिस्टोग्राम का मूल्यांकन करता है: क्लिप्ड हाइलाइट्स की पहचान करता है, जहाँ अधिकतम मानों पर डिटेल खो जाती है, क्रश्ड शैडो की, जहाँ डिटेल पूरे काले में गायब हो जाती है, और बाकी रेंज में मिडटोन वितरण की। फिर यह पैरामेट्रिक कर्व एडजस्टमेंट लगाता है, जो लगभग क्लिप हो चुकी हाइलाइट डिटेल वापस लाते हैं और अच्छी तरह एक्सपोज़ हुए मिडटोन को अछूता छोड़ते हैं। नतीजा अक्सर किसी कुशल मैन्युअल एडिट जैसा लगता है, न कि भोंडी ब्राइटनेस बढ़ोतरी जैसा।
नॉइज़ रिमूवल: पैटर्न बनाम रैंडमनेस
डिजिटल नॉइज़ सेंसर की गर्मी और इलेक्ट्रिकल इंटरफ़ेरेंस से होने वाला पिक्सेल मानों का रैंडम बदलाव है, खासकर ऊँची ISO सेटिंग पर। आँख को यह फ़िल्म ग्रेन जैसा दिखता है। AI के लिए यह हाई-फ़्रीक्वेंसी बदलाव है, जो असली सतही टेक्सचर के सांख्यिकीय पैटर्न का पालन नहीं करता।
AI टेक्सचर को नॉइज़ से कैसे अलग करता है
मानव त्वचा का प्राकृतिक टेक्सचर होता है: दिखने वाले रोम-छिद्र, बारीक रेखाएँ और सूक्ष्म सतही उतार-चढ़ाव, जो लगातार, स्थानिक रूप से सहसंबंधित दिशात्मक पैटर्न का पालन करते हैं। डिजिटल नॉइज़ इसकी दृश्य नकल करता है, इसीलिए पुराने नॉइज़ रिडक्शन एल्गोरिदम उस दाने के साथ-साथ त्वचा की डिटेल भी मिटा देते थे जिसे वे निशाना बनाते थे।
खास तौर पर असली टेक्सचर और सेंसर नॉइज़ में फ़र्क करने के लिए ट्रेन किए गए AI टूल उन्हें बेहद बारीक स्तर पर अलग कर सकते हैं। दिशात्मक, स्थानिक रूप से सहसंबंधित पैटर्न जैसे फ़ैब्रिक की बुनाई, लकड़ी की बनावट और बाल के स्ट्रैंड सुरक्षित रहते हैं। रैंडम, स्थानिक रूप से असंबद्ध बदलाव चिकना कर दिया जाता है। नतीजा असली टेक्सचर जैसा दिखता है, न कि आक्रामक पारंपरिक डीनॉइज़र से पैदा होने वाले ओवर-प्रोसेस्ड "प्लास्टिक स्किन" प्रभाव जैसा।
थ्रेशोल्ड को कैलिब्रेट करना
AI डीनॉइज़िंग की विफलता का तरीका ओवर-स्मूदिंग है। जब कॉन्फ़िडेंस थ्रेशोल्ड बहुत ऊँचे सेट होते हैं, तो मॉडल वह बारीक डिटेल हटा देता है जिसे उसे छूना नहीं चाहिए। सबसे अच्छे टूल इसे एक ट्यून करने योग्य पैरामीटर के रूप में देते हैं, जिससे आप फ़ोटो की खास ज़रूरतों और आउटपुट रिज़ॉल्यूशन के आधार पर नॉइज़ हटाने और टेक्सचर बचाने के बीच संतुलन बना सकते हैं।
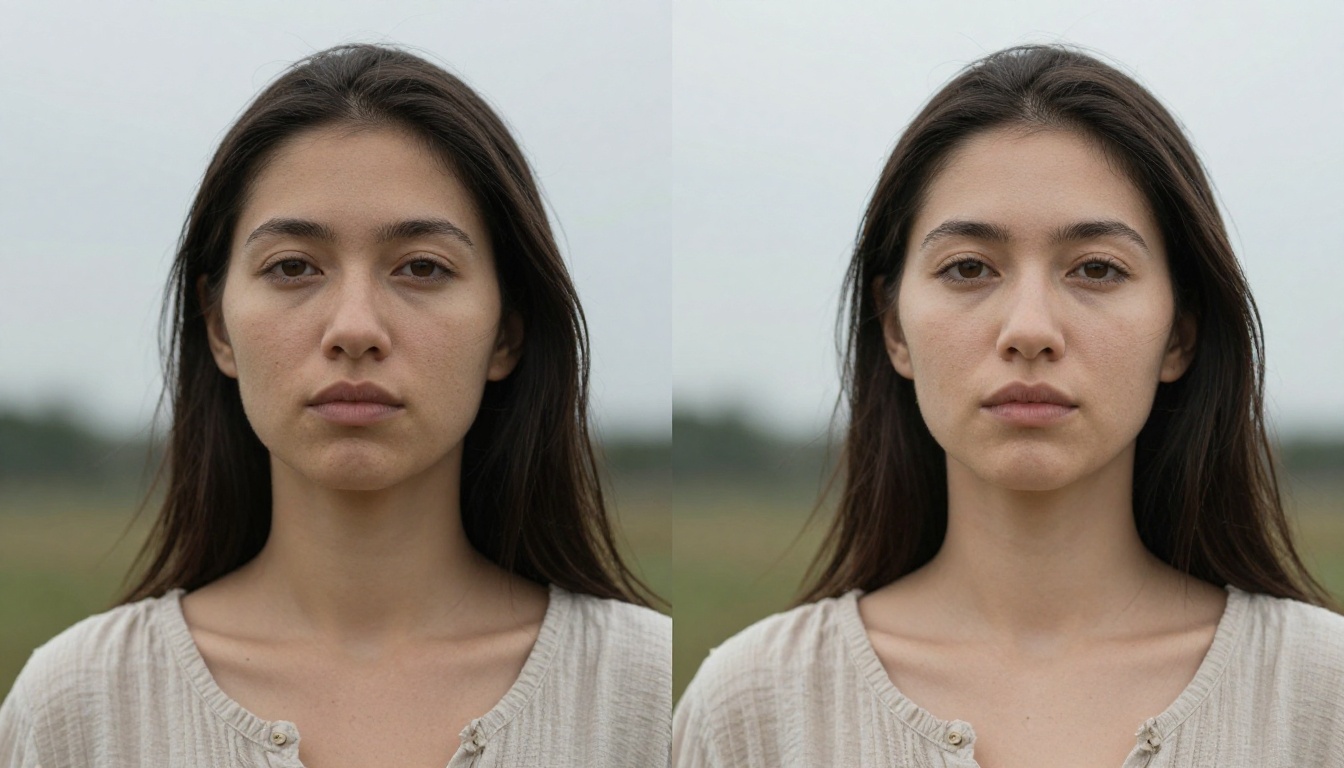
सुपर रिज़ोल्यूशन: उन पिक्सेल की भविष्यवाणी जो मौजूद नहीं थे
जब AI टूल आपकी फ़ोटो को अपस्केल करता है, तो वह मौजूदा पिक्सेल को खींचता या इंटरपोलेट नहीं करता। वह लाखों मैच की गई इमेज जोड़ियों से सीखे गए पैटर्न के आधार पर नए पिक्सेल का अनुमान लगाता है।
अपस्केलिंग मॉडल असल में क्या करते हैं
Real ESRGAN और Clarity Pro Upscaler जैसे टूल कम और ज़्यादा रिज़ॉल्यूशन वाली इमेज की मैच की गई जोड़ियों पर ट्रेन किए जाते हैं। मॉडल यह सांख्यिकीय संबंध बनाता है कि एक छोटी, खराब इमेज कैसी दिखती है और उसी दृश्य का पूरी डिटेल वाला संस्करण क्या होना चाहिए।
जब आप पोर्ट्रेट को अपस्केल करते हैं, तो AI लाखों पोर्ट्रेट उदाहरणों के पैटर्न से यह अनुमान लगाता है कि मूल रिज़ॉल्यूशन के दो या चार गुना पर त्वचा, बाल और कपड़े का टेक्सचर कैसा दिखना चाहिए। त्वचा के लिए इसका मतलब है विश्वसनीय रोम-छिद्र संरचना और माइक्रो-शैडो जोड़ना। बालों के लिए इसका मतलब है अलग-अलग स्ट्रैंड को अलग दिखाना। फ़ैब्रिक के लिए इसका मतलब है ज़्यादा रिज़ॉल्यूशन पर बुनाई की आवृत्ति फिर से बनाना।
💡 खास तौर पर पोर्ट्रेट के लिए, Crystal Upscaler फ़ेस-अवेयर प्रोसेसिंग लगाता है, जो त्वचा और बालों की बारीक डिटेल चुनिंदा रूप से जोड़ता है और बैकग्राउंड टेक्सचर को स्थानिक रूप से सुसंगत तथा हैलुसिनेटेड आर्टिफ़ैक्ट से मुक्त रखता है।
सही अपस्केलिंग टूल चुनना
अलग-अलग अपस्केलर का ट्रेनिंग फ़ोकस और आउटपुट गुण अलग होते हैं:
बैकग्राउंड हटाना: जहाँ किनारे कठिन हो जाते हैं
बैकग्राउंड हटाना AI के सरल कामों में से एक लगता है। पर है नहीं। मुश्किल हिस्सा हमेशा किनारे होते हैं: चमकीले आसमान के सामने बिखरे बाल, फ़्रेम के किनारे के पास अर्ध-पारदर्शी कपड़ा, सब्जेक्ट की सीमा पर मोशन-ब्लर वाली बाँहें।
दो-चरणीय अलगाव प्रक्रिया
बैकग्राउंड रिमूवल टूल डेप्थ मैप अनुमान और सिमेंटिक सेगमेंटेशन को मिलाकर सब्जेक्ट की सीमाएँ सटीकता से पहचानते हैं। सीमा क्षेत्र मिल जाने के बाद, एक मैटिंग एल्गोरिदम उस सीमा के पास हर पिक्सेल के लिए गणना करता है कि वह फ़ोरग्राउंड का है या बैकग्राउंड का।
आउटपुट एक अल्फ़ा मैट होता है: एक ग्रेस्केल मास्क, जहाँ सफ़ेद पिक्सेल पूरी तरह फ़ोरग्राउंड हैं, काले पिक्सेल पूरी तरह बैकग्राउंड हैं, और ग्रे पिक्सेल आंशिक रूप से पारदर्शी हैं। यही ग्रेडेशन उड़ते बालों का बिखरा रूप और कपड़े के हेम का मुलायम किनारा बचाता है, न कि पुराने सिलेक्शन टूल की कठोर, कुकी-कटर जैसी कटिंग।
जब अलगाव विफल होता है
सबसे आम विफलता का मामला: गहरे रंग के बाल, जो लगभग उतने ही गहरे या कम कॉन्ट्रास्ट वाले बैकग्राउंड के सामने हों। जब डेप्थ कॉन्ट्रास्ट और रंग कॉन्ट्रास्ट दोनों कम हों, तो मॉडल सीमा सही जगह रखने में संघर्ष करता है। सब्जेक्ट को ऐसे बैकग्राउंड के सामने शूट करना जिसमें साफ़ टोनल कॉन्ट्रास्ट हो, चाहे वह सब्जेक्ट से हल्का हो या गहरा, AI को ज़्यादा संकेत देता है और मैट्स को सचमुच ज़्यादा साफ़ बनाता है।
खराब और पुरानी फ़ोटो की बहाली
फ़ोटो रिस्टोरेशन वह जगह है जहाँ AI की ट्रेनिंग डेटा की बढ़त सबसे साफ़ दिखती है। किसी बुरी तरह खराब फ़ोटो को हाथ से ठीक करने में एक कुशल रीटचर और घंटों की सावधान मेहनत लगती है। हज़ारों रिस्टोरेशन जोड़ियों पर ट्रेन किया गया AI सेकंडों में विश्वसनीय नतीजा दे सकता है।
इनपेंटिंग: जो गायब है उसे भरना
जब फ़ोटो में भौतिक क्षति, खरोंच, पानी के धब्बे या गायब हिस्से हों, तो AI इनपेंटिंग का इस्तेमाल करता है: वह संदर्भ के सुराग के लिए आसपास के पिक्सेल पढ़ता है (पास के रंग, टेक्सचर, संरचनात्मक किनारे, वस्तु की सीमाएँ) और अनुमान लगाता है कि गायब हिस्से में क्या होना चाहिए।
चेहरों के लिए इनपेंटिंग खास तौर पर अच्छी काम करती है, क्योंकि मॉडल ने लाखों चेहरे की इमेज देखी होती हैं और वह दिखते आसपास के संदर्भ से गाल का गायब हिस्सा, आधी ढकी आँख या हेयरलाइन का क्षतिग्रस्त हिस्सा फिर से बना सकता है। अनियमित या अनोखे पैटर्न वाले जटिल बैकग्राउंड के लिए नतीजे इस पर निर्भर करते हैं कि क्षतिग्रस्त क्षेत्र के चारों ओर कितना सुसंगत संदर्भ है।
ब्लैक एंड व्हाइट फ़ोटो को रंगीन बनाना
कलराइज़ेशन एक अलग मॉडल कार्य है। ये मॉडल एक ही इमेज के पेयर्ड रंगीन और ग्रेस्केल संस्करणों पर ट्रेन होते हैं, जिससे वे चमक के डेटा को सिमेंटिक ऑब्जेक्ट वर्गीकरण के साथ जोड़कर रंग का अनुमान लगाना सीखते हैं। सबसे अच्छे कलराइज़ेशन टूल टेक्सचर और ऑब्जेक्ट श्रेणी दोनों पढ़ते हैं, इसलिए वे सभी लकड़ी की सतहों को एक ही भूरे रंग से या सारी त्वचा को एक सपाट टोन से नहीं रंगते। वे अलग-अलग और संदर्भ-आधारित रंग बनाते हैं, जो कृत्रिम रूप से टिंटेड दिखने के बजाय प्राकृतिक लगते हैं।
पूरी पाइपलाइन काम में
आधुनिक AI फ़ोटो टूल शक्तिशाली क्यों लगते हैं, इसका कारण यह है कि वे एक ही एल्गोरिदम नहीं चलाते। वे एक एकीकृत पाइपलाइन चलाते हैं, जहाँ हर कदम अगले कदम को जानकारी देता है।
एक ही फ़ोटो इन चरणों से गुज़र सकती है:
- मेटाडेटा रीडिंग कैमरा संदर्भ स्थापित करने और शुरुआती प्रोसेसिंग पैरामीटर सेट करने के लिए
- नॉइज़ मूल्यांकन किसी भी स्थानिक काम से पहले डीनॉइज़िंग की ताकत तय करने के लिए
- डेप्थ अनुमान दृश्य का पिक्सेल-दर-पिक्सेल स्थानिक मैप बनाने के लिए
- सिमेंटिक सेगमेंटेशन फ़्रेम के हर पिक्सेल को श्रेणी लेबल देने के लिए
- फ़ेशियल लैंडमार्क डिटेक्शन मौजूद किसी भी चेहरे पर सटीक एडिटिंग ज़ोन खोजने के लिए
- कलर स्पेस कन्वर्ज़न सटीक टोनल और क्रोमैटिक प्रोसेसिंग के लिए
- टास्क-विशिष्ट मॉडलिंग अपस्केलिंग, इनपेंटिंग, बैकग्राउंड रिमूवल या रिस्टोरेशन के लिए
हर कदम अगले को आकार देता है। डेप्थ मैप बताता है कि सेगमेंटेशन की सीमाएँ कहाँ पड़नी चाहिए। सेगमेंटेशन नॉइज़ मॉडल को बताता है कि कौन से क्षेत्र त्वचा हैं (टेक्सचर बचाएँ) और कौन सी सपाट दीवारें हैं (आक्रामक नॉइज़ रिमूवल)। फ़ेशियल लैंडमार्क तय करते हैं कि स्किन स्मूदिंग कहाँ लगेगी और कहाँ रुकेगी।
यही पाइपलाइन AI एडिटिंग को यांत्रिक के बजाय संदर्भ-सचेत महसूस कराती है, और इसी से नतीजे तब भी टिके रहते हैं जब आप किसी चेहरे पर 100 प्रतिशत तक ज़ूम करते हैं।
अब पाइपलाइन को काम में लाएँ
इस लेख में बताई हर चीज़, डेप्थ मैपिंग से लेकर सुपर रिज़ोल्यूशन, बैकग्राउंड अलगाव और इनपेंटिंग तक, अभी Picasso IA पर चलती है। आप Topaz Labs Image Upscale से किसी पोर्ट्रेट को उसके मूल रिज़ॉल्यूशन के 6x तक अपस्केल कर सकते हैं, Bria Background Removal से सटीक मैटिंग के साथ जटिल बैकग्राउंड हटा सकते हैं, Clarity Pro Upscaler से खराब फ़ोटो में बारीक डिटेल वापस ला सकते हैं, या Recraft Crisp Upscale से रिज़ॉल्यूशन और आगे बढ़ा सकते हैं।
इस लेख में बताई गई तकनीक सैद्धांतिक नहीं है। एक फ़ोटो चुनें, एक टूल चुनें और पाइपलाइन को रियल टाइम में काम करते देखें। एक बार आप समझ जाएँगे कि वह क्या कर रही है, तो आपको पता होगा कि उसे कैसी फ़ोटो दें कि सबसे अच्छा आउटपुट मिले।


