Quando você arrasta uma foto para um app de edição com IA e vê o aplicativo corrigir a iluminação, deixar os rostos mais nítidos e separar o fundo em um instante, parece mágica. Não é. O que acontece é um processo computacional preciso e em várias camadas, que analisa sua imagem de maneiras que a maioria das pessoas nunca imagina.
As ferramentas de edição com IA não veem fotos como você vê. Elas veem dados: grades de números, distribuições de probabilidade, relações espaciais e correspondências de padrões tiradas de milhões de imagens de treinamento. Quando você entende o que realmente acontece por trás dos bastidores, passa a tirar muito mais proveito de cada ferramenta que usa.
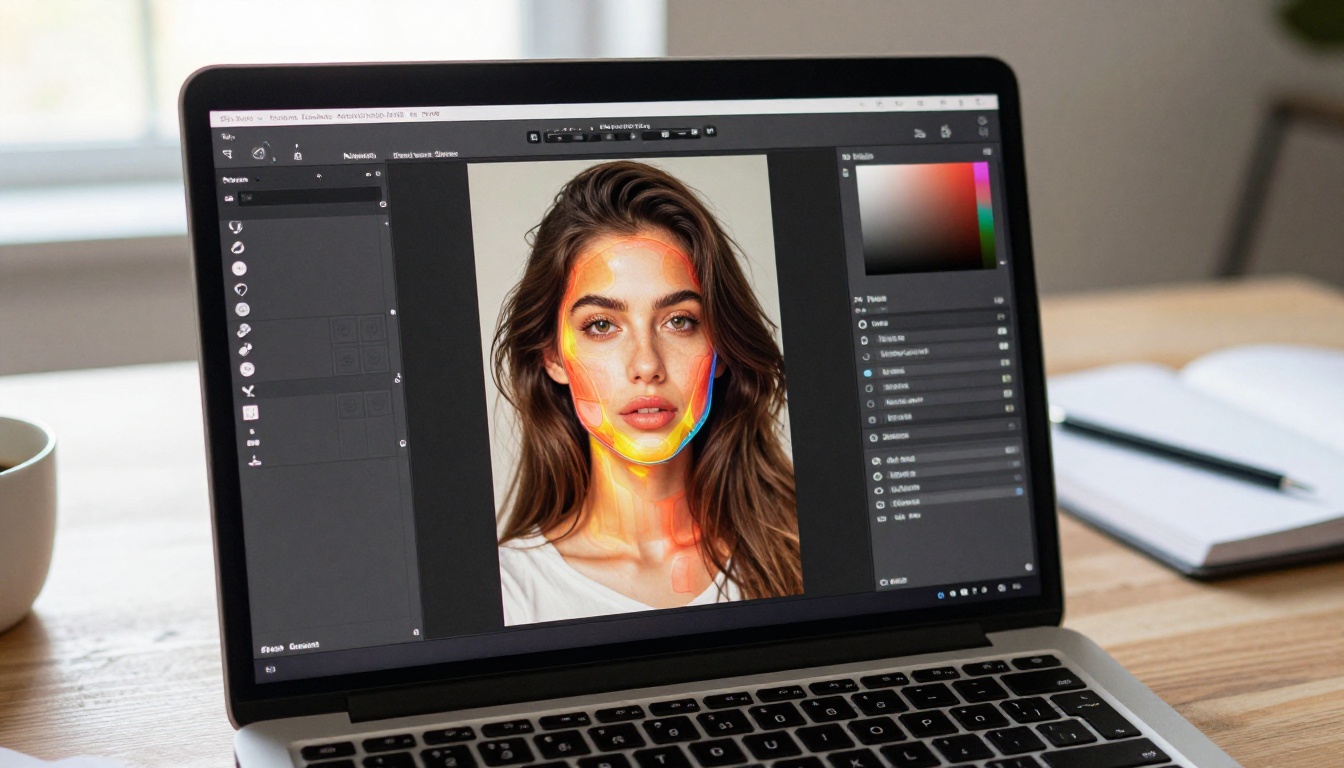
Para uma IA, sua foto não é uma imagem. É uma matriz.
Cada imagem é armazenada como uma grade de pixels, e cada pixel carrega valores numéricos para os canais vermelho, verde e azul. Uma foto padrão de 24 megapixels contém 24 milhões de pixels e, com profundidade de cor de 8 bits, isso representa três números entre 0 e 255 por pixel. São 72 milhões de valores individuais antes de qualquer processamento começar. Arquivos RAW vão mais fundo, muitas vezes com 14 bits, o que significa que cada canal pode armazenar até 16.384 valores distintos em vez de 256.
Pixels brutos são apenas números
A IA lê essa matriz não isoladamente, mas como um mapa espacial. Pixels vizinhos carregam contexto: um pixel claro cercado por pixels escuros provavelmente indica uma borda. Um conjunto de pixels de tons semelhantes representa uma superfície ou um objeto. Uma região com mudanças rápidas de valor indica textura ou detalhe. Essa leitura espacial é o que permite às ferramentas de IA detectar onde um sujeito termina e onde o fundo começa, sem que você precise desenhar uma única seleção manual.
Arquiteturas modernas de IA, em especial as Redes Neurais Convolucionais (CNNs), deslizam pequenas janelas de filtro por essa grade de pixels e detectam padrões em escalas crescentes. Dos pequenos detalhes de borda, no nível do pixel, até grandes estruturas como rostos ou linhas do horizonte, no nível da imagem inteira, cada camada de filtro se apoia na anterior e converte números brutos em representações progressivamente mais abstratas do que a imagem realmente contém.
Os metadados contam a história oculta
Antes de processar um único pixel, a maioria das ferramentas de IA lê os metadados EXIF do arquivo. Esses dados incorporados incluem modelo da câmera, distância focal, abertura, sensibilidade ISO, velocidade do obturador e, muitas vezes, coordenadas GPS. Uma foto tirada com ISO 6400 é marcada para redução de ruído agressiva antes de qualquer processamento visual começar. Um retrato com distância focal de 85mm aciona a lógica de detecção de rostos. Uma foto com horário do nascer do sol é avaliada para iluminação quente e direcional.
Esses metadados funcionam como um briefing de pré-processamento que molda todo o pipeline posterior, tornando as decisões da IA bem mais precisas desde o primeiro passo.
Como o mapeamento de profundidade muda tudo
Uma das coisas mais poderosas que uma ferramenta de IA faz com sua foto é construir um mapa de profundidade: uma representação em tons de cinza de quão distante cada região da imagem está da lente da câmera. Áreas mais claras no mapa representam objetos próximos à câmera; áreas mais escuras representam os distantes.
Inferindo profundidade a partir de uma imagem plana
A parte complicada: a maioria das fotos é plana. Não há câmera estéreo, nem sensor LiDAR, nem dados de tempo de voo anexados. As ferramentas de IA inferem a profundidade a partir de uma única imagem 2D usando as mesmas pistas visuais que o cérebro humano processa automaticamente: relações de tamanho (objetos menores tendem a estar mais longe), névoa atmosférica, queda de nitidez das bordas, gradientes de densidade de textura e oclusão (quando um objeto bloqueia outro, o bloqueado está atrás dele).
CNNs treinadas com grandes conjuntos de imagens pareadas com dados de profundidade conhecidos, como quadros de ambientes 3D ou fotos tiradas com sensores de profundidade dedicados, aprendem a prever essas relações espaciais com precisão impressionante. A saída é uma estimativa de profundidade por pixel que a ferramenta usa para tomar todas as suas decisões de edição espacial.
O que os dados de profundidade tornam possível
Com um mapa de profundidade confiável, as ferramentas de IA podem:
- Separar o primeiro plano do fundo sem máscaras manuais nem caminhos de seleção
- Aplicar efeitos de foco seletivo que imitam a profundidade de campo rasa de uma lente prime rápida
- Ajustar a iluminação de forma independente entre planos de profundidade, clareando o sujeito e deixando o fundo mais escuro
- Substituir ou desfocar fundos mantendo a integridade das bordas do sujeito em cabelos e tecidos macios
- Aplicar vinheta apenas nas regiões mais distantes do quadro
É por isso que as ferramentas de retrato com IA conseguem produzir separações de fundo que levariam 20 ou 30 minutos para um retocador experiente criar manualmente.
Reconhecimento de objetos e segmentação semântica
Identificar que há uma pessoa na sua foto é o primeiro passo. Saber que a pessoa tem um rosto, dois olhos, cabelo e roupas, e que está em frente a um tipo específico de fundo é um problema completamente diferente, e é um que as ferramentas de IA hoje resolvem de forma rotineira.
A segmentação semântica em ação
A segmentação semântica atribui um rótulo de categoria a cada pixel de uma imagem. Um retrato totalmente segmentado pode classificar os pixels como: pele, cabelo, olhos, lábios, dentes, tecido da roupa, fundo de céu, fundo de vegetação, chão em primeiro plano e acessórios.
Isso importa porque cada categoria merece um tratamento diferente. A pele deve receber suavização, mas não nitidez de bordas. O cabelo deve ser realçado fio a fio, mas não ter a cor corrigida como a pele. O céu do fundo pode ter o matiz alterado para um azul mais rico sem afetar o sujeito. Sem segmentação, cada ajuste seria uma operação grosseira aplicada ao quadro inteiro.
Modelos treinados em conjuntos de dados como COCO (Common Objects in Context) e ADE20K conseguem segmentar mais de 150 categorias de objetos distintas no nível do pixel, e modelos específicos para retratos vão ainda mais fundo, com subcategorias detalhadas da anatomia do rosto.
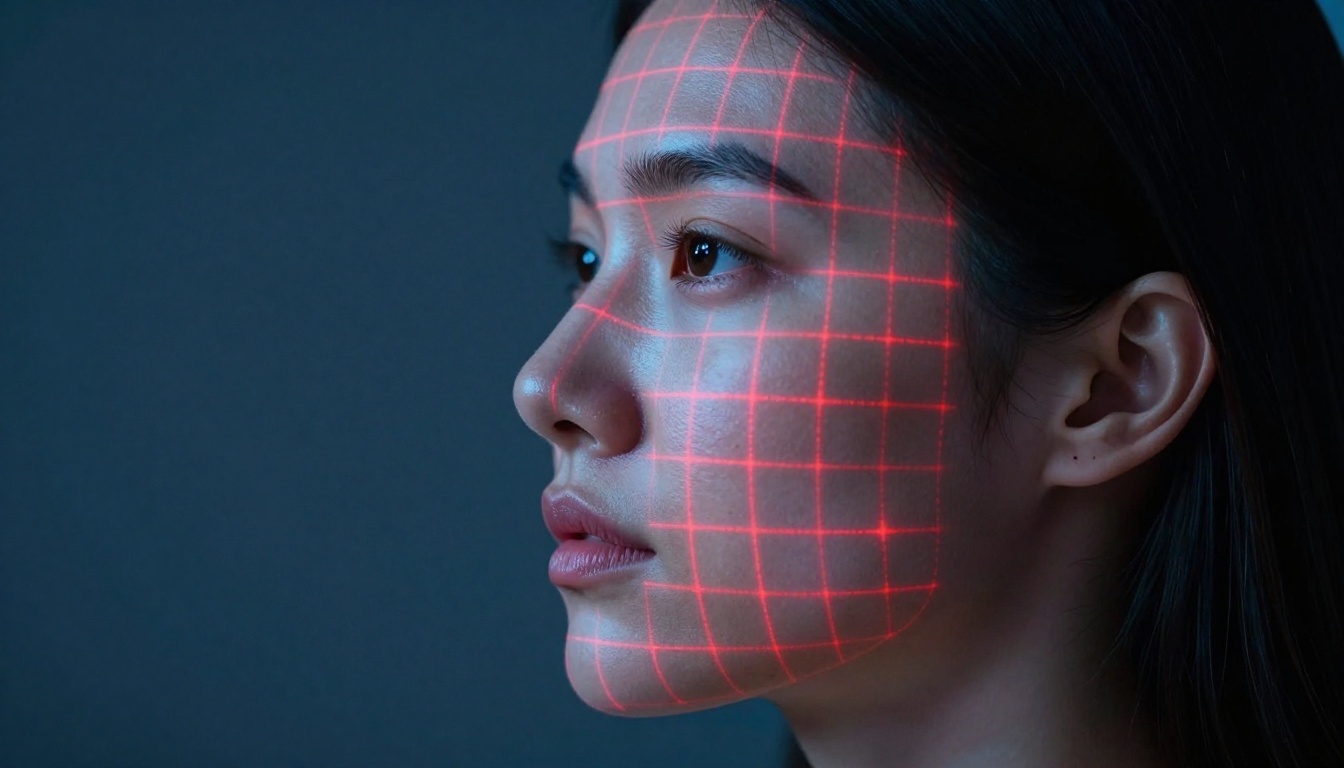
Pontos faciais: o mapa de 68 pontos
Para a edição de retratos especificamente, os modelos de IA detectam até 68 pontos faciais: coordenadas posicionadas com precisão que marcam os cantos de cada olho, as bordas das duas sobrancelhas, o contorno de cada lábio, a ponta e a ponte do nariz e a curva completa da linha da mandíbula.
Esses mapas de pontos possibilitam:
- Retoque seletivo de pele que para exatamente na borda da sobrancelha e da órbita do olho
- Clareamento dos dentes que fica dentro do contorno dos lábios sem afetar a cor dos lábios
- Ajustes no formato do rosto que mantêm a geometria natural e o equilíbrio proporcional
- Animação de retratos em ferramentas de sincronização labial e troca de rosto, nas quais a geometria de um rosto de origem precisa se mapear com exatidão sobre o alvo
💡 As ferramentas de troca de rosto no Picasso IA usam esses mesmos mapas de pontos faciais para alinhar e mesclar rostos com precisão geométrica. O resultado convence porque o alinhamento espacial estava correto desde o início.
Ciência das cores: muito mais do que parece
A cor na fotografia não é apenas uma questão dos valores armazenados em cada canal de pixel. Trata-se de contexto, equilíbrio perceptivo e das propriedades físicas da luz que criou a imagem, em primeiro lugar.
Como a IA lê a temperatura de cor
As ferramentas de IA identificam as características da fonte de luz procurando dominantes de cor em superfícies visualmente neutras do quadro: paredes brancas, roupas cinza, tetos de cor clara. Uma superfície cinza com leve dominante azul indica luz natural fria e nublada, por volta de 6500-7500K. A mesma superfície com dominante âmbar quente sugere luz de lâmpada incandescente ou luz do fim da tarde, entre 2700-3500K.
O processo de correção converte a imagem do RGB para um espaço de cor perceptivo, como o CIE LAB, no qual um canal cuida da luminância independentemente de dois canais de crominância. Ajustar o balanço de branco no LAB significa mudar a cor sem alterar o brilho percebido, e é isso que faz a correção de balanço de branco com IA parecer natural, em vez de desbotada ou tingida.
| Fonte de luz | Temperatura de cor | Dominante comum |
|---|
| Céu nublado | 6500-7500K | Azul frio |
| Luz solar direta | 5000-5500K | Neutra |
| Hora dourada | 2500-3500K | Laranja quente |
| Incandescente interna | 2700-3200K | Âmbar/amarela |
| Fluorescente | 4000-4500K | Desvio para verde |
Mapeamento automático de tons
A correção de exposição é mais do que multiplicar os valores dos pixels por uma constante. Realces e sombras em uma fotografia se comportam de forma diferente, e boas ferramentas de IA os processam como canais separados, com lógicas distintas.
A IA avalia o histograma da imagem: identifica realces estourados, onde os detalhes se perdem nos valores máximos, sombras esmagadas, onde os detalhes desaparecem em preto puro, e a distribuição dos meios-tons no restante da faixa. Em seguida, aplica ajustes de curva paramétrica que recuperam detalhes de realces próximos ao estouro e deixam os meios-tons bem expostos intactos. O resultado costuma parecer uma edição manual habilidosa, e não um aumento de brilho bruto.
Remoção de ruído: padrão ou aleatoriedade
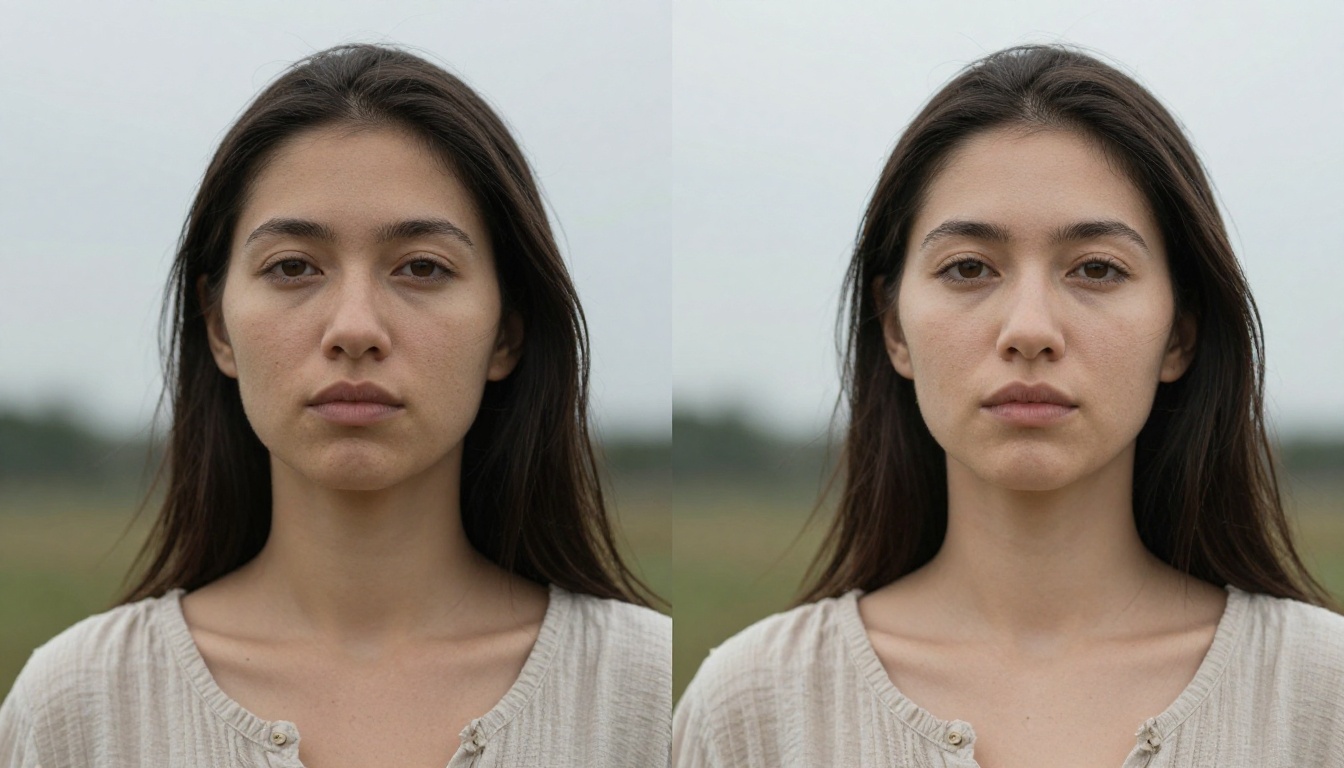
Ruído digital é uma variação aleatória nos valores dos pixels causada por calor do sensor e interferência elétrica, especialmente em configurações de ISO alto. Para o olho, parece granulação de filme. Para uma IA, parece uma variação de alta frequência que não segue os padrões estatísticos de uma textura de superfície genuína.
Como a IA distingue textura de ruído
A pele humana tem textura natural: poros visíveis, linhas finas e microvariações de superfície que seguem padrões direcionais consistentes e correlacionados espacialmente. O ruído digital imita isso visualmente, e é por isso que os algoritmos antigos de redução de ruído destruíam detalhes da pele junto com a granulação que pretendiam combater.
Ferramentas de IA treinadas especificamente para distinguir textura genuína de ruído do sensor conseguem separá-las em um nível microscópico. Padrões direcionais e correlacionados espacialmente, como a trama de tecidos, o veio da madeira e os fios de cabelo, são preservados. Variações aleatórias e não correlacionadas espacialmente são suavizadas. O resultado parece textura real, e não o efeito de "pele de plástico" superprocessada produzido por redutores de ruído tradicionais agressivos.
Calibrando o limite
A falha típica da remoção de ruído com IA é o excesso de suavização. Quando os limiares de confiança são definidos alto demais, o modelo remove detalhes finos que não deveria tocar. As melhores ferramentas expõem isso como um parâmetro ajustável, permitindo equilibrar a remoção de ruído e a preservação de textura de acordo com as necessidades da foto específica e a resolução de saída.
Super-resolução: prevendo pixels que não estavam lá
Quando uma ferramenta de IA faz o upscaling da sua foto, ela não estica nem interpola os pixels existentes. Ela prevê novos pixels com base em padrões aprendidos a partir de milhões de pares de imagens correspondentes.
O que os modelos de upscaling realmente fazem
Ferramentas como Real ESRGAN e Clarity Pro Upscaler são treinadas com pares de imagens de baixa e alta resolução. O modelo desenvolve relações estatísticas entre a aparência de uma imagem pequena e degradada e o que uma versão totalmente detalhada daquela cena deveria conter.
Quando você faz o upscaling de um retrato, a IA recorre a padrões de milhões de exemplos de retratos para prever como devem ser a textura da pele, do cabelo e do tecido em duas ou quatro vezes a resolução original. Para a pele, isso significa acrescentar uma estrutura de poros plausível e microssombras. Para o cabelo, significa renderizar a separação fio a fio. Para o tecido, significa recriar a frequência da trama em resolução mais alta.
💡 Para retratos especificamente, o Crystal Upscaler aplica um processamento com reconhecimento de rosto que acrescenta detalhes finos de pele e cabelo de forma seletiva, mantendo as texturas do fundo espacialmente coerentes e livres de artefatos de alucinação.
Escolhendo a ferramenta de upscaling certa
Diferentes upscalers têm ênfases de treinamento e características de saída distintas:
Remoção de fundo: onde as bordas ficam difíceis
A remoção de fundo parece uma das tarefas mais simples da IA. Não é. A parte difícil são sempre as bordas: cabelos soltos contra um céu claro, tecidos semitransparentes perto da borda do quadro, braços com desfoque de movimento na fronteira do sujeito.
O processo de separação em duas etapas
As ferramentas de remoção de fundo combinam a estimativa de mapa de profundidade com a segmentação semântica para identificar os limites do sujeito com precisão. Depois que a zona de borda é localizada, um algoritmo de matting calcula, para cada pixel próximo a essa fronteira, a probabilidade de ele pertencer ao primeiro plano ou ao fundo.
A saída é um alpha matte: uma máscara em tons de cinza em que os pixels brancos são totalmente primeiro plano, os pixels pretos são totalmente fundo e os pixels cinza são parcialmente transparentes. Essa gradação é o que preserva a aparência esvoaçante de fios de cabelo soltos e a borda suave da barra de um tecido, em vez de produzir os recortes duros e de molde das ferramentas antigas de seleção.
Quando a separação falha
O caso de falha mais comum: cabelo escuro contra um fundo parecido, escuro ou de baixo contraste. Quando o contraste de profundidade e o contraste de cor são baixos, o modelo tem dificuldade para posicionar a fronteira corretamente. Fotografar sujeitos contra fundos com contraste tonal claro, seja mais claro ou mais escuro que o sujeito, dá à IA mais sinal para trabalhar e produz recortes visivelmente mais limpos.
Restaurando fotos danificadas e antigas
A restauração de fotos é onde a vantagem dos dados de treinamento da IA aparece com mais clareza. Restaurar uma foto muito danificada à mão exige um retocador experiente e horas de trabalho cuidadoso. Uma IA treinada com milhares de pares de restauração pode produzir um resultado crível em segundos.
Inpainting: preenchendo o que falta
Quando uma foto tem danos físicos, arranhões, manchas de água ou regiões ausentes, a IA usa o inpainting: ela lê os pixels ao redor em busca de pistas de contexto (cores próximas, texturas, bordas estruturais, limites de objetos) e prevê o que a região faltante deveria conter.
Em rostos, o inpainting funciona particularmente bem porque o modelo já viu milhões de imagens de rostos e consegue reconstruir uma parte ausente da bochecha, um olho parcialmente oculto ou uma área danificada da linha do cabelo a partir do contexto visível ao redor. Para fundos complexos, com padrões irregulares ou únicos, os resultados variam conforme o volume de contexto coerente que cerca a área danificada.
Colorizando fotografias em preto e branco
A colorização é uma tarefa separada de modelo. Esses modelos são treinados com versões pareadas, coloridas e em tons de cinza, das mesmas imagens, aprendendo a prever a cor a partir dos dados de luminância combinados com a classificação semântica dos objetos. As melhores ferramentas de colorização leem tanto a textura quanto a categoria do objeto, então não pintam todas as superfícies de madeira com o mesmo marrom único nem toda a pele com o mesmo tom chapado. Elas produzem cor diferenciada e contextual, que parece natural em vez de artificialmente tingida.
O pipeline completo em ação
O motivo pelo qual as ferramentas modernas de foto com IA parecem poderosas é que elas não executam um único algoritmo. Elas executam um pipeline integrado, em que cada etapa informa a seguinte.
Uma única foto pode passar por:
- Leitura de metadados para estabelecer o contexto da câmera e definir os parâmetros iniciais de processamento
- Avaliação de ruído para determinar a força da redução de ruído antes de qualquer trabalho espacial começar
- Estimativa de profundidade para construir o mapa espacial por pixel da cena
- Segmentação semântica para atribuir rótulos de categoria a cada pixel do quadro
- Detecção de pontos faciais para localizar zonas precisas de edição em qualquer rosto presente
- Conversão do espaço de cor para um processamento tonal e cromático preciso
- Modelagem específica da tarefa para upscaling, inpainting, remoção de fundo ou restauração
Cada etapa molda a próxima. O mapa de profundidade informa onde as fronteiras da segmentação devem cair. A segmentação diz ao modelo de ruído quais áreas são pele (preservar a textura) e quais são paredes lisas (remoção agressiva de ruído). Os pontos faciais definem exatamente onde a suavização da pele se aplica e onde ela para.
É esse pipeline que faz a edição com IA parecer sensível ao contexto, e não mecânica, e é por isso que os resultados se sustentam quando você amplia um rosto até 100 por cento.
Agora coloque o pipeline para funcionar
Tudo o que este texto descreve, do mapeamento de profundidade à super-resolução, passando pela separação de fundo e pelo inpainting, funciona no Picasso IA agora mesmo. Você pode fazer o upscaling de um retrato para 6x a resolução original com o Topaz Labs Image Upscale, remover um fundo complexo com matting preciso usando o Bria Background Removal, recuperar detalhes finos de uma foto degradada com o Clarity Pro Upscaler ou elevar ainda mais a resolução com o Recraft Crisp Upscale.
A tecnologia descrita neste texto não é teórica. Escolha uma foto, selecione uma ferramenta e veja o pipeline funcionar em tempo real. Depois que você entender o que ele faz, saberá exatamente como dar a ele fotos que produzam o melhor resultado possível.


