Quand vous glissez une photo dans une application d’édition par IA et que vous la regardez corriger instantanément l’éclairage, accentuer les visages et détacher l’arrière-plan, on peut avoir l’impression de la magie. Ce n’en est pas une. Il se passe un processus de calcul précis et à plusieurs couches, qui analyse votre image d’une façon que la plupart des gens n’imaginent jamais.
Les outils d’édition par IA ne voient pas les photos comme vous. Ils voient des données : des grilles de nombres, des distributions de probabilités, des relations spatiales et des correspondances de motifs tirées de millions d’images d’entraînement. Une fois que vous comprenez ce qui se passe sous le capot, vous tirerez bien plus parti de chaque outil que vous utilisez.
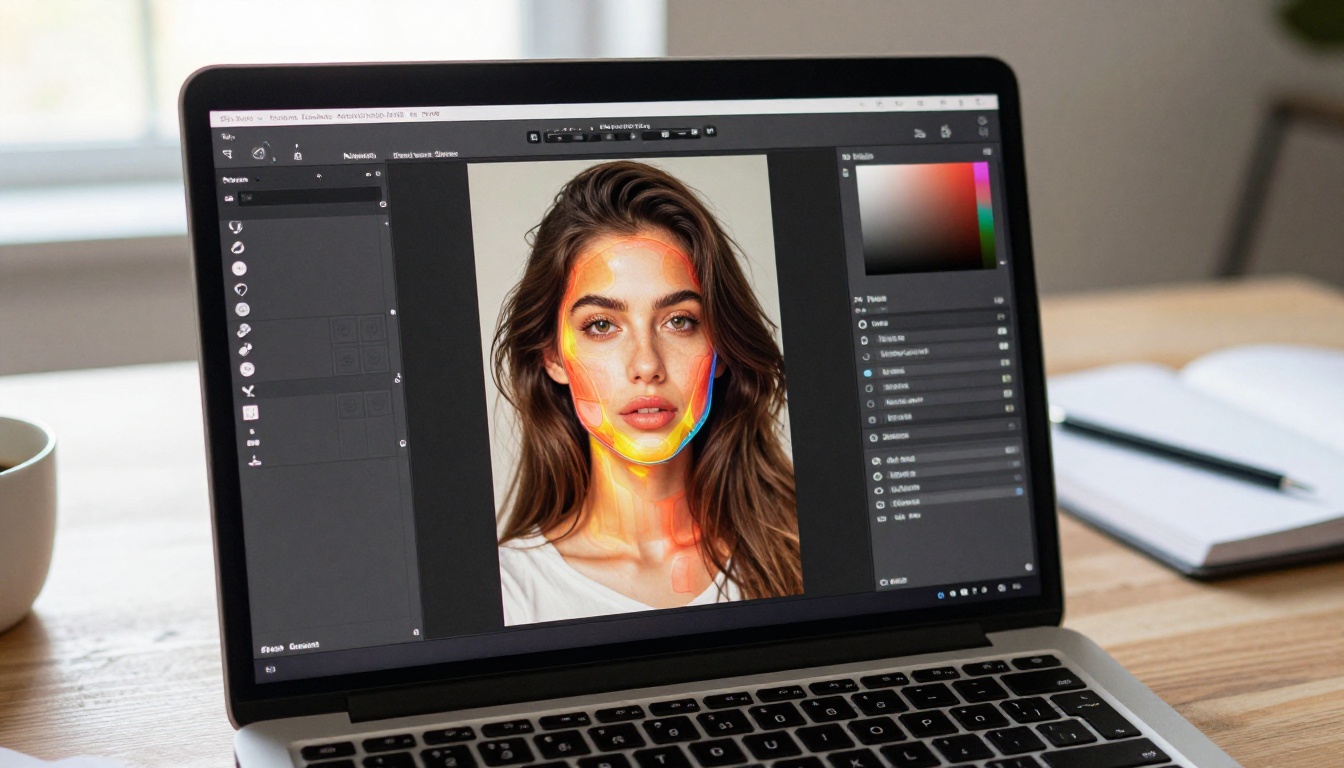
Ce que votre appareil capture face à ce que voit l’IA
Pour une IA, votre photo n’est pas une image. C’est une matrice.
Chaque image est stockée sous forme de grille de pixels, et chaque pixel porte des valeurs numériques pour les canaux rouge, vert et bleu. Une photo standard de 24 mégapixels contient 24 millions de pixels, et avec une profondeur de couleur de 8 bits, cela représente trois nombres compris entre 0 et 255 par pixel. Soit 72 millions de valeurs individuelles avant même le début du traitement. Les fichiers RAW vont plus loin, souvent en 14 bits, ce qui signifie que chaque canal peut stocker jusqu’à 16 384 valeurs distinctes au lieu de 256.
Les pixels bruts ne sont que des nombres
L’IA lit cette matrice non pas isolément, mais comme une carte spatiale. Les pixels voisins apportent du contexte : un pixel clair entouré de pixels sombres signale probablement un contour. Un ensemble de pixels de tons proches représente une surface ou un objet. Une zone où les valeurs changent rapidement indique une texture ou un détail. Cette lecture spatiale permet aux outils d’IA de détecter où un sujet se termine et où commence l’arrière-plan, sans que vous ayez à tracer une seule sélection manuelle.
Les architectures modernes d’IA, en particulier les réseaux de neurones convolutifs (CNN), font glisser de petites fenêtres de filtres sur cette grille de pixels et détectent des motifs à des échelles croissantes. Des plus petits détails de contour au niveau du pixel jusqu’aux grandes structures comme les visages ou les lignes d’horizon à l’échelle de l’image entière, chaque couche de filtres s’appuie sur la précédente et transforme les nombres bruts en représentations de plus en plus abstraites de ce que l’image contient réellement.
Les métadonnées racontent l’histoire cachée
Avant de traiter le moindre pixel, la plupart des outils d’IA lisent les métadonnées EXIF du fichier. Ces données intégrées comprennent le modèle d’appareil, la focale, l’ouverture, la sensibilité ISO, la vitesse d’obturation et souvent les coordonnées GPS. Une photo prise à ISO 6400 est signalée pour une réduction de bruit agressive avant même tout traitement visuel. Un portrait associé à une focale de 85 mm déclenche la logique de détection des visages. Une photo horodatée au lever du soleil est évaluée pour un éclairage chaud et directionnel.
Ces métadonnées agissent comme un brief de prétraitement qui façonne l’ensemble du pipeline en aval, et rendent les décisions de l’IA nettement plus précises dès la toute première étape.
L’une des fonctions les plus puissantes qu’un outil d’IA applique à votre photo est la construction d’une carte de profondeur : une représentation en niveaux de gris de la distance qui sépare chaque zone de l’image de l’objectif. Les zones claires de la carte représentent les objets proches de l’appareil ; les zones sombres représentent les objets lointains.
Déduire la profondeur d’une image plate
La difficulté, c’est que la plupart des photos sont plates. Il n’y a ni appareil stéréo, ni capteur LiDAR, ni donnée de temps de vol attachée. Les outils d’IA déduisent la profondeur d’une image 2D unique à partir des mêmes indices visuels que le cerveau humain traite automatiquement : les rapports de taille (les objets plus petits sont généralement plus éloignés), la brume atmosphérique, la chute de netteté des contours, les gradients de densité de texture et l’occlusion (lorsqu’un objet en masque un autre, celui qui est masqué se trouve derrière).
Les CNN entraînés sur de grands jeux de données d’images associées à des données de profondeur connues, comme des images extraites d’environnements 3D ou des photos prises avec des capteurs de profondeur dédiés, apprennent à prédire ces relations spatiales avec une précision impressionnante. Le résultat est une estimation de profondeur pixel par pixel que l’outil utilise pour toutes ses décisions d’édition spatiale.
Ce que permettent les données de profondeur
Avec une carte de profondeur fiable, les outils d’IA peuvent :
- Séparer le premier plan de l’arrière-plan sans masquage ni tracé de sélection manuel
- Appliquer des effets de mise au point sélective qui imitent la faible profondeur de champ d’un objectif à focale fixe lumineux
- Ajuster l’éclairage indépendamment selon les plans de profondeur, en éclaircissant le sujet tout en laissant l’arrière-plan plus sombre
- Remplacer ou flouter les arrière-plans tout en préservant les contours du sujet, notamment les cheveux et les tissus souples
- Appliquer un vignettage uniquement aux zones les plus éloignées du cadre
C’est pourquoi les outils de portrait par IA peuvent produire des séparations d’arrière-plan qui auraient demandé 20 à 30 minutes à un retoucheur qualifié, réalisées à la main.
Reconnaissance d’objets et segmentation sémantique
Identifier qu’une personne figure sur votre photo est la première étape. Savoir que cette personne a un visage, deux yeux, des cheveux, des vêtements, et qu’elle se tient devant un certain type d’arrière-plan, est un problème totalement différent, et c’est un problème que les outils d’IA résolvent désormais de façon routinière.
La segmentation sémantique en pratique
La segmentation sémantique attribue une étiquette de catégorie à chaque pixel d’une image. Un portrait entièrement segmenté pourrait classer les pixels en : peau, cheveux, yeux, lèvres, dents, tissu des vêtements, ciel en arrière-plan, feuillage en arrière-plan, sol du premier plan et accessoires.
Cela compte, car chaque catégorie mérite un traitement différent. La peau doit recevoir un lissage mais pas un renforcement des contours. Les cheveux doivent être accentués brin par brin, sans recevoir la même correction de couleur que la peau. Le ciel de l’arrière-plan peut voir sa teinte virer vers un bleu plus riche sans affecter du tout le sujet. Sans segmentation, chaque réglage serait une opération grossière appliquée à l’ensemble du cadre.
Les modèles entraînés sur des jeux de données comme COCO (Common Objects in Context) et ADE20K peuvent segmenter plus de 150 catégories d’objets distinctes au niveau du pixel, et les modèles spécialisés dans les portraits vont encore plus loin, avec des sous-catégories détaillées de l’anatomie du visage.
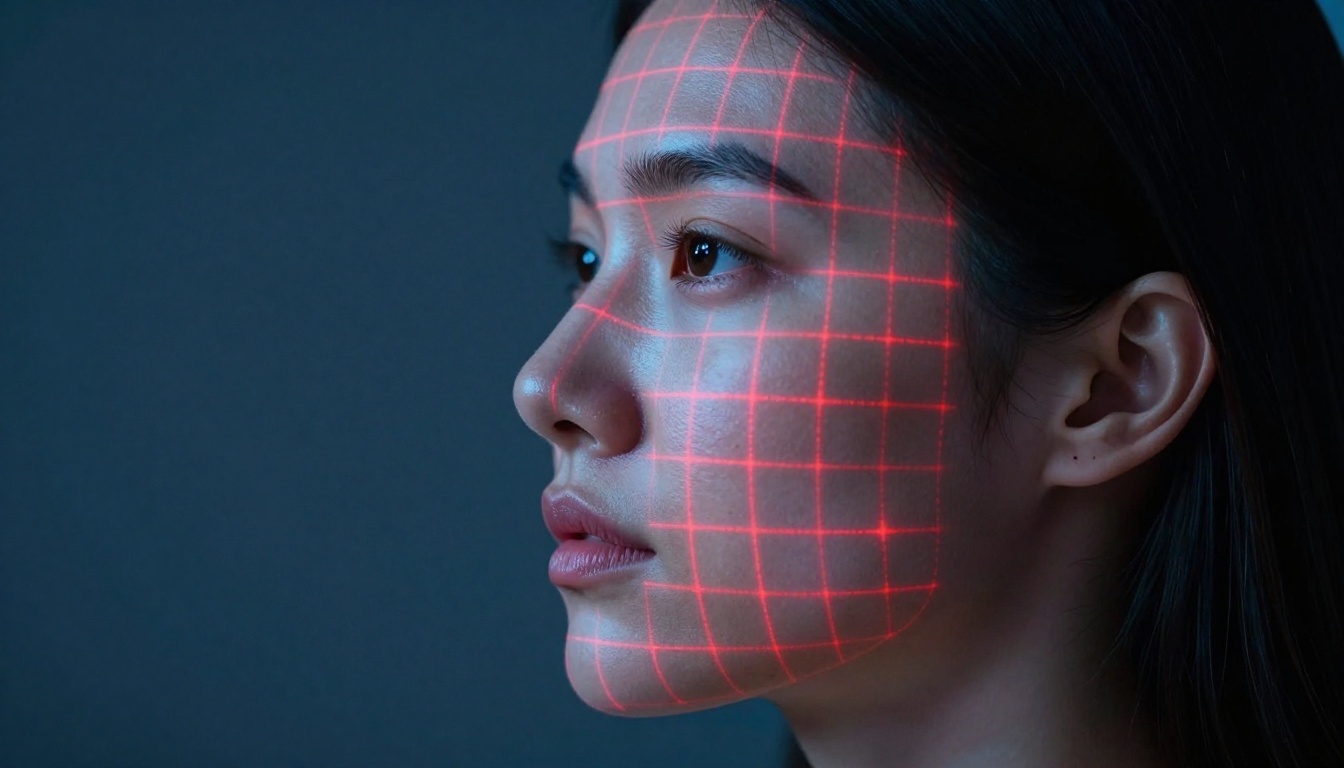
Points de repère du visage : la carte à 68 points
Pour la retouche de portrait en particulier, les modèles d’IA détectent jusqu’à 68 points de repère faciaux : des points de coordonnées placés avec précision, qui marquent les coins de chaque œil, les contours des deux sourcils, le contour de chaque lèvre, la pointe et l’arête du nez, ainsi que la courbe complète de la mâchoire.
Ces cartes de points de repère permettent :
- Une retouche sélective de la peau qui s’arrête précisément à la limite du sourcil et de l’orbite
- Un blanchiment des dents qui reste à l’intérieur du contour des lèvres sans altérer la couleur des lèvres
- Des ajustements de la forme du visage qui préservent une géométrie naturelle et un équilibre des proportions
- L’animation de portrait dans les outils de synchronisation labiale et d’échange de visage, où la géométrie d’un visage source doit se superposer précisément à la cible
💡 Les outils d’échange de visage sur Picasso IA utilisent ces mêmes cartes de points de repère faciaux pour aligner et fondre les visages avec une précision géométrique rigoureuse. Le résultat paraît convaincant parce que l’alignement spatial était juste dès le départ.
La science des couleurs : plus qu’il n’y paraît
En photographie, la couleur ne se résume pas aux valeurs stockées dans chaque canal de pixel. Elle dépend du contexte, de l’équilibre perceptif et des propriétés physiques de la source lumineuse qui a créé l’image.
Comment l’IA lit la température de couleur
Les outils d’IA identifient les caractéristiques de la source lumineuse en repérant les dominantes de couleur sur les surfaces visuellement neutres du cadre : murs blancs, vêtements gris, plafonds clairs. Une surface grise avec une légère dominante bleue indique une lumière naturelle froide et couverte, autour de 6500-7500 K. La même surface avec une dominante ambrée chaude suggère une lumière de tungstène ou une lumière de fin d’après-midi, entre 2700 et 3500 K.
La correction s’effectue en convertissant l’image du RVB vers un espace colorimétrique perceptuel comme le CIE LAB, où un canal gère la luminance indépendamment de deux canaux de chrominance. Modifier la balance des blancs dans le LAB revient à changer la couleur sans altérer la luminosité perçue, ce qui fait que la correction automatique de la balance des blancs par IA paraît naturelle plutôt que délavée ou teintée.
| Source lumineuse | Température de couleur | Dominante courante |
|---|
| Ciel couvert | 6500-7500 K | Bleu froid |
| Soleil direct | 5000-5500 K | Neutre |
| Heure dorée | 2500-3500 K | Orange chaud |
| Tungstène intérieur | 2700-3200 K | Ambre/jaune |
| Fluorescent | 4000-4500 K | Tirant vers le vert |
Correspondance tonale automatique
La correction de l’exposition ne se limite pas à multiplier les valeurs des pixels par une constante. Les hautes lumières et les ombres d’une photographie ne se comportent pas de la même façon, et les bons outils d’IA les traitent comme des canaux distincts, avec des logiques différentes.
L’IA évalue l’histogramme de l’image : elle repère les hautes lumières écrêtées, où le détail est perdu aux valeurs maximales, les ombres bouchées, où le détail disparaît dans un noir pur, et la répartition des tons moyens sur le reste de la plage. Elle applique ensuite des ajustements de courbes paramétriques qui récupèrent le détail des hautes lumières proches de l’écrêtage, tout en laissant intacts les tons moyens bien exposés. Le résultat ressemble souvent à une retouche manuelle soignée plutôt qu’à une augmentation brutale de la luminosité.
Réduction du bruit : motif contre hasard
Le bruit numérique est une variation aléatoire des valeurs des pixels, causée par la chaleur du capteur et les interférences électriques, surtout à des réglages ISO élevés. À l’œil, il ressemble au grain de la pellicule. Pour une IA, il ressemble à une variation haute fréquence qui ne suit pas les schémas statistiques d’une véritable texture de surface.
Comment l’IA distingue la texture du bruit
La peau humaine a une texture naturelle : pores visibles, fines rides et micro-variations de surface qui suivent des motifs directionnels cohérents et spatialement corrélés. Le bruit numérique imite cet effet visuellement, c’est pourquoi les anciens algorithmes de réduction du bruit effaçaient le détail de la peau en même temps que le grain qu’ils visaient.
Les outils d’IA entraînés spécifiquement à distinguer la vraie texture du bruit du capteur peuvent les séparer à une échelle microscopique. Les motifs directionnels et spatialement corrélés, comme le tissage d’un tissu, le grain du bois ou les mèches de cheveux, sont préservés. La variation aléatoire et non corrélée spatialement est lissée. Le résultat ressemble à une vraie texture plutôt qu’à l’effet « peau plastique », sur-traitée, que produisent les débruiteurs traditionnels trop agressifs.
Calibrer le seuil
Le défaut habituel du débruitage par IA est le sur-lissage. Lorsque les seuils de confiance sont réglés trop haut, le modèle supprime des détails fins qu’il ne devrait pas toucher. Les meilleurs outils rendent cela réglable, ce qui vous permet d’équilibrer la réduction du bruit et la préservation de la texture selon les besoins de la photo et la résolution de sortie.
Super-résolution : prédire des pixels qui n’existaient pas
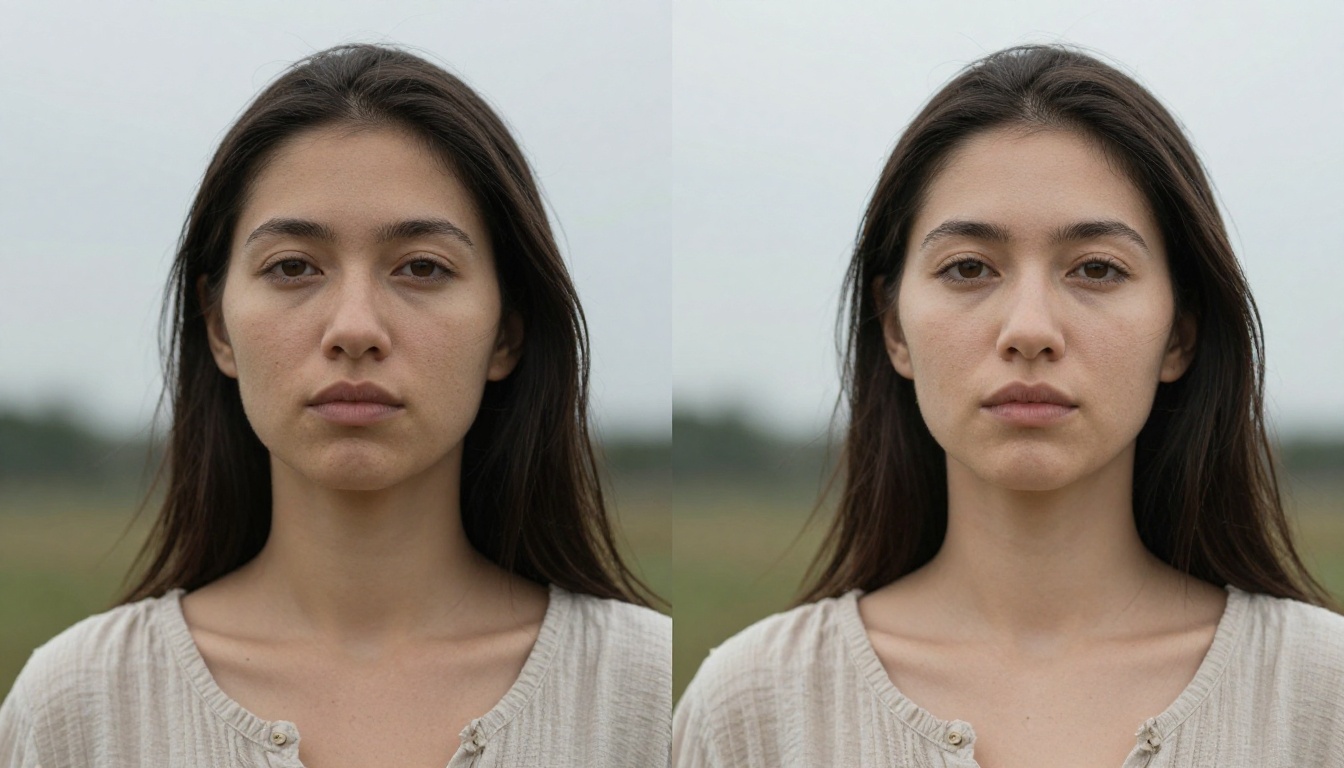
Lorsqu’un outil d’IA augmente la résolution de votre photo, il n’étire ni n’interpole les pixels existants. Il en prédit de nouveaux, à partir de motifs appris sur des millions de paires d’images appariées.
Ce que font réellement les modèles d’upscaling
Des outils comme Real ESRGAN et Clarity Pro Upscaler sont entraînés sur des paires d’images basse et haute résolution. Le modèle développe des relations statistiques entre ce à quoi ressemble une petite image dégradée et ce que devrait contenir une version entièrement détaillée de cette même scène.
Lorsque vous augmentez la résolution d’un portrait, l’IA s’appuie sur des motifs issus de millions d’exemples de portraits pour prédire ce que devraient être la texture de la peau, des cheveux et des tissus à deux ou quatre fois la résolution d’origine. Pour la peau, cela signifie ajouter une structure de pores et des micro-ombres plausibles. Pour les cheveux, cela signifie restituer la séparation des mèches individuelles. Pour les tissus, cela signifie recréer la fréquence du tissage à une résolution supérieure.
💡 Pour les portraits en particulier, Crystal Upscaler applique un traitement sensible aux visages qui ajoute sélectivement des détails fins de peau et de cheveux, tout en gardant les textures d’arrière-plan spatialement cohérentes et exemptes d’artefacts d’hallucination.
Choisir le bon outil d’upscaling
Les différents upscalers n’ont pas les mêmes orientations d’entraînement ni les mêmes caractéristiques de sortie :
Suppression d’arrière-plan : là où les contours deviennent durs
La suppression d’arrière-plan semble être l’une des tâches les plus simples pour l’IA. Ce n’est pas le cas. La difficulté réside toujours dans les contours : les cheveux diaphanes sur un ciel clair, les tissus semi-transparents près du bord du cadre, les bras en flou de bougé à la limite du sujet.
Le processus de séparation en deux étapes
Les outils de suppression d’arrière-plan combinent l’estimation de la carte de profondeur et la segmentation sémantique pour identifier précisément les limites du sujet. Une fois la zone de contour localisée, un algorithme de matting calcule, pour chaque pixel proche de cette limite, la probabilité qu’il appartienne au premier plan ou à l’arrière-plan.
Le résultat est un matte alpha : un masque en niveaux de gris où les pixels blancs sont entièrement au premier plan, les pixels noirs entièrement à l’arrière-plan et les pixels gris partiellement transparents. Cette gradation permet de préserver l’aspect duveteux des cheveux volants et le bord doux d’un ourlet de tissu, plutôt que de produire les découpes dures et uniformes des anciens outils de sélection.
Quand la séparation échoue
Le cas d’échec le plus fréquent : des cheveux sombres devant un arrière-plan sombre ou peu contrasté. Lorsque le contraste de profondeur et le contraste de couleur sont faibles, le modèle peine à placer correctement la limite. Photographier des sujets devant des arrière-plans offrant un contraste tonal net, plus clair ou plus sombre que le sujet, donne davantage de signal à l’IA et produit des mattes nettement plus propres.
Restaurer les photos abîmées et anciennes
La restauration photo est le domaine où l’avantage des données d’entraînement de l’IA apparaît le plus clairement. Restaurer à la main une photo gravement endommagée demande un retoucheur qualifié et des heures de travail minutieux. Une IA entraînée sur des milliers de paires de restauration peut produire un résultat crédible en quelques secondes.
Inpainting : combler ce qui manque
Lorsqu’une photo présente des dommages physiques, des rayures, des taches d’eau ou des zones manquantes, l’IA utilise l’inpainting : elle lit les pixels environnants pour y trouver des indices de contexte (couleurs proches, textures, contours structurels, limites des objets) et prédit ce que la zone manquante devrait contenir.
Pour les visages, l’inpainting fonctionne particulièrement bien, car le modèle a vu des millions d’images de visages et peut reconstituer une portion de joue manquante, un œil partiellement masqué ou une zone de cheveux abîmée à partir du contexte visible autour. Pour les arrière-plans complexes aux motifs irréguliers ou uniques, les résultats varient selon la quantité de contexte cohérent qui entoure la zone endommagée.
Coloriser des photos en noir et blanc
La colorisation est une tâche de modèle distincte. Ces modèles sont entraînés sur des versions couleur et en niveaux de gris appariées des mêmes images, ce qui leur apprend à prédire la couleur à partir des données de luminance combinées à la classification sémantique des objets. Les meilleurs outils de colorisation lisent à la fois la texture et la catégorie de l’objet, de sorte qu’ils ne peignent pas toutes les surfaces en bois d’une seule et même nuance de brun, ni toute la peau d’un ton plat identique. Ils produisent une couleur différenciée et contextuelle qui paraît naturelle plutôt qu’artificiellement teintée.
Le pipeline complet en action
Si les outils photo modernes par IA semblent puissants, c’est qu’ils n’exécutent pas un algorithme unique. Ils font tourner un pipeline intégré où chaque étape alimente la suivante.
Une seule photo peut passer par les étapes suivantes :
- Lecture des métadonnées pour établir le contexte de l’appareil et définir les paramètres de traitement initiaux
- Évaluation du bruit pour déterminer l’intensité du débruitage avant tout travail spatial
- Estimation de la profondeur pour construire la carte spatiale pixel par pixel de la scène
- Segmentation sémantique pour attribuer une étiquette de catégorie à chaque pixel de l’image
- Détection des points de repère du visage pour localiser les zones d’édition précises sur les visages présents
- Conversion de l’espace colorimétrique pour un traitement tonal et chromatique précis
- Modélisation spécifique à la tâche pour l’upscaling, l’inpainting, la suppression d’arrière-plan ou la restauration
Chaque étape influence la suivante. La carte de profondeur indique où doivent se situer les limites de segmentation. La segmentation indique au modèle de bruit quelles zones sont de la peau (texture à préserver) et quels sont les murs unis (débruitage agressif). Les points de repère du visage définissent exactement où le lissage de la peau s’applique et où il s’arrête.
C’est ce pipeline qui donne à l’édition par IA un comportement attentif au contexte plutôt que mécanique, et c’est pourquoi les résultats tiennent quand vous zoomez à 100 % sur un visage.
Mettez maintenant le pipeline au travail
Tout ce qui est décrit dans cet article, de la cartographie de la profondeur à la super-résolution en passant par la séparation de l’arrière-plan et l’inpainting, fonctionne dès maintenant sur Picasso IA. Vous pouvez augmenter la résolution d’un portrait jusqu’à 6x sa résolution d’origine avec Topaz Labs Image Upscale, supprimer un arrière-plan complexe avec un matting précis grâce à Bria Background Removal, restituer les détails fins d’une photo dégradée avec Clarity Pro Upscaler, ou pousser la résolution plus loin avec Recraft Crisp Upscale.
La technologie décrite dans cet article n’est pas théorique. Choisissez une photo, sélectionnez un outil et regardez le pipeline travailler en temps réel. Une fois que vous aurez vu ce qu’il fait, vous saurez exactement comment lui fournir des photos qui donnent le meilleur résultat possible.


