Cuando arrastras una foto a una aplicación de edición con IA y la ves corregir la iluminación, enfocar los rostros y separar el fondo al instante, puede parecer magia. No lo es. Lo que ocurre es un proceso computacional preciso y de varias capas que analiza tu imagen de maneras en las que la mayoría de la gente nunca piensa.
Las herramientas de edición con IA no ven las fotos como tú. Ven datos: cuadrículas de números, distribuciones de probabilidad, relaciones espaciales y coincidencias de patrones extraídas de millones de imágenes de entrenamiento. Una vez que entiendes lo que pasa bajo el capó, sacarás mucho más provecho de cada herramienta que uses.
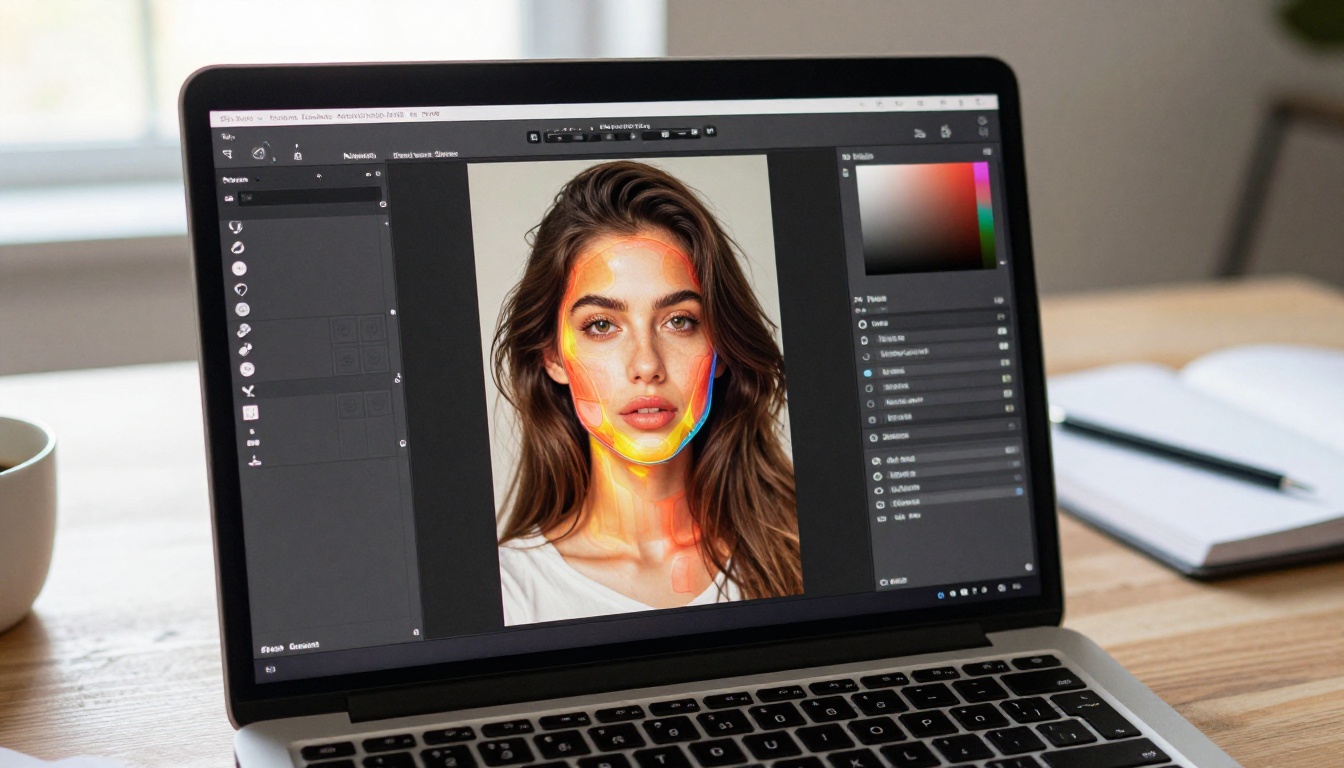
Lo que captura tu cámara frente a lo que ve la IA
Para una IA, tu foto no es una imagen. Es una matriz.
Cada imagen se guarda como una cuadrícula de píxeles, y cada píxel contiene valores numéricos para los canales rojo, verde y azul. Una foto estándar de 24 megapíxeles contiene 24 millones de píxeles y, con una profundidad de color de 8 bits, son tres números entre 0 y 255 por píxel. Eso suma 72 millones de valores individuales antes de empezar cualquier procesamiento. Los archivos RAW llegan más lejos, con frecuencia a 14 bits, lo que significa que cada canal puede almacenar hasta 16 384 valores distintos en lugar de 256.
Los píxeles en bruto son solo números
La IA lee esta matriz no de forma aislada, sino como un mapa espacial. Los píxeles vecinos aportan contexto: un píxel brillante rodeado de píxeles oscuros probablemente indica un borde. Un grupo de píxeles de tonos parecidos representa una superficie o un objeto. Una región con cambios rápidos de valor indica textura o detalle. Esta lectura espacial es lo que permite a las herramientas de IA detectar dónde termina un sujeto y empieza el fondo sin que tengas que trazar ninguna selección manual.
Las arquitecturas modernas de IA, en particular las redes neuronales convolucionales (CNN), deslizan pequeñas ventanas de filtros sobre esta cuadrícula de píxeles y detectan patrones a escalas crecientes. Desde detalles finos de borde a nivel de píxel hasta rasgos estructurales grandes, como rostros o líneas del horizonte, a nivel de imagen completa, cada capa de filtros se apoya en la anterior y convierte los números en bruto en representaciones cada vez más abstractas de lo que la imagen contiene realmente.
Los metadatos cuentan la historia oculta
Antes de procesar un solo píxel, la mayoría de las herramientas de IA leen los metadatos EXIF del archivo. Estos datos incluyen el modelo de cámara, la distancia focal, la apertura, la sensibilidad ISO, la velocidad de obturación y, a menudo, las coordenadas GPS. Una toma hecha a ISO 6400 se marca para una reducción de ruido agresiva antes de que empiece cualquier procesamiento visual. Un retrato etiquetado con una distancia focal de 85 mm activa la lógica de detección de rostros. Una foto con marca de hora al amanecer se evalúa en busca de una iluminación cálida y direccional.
Estos metadatos funcionan como un informe previo al procesamiento que da forma a todo el proceso posterior, lo que hace que las decisiones de la IA sean mucho más precisas desde el primer paso.
Cómo el mapa de profundidad lo cambia todo
Una de las cosas más potentes que hace una herramienta de IA con tu foto es construir un mapa de profundidad: una representación en escala de grises de la distancia que hay entre cada zona de la imagen y el objetivo de la cámara. Las áreas más claras del mapa representan objetos cercanos a la cámara; las más oscuras, los lejanos.
Inferir la profundidad a partir de una imagen plana
La parte complicada: la mayoría de las fotos son planas. No hay cámara estéreo, ni sensor LiDAR, ni datos de tiempo de vuelo adjuntos. Las herramientas de IA infieren la profundidad a partir de una sola imagen 2D usando las mismas pistas visuales que el cerebro humano procesa de forma automática: relaciones de tamaño (los objetos más pequeños tienden a estar más lejos), neblina atmosférica, caída de la nitidez de los bordes, gradientes de densidad de textura y oclusión (cuando un objeto tapa a otro, el que queda tapado está detrás).
Las CNN entrenadas con grandes conjuntos de imágenes emparejadas con datos de profundidad conocidos, como fotogramas de entornos 3D o fotos tomadas con sensores de profundidad dedicados, aprenden a predecir estas relaciones espaciales con una precisión impresionante. El resultado es una estimación de profundidad píxel a píxel que la herramienta usa para tomar todas sus decisiones de edición espacial.
Lo que hace posible el dato de profundidad
Con un mapa de profundidad fiable, las herramientas de IA pueden:
- Separar el primer plano del fondo sin máscaras ni trazados de selección manuales
- Aplicar efectos de enfoque selectivo que imitan la profundidad de campo reducida de un objetivo fijo luminoso
- Ajustar la iluminación de forma independiente por planos de profundidad, aclarando el sujeto y dejando el fondo más oscuro
- Reemplazar o desenfocar fondos manteniendo la integridad de los bordes del sujeto en el cabello y las telas suaves
- Aplicar viñeteado solo en las zonas más lejanas del encuadre
Por eso las herramientas de retratos con IA pueden producir separaciones de fondo que a un retocador experto le llevarían entre 20 y 30 minutos hacer a mano.
Reconocimiento de objetos y segmentación semántica
Identificar que hay una persona en tu foto es el primer paso. Saber que la persona tiene cara, dos ojos, pelo y ropa, y que está delante de un tipo concreto de fondo, es un problema completamente distinto, y hoy las herramientas de IA lo resuelven con normalidad.
La segmentación semántica en acción
La segmentación semántica asigna una etiqueta de categoría a cada píxel de la imagen. Un retrato totalmente segmentado podría clasificar los píxeles como: piel, pelo, ojos, labios, dientes, tela de la ropa, cielo de fondo, follaje de fondo, suelo del primer plano y accesorios.
Esto importa porque cada categoría merece un tratamiento distinto. La piel debe recibir suavizado, pero no afilado de bordes. El pelo debe afilarse mechón a mechón, pero no corregirse en color como la piel. El cielo del fondo puede cambiar su tono hacia un azul más intenso sin afectar en absoluto al sujeto. Sin segmentación, cada ajuste sería una operación burda aplicada a todo el encuadre.
Los modelos entrenados con conjuntos de datos como COCO (Common Objects in Context) y ADE20K pueden segmentar más de 150 categorías de objetos distintas a nivel de píxel, y los modelos específicos para retratos llegan aún más lejos, con subcategorías detalladas de la anatomía facial.
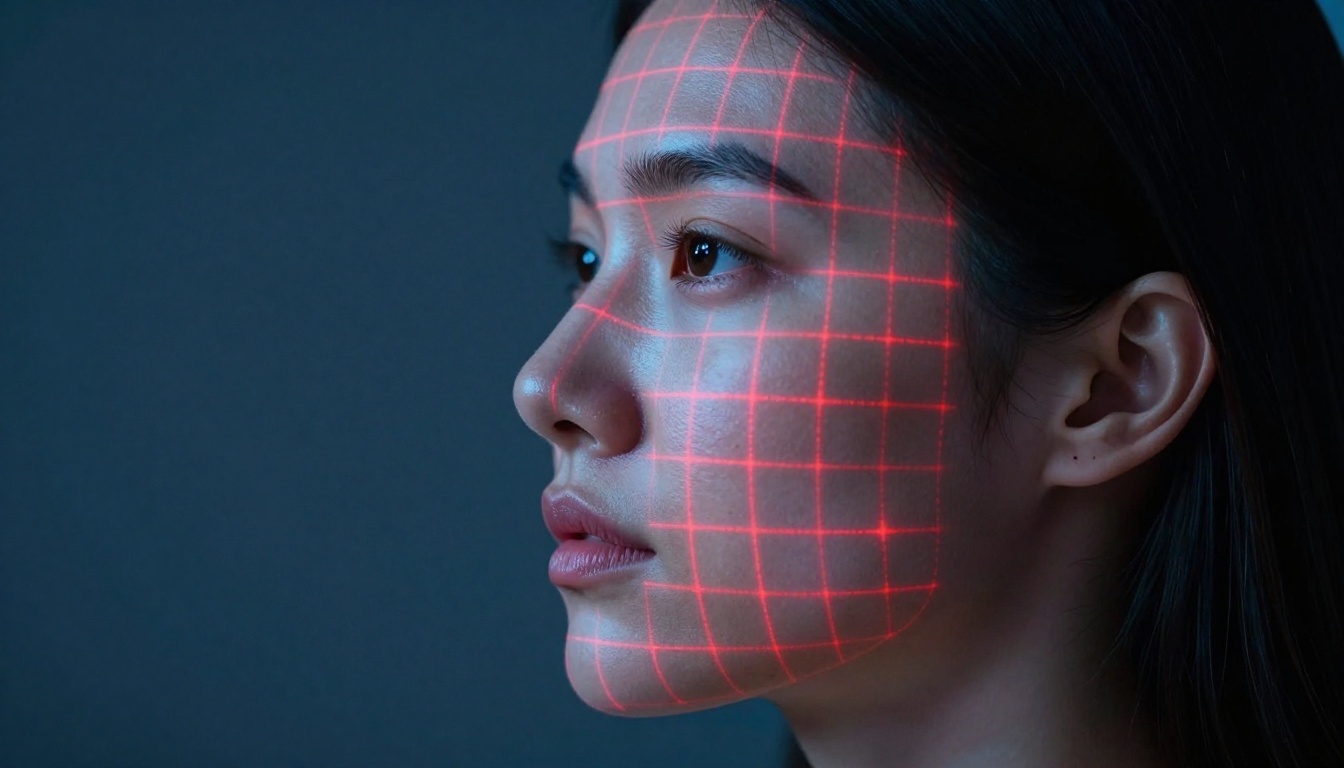
Puntos faciales: el mapa de 68 puntos
En la edición de retratos en concreto, los modelos de IA detectan hasta 68 puntos faciales: puntos de coordenadas colocados con precisión que marcan las comisuras de cada ojo, los bordes de ambas cejas, el contorno de cada labio, la punta y el puente de la nariz, y la curva completa de la mandíbula.
Estos mapas de puntos permiten:
- Retoque selectivo de la piel que se detiene exactamente en el límite de la ceja y la cuenca del ojo
- Aclarado de dientes que se mantiene dentro del contorno de los labios sin afectar al color de los labios
- Ajustes de la forma del rostro que mantienen una geometría natural y un equilibrio proporcional
- Animación de retratos en las herramientas de sincronización labial e intercambio de rostros, donde la geometría de un rostro de origen debe coincidir con precisión con el destino
💡 Las herramientas de intercambio de rostros de Picasso IA usan estos mismos mapas de puntos faciales para alinear y fusionar rostros con una precisión geométrica exacta. El resultado resulta convincente porque la alineación espacial fue correcta desde el principio.
Ciencia del color: más de lo que parece
El color en la fotografía no se reduce a los valores guardados en cada canal de píxel. Depende del contexto, del equilibrio perceptual y de las propiedades físicas de la fuente de luz que creó la imagen en primer lugar.
Cómo la IA interpreta la temperatura de color
Las herramientas de IA identifican las características de la fuente de luz buscando dominantes de color en superficies visualmente neutras del encuadre: paredes blancas, ropa gris, techos de tonos claros. Una superficie gris con una ligera dominante azul indica luz natural nublada y fría, en torno a 6500-7500 K. La misma superficie con una dominante ámbar cálida sugiere luz de tungsteno o de última hora de la tarde, de 2700-3500 K.
El proceso de corrección consiste en convertir la imagen de RGB a un espacio de color perceptual como CIE LAB, donde un canal gestiona la luminancia de forma independiente de dos canales de crominancia. Desplazar el balance de blancos en LAB significa cambiar el color sin alterar el brillo percibido, y eso es lo que hace que la corrección automática de balance de blancos con IA parezca natural en lugar de apagada o teñida.
| Fuente de luz | Temperatura de color | Dominante habitual |
|---|
| Cielo nublado | 6500-7500 K | Azul frío |
| Luz solar directa | 5000-5500 K | Neutra |
| Hora dorada | 2500-3500 K | Naranja cálido |
| Tungsteno en interiores | 2700-3200 K | Ámbar/amarillo |
| Fluorescente | 4000-4500 K | Desplazada hacia el verde |
Mapeo tonal automático
La corrección de la exposición es más que multiplicar los valores de píxeles por una constante. Las luces y las sombras de una fotografía se comportan de forma distinta, y las buenas herramientas de IA las procesan como canales independientes con lógicas diferentes.
La IA evalúa el histograma de la imagen: identifica las altas luces recortadas, donde se pierde detalle en los valores máximos, las sombras aplastadas, donde el detalle desaparece en negro puro, y la distribución de medios tonos en el resto del rango. Después aplica ajustes de curvas paramétricas que recuperan el detalle de las altas luces casi recortadas y dejan intactos los medios tonos bien expuestos. El resultado a menudo parece una edición manual experta y no un aumento brusco del brillo.
Eliminación de ruido: patrón frente a aleatoriedad
El ruido digital es una variación aleatoria de los valores de píxel causada por el calor del sensor y las interferencias eléctricas, sobre todo con ajustes de ISO altos. A simple vista se parece al grano de la película. Para una IA, es una variación de alta frecuencia que no sigue los patrones estadísticos de la textura real de una superficie.
Cómo la IA distingue la textura del ruido
La piel humana tiene textura natural: poros visibles, líneas finas y microvariaciones de superficie que siguen patrones direccionales constantes y correlacionados espacialmente. El ruido digital imita esto visualmente, y por eso los algoritmos de reducción de ruido más antiguos destruían el detalle de la piel junto con el grano que pretendían eliminar.
Las herramientas de IA entrenadas específicamente para distinguir la textura genuina del ruido del sensor pueden separarlos a nivel microscópico. Los patrones direccionales y correlacionados espacialmente, como el tejido de una tela, la veta de la madera o los mechones de pelo, se conservan. La variación aleatoria y no correlacionada se suaviza. El resultado parece textura real y no el efecto de «piel de plástico» sobreprocesada que producen los eliminadores de ruido tradicionales agresivos.
Calibrar el umbral
El fallo típico de la reducción de ruido con IA es el suavizado excesivo. Cuando los umbrales de confianza se fijan demasiado altos, el modelo elimina detalles finos que no debería tocar. Las mejores herramientas lo exponen como un parámetro ajustable, lo que te permite equilibrar la eliminación de ruido y la conservación de la textura según las necesidades de la foto concreta y la resolución de salida.
Superresolución: predecir píxeles que no estaban
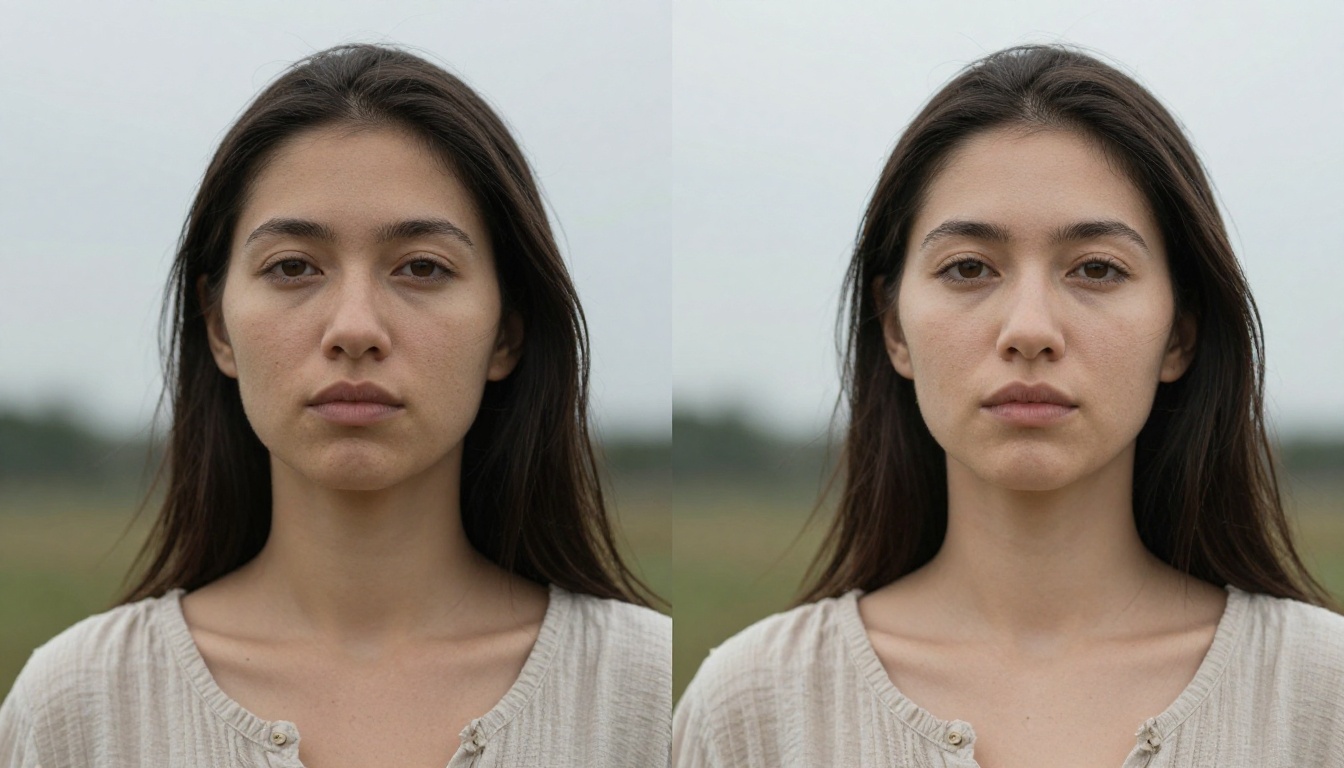
Cuando una herramienta de IA aumenta la resolución de tu foto, no estira ni interpola los píxeles existentes. Predice otros nuevos a partir de patrones aprendidos de millones de pares de imágenes emparejadas.
Qué hacen realmente los modelos de escalado
Herramientas como Real ESRGAN y Clarity Pro Upscaler se entrenan con pares emparejados de imágenes de baja y de alta resolución. El modelo desarrolla relaciones estadísticas entre lo que parece una imagen pequeña y degradada y lo que debería contener una versión totalmente detallada de esa misma escena.
Cuando escalas un retrato, la IA recurre a patrones de millones de ejemplos de retratos para predecir cómo deberían verse la textura de la piel, el pelo y la tela a dos o cuatro veces la resolución original. En la piel, eso significa añadir una estructura de poros y microsombras plausibles. En el pelo, significa representar la separación de mechones individuales. En la tela, significa recrear la frecuencia del tejido a mayor resolución.
💡 Para retratos en concreto, Crystal Upscaler aplica un procesamiento con reconocimiento facial que añade detalle fino de piel y pelo de forma selectiva, mientras mantiene las texturas del fondo coherentes espacialmente y sin artefactos generados por alucinación.
Elegir la herramienta de escalado adecuada
Los distintos upscalers tienen énfasis de entrenamiento y características de salida diferentes:
Eliminación de fondo: dónde los bordes se complican
Eliminar el fondo parece una de las tareas más sencillas de la IA. No lo es. La parte difícil son siempre los bordes: pelo suelto contra un cielo brillante, tela semitransparente cerca del borde del encuadre, brazos con desenfoque de movimiento en el límite del sujeto.
El proceso de separación en dos etapas
Las herramientas de eliminación de fondo combinan la estimación del mapa de profundidad con la segmentación semántica para identificar con precisión los límites del sujeto. Una vez localizada la zona del borde, un algoritmo de matting calcula, para cada píxel cercano a ese límite, la probabilidad de que pertenezca al primer plano o al fondo.
El resultado es una máscara alfa: una máscara en escala de grises donde los píxeles blancos son primer plano completo, los negros son fondo completo y los grises son parcialmente transparentes. Esta gradación es lo que conserva el aspecto difuso del pelo suelto y el borde suave del bajo de una tela, en lugar de producir los recortes duros y de molde de las herramientas de selección más antiguas.
Cuando la separación falla
El caso de fallo más común: pelo oscuro sobre un fondo igual de oscuro o de bajo contraste. Cuando el contraste de profundidad y el de color son bajos, el modelo tiene dificultades para situar bien el límite. Fotografiar a los sujetos frente a fondos con un contraste tonal claro, sean más claros o más oscuros que el sujeto, da a la IA más información con la que trabajar y produce un matting notablemente más limpio.
Restaurar fotos dañadas y antiguas
La restauración de fotos es donde la ventaja de los datos de entrenamiento de la IA se nota más. Restaurar a mano una foto muy dañada requiere un retocador experto y horas de trabajo minucioso. Una IA entrenada con miles de pares de restauración puede producir un resultado creíble en segundos.
Inpainting: rellenar lo que falta
Cuando una foto tiene daños físicos, arañazos, manchas de agua o zonas perdidas, la IA usa inpainting: lee los píxeles circundantes en busca de pistas de contexto (colores cercanos, texturas, bordes estructurales, límites de objetos) y predice lo que debería contener la zona perdida.
En los rostros, el inpainting funciona especialmente bien porque el modelo ha visto millones de imágenes de caras y puede reconstruir una parte de mejilla que falta, un ojo parcialmente tapado o una zona dañada del nacimiento del pelo a partir del contexto visible alrededor. En los fondos complejos, con patrones irregulares o únicos, los resultados varían según cuánto contexto coherente rodee la zona dañada.
Colorear fotografías en blanco y negro
La colorización es una tarea de modelo aparte. Estos modelos se entrenan con versiones emparejadas en color y en escala de grises de las mismas imágenes, lo que les enseña a predecir el color a partir de los datos de luminancia combinados con la clasificación semántica de los objetos. Las mejores herramientas de colorización leen tanto la textura como la categoría del objeto, así que no pintan todas las superficies de madera del mismo marrón único ni toda la piel con el mismo tono plano. Producen un color diferenciado y contextual que resulta natural en lugar de tintado artificialmente.
El proceso completo en acción
La razón por la que las herramientas modernas de foto con IA resultan potentes es que no ejecutan un único algoritmo. Ejecutan un proceso integrado en el que cada paso informa al siguiente.
Una sola foto puede pasar por:
- Lectura de metadatos para establecer el contexto de la cámara y fijar los parámetros de procesamiento iniciales
- Evaluación del ruido para determinar la intensidad de la reducción de ruido antes de empezar cualquier trabajo espacial
- Estimación de profundidad para construir el mapa espacial de la escena píxel a píxel
- Segmentación semántica para asignar etiquetas de categoría a cada píxel del encuadre
- Detección de puntos faciales para localizar zonas de edición precisas en los rostros presentes
- Conversión del espacio de color para un procesamiento tonal y cromático preciso
- Modelado específico de la tarea para el escalado, el inpainting, la eliminación de fondo o la restauración
Cada paso da forma al siguiente. El mapa de profundidad indica dónde deben caer los límites de la segmentación. La segmentación le dice al modelo de ruido qué zonas son piel (conservar la textura) y cuáles son paredes lisas (eliminación agresiva del ruido). Los puntos faciales definen exactamente dónde se aplica el suavizado de piel y dónde se detiene.
Este proceso es la razón por la que la edición con IA parece consciente del contexto y no mecánica, y por la que los resultados aguantan cuando amplías un rostro al 100 por ciento.
Ahora pon el proceso a trabajar
Todo lo que se explica en este artículo, desde el mapeo de profundidad hasta la superresolución, pasando por la separación del fondo y el inpainting, funciona ahora mismo en Picasso IA. Puedes escalar un retrato a 6x su resolución original con Topaz Labs Image Upscale, eliminar un fondo complejo con matting preciso usando Bria Background Removal, recuperar detalle fino en una foto degradada con Clarity Pro Upscaler, o aumentar aún más la resolución con Recraft Crisp Upscale.
La tecnología descrita en este artículo no es teórica. Elige una foto, escoge una herramienta y mira el proceso funcionando en tiempo real. Una vez que veas lo que hace, sabrás exactamente cómo darle fotos que produzcan el mejor resultado posible.


