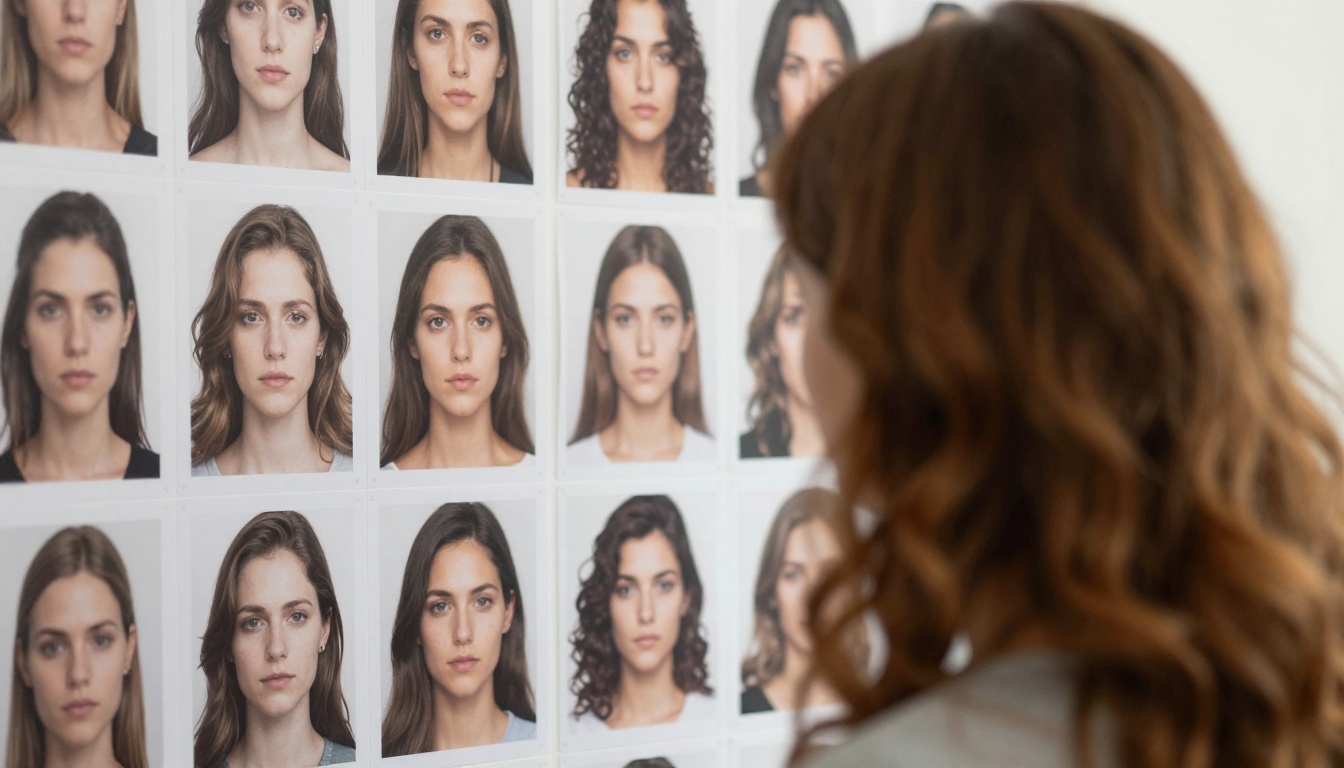
المشكلة ليست في جعل الذكاء الاصطناعي يولّد شخصاً جميلاً. هذا الجزء أصبح سهلاً تقريباً اليوم. التحدي الحقيقي هو أن يظهر الشخص نفسه في المشهد التالي، وفي المشهد الذي يليه، دون أن يتغيّر شكل أنفه، أو يتبدّل لون عينيه، أو يتحوّل وجهه بتدرّج خفي إلى شخص آخر تماماً. هذه هي المشكلة الجوهرية في ثبات شخصيات الذكاء الاصطناعي في الفيديوهات، وقد أعاقت توظيف المحتوى المولَّد بالذكاء الاصطناعي توظيفاً حقيقياً في سرد القصص والتسويق وإنتاج الأفلام.
لماذا يصعب الحفاظ على ثبات الشخصيات
تولّد نماذج انتشار الفيديو الإطارات بالتتابع، لكنها لا "تتذكر" بشكل طبيعي كيف كانت الشخصية تبدو قبل ثلاث ثوانٍ. يُنشأ كل إطار بناءً على احتمالات، لا على ذاكرة. والنتيجة هي ما يُعرف باسم مشكلة الوجه المرتعش: خلال بضع ثوانٍ، يتغيّر خط الفك، وتنزاح العينان قليلاً، وما كان يُفترض أن يكون شخصاً واحداً يتحوّل إلى ضبابية مخيفة تمزج عدداً من الأشخاص المختلفين.
مشكلة الوجه المرتعش
يحدث ذلك لأن نماذج تحويل النص إلى فيديو القياسية دُرِّبت على إنتاج مشاهد مقنعة بصرياً، لا على الحفاظ على هوية فرد بعينه. عندما تكتب الأمر النصي "امرأة تمشي في حديقة"، يستمد النموذج من آلاف الوجوه المختلفة التي رآها في بيانات التدريب. وبدون مرجع ثابت، لا يوجد ما يخبره بأن الوجه في الإطار 47 يجب أن يطابق الإطار 12.
💡 انزياح هوية الشخصية من أكثر نقاط الفشل شيوعاً في فيديو الذكاء الاصطناعي. حتى مقطع مدته 3 ثوانٍ قد يُظهر تغيّرات خفية في عرض الأنف، أو لون البشرة، أو المسافة بين العينين، ما لم يكن النموذج مصمماً خصيصاً لمنع ذلك.
ما الذي ينكسر بين الإطارات
تسبب عدة عوامل انزياح الشخصية في فيديو الذكاء الاصطناعي:
- غياب تكييف الهوية: لا يملك النموذج تمثيلاً صريحاً لوجه الشخصية يرجع إليه
- تباين الفضاء الكامن: تتراكم التغيّرات العشوائية الصغيرة في عملية أخذ العينات بالانتشار مع الوقت
- تغيّرات الإضاءة: حتى التحولات الطفيفة في الإضاءة المحاكاة قد تغيّر بنية الوجه
- انتقالات زاوية الكاميرا: الانتقال من منظر أمامي إلى منظر ثلاثي الأرباع يجبر النموذج على إعادة بناء ملامح لم يرها قط لتلك الشخصية بتلك الزاوية
- نقاط القطع في الفيديوهات الأطول: كل توليد جديد لمقطع يعيد ضبط السياق، فيمحو أي تمثيل متراكم للوجه
التقنية وراء تثبيت الشخصية
تستخدم نماذج الفيديو الحديثة بالذكاء الاصطناعي عدة استراتيجيات تقنية مختلفة لحل هذه المشكلة. وفهم هذه الاستراتيجيات يوضح لك الكثير عن سبب تفوّق بعض النماذج على غيرها في المحتوى الذي تغلب عليه الشخصيات.
التكييف القائم على المرجع
الحل الأكثر مباشرة هو منح النموذج صورة مرجعية للشخصية قبل بدء التوليد. تُرمَّز هذه الصورة داخل طبقات الانتباه في النموذج، فتقول عملياً لكل إطار: "يجب أن يبدو الوجه هكذا". نماذج تحويل الصورة إلى فيديو مثل Wan 2.6 I2V و Wan 2.5 I2V مبنية بالكامل على هذا المبدأ. تزوّدها بصورة ثابتة، فيحرّكها النموذج مع الرجوع المستمر إلى الوجه الأصلي.
المزية هنا قوية. أما العيب فهو أنك مقيّد بالوضعية والإضاءة الموجودتين في صورة المرجع. والابتعاد كثيراً عن المرجع يُثقل آلية الثبات.
كيف يثبّت LoRA الهوية
يضبط تدريب LoRA (Low-Rank Adaptation) نموذجاً أساسياً بدقة على مجموعة صغيرة من صور شخص أو شخصية معينة. فبدلاً من إعادة تدريب النموذج بالكامل، يُدخل LoRA مجموعة خفيفة من المعاملات تُوجّه النموذج نحو هوية بعينها. وعند تطبيقه على توليد الفيديو، يعمل LoRA الخاص بالشخصية كإشارة هوية دائمة عبر كل الإطارات المولّدة.
هذا النهج قوي لإنشاء شخصيات خيالية أصلية لا تملك مرجعاً من الواقع. تدرّب LoRA على رسومات مفاهيمية أو على أولى الصور المولّدة، ثم تستخدمه لتوليد تسلسلات فيديو تبدو فيها الشخصية ثابتة عبر المشاهد.
الانتباه الزمني في انتشار الفيديو
يتضمن الحل المعماري الأعمق آليات الانتباه الزمني. في محولات انتشار الفيديو، يتيح الانتباه الزمني لكل إطار أن ينظر إلى الإطارات المجاورة أثناء التوليد. وهذا يخلق شكلاً من الذاكرة البصرية قصيرة المدى، تؤثر فيها الإطارات في بعضها البعض في الاتجاهين.
تستخدم نماذج مثل Kling v3 Video وSeedance 2.0 بنى انتباه زمني متقدمة تنقل ميزات الهوية عبر مدة المقطع كاملة، لا عبر الإطارات المجاورة فقط. والنتيجة شخصية تحافظ على تماسكها حتى مع الحركة المعقدة.
💡 كلما طال المقطع المولَّد، صار الثبات أصعب. قد يحافظ مقطع مدته 3 ثوانٍ على ثبات شبه مثالي. أما مقطع مدته 10 ثوانٍ بالجودة نفسها فيحتاج إلى دعم معماري أكبر بكثير.
تحويل الصورة إلى فيديو مقابل تحويل النص إلى فيديو للشخصيات
لهذا التمييز أهمية كبيرة عندما يكون الهدف هو ثبات الشخصية.
البدء من وجه تتحكم فيه
يمنحك تحويل الصورة إلى فيديو أكثر المسارات مباشرة نحو شخصية ثابتة. تنشئ الوجه المحدد الذي تريده في صورة ثابتة أو تجده، ثم تحرّكه. يُقيَّد النموذج بهذا الوجه منذ الإطار الأول. ومن النماذج المصممة لهذا السير العمل Wan 2.2 I2V Fast وKling v2.1.
يتناسب سير العمل هذا بشكل طبيعي مع تحويل النص إلى صورة عالي الجودة. تستخدم نموذجاً لإنشاء صورة مرجعية مثالية لشخصيتك، ثم تغذّي بها نموذج تحويل الصورة إلى فيديو لتحريكها.
| الطريقة | مستوى الثبات | المرونة | الأفضل لـ |
|---|
| تحويل الصورة إلى فيديو (I2V) | عالٍ جداً | متوسطة | تحريك شخصية محددة |
| تحويل النص إلى فيديو (T2V) بأمر نصي | منخفض إلى متوسط | عالية | مشاهد عامة دون شخصية ثابتة |
| نماذج الأفاتار أو المدفوعة بالوجه | شبه مثالي | منخفضة | أشخاص حقيقيون أو أفاتارات جاهزة |
| فيديو بتكييف LoRA | عالٍ | عالية | شخصيات خيالية أصلية |
عندما يعجز النص وحده
يُعد توليد الفيديو بالنص وحده الخيار الأضعف للحفاظ على ثبات الشخصية. مهما كان أمرك النصي مفصلاً، لا يملك النموذج طريقة لتحديد الوجه الدقيق من بين ملايين الوجوه المحتملة في بيانات تدريبه. مقطعان بأمر نصي "امرأة شابة بشعر بني داكن ترتدي سترة حمراء" سينتجان شخصين مختلفين في الغالب كل مرة تقريباً.
الاستثناء هو حين تُصمَّم النماذج صراحةً بميزات أمر نصي على مستوى الشخصية، كما يحاول Kling v3 Omni Video أن يفعل. ومع ذلك، حتى في هذه الحالة، تتفوق صورة المرجع دائماً تقريباً على الوصف النصي الخالص في الحفاظ على هوية محددة.
نماذج تحافظ فعلاً على الشخصية
ليست كل أدوات فيديو الذكاء الاصطناعي متساوية في هذا الجانب. إليك النماذج التي يكون فيها ثبات الشخصية قوياً حقاً.
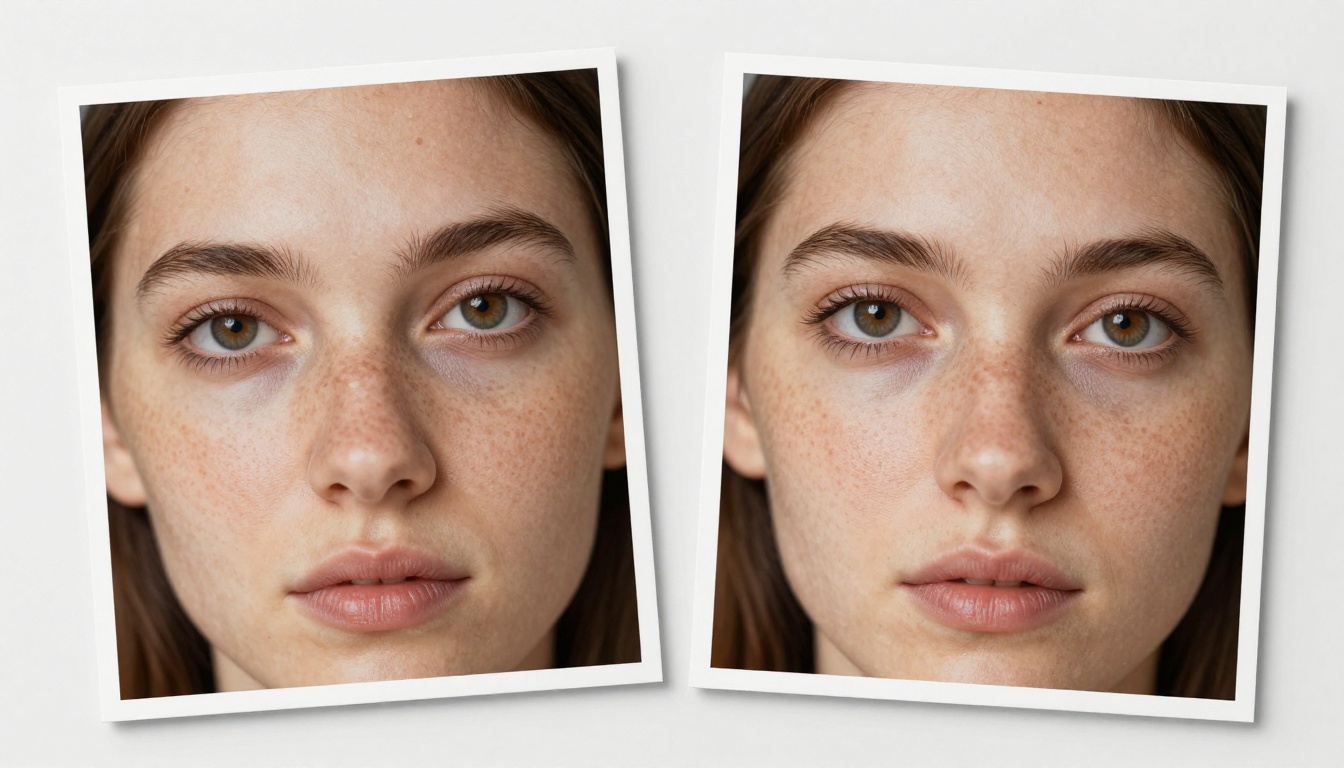
Kling Avatar v2
صُمم Kling Avatar v2 خصيصاً لتحريك الفيديو المدفوع بالوجه. تزوّده بصورة شخصية، فيولّد النموذج حركة تُبقي الوجه ثابتاً عبر المقطع كله. ويتعامل مع دوران الرأس والتعابير الخفيفة وتغيّرات الإضاءة بشكل أفضل من معظم نماذج الفيديو ذات الاستخدام العام.
الميزة المعمارية الأساسية هي التكييف المثبَّت على الوجه، حيث يُحافَظ على تضمين الهوية المأخوذ من الصورة الشخصية المدخلة بوزن مرتفع طوال عملية التوليد. وهذا يختلف عن نماذج I2V العامة التي تتعامل مع الصورة المدخلة كمرساة للمشهد كله، لا تعزل الوجه بوصفه القيد الأساسي.
Dreamactor M2.0 للتحكم في الوضعية
يتبع Dreamactor M2.0 من ByteDance نهجاً مختلفاً. فهو يفصل المظهر (كيف تبدو الشخصية) عن الحركة (كيف تتحرك). تزوّده بصورة مرجعية للمظهر، وبتسلسل حركة أو هيكل وضعية للحركة. وهذا الفصل قوي لأنه يعني أنك تستطيع إعادة استخدام الشخصية نفسها عبر تسلسلات حركية مختلفة تماماً دون إعادة توليدها.
هذا هو النموذج الذي تلجأ إليه حين تحتاج إلى أن تمشي الشخصية أو تومئ أو ترقص مع بقائها تشبه مرجعك بدقة. يثبت الوجه لأن طبقة التحكم في الحركة لا تمس ترميز الهوية أبداً.
عائلة Wan I2V وسلسلة Animate
تقدم عائلة نماذج Wan إصدارات متعددة من I2V مناسبة لعمل الشخصيات. يُنتج Wan 2.6 I2V تحريكات عالية الجودة من الصور الشخصية. لكن الأكثر إثارة للاهتمام في السرد القصصي المعتمد على الشخصيات هو Wan 2.2 Animate Replace وWan 2.2 Animate Animation، واللذان يتيحان لك نسخ أنماط الحركة على شخصيتك، أو استبدال الشخصيات في تسلسلات فيديو موجودة.
💡 في المشاريع متعددة المشاهد، تتيح سلسلة Wan Animate إعادة استخدام مرجع شخصية واحد عبر سيناريوهات فيديو كثيرة، مع الحفاظ على الهوية البصرية حتى عندما يتغير المكان تماماً.
Kling v2.6 و v3 للجودة السينمائية
يمثل Kling v2.6 وKling v3 Video أحدث ما وصلت إليه الجودة السينمائية للفيديو مع ثبات قوي للشخصية. تتعامل هذه النماذج مع الحركة المعقدة والمقاطع الأطول وسيناريوهات الإضاءة الصعبة، مع الحفاظ على استقرار الوجوه.
يضيف Kling v3 Motion Control طبقة إضافية: تحديد دقيق لحركة الكاميرا والشخصية، فلا تكتفي بإبقاء الشخصية ثابتة، بل تتحكم أيضاً في طريقة تحرّك المشهد من حولها.
Veo 3 وGen 4.5 وHailuo 2.3
يحقق Veo 3 من Google ثباتاً قوياً داخل المقطع الواحد بفضل تدريبه واسع النطاق وبنيته للتماسك الزمني. يركّز Gen 4.5 من Runway على الحركة السينمائية مع الأشخاص في المشهد ثابتين إلى حد معقول. ويتعامل Hailuo 2.3 من Minimax مع الرسوم المتحركة التي تتصدرها الوجوه بثبات وجه جيد بشكل خاص بدقة 1080p.
| النموذج | نوع الشخصية | الثبات | أفضل حالة استخدام |
|---|
| Kling Avatar v2 | مثبتة على الوجه | ★★★★★ | رؤوس المتحدثين، تحريك البورتريه |
| Dreamactor M2.0 | المظهر + الحركة | ★★★★★ | تحريك الشخصية بالجسم كاملاً |
| Wan 2.6 I2V | قائم على الصورة | ★★★★☆ | تحريك الشخصيات بشكل عام |
| Kling v3 Video | نص أو صورة | ★★★★☆ | المشاهد السينمائية |
| Veo 3 | قائم على النص | ★★★☆☆ | ثبات داخل مقطع واحد |
| Gen 4.5 | قائم على النص | ★★★☆☆ | تسلسلات الحركة السينمائية |
كيفية استخدام Kling Avatar v2 على PicassoIA
يُعد Kling Avatar v2 من أسهل الأدوات المتاحة للفيديو المحافظ على ثبات الشخصية على PicassoIA. إليك كيفية استخدامه لتحقيق أفضل النتائج.
الخطوة 1: جهّز صورة المرجع الشخصية
صورة المرجع هي كل شيء. استخدم بورتريهاً واضحاً يواجه الكاميرا أو مائلاً قليلاً بثلاثة أرباع، مع مراعاة ما يلي:
- إضاءة متساوية ومحايدة دون ظلال حادة على الوجه
- دقة عالية (512 بكسل على الأقل في أقصر ضلع)
- خلفية بسيطة أو ضبابية بنعومة
- أن يشغل الوجه 40% على الأقل من الإطار
إذا لم تكن لديك صورة حقيقية تستخدمها، فولّد واحدة أولاً باستخدام أي نموذج لتوليد الصور من النص على PicassoIA. كلما ارتفعت جودة مرجعك، صارت الشخصية الناتجة أكثر ثباتاً.
الخطوة 2: اكتب أمراً نصياً للحركة
يجب أن يصف أمرك النصي ما الذي تفعله الشخصية، لا من هي. يعرف Kling Avatar v2 بالفعل من هي الشخصية من صورة المرجع. ركّز على:
- نوع الحركة: "تدير رأسها ببطء نحو اليسار"، "تبتسم بدفء"، "تتحدث إلى الكاميرا"
- إضاءة المكان إن كانت مهمة: "ضوء نهار داخلي ناعم"، "ضوء شموع مسائي"
- سلوك الكاميرا: "كاميرا ثابتة"، "اقتراب بطيء"
أمر ضعيف: "امرأة جميلة ذات شعر بني داكن وعينين بنيتين ترتدي بلوزة كريمية"
أمر جيد: "تدير رأسها ببطء نحو الكاميرا بابتسامة لطيفة، وضوء بعد الظهر الناعم يأتي من النافذة اليسرى"
الخطوة 3: اضبط المدة والدقة
في عمل الشخصيات، تميل المقاطع القصيرة التي تتراوح بين 3 و5 ثوانٍ إلى إنتاج ثبات أعلى من المقاطع الأطول. وإذا احتجت إلى 10 ثوانٍ أو أكثر من الشخصية نفسها، فولّد عدة مقاطع من 5 ثوانٍ ثم ادمجها لاحقاً في المونتاج.
اختر دقة 1080p للنتيجة النهائية، أو 720p لتكرار أسرع أثناء الاختبار.
الخطوة 4: تحقق من الوجه
قبل استخدام المقطع في أي مشروع، تحقق من:
إذا انحرف أي من هذه العناصر، فقلّل شدة الحركة في أمرك النصي، أو جرّب صورة مرجعية مختلفة قليلاً بإضاءة أنظف.
ما الذي يظل يسير على نحو خاطئ
حتى مع أفضل النماذج وسير العمل، لا يزال ثبات الشخصية في فيديو الذكاء الاصطناعي مشكلة غير محلولة بالكامل. هذه أنماط الفشل التي ينبغي أن تستعد لها.
تغيّرات الإضاءة تكسر الوجوه
السبب الأكثر شيوعاً لفشل الثبات في منتصف المقطع هو تحول حاد في الإضاءة. عندما يحاكي النموذج مصدر ضوء يتحرك، أو ينتقل من داخل المكان إلى خارجه، يجب إعادة بناء الوجه تحت ظروف إضاءة جديدة. وهنا بالضبط قد تنزاح ملامح الهوية.
الحل: حافظ على ثبات ظروف الإضاءة في أمرك النصي. وإذا احتجت إلى انتقال في الإضاءة، فأنشئ مقطعين منفصلين بإضاءتين مختلفتين وانتقل بينهما بالقطع، بدلاً من محاولة توليد الانتقال داخل مقطع واحد.
قطعات متعددة، الشخصية نفسها
توليد شخصيتك في المشهد A والمشهد B كمقطعين منفصلين ينتج تقريباً دائماً نسختين مختلفتين قليلاً من الشخص نفسه. وهذا أكبر تحدٍ لم يُحلّ بعد في إنتاج فيديو الذكاء الاصطناعي. فالنماذج لا تتشارك الحالة بين عمليات التوليد المنفصلة.
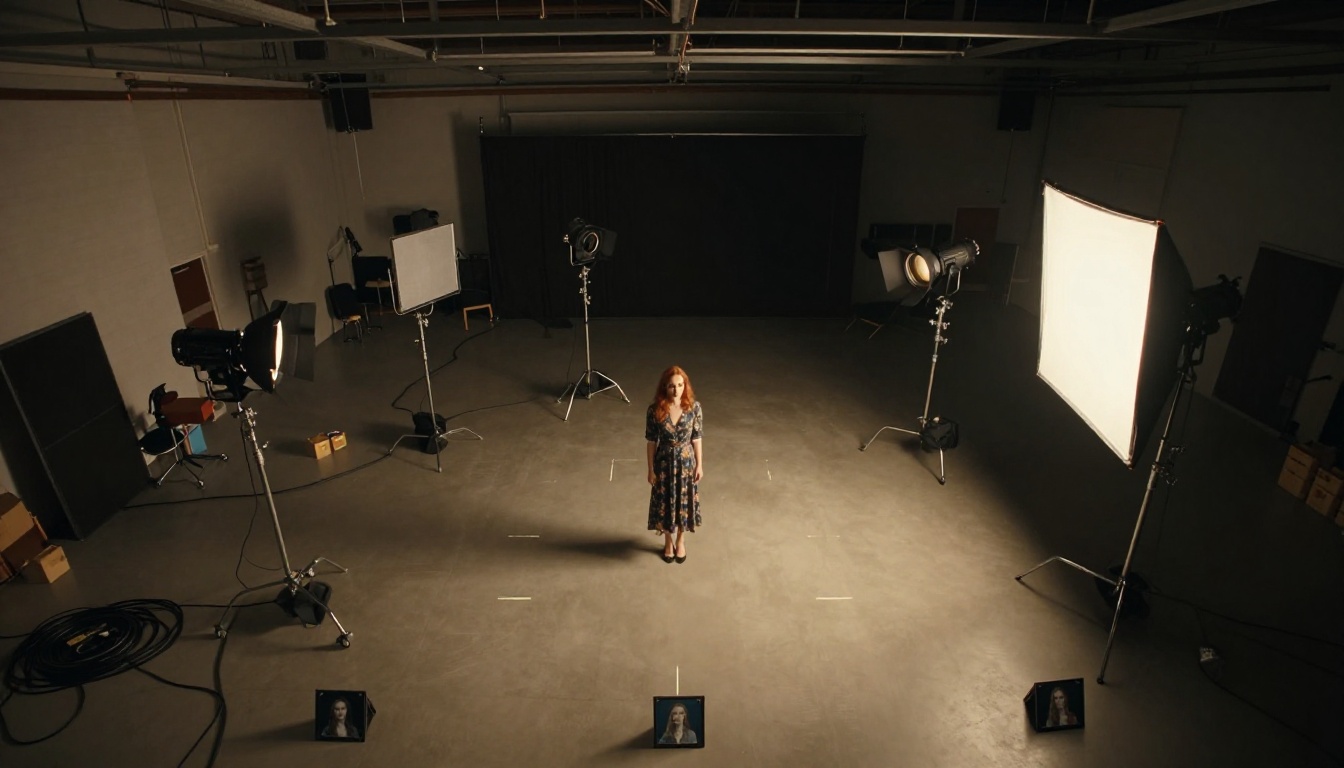
الحل: أنشئ ورقة مرجعية محكمة ومضبوطة تضم زوايا متعددة لشخصيتك (أمامي، وجه جانبي أيسر، وجه جانبي أيمن، وزاوية علوية خفيفة)، جميعها مصورة تحت الإضاءة نفسها. استخدم صورة المرجع نفسها في كل توليد، وحافظ على اتساق أوامرك النصية من حيث الأسلوب.
💡 يحتفظ بعض صناع المحتوى بما يسمّونه "كتاب الشخصية"، وهو مجلد صغير من صور المرجع مأخوذة من جلسة تصوير موحّدة واحدة، ويغذّون بها كل توليد للحفاظ على هوية الشخصية عبر المقاطع.
الإكسسوارات والتفاصيل تتشتت
تختفي الأقراط. تتغير أشكال القلادات. تبهت الوشوم أو تتكاثر. التفاصيل الصغيرة هي أول ما يضيع في فيديو الذكاء الاصطناعي، لأنها تتطلب من النموذج الحفاظ على معلومات عالية التردد عبر الحركة. والإبقاء على الإكسسوارات بسيطة في صورة المرجع يحسّن الثبات الكلي بشكل مباشر.
ابدأ في إنشاء فيديوهاتك الخاصة بشخصيات ثابتة
لم يعد ثبات الشخصية عائقاً مقصوراً على الاستوديوهات ذات الميزانيات الضخمة وأشهر من عمل المؤثرات البصرية. فالأدوات المتاحة اليوم، من Kling Avatar v2 إلى Dreamactor M2.0 إلى عائلة Wan I2V الكاملة، تجعل إنشاء محتوى فيديو متعدد المشاهد بشخصية ثابتة بصرياً ممكناً في ظهيرة واحدة.
سير العمل بسيط: ابدأ بصورة مرجعية قوية للشخصية، واختر نموذج I2V أو الأفاتار المناسب لحالتك، وأبقِ أوامرك النصية مركزة على الحركة لا على المظهر، ثم ولّد مقاطع قصيرة تجمعها لاحقاً في مرحلة ما بعد الإنتاج. كل واحد من هذه النماذج متاح مباشرة على PicassoIA، دون الحاجة إلى عتاد محلي أو إعداد معقد.
اختر شخصيتك. أعطها وجهاً. ضعها في حركة.
جرّب Kling Avatar v2، أو Dreamactor M2.0، أو Wan 2.6 I2V على PicassoIA اليوم، وشاهد إلى أي مدى تطورت الشخصيات المتسقة في الذكاء الاصطناعي.


