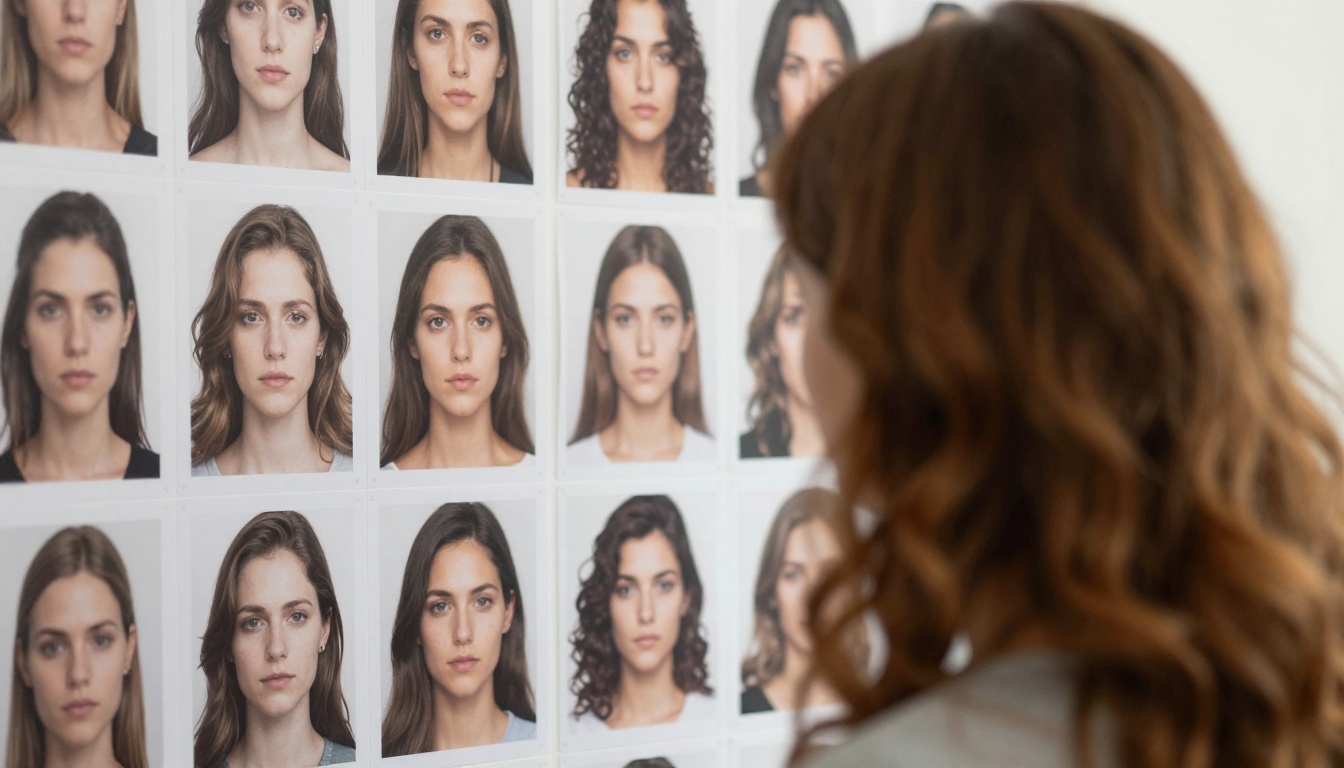
El problema no es que la IA genere a una persona bonita. Eso ya es casi demasiado fácil. El verdadero reto es que esa misma persona aparezca en el siguiente plano, y en el que viene después, sin que su nariz cambie de forma, sin que el color de sus ojos varíe o sin que todo su rostro se transforme poco a poco en otra persona. Este es el problema central de la coherencia de personajes en videos con IA, y ha impedido que el contenido generado por IA sea realmente útil para contar historias, hacer marketing y producir cine.
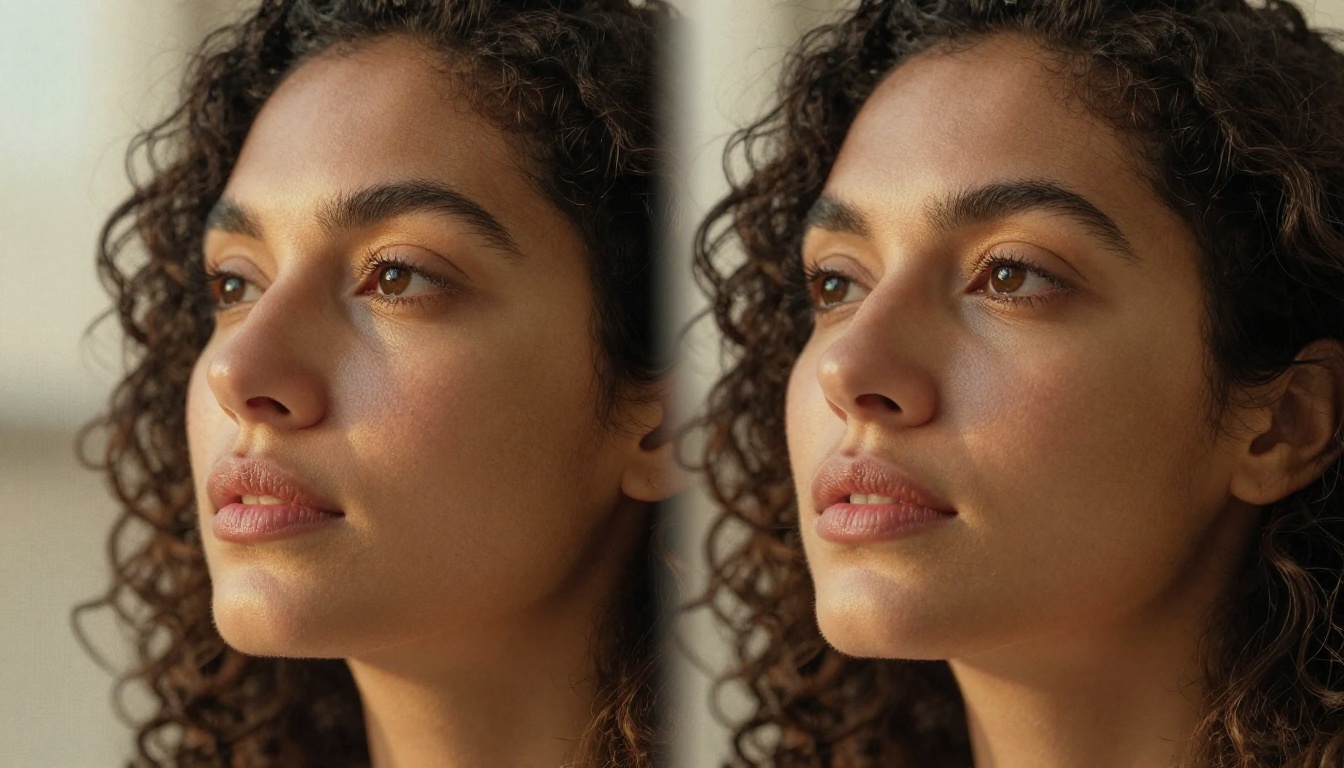
Por qué los personajes coherentes son tan difíciles
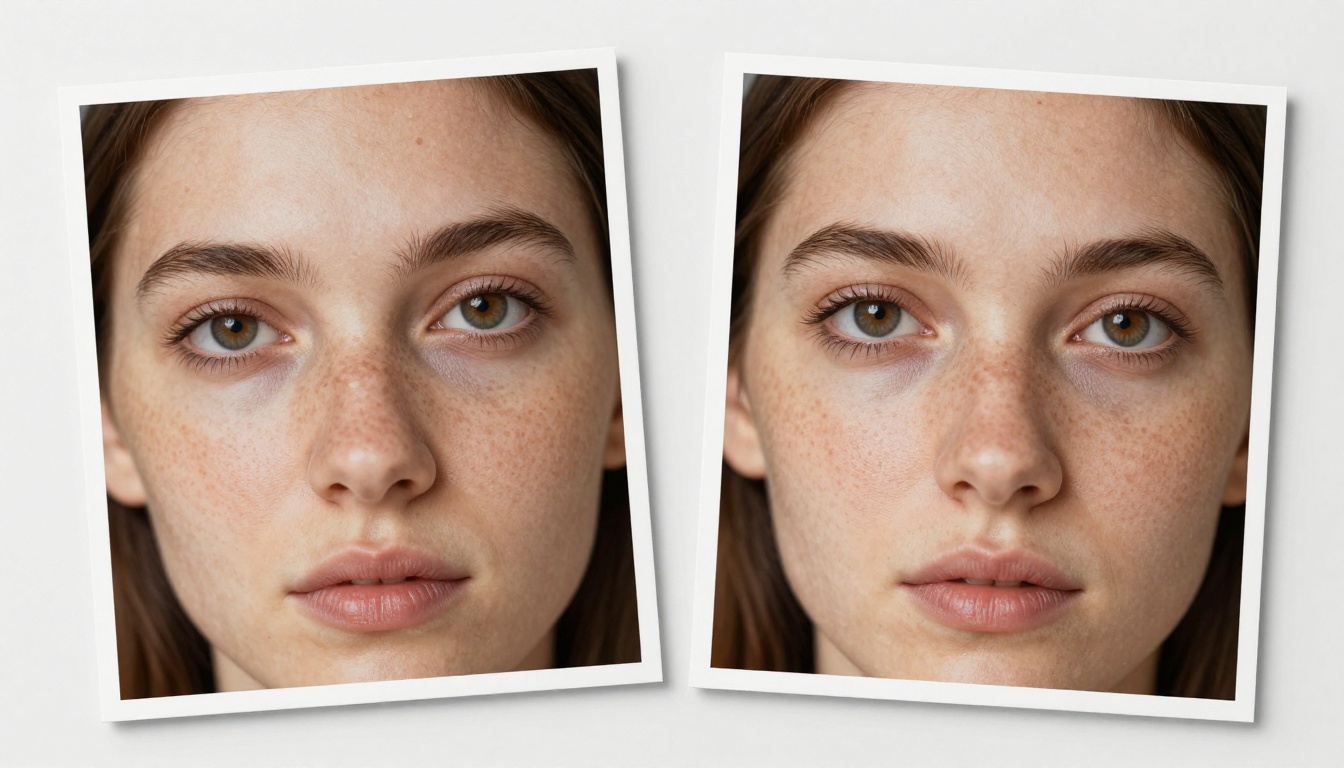
Los modelos de difusión de video generan los fotogramas en secuencia, pero no "recuerdan" de forma natural cómo era un personaje hace tres segundos. Cada fotograma se sintetiza a partir de probabilidades, no de memoria. El resultado es el llamado problema del rostro parpadeante: en apenas unos segundos, la mandíbula del personaje se desplaza, sus ojos se desvían ligeramente y lo que debía ser una sola persona se convierte en un borrón extraño de una docena de personas mezcladas.
El problema del rostro parpadeante
Esto ocurre porque los modelos estándar de texto a video se entrenaron para producir escenas visualmente plausibles, no para preservar la identidad de un individuo concreto. Cuando escribes "una mujer caminando por un parque", el modelo toma rostros de los miles que vio durante el entrenamiento. Sin un ancla de referencia, nada le indica que el rostro del fotograma 47 debe coincidir con el del fotograma 12.
💡 La deriva de identidad del personaje es uno de los fallos más comunes en el video con IA. Incluso un clip de 3 segundos puede mostrar cambios sutiles en el ancho de la nariz, el tono de la piel o la separación de los ojos, a menos que el modelo esté diseñado específicamente para evitarlo.
Qué se rompe entre fotogramas
Varios factores provocan la deriva del personaje en el video con IA:
- Falta de condicionamiento de identidad: el modelo no tiene una representación explícita del rostro del personaje a la que volver
- Varianza en el espacio latente: las pequeñas variaciones aleatorias del proceso de muestreo de la difusión se acumulan con el tiempo
- Cambios de iluminación: incluso los ligeros cambios en la luz simulada pueden alterar la forma en que aparece estructuralmente un rostro
- Transiciones de ángulo de cámara: pasar de una vista frontal a una de tres cuartos obliga al modelo a reconstruir rasgos que nunca ha visto en ese ángulo para ese personaje
- Puntos de corte en videos largos: cada nueva generación de clip reinicia el contexto y borra cualquier representación facial acumulada
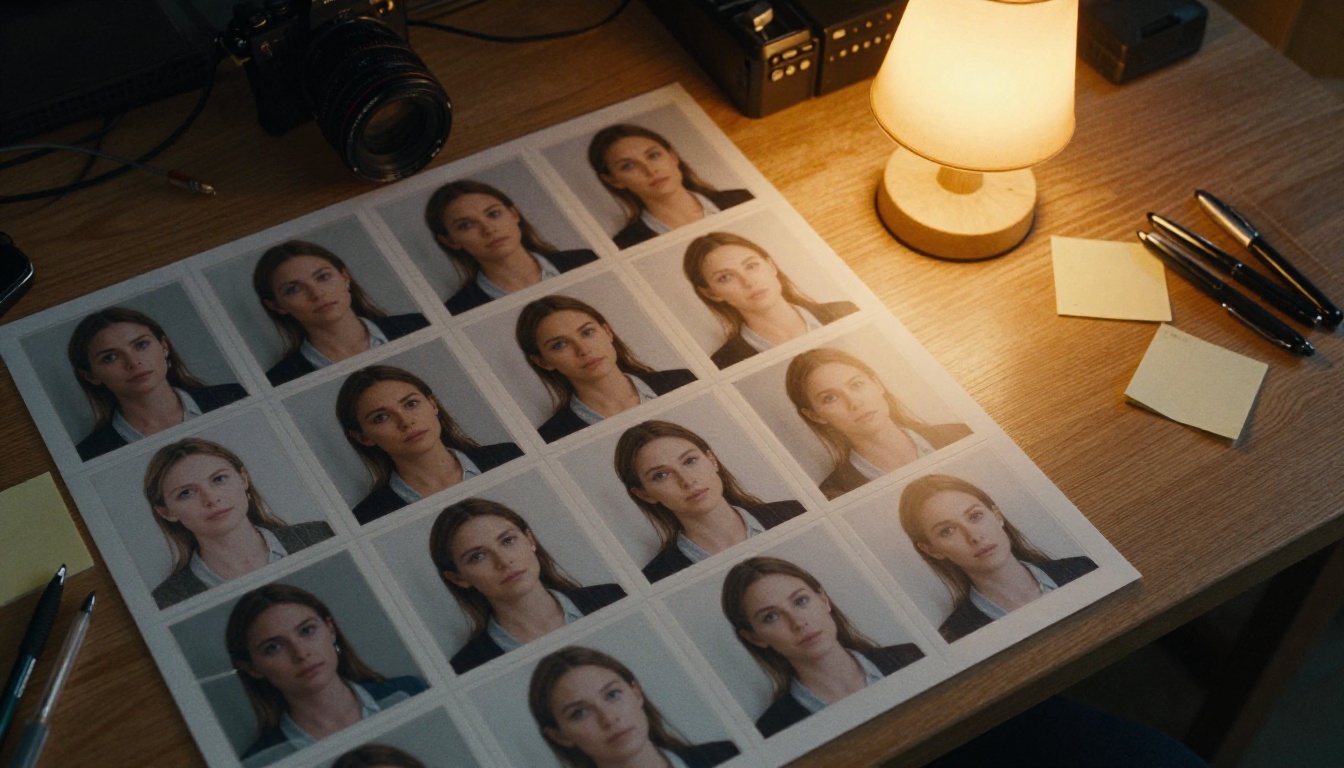
La tecnología detrás del bloqueo de personajes
Los modelos de video con IA modernos usan varias estrategias técnicas distintas para resolver este problema. Entender estas estrategias explica bastante bien por qué algunos modelos rinden mejor que otros con contenido centrado en personajes.
Condicionamiento basado en referencias
La solución más directa es darle al modelo una imagen de referencia del personaje antes de empezar a generar. Esta referencia se codifica en las capas de atención del modelo y, en esencia, le dice a cada fotograma: "el rostro debe parecerse a esto". Los modelos de imagen a video como Wan 2.6 I2V y Wan 2.5 I2V se basan por completo en este principio. Tú aportas una imagen fija y el modelo la anima mientras consulta continuamente ese rostro original.
La ventaja es grande. La desventaja es que quedas atado a la pose y la iluminación que tenga la imagen de referencia. Alejarse mucho de la referencia somete al mecanismo de coherencia a una fuerte tensión.
Cómo LoRA bloquea la identidad
El entrenamiento LoRA (Low-Rank Adaptation) ajusta un modelo base con un pequeño conjunto de imágenes de una persona o personaje concreto. En lugar de reentrenar todo el modelo, LoRA inyecta un conjunto ligero de parámetros que orientan el modelo hacia una identidad particular. Al aplicarlo a la generación de video, un LoRA de personaje actúa como una señal de identidad persistente en todos los fotogramas generados.
Este enfoque es muy potente para crear personajes de ficción originales sin ninguna referencia del mundo real. Entrenas el LoRA con arte conceptual o con renders iniciales y luego lo usas para generar secuencias de video en las que el personaje aparece estable en distintas escenas.
Atención temporal en la difusión de video
La solución arquitectónica más profunda son los mecanismos de atención temporal. En los transformadores de difusión de video, la atención temporal permite que cada fotograma consulte a los fotogramas vecinos durante la generación. Así se crea una forma de memoria visual a corto plazo en la que los fotogramas se influyen mutuamente en ambas direcciones.
Modelos como Kling v3 Video y Seedance 2.0 usan arquitecturas de atención temporal sofisticadas que propagan los rasgos de identidad a lo largo de toda la duración del clip, no solo entre fotogramas adyacentes. El resultado es un personaje que se mantiene íntegro incluso en movimientos complejos.
💡 Cuanto más largo es el clip generado, más difícil se vuelve la coherencia. Un clip de 3 segundos puede mantener una coherencia casi perfecta. Un clip de 10 segundos con la misma calidad requiere un soporte arquitectónico mucho mayor.
Imagen a video frente a texto a video para personajes
Esta distinción importa muchísimo cuando el objetivo es la coherencia del personaje.
Partir de un rostro que controlas
La imagen a video te ofrece el camino más directo hacia un personaje coherente. Creas o buscas el rostro exacto que quieres en una imagen fija y luego lo animas. El modelo se ciñe a ese rostro desde el primer fotograma. Entre los modelos diseñados para este flujo de trabajo están Wan 2.2 I2V Fast y Kling v2.1.
Este flujo combina de forma natural con la generación de imágenes de alta calidad a partir de texto. Usas un modelo para crear el retrato de referencia perfecto de tu personaje y luego lo introduces en un modelo de imagen a video para ponerlo en movimiento.
| Método | Nivel de coherencia | Flexibilidad | Mejor para |
|---|
| Imagen a video (I2V) | Muy alto | Media | Animar un personaje concreto |
| Texto a video (T2V) con prompt | Bajo-medio | Alta | Escenas generales, sin personaje fijo |
| Modelos de avatar o impulsados por rostro | Casi perfecto | Baja | Personas reales o avatares preconstruidos |
| Video con condicionamiento LoRA | Alto | Alta | Personajes de ficción originales |
Cuando solo el texto no basta
Escribir prompts de texto a video es el enfoque más débil para la coherencia de personajes. No importa lo detallado que sea tu prompt: el modelo no tiene forma de fijar cuál de los millones de rostros posibles de sus datos de entrenamiento debe usar. Dos clips con el prompt "una mujer joven morena con una chaqueta roja" producirán casi siempre dos personas distintas.
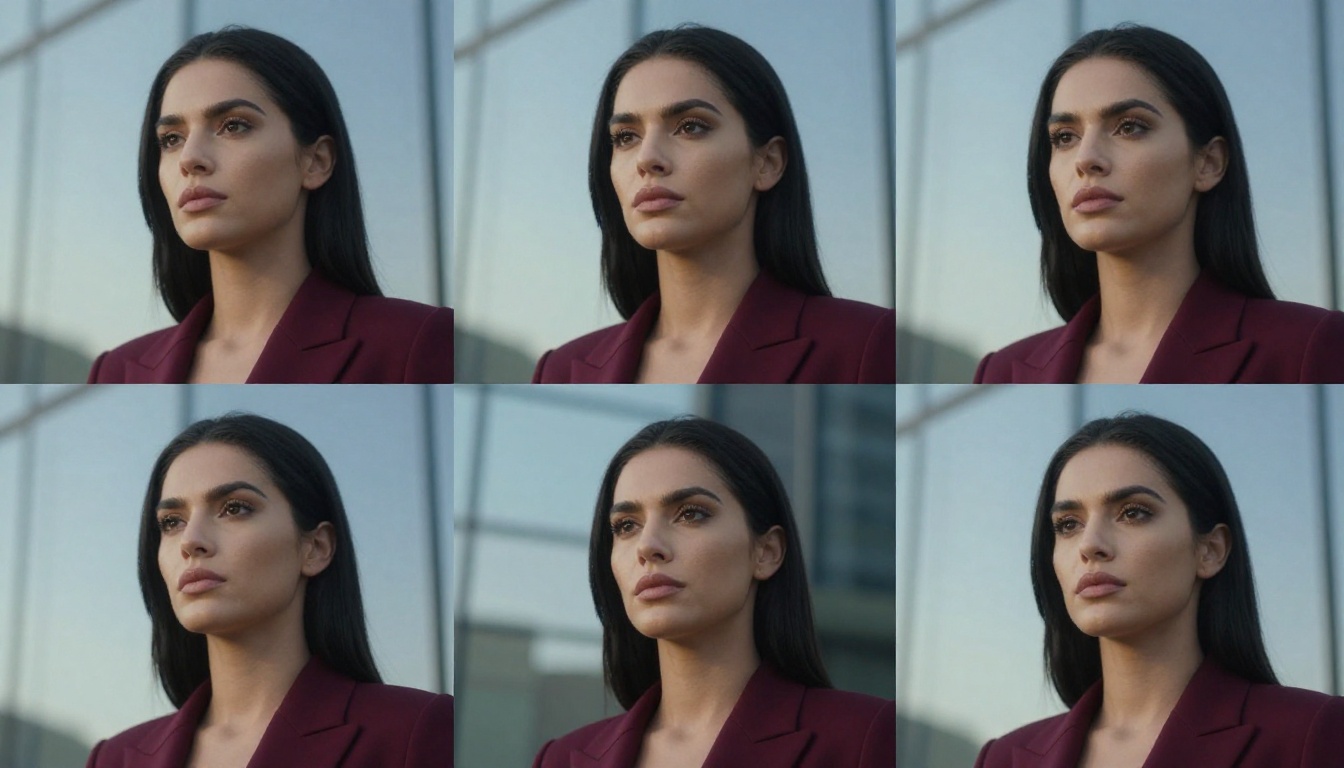
La excepción son los modelos diseñados explícitamente con funciones de prompting a nivel de personaje, como intenta Kling v3 Omni Video, pero incluso así, una imagen de referencia casi siempre supera a la descripción solo con texto para mantener una identidad concreta.
Modelos que de verdad mantienen a un personaje
No todo el video con IA es igual en esta dimensión. Estos son los modelos en los que la coherencia de personajes es realmente sólida.
Kling Avatar v2
Kling Avatar v2 está creado específicamente para la animación de video impulsada por rostros. Tú aportas un retrato y el modelo genera movimiento que mantiene ese rostro estable durante todo el clip. Maneja mejor que la mayoría de los modelos de video de uso general los giros de cabeza, las expresiones sutiles y los cambios de iluminación.
La característica arquitectónica clave es el condicionamiento de rostro bloqueado, en el que el embedding de identidad del retrato de entrada se mantiene con un peso alto durante todo el proceso de generación. Esto se diferencia de los modelos I2V generales, que tratan la imagen de entrada como un ancla de escena completa en lugar de aislar el rostro como la restricción principal.
Dreamactor M2.0 para el control de pose
Dreamactor M2.0 de ByteDance adopta un enfoque distinto. Separa la apariencia (a quién se parece el personaje) del movimiento (cómo se mueve). Tú aportas una imagen de referencia para la apariencia y una secuencia de movimiento o un esqueleto de pose para el movimiento. Este desacoplamiento es muy potente porque permite reutilizar el mismo personaje en secuencias de movimiento completamente distintas sin tener que regenerarlo.
Este es el modelo al que recurres cuando necesitas que un personaje camine, gesticule o baile pareciéndose exactamente a tu referencia. El rostro se mantiene porque la capa de control de movimiento nunca toca la codificación de identidad.
Wan I2V y la serie Animate
La familia Wan ofrece varias variantes de I2V adecuadas para trabajar con personajes. Wan 2.6 I2V produce animaciones de alta calidad a partir de retratos. Pero para las historias centradas en personajes resulta aún más interesante Wan 2.2 Animate Replace y Wan 2.2 Animate Animation, que te permiten copiar patrones de movimiento a tu personaje o sustituir personajes en secuencias de video existentes.
💡 En proyectos de varias escenas, la serie Wan Animate te permite reutilizar una sola referencia de personaje en muchos escenarios de video distintos, manteniendo la identidad visual coherente aunque el escenario cambie por completo.
Kling v2.6 y v3 para una calidad cinematográfica
Kling v2.6 y Kling v3 Video representan lo más avanzado en calidad de video cinematográfico con una coherencia de personajes sólida. Estos modelos manejan movimientos complejos, clips más largos y escenarios de iluminación difíciles, manteniendo los rostros estables.
Kling v3 Motion Control añade una capa más: la especificación precisa del movimiento de cámara y del personaje, de modo que no solo mantienes al personaje coherente, sino que también controlas cómo se mueve la escena a su alrededor.
Veo 3, Gen 4.5 e Hailuo 2.3
Veo 3 de Google logra una fuerte coherencia dentro del clip gracias a su entrenamiento a gran escala y a su arquitectura de coherencia temporal. Gen 4.5 de Runway pone el énfasis en el movimiento cinematográfico con sujetos razonablemente estables. Hailuo 2.3 de Minimax gestiona bien las animaciones centradas en retratos, con una estabilidad facial especialmente buena en resolución 1080p.
| Modelo | Tipo de personaje | Coherencia | Mejor caso de uso |
|---|
| Kling Avatar v2 | Anclado al rostro | ★★★★★ | Cabezas parlantes, animación de retratos |
| Dreamactor M2.0 | Apariencia + movimiento | ★★★★★ | Animación de personajes de cuerpo completo |
| Wan 2.6 I2V | Basado en imagen | ★★★★☆ | Animación general de personajes |
| Kling v3 Video | Texto o imagen | ★★★★☆ | Escenas cinematográficas |
| Veo 3 | Basado en texto | ★★★☆☆ | Coherencia en un solo clip |
| Gen 4.5 | Basado en texto | ★★★☆☆ | Secuencias de movimiento cinematográfico |
Cómo usar Kling Avatar v2 en PicassoIA
Kling Avatar v2 es una de las herramientas más accesibles para video con personajes coherentes en PicassoIA. Así se usa para obtener los mejores resultados.
Paso 1: prepara tu retrato de referencia
Tu imagen de referencia lo es todo. Usa un retrato claro, de frente o en tres cuartos leve, con:
- Iluminación uniforme y neutra, sin sombras duras sobre el rostro
- Alta resolución (al menos 512 px en el lado más corto)
- Un fondo liso o levemente desenfocado
- El rostro ocupando al menos el 40 % del encuadre
Si no tienes una foto real que usar, genera primero una con cualquier modelo de texto a imagen de PicassoIA. Cuanta más calidad tenga tu referencia, más estable será el personaje resultante.
Paso 2: escribe un prompt de movimiento
Tu prompt debe describir lo que hace el personaje, no quién es. Kling Avatar v2 ya sabe quién es gracias a la imagen de referencia. Céntrate en:
- Tipo de movimiento: "gira lentamente la cabeza a la izquierda", "sonríe con calidez", "habla a cámara"
- Iluminación del entorno si es relevante: "luz de día suave en interior", "luz de velas por la noche"
- Comportamiento de la cámara: "cámara fija", "acercamiento suave"
Prompt malo: "Una mujer morena y hermosa con ojos marrones y una blusa color crema"
Prompt bueno: "Gira lentamente la cabeza hacia la cámara con una sonrisa leve, luz de tarde suave desde la ventana de la izquierda"
Paso 3: define la duración y la resolución
Para el trabajo con personajes, los clips más cortos de 3 a 5 segundos suelen producir más coherencia que los clips largos. Si necesitas 10 segundos o más del mismo personaje, genera varios clips de 5 segundos y después móntalos juntos.
Selecciona la resolución 1080p para el resultado final o 720p para iterar más rápido durante las pruebas.
Paso 4: verifica el rostro
Antes de usar el clip en un proyecto, comprueba:
Si alguno de estos aspectos se desvía, reduce la intensidad del movimiento en tu prompt o prueba una imagen de referencia algo distinta con una iluminación más limpia.
Lo que aún sale mal
Incluso con los mejores modelos y flujos de trabajo, la coherencia de personajes en el video con IA no es un problema del todo resuelto. Estos son los patrones de fallo para los que conviene prepararse.
Los cambios de iluminación rompen los rostros
La causa más frecuente de fallo de coherencia a mitad de clip es un cambio de iluminación brusco. Cuando el modelo simula una fuente de luz que se mueve, o pasa de interior a exterior, el rostro debe reconstruirse con nuevas condiciones de luz. Es en esa reconstrucción donde los rasgos de identidad pueden desviarse.
Solución: mantén estables las condiciones de iluminación en tu prompt. Si necesitas una transición de luz, crea dos clips separados con iluminaciones distintas y haz el corte entre ellos en lugar de intentar generar la transición dentro de un solo clip.
Varios cortes, el mismo personaje
Generar a tu personaje en la escena A y en la escena B como clips separados casi siempre produce dos versiones ligeramente distintas de la misma persona. Este es el mayor reto sin resolver en la producción de video con IA. Los modelos no comparten estado entre generaciones independientes.
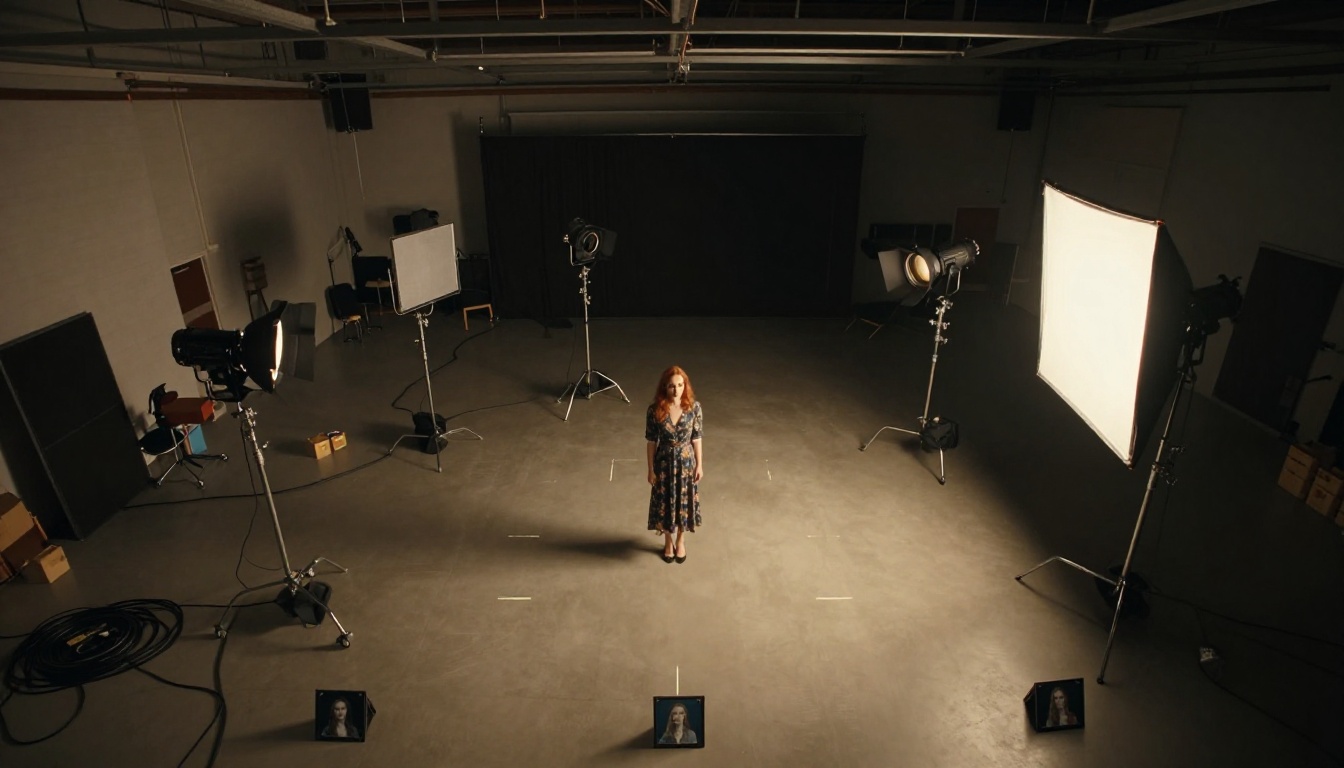
Solución: crea una hoja de referencia controlada y precisa con varios ángulos de tu personaje (frontal, perfil izquierdo, perfil derecho, ligero ángulo hacia arriba), todos fotografiados con la misma iluminación. Usa la misma imagen de referencia en cada generación y mantén tus prompts coherentes en cuanto al estilo.
💡 Algunos creadores mantienen una "biblia del personaje", una pequeña carpeta de imágenes de referencia de una sesión de fotos estandarizada, que introducen en cada generación para mantener la identidad entre clips.
Los accesorios y los detalles se desvían
Los pendientes desaparecen. Los collares cambian de forma. Los tatuajes se desvanecen o se multiplican. Los detalles pequeños son lo primero que se pierde en el video con IA, porque exigen que el modelo mantenga información de alta frecuencia durante el movimiento. Mantener los accesorios al mínimo en tu imagen de referencia mejora directamente la coherencia general.
Empieza a crear tus propios videos con personajes coherentes
La coherencia de personajes ya no es una barrera reservada a estudios con presupuestos enormes y meses de trabajo en VFX. Las herramientas disponibles hoy, desde Kling Avatar v2 hasta Dreamactor M2.0 y toda la familia Wan I2V, hacen posible crear contenido de video de varias escenas con un personaje visualmente coherente en una sola tarde.
El flujo de trabajo es sencillo: empieza con un retrato de referencia sólido, elige el modelo I2V o de avatar adecuado para tu caso, mantén tus prompts centrados en el movimiento y no en la apariencia y genera clips cortos que luego ensamblas en postproducción. Cada uno de estos modelos está disponible directamente en PicassoIA, sin necesidad de hardware local ni configuraciones complicadas.
Elige a tu personaje. Dale un rostro. Ponlo en movimiento.
Prueba Kling Avatar v2, Dreamactor M2.0 o Wan 2.6 I2V en PicassoIA hoy mismo y comprueba hasta dónde han llegado los personajes de IA coherentes.


