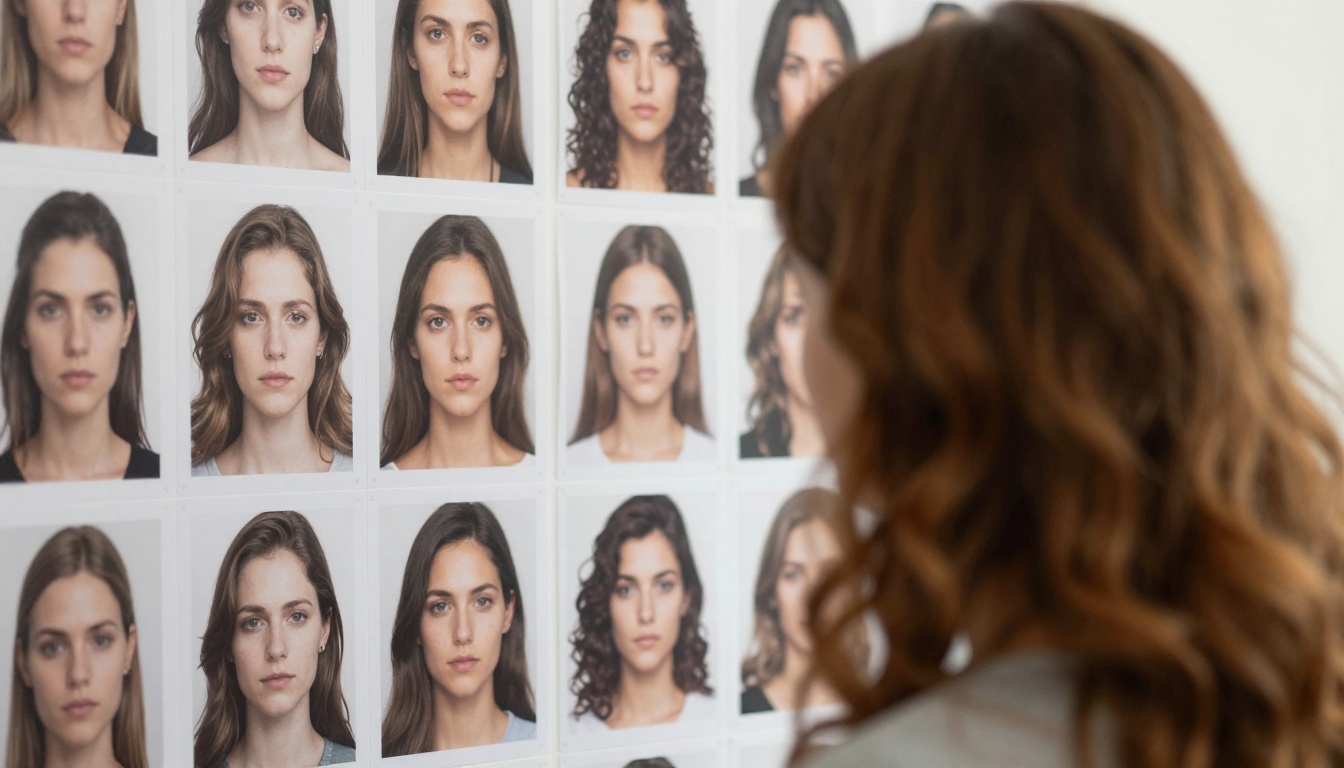
समस्या यह नहीं है कि AI से एक सुंदर इंसान बनवाया जाए। वह हिस्सा अब लगभग ज़रूरत से ज़्यादा आसान हो गया है। असली चुनौती यह है कि वही इंसान अगले शॉट में भी दिखे, और उसके बाद वाले शॉट में भी, बिना उसकी नाक का आकार बदले, बिना आँखों का रंग खिसके, और बिना उसका पूरा चेहरा धीरे-धीरे किसी और इंसान में बदले। यही वीडियो में AI कैरेक्टर कंसिस्टेंसी की मुख्य समस्या है, और इसी वजह से AI-जनरेटेड कंटेंट स्टोरीटेलिंग, मार्केटिंग और फ़िल्म प्रोडक्शन के लिए सच में उपयोगी नहीं बन पाया है।
कंसिस्टेंट कैरेक्टर इतने मुश्किल क्यों होते हैं
वीडियो डिफ्यूज़न मॉडल फ़्रेम एक के बाद एक क्रम में बनाते हैं, लेकिन उन्हें स्वाभाविक रूप से यह याद नहीं रहता कि कैरेक्टर तीन सेकंड पहले कैसा दिखता था। हर फ़्रेम संभावनाओं के आधार पर बनता है, याददाश्त के आधार पर नहीं। नतीजा वह तथाकथित फ़्लिकरिंग फ़ेस समस्या है: कुछ सेकंड में कैरेक्टर का जबड़ा खिसकता है, आँखें थोड़ी बदल जाती हैं, और जो एक इंसान होना था वह एक दर्जन अलग-अलग लोगों के मिश्रण जैसा अजीब धुंधलापन बन जाता है।
फ़्लिकरिंग फ़ेस समस्या
ऐसा इसलिए होता है क्योंकि स्टैंडर्ड टेक्स्ट-टू-वीडियो मॉडल को दृश्यात्मक रूप से विश्वसनीय सीन बनाने के लिए प्रशिक्षित किया गया था, किसी खास व्यक्ति की पहचान बचाने के लिए नहीं। जब आप "पार्क में चलती एक महिला" प्रॉम्प्ट देते हैं, तो मॉडल ट्रेनिंग में देखे गए हज़ारों अलग-अलग चेहरों से खींचता है। किसी रेफ़रेंस एंकर के बिना कुछ भी उसे नहीं बताता कि फ़्रेम 47 का चेहरा फ़्रेम 12 से मेल खाना चाहिए।
💡 कैरेक्टर आइडेंटिटी ड्रिफ़्ट AI वीडियो में विफलता के सबसे आम बिंदुओं में से एक है। तीन सेकंड की क्लिप में भी नाक की चौड़ाई, स्किन टोन या आँखों के बीच की दूरी में सूक्ष्म बदलाव दिख सकते हैं, जब तक मॉडल खास तौर पर इसे रोकने के लिए डिज़ाइन न किया गया हो।
फ़्रेम के बीच क्या बिगड़ता है
AI वीडियो में कैरेक्टर ड्रिफ़्ट कई कारणों से होता है:
- आइडेंटिटी कंडीशनिंग की कमी: मॉडल के पास कैरेक्टर के चेहरे का कोई स्पष्ट प्रतिनिधित्व नहीं होता जिसकी ओर वह लौट सके
- लेटेंट स्पेस में विचलन: डिफ्यूज़न सैंपलिंग प्रक्रिया में छोटे रैंडम बदलाव समय के साथ जमा होते जाते हैं
- लाइटिंग में बदलाव: सिमुलेटेड लाइटिंग में हल्का बदलाव भी चेहरे की संरचना को अलग दिखा सकता है
- कैमरा एंगल में बदलाव: फ़्रंटल से थ्री-क्वार्टर व्यू में जाने पर मॉडल को ऐसे फ़ीचर दोबारा बनाने पड़ते हैं जो उस कैरेक्टर के लिए उस एंगल पर उसने कभी देखे ही नहीं
- लंबे वीडियो में कट पॉइंट: हर नई क्लिप जनरेशन संदर्भ को रीसेट करती है, और जमा हुआ चेहरा-प्रतिनिधित्व मिट जाता है
कैरेक्टर लॉकिंग के पीछे की तकनीक
आधुनिक AI वीडियो मॉडल इस समस्या को हल करने के लिए कई अलग तकनीकी रणनीतियाँ इस्तेमाल करते हैं। इन रणनीतियों को समझने से पता चलता है कि कैरेक्टर-भारी कंटेंट पर कुछ मॉडल दूसरों से बेहतर क्यों चलते हैं।
रेफ़रेंस-आधारित कंडीशनिंग
सबसे सीधा समाधान है जनरेशन शुरू होने से पहले मॉडल को कैरेक्टर की रेफ़रेंस इमेज देना। यह रेफ़रेंस मॉडल की attention layers में एन्कोड हो जाता है, और मानो हर फ़्रेम से कहता है: "चेहरा ऐसा दिखना चाहिए।" Wan 2.6 I2V और Wan 2.5 I2V जैसे इमेज-टू-वीडियो मॉडल पूरी तरह इसी सिद्धांत पर बने हैं। आप एक स्थिर इमेज देते हैं, और मॉडल उस मूल चेहरे को लगातार देखते हुए उसे एनिमेट करता है।
फ़ायदा मज़बूत है। नुकसान यह है कि आप रेफ़रेंस इमेज में मौजूद पोज़ और लाइटिंग से बँधे रहते हैं। रेफ़रेंस से बहुत दूर जाने पर कंसिस्टेंसी मैकेनिज़्म पर दबाव पड़ता है।
LoRA पहचान को कैसे लॉक करता है
LoRA (Low-Rank Adaptation) ट्रेनिंग किसी खास व्यक्ति या कैरेक्टर की कुछ इमेज पर बेस मॉडल को फाइन-ट्यून करती है। पूरे मॉडल को दोबारा ट्रेन करने के बजाय, LoRA पैरामीटर का एक हल्का सेट जोड़ता है जो मॉडल को किसी खास पहचान की ओर झुकाता है। वीडियो जनरेशन में लागू होने पर, कैरेक्टर LoRA सभी जनरेट किए गए फ़्रेम में एक स्थायी पहचान संकेत की तरह काम करता है।
यह तरीका बिना किसी असली-दुनिया के रेफ़रेंस वाले मौलिक काल्पनिक कैरेक्टर बनाने में शक्तिशाली है। आप LoRA को कॉन्सेप्ट आर्ट या शुरुआती रेंडर पर ट्रेन करते हैं, और फिर उसी LoRA से ऐसे वीडियो सीक्वेंस बनाते हैं जिनमें कैरेक्टर अलग-अलग सीन में स्थिर दिखता है।
वीडियो डिफ्यूज़न में टेम्पोरल attention
सबसे गहरा आर्किटेक्चरल समाधान टेम्पोरल attention मैकेनिज़्म है। वीडियो डिफ्यूज़न ट्रांसफ़ॉर्मर में टेम्पोरल attention हर फ़्रेम को जनरेशन के दौरान पड़ोसी फ़्रेम देखने देता है। इससे एक तरह की शॉर्ट-टर्म विज़ुअल मेमोरी बनती है, जिसमें फ़्रेम एक-दूसरे को दोनों दिशाओं में प्रभावित करते हैं।
Kling v3 Video और Seedance 2.0 जैसे मॉडल जटिल टेम्पोरल attention आर्किटेक्चर इस्तेमाल करते हैं, जो पहचान-फ़ीचर को सिर्फ़ आस-पास के फ़्रेम में नहीं, बल्कि पूरी क्लिप की अवधि में आगे ले जाते हैं। नतीजा यह है कि कैरेक्टर जटिल मूवमेंट में भी एकजुट रहता है।
💡 वीडियो जितना लंबा, कंसिस्टेंसी उतनी ही कठिन। तीन सेकंड की क्लिप लगभग पूरी तरह कंसिस्टेंट रह सकती है। उसी क्वालिटी की दस सेकंड की क्लिप के लिए काफ़ी ज़्यादा आर्किटेक्चरल सपोर्ट चाहिए।
कैरेक्टर के लिए इमेज-टू-वीडियो बनाम टेक्स्ट-टू-वीडियो
कैरेक्टर कंसिस्टेंसी लक्ष्य हो तो यह अंतर बहुत मायने रखता है।
ऐसे चेहरे से शुरुआत जिसे आप नियंत्रित करते हैं
इमेज-टू-वीडियो कंसिस्टेंट कैरेक्टर का सबसे सीधा रास्ता देता है। आप एक स्थिर इमेज में वही चेहरा बनाते या खोजते हैं जो आपको चाहिए, फिर उसे एनिमेट करते हैं। मॉडल पहले फ़्रेम से ही उस चेहरे तक सीमित रहता है। इस वर्कफ़्लो के लिए बने मॉडलों में Wan 2.2 I2V Fast और Kling v2.1 शामिल हैं।
यह वर्कफ़्लो हाई-क्वालिटी टेक्स्ट-टू-इमेज जनरेशन के साथ स्वाभाविक रूप से जुड़ता है। आप एक मॉडल से अपने कैरेक्टर का परफ़ेक्ट रेफ़रेंस पोर्ट्रेट बनाते हैं, फिर उसे इमेज-टू-वीडियो मॉडल में डालकर उसे गति में लाते हैं।
| तरीका | कंसिस्टेंसी लेवल | लचीलापन | सबसे अच्छा किसके लिए |
|---|
| इमेज-टू-वीडियो (I2V) | बहुत उच्च | मध्यम | किसी खास कैरेक्टर को एनिमेट करना |
| प्रॉम्प्ट के साथ टेक्स्ट-टू-वीडियो (T2V) | कम-मध्यम | उच्च | सामान्य सीन, कोई तय कैरेक्टर नहीं |
| अवतार या चेहरा-संचालित मॉडल | लगभग परफ़ेक्ट | कम | असली व्यक्ति या पहले से बने अवतार |
| LoRA-कंडीशन्ड वीडियो | उच्च | उच्च | मौलिक काल्पनिक कैरेक्टर |
जब सिर्फ़ टेक्स्ट विफल होता है
कैरेक्टर कंसिस्टेंसी के लिए सिर्फ़ टेक्स्ट-टू-वीडियो प्रॉम्प्टिंग सबसे कमज़ोर तरीका है। प्रॉम्प्ट कितना भी विस्तृत हो, मॉडल के पास यह तय करने का कोई तरीका नहीं कि अपने ट्रेनिंग डेटा के लाखों संभावित चेहरों में से किसे इस्तेमाल करे। "लाल जैकेट में एक युवा ब्रुनेट महिला" प्रॉम्प्ट से बनी दो क्लिप लगभग हर बार दो अलग लोग दिखाएँगी।
अपवाद वह है जब मॉडल खास तौर पर कैरेक्टर-स्तर के प्रॉम्प्टिंग फ़ीचर के साथ डिज़ाइन किए गए हों, जैसा Kling v3 Omni Video करने की कोशिश करता है। फिर भी, किसी खास पहचान को बनाए रखने के लिए रेफ़रेंस इमेज लगभग हमेशा सिर्फ़ टेक्स्ट विवरण से बेहतर साबित होती है।
वे मॉडल जो असल में कैरेक्टर को बनाए रखते हैं
इस आयाम पर सभी वीडियो AI बराबर नहीं हैं। यहाँ वे मॉडल हैं जिनमें कैरेक्टर कंसिस्टेंसी सच में मज़बूत है।
Kling Avatar v2
Kling Avatar v2 खास तौर पर चेहरा-संचालित वीडियो एनिमेशन के लिए बना है। आप एक पोर्ट्रेट देते हैं, और मॉडल ऐसा मूवमेंट बनाता है जो पूरी क्लिप में उस चेहरे को स्थिर रखता है। यह सिर के मोड़, सूक्ष्म एक्सप्रेशन और लाइटिंग में बदलाव को ज़्यादातर सामान्य-उद्देश्य वीडियो मॉडल से बेहतर संभालता है।
मुख्य आर्किटेक्चरल फ़ीचर फ़ेस-लॉक्ड कंडीशनिंग है, जिसमें इनपुट पोर्ट्रेट का आइडेंटिटी एम्बेडिंग पूरी जनरेशन प्रक्रिया में उच्च वेट पर बना रहता है। यह सामान्य I2V मॉडलों से अलग है, जो इनपुट इमेज को पूरे सीन के एंकर की तरह लेते हैं, न कि चेहरे को मुख्य बाधा मानकर अलग करते हैं।
पोज़ कंट्रोल के लिए Dreamactor M2.0
Dreamactor M2.0 ByteDance से आता है और यह अलग तरीका अपनाता है। यह दिखावट (कैरेक्टर कैसा दिखता है) को मूवमेंट (वह कैसे चलता है) से अलग करता है। दिखावट के लिए आप एक रेफ़रेंस इमेज देते हैं, और मूवमेंट के लिए एक मोशन सीक्वेंस या पोज़ स्केलेटन। यह अलगाव शक्तिशाली है, क्योंकि इससे आप बिना दोबारा जनरेट किए एक ही कैरेक्टर को पूरी तरह अलग मोशन सीक्वेंस में दोबारा इस्तेमाल कर सकते हैं।
जब कैरेक्टर को रेफ़रेंस जैसा ही दिखते हुए चलना, इशारे करना या नाचना हो, तब आप इसी मॉडल तक पहुँचते हैं। चेहरा इसलिए टिकता है क्योंकि मोशन कंट्रोल लेयर कभी आइडेंटिटी एन्कोडिंग को छूती ही नहीं।
Wan I2V और Animate सीरीज़
Wan मॉडल परिवार कैरेक्टर वर्क के लिए कई I2V वर्ज़न देता है। Wan 2.6 I2V पोर्ट्रेट से हाई-क्वालिटी एनिमेशन बनाता है। लेकिन कैरेक्टर-संचालित स्टोरीटेलिंग के लिए और भी दिलचस्प हैं Wan 2.2 Animate Replace और Wan 2.2 Animate Animation, जो आपको अपने कैरेक्टर पर मोशन पैटर्न कॉपी करने या मौजूदा वीडियो सीक्वेंस में कैरेक्टर बदलने देते हैं।
💡 मल्टी-सीन प्रोजेक्ट के लिए Wan Animate सीरीज़ आपको एक ही कैरेक्टर रेफ़रेंस को कई अलग वीडियो परिदृश्यों में दोबारा इस्तेमाल करने देती है, और सेटिंग पूरी तरह बदलने पर भी विज़ुअल पहचान कंसिस्टेंट रहती है।
सिनेमैटिक क्वालिटी के लिए Kling v2.6 और v3
Kling v2.6 और Kling v3 Video मज़बूत कैरेक्टर कंसिस्टेंसी के साथ सिनेमैटिक वीडियो क्वालिटी में सबसे अत्याधुनिक हैं। ये मॉडल जटिल मूवमेंट, लंबी क्लिप और चुनौतीपूर्ण लाइटिंग स्थितियाँ संभालते हैं, और चेहरे को स्थिर रखते हैं।
Kling v3 Motion Control एक अतिरिक्त परत जोड़ता है: सटीक कैमरा और कैरेक्टर मूवमेंट का निर्देश, ताकि आप सिर्फ़ कैरेक्टर को कंसिस्टेंट न रखें, बल्कि यह भी नियंत्रित करें कि सीन उसके चारों ओर कैसे चलता है।
Veo 3, Gen 4.5 और Hailuo 2.3
Google का Veo 3 अपनी बड़े पैमाने की ट्रेनिंग और टेम्पोरल कोहेरेंस आर्किटेक्चर से क्लिप के भीतर मज़बूत कंसिस्टेंसी देता है। Runway का Gen 4.5 सिनेमैटिक मूवमेंट पर ज़ोर देता है, जिसमें सब्जेक्ट काफ़ी स्थिर रहते हैं। Minimax का Hailuo 2.3 पोर्ट्रेट-केंद्रित एनिमेशन को 1080p रेज़ोल्यूशन पर खास तौर पर अच्छी चेहरा स्थिरता के साथ संभालता है।
| मॉडल | कैरेक्टर प्रकार | कंसिस्टेंसी | सबसे अच्छा उपयोग |
|---|
| Kling Avatar v2 | चेहरा-एंकर्ड | ★★★★★ | टॉकिंग हेड्स, पोर्ट्रेट एनिमेशन |
| Dreamactor M2.0 | दिखावट + मूवमेंट | ★★★★★ | पूरे शरीर का कैरेक्टर एनिमेशन |
| Wan 2.6 I2V | इमेज-आधारित | ★★★★☆ | सामान्य कैरेक्टर एनिमेशन |
| Kling v3 Video | टेक्स्ट या इमेज | ★★★★☆ | सिनेमैटिक सीन |
| Veo 3 | टेक्स्ट-आधारित | ★★★☆☆ | सिंगल-क्लिप कंसिस्टेंसी |
| Gen 4.5 | टेक्स्ट-आधारित | ★★★☆☆ | सिनेमैटिक मूवमेंट सीक्वेंस |
PicassoIA पर Kling Avatar v2 कैसे इस्तेमाल करें
Kling Avatar v2 PicassoIA पर कैरेक्टर-कंसिस्टेंट वीडियो के लिए सबसे आसानी से उपलब्ध टूल्स में से एक है। सबसे अच्छे परिणामों के लिए इसे इस्तेमाल करने का तरीका यह है।
चरण 1: अपना रेफ़रेंस पोर्ट्रेट तैयार करें
आपकी रेफ़रेंस इमेज ही सब कुछ है। साफ़, सामने से या हल्के थ्री-क्वार्टर पोर्ट्रेट का उपयोग करें, जिसमें:
- चेहरे पर कठोर परछाइयों के बिना, समान और न्यूट्रल लाइटिंग हो
- उच्च रेज़ोल्यूशन हो (छोटी भुजा पर कम से कम 512px)
- सादा या हल्का धुंधला बैकग्राउंड हो
- चेहरा फ़्रेम के कम से कम 40% हिस्से में हो
अगर आपके पास इस्तेमाल करने के लिए असली फ़ोटो नहीं है, तो पहले PicassoIA पर किसी भी टेक्स्ट-टू-इमेज मॉडल से एक बना लें। रेफ़रेंस जितनी अच्छी क्वालिटी का होगा, आउटपुट कैरेक्टर उतना ही स्थिर होगा।
चरण 2: एक मोशन प्रॉम्प्ट लिखें
आपके प्रॉम्प्ट में यह बताया जाना चाहिए कि कैरेक्टर क्या करता है, न कि वह कौन है। Kling Avatar v2 रेफ़रेंस इमेज से पहले ही जानता है कि वह कौन है। इन पर ध्यान दें:
- मूवमेंट का प्रकार: "धीरे से सिर बाईं ओर मोड़ता है," "गर्मजोशी से मुस्कुराता है," "कैमरे की ओर बात करता है"
- प्रासंगिक हो तो एनवायरनमेंट लाइटिंग: "नरम इनडोर दिन की रोशनी," "शाम की मोमबत्ती की रोशनी"
- कैमरा व्यवहार: "स्थिर कैमरा," "हल्का पुश-इन"
खराब प्रॉम्प्ट: "क्रीम ब्लाउज़ में भूरी आँखों वाली एक खूबसूरत ब्रुनेट महिला"
अच्छा प्रॉम्प्ट: "धीरे से सिर कैमरे की ओर मोड़ती है, हल्की मुस्कान के साथ, बाईं खिड़की से आती नरम दोपहर की रोशनी"
चरण 3: अवधि और रेज़ोल्यूशन तय करें
कैरेक्टर वर्क के लिए 3 से 5 सेकंड की छोटी क्लिप आम तौर पर लंबी क्लिप से ज़्यादा कंसिस्टेंसी देती हैं। अगर आपको एक ही कैरेक्टर के 10 या अधिक सेकंड चाहिए, तो कई 5-सेकंड की क्लिप बनाएँ और बाद में उन्हें एडिट करके जोड़ें।
अंतिम आउटपुट के लिए 1080p रेज़ोल्यूशन चुनें, या टेस्टिंग के दौरान तेज़ इटरेशन के लिए 720p।
चरण 4: चेहरे की जाँच करें
प्रोजेक्ट में क्लिप इस्तेमाल करने से पहले जाँचें:
अगर इनमें से कोई भी बहकता है, तो प्रॉम्प्ट में मूवमेंट की तीव्रता घटाएँ, या थोड़ी अलग रेफ़रेंस इमेज आज़माएँ, जिसमें लाइटिंग ज़्यादा साफ़ हो।
अभी भी क्या गड़बड़ होता है
सबसे अच्छे मॉडल और वर्कफ़्लो के साथ भी, AI वीडियो में कैरेक्टर कंसिस्टेंसी पूरी तरह हल की गई समस्या नहीं है। ये वे विफलता पैटर्न हैं जिनके लिए आपको तैयार रहना चाहिए।
लाइटिंग में बदलाव चेहरों को तोड़ते हैं
क्लिप के बीच में कंसिस्टेंसी विफल होने का सबसे आम कारण नाटकीय लाइटिंग बदलाव है। जब मॉडल किसी चलती रोशनी के स्रोत को सिमुलेट करता है, या इनडोर से आउटडोर में बदलता है, तो चेहरे को नई लाइटिंग स्थितियों में दोबारा बनाना पड़ता है। यही दोबारा निर्माण वह जगह है जहाँ पहचान-फ़ीचर बहक सकते हैं।
समाधान: अपने प्रॉम्प्ट में लाइटिंग स्थितियाँ स्थिर रखें। अगर आपको लाइटिंग का बदलाव चाहिए, तो अलग-अलग लाइटिंग वाली दो क्लिप बनाएँ और उनके बीच कट करें, बजाय इसके कि एक ही क्लिप में ट्रांज़िशन बनाने की कोशिश करें।
कई कट, वही कैरेक्टर
अपने कैरेक्टर को सीन A और सीन B में अलग-अलग क्लिप के रूप में बनाने से लगभग हमेशा एक ही व्यक्ति के दो थोड़े अलग संस्करण बनते हैं। AI वीडियो प्रोडक्शन में यह अब तक की सबसे बड़ी अनसुलझी चुनौती है। अलग-अलग जनरेशन रन के बीच मॉडल कोई स्टेट साझा नहीं करते।
समाधान: अपने कैरेक्टर के कई एंगल (फ़्रंटल, बायाँ प्रोफ़ाइल, दायाँ प्रोफ़ाइल, थोड़ा ऊपर का एंगल) वाली एक सधी हुई, नियंत्रित रेफ़रेंस शीट बनाएँ, जिसकी सारी फ़ोटो एक जैसी लाइटिंग में ली गई हों। हर जनरेशन के लिए एक ही रेफ़रेंस इमेज इस्तेमाल करें और अपने प्रॉम्प्ट स्टाइल में भी एकरूपता रखें।
💡 कुछ क्रिएटर एक "कैरेक्टर बाइबल" रखते हैं, यानी एक मानकीकृत फ़ोटोशूट की रेफ़रेंस इमेज का छोटा फ़ोल्डर, जिसे वे हर जनरेशन में डालते हैं ताकि क्लिप-दर-क्लिप पहचान बनी रहे।
एक्सेसरीज़ और डिटेल्स भटकते हैं
झुमके गायब हो जाते हैं। हार का आकार बदल जाता है। टैटू फीके पड़ जाते हैं या अपने-आप दोहरे दिखने लगते हैं। AI वीडियो में छोटे डिटेल्स सबसे पहले बिगड़ जाते हैं, क्योंकि मूवमेंट के दौरान मॉडल को उच्च-फ़्रीक्वेंसी जानकारी बनाए रखनी पड़ती है। अपनी रेफ़रेंस इमेज में एक्सेसरीज़ कम रखने से समग्र कंसिस्टेंसी सीधे बेहतर होती है।
अपने कंसिस्टेंट कैरेक्टर वाले वीडियो बनाना शुरू करें
कैरेक्टर कंसिस्टेंसी अब उन स्टूडियो तक सीमित बाधा नहीं है जिनके पास भारी बजट और महीनों का VFX समय हो। आज उपलब्ध टूल्स, Kling Avatar v2 से लेकर Dreamactor M2.0 और पूरे Wan I2V परिवार तक, एक ही दोपहर में ऐसा मल्टी-सीन वीडियो कंटेंट बनाना संभव बनाते हैं जिसमें एक विज़ुअली कंसिस्टेंट कैरेक्टर हो।
वर्कफ़्लो सीधा है: एक मज़बूत रेफ़रेंस पोर्ट्रेट से शुरू करें, अपने उपयोग के लिए सही I2V या अवतार मॉडल चुनें, प्रॉम्प्ट को दिखावट के बजाय मूवमेंट पर केंद्रित रखें, और छोटी क्लिप जनरेट करें जिन्हें आप पोस्ट-प्रोडक्शन में जोड़ें। इनमें से हर मॉडल PicassoIA पर सीधे उपलब्ध है, बिना लोकल हार्डवेयर या जटिल सेटअप के।
अपना कैरेक्टर चुनें। उसे एक चेहरा दें। उसे गति में लाएँ।
आज ही PicassoIA पर Kling Avatar v2, Dreamactor M2.0 या Wan 2.6 I2V आज़माएँ, और देखें कि कंसिस्टेंट AI कैरेक्टर कितनी दूर तक पहुँच चुके हैं।


