Le problème n’est pas de faire générer à l’IA une belle personne. Cette étape est presque trop facile aujourd’hui. Le vrai défi consiste à faire réapparaître cette même personne dans le plan suivant, puis dans celui d’après, sans que son nez change de forme, que la couleur de ses yeux varie ou que son visage se transforme subtilement en celui de quelqu’un d’autre. C’est le problème central de la cohérence des personnages par IA dans les vidéos, et il a freiné l’usage réel des contenus générés par IA pour la narration, le marketing et la production cinématographique.
Pourquoi les personnages cohérents sont si difficiles à obtenir
Les modèles de diffusion vidéo génèrent les images en séquence, mais ils ne « se souviennent » pas naturellement de l’apparence d’un personnage il y a trois secondes. Chaque image est synthétisée à partir de probabilités, et non de mémoire. Il en résulte le phénomène dit du visage qui scintille : au fil de quelques secondes, la mâchoire d’un personnage se déplace, ses yeux dérivent légèrement et ce qui devait être une seule personne devient un flou troublant, mélange d’une douzaine d’individus différents.
Le problème du visage qui scintille
Cela vient du fait que les modèles texte vers vidéo classiques ont été entraînés à produire des scènes visuellement plausibles, et non à préserver l’identité d’un individu précis. Quand vous écrivez « une femme qui traverse un parc », le modèle puise dans les milliers de visages qu’il a vus pendant l’entraînement. Sans point d’ancrage de référence, rien ne lui indique que le visage de l’image 47 doit correspondre à celui de l’image 12.
💡 La dérive de l’identité du personnage est l’un des défauts les plus courants de la vidéo par IA. Même un clip de 3 secondes peut montrer de légers changements de largeur de nez, de teint ou d’écart entre les yeux, sauf si le modèle est spécifiquement conçu pour l’éviter.
Ce qui se dégrade entre les images
Plusieurs facteurs provoquent la dérive du personnage dans la vidéo par IA :
- Absence de conditionnement par l’identité : le modèle ne dispose d’aucune représentation explicite du visage du personnage vers laquelle revenir
- Variance de l’espace latent : de petites variations aléatoires dans le processus d’échantillonnage de la diffusion s’accumulent avec le temps
- Changements d’éclairage : même de légers décalages de la lumière simulée peuvent modifier la structure apparente d’un visage
- Transitions d’angle de caméra : passer d’une vue de face à une vue de trois quarts oblige le modèle à reconstruire des traits qu’il n’a jamais vus sous cet angle pour ce personnage
- Points de coupure dans les vidéos longues : chaque nouvelle génération de clip réinitialise le contexte et efface toute représentation du visage accumulée
La technologie derrière le verrouillage du personnage
Les modèles vidéo d’IA modernes recourent à plusieurs stratégies techniques distinctes pour résoudre ce problème. Comprendre ces stratégies permet de saisir pourquoi certains modèles font mieux que d’autres sur des contenus riches en personnages.
Conditionnement par image de référence
La solution la plus directe consiste à fournir au modèle une image de référence du personnage avant le début de la génération. Cette référence est encodée dans les couches d’attention du modèle, ce qui revient à dire à chaque image : « le visage doit ressembler à ceci ». Les modèles image vers vidéo comme Wan 2.6 I2V et Wan 2.5 I2V reposent entièrement sur ce principe. Vous fournissez une image fixe, et le modèle l’anime en se référant en permanence à ce visage d’origine.
L’avantage est réel. L’inconvénient, c’est que vous êtes lié à la pose et à l’éclairage présents sur l’image de référence. S’éloigner beaucoup de la référence met à rude épreuve le mécanisme de cohérence.
Comment le LoRA verrouille l’identité
L’entraînement LoRA (Low-Rank Adaptation) procède au fine-tuning d’un modèle de base sur un petit ensemble d’images d’une personne ou d’un personnage précis. Plutôt que de réentraîner l’ensemble du modèle, le LoRA injecte un jeu léger de paramètres qui oriente le modèle vers une identité particulière. Appliqué à la génération de vidéos, un LoRA de personnage agit comme un signal d’identité persistant sur toutes les images générées.
Cette approche est puissante pour créer des personnages de fiction originaux, sans référence réelle. Vous entraînez le LoRA sur des concept arts ou des rendus initiaux, puis vous utilisez ce LoRA pour générer des séquences vidéo où le personnage reste stable d’une scène à l’autre.
L’attention temporelle dans la diffusion vidéo
La solution architecturale la plus profonde repose sur les mécanismes d’attention temporelle. Dans les transformeurs de diffusion vidéo, l’attention temporelle permet à chaque image de consulter les images voisines pendant la génération. On obtient ainsi une forme de mémoire visuelle à court terme, où les images s’influencent mutuellement dans les deux sens.
Des modèles comme Kling v3 Video et Seedance 2.0 utilisent des architectures d’attention temporelle sophistiquées qui propagent les caractéristiques d’identité sur toute la durée du clip, et non pas seulement sur les images adjacentes. Le résultat est un personnage qui tient le coup, même dans des mouvements complexes.
💡 Plus le clip généré est long, plus la cohérence devient difficile. Un clip de 3 secondes peut conserver une cohérence quasi parfaite. Un clip de 10 secondes, à la même qualité, exige un soutien architectural nettement plus poussé.
Image vers vidéo ou texte vers vidéo pour les personnages
Cette distinction compte énormément quand la cohérence du personnage est l’objectif.
Partir d’un visage que vous maîtrisez
L’image vers vidéo offre la voie la plus directe vers un personnage cohérent. Vous créez ou trouvez le visage exact que vous voulez dans une image fixe, puis vous l’animez. Le modèle est contraint à ce visage dès la première image. Parmi les modèles conçus pour ce flux de travail, on trouve Wan 2.2 I2V Fast et Kling v2.1.
Ce flux se combine naturellement avec une génération d’images de haute qualité par texte vers image. Vous utilisez un modèle pour créer le portrait de référence parfait de votre personnage, puis vous le faites passer dans un modèle image vers vidéo pour le mettre en mouvement.
| Méthode | Niveau de cohérence | Flexibilité | Idéal pour |
|---|
| Image vers vidéo (I2V) | Très élevé | Moyenne | Animer un personnage précis |
| Texte vers vidéo (T2V) avec prompt | Faible à moyen | Élevée | Scènes générales, sans personnage fixe |
| Modèles d’avatar ou pilotés par le visage | Quasi parfait | Faible | Personnes réelles ou avatars préconçus |
| Vidéo conditionnée par LoRA | Élevé | Élevée | Personnages de fiction originaux |
Quand le texte seul ne suffit pas
Le prompt texte vers vidéo pur est l’approche la plus faible pour la cohérence des personnages. Quelle que soit la précision de votre prompt, le modèle n’a aucun moyen de déterminer lequel des millions de visages possibles de ses données d’entraînement il doit utiliser. Deux clips générés avec « une jeune femme brune en veste rouge » produiront presque à chaque fois deux personnes différentes.
L’exception concerne les modèles explicitement conçus avec des fonctions de prompt au niveau du personnage, comme le tente Kling v3 Omni Video. Mais même dans ce cas, une image de référence surpasse presque toujours une description textuelle pour conserver une identité précise.
Les modèles qui tiennent réellement un personnage
Toutes les IA vidéo ne se valent pas sur ce point. Voici les modèles dont la cohérence des personnages est réellement solide.
Kling Avatar v2
Kling Avatar v2 est conçu spécifiquement pour l’animation vidéo pilotée par le visage. Vous fournissez un portrait, et le modèle génère un mouvement qui garde ce visage stable sur tout le clip. Il gère mieux que la plupart des modèles vidéo généralistes les rotations de tête, les expressions subtiles et les changements d’éclairage.
La caractéristique architecturale clé est le conditionnement verrouillé sur le visage, où l’empreinte d’identité issue du portrait d’entrée est maintenue avec un poids élevé pendant toute la génération. Cela se distingue des modèles I2V généralistes, qui traitent l’image d’entrée comme un ancrage de scène complète plutôt que d’isoler le visage comme contrainte principale.
Dreamactor M2.0 pour le contrôle de la pose
Dreamactor M2.0 de ByteDance adopte une approche différente. Il sépare l’apparence (à quoi ressemble le personnage) du mouvement (comment il bouge). Vous fournissez une image de référence pour l’apparence, et une séquence de mouvement ou un squelette de pose pour le déplacement. Ce découplage est puissant, car il permet de réutiliser le même personnage dans des séquences de mouvement entièrement différentes, sans tout régénérer.
C’est le modèle à privilégier lorsqu’un personnage doit marcher, gesticuler ou danser tout en ressemblant précisément à votre référence. Le visage tient parce que la couche de contrôle du mouvement ne touche jamais à l’encodage de l’identité.
Wan I2V et la série Animate
La famille Wan propose plusieurs variantes I2V adaptées au travail sur les personnages. Wan 2.6 I2V produit des animations de haute qualité à partir de portraits. Mais ce qui est encore plus intéressant pour la narration centrée sur les personnages, ce sont Wan 2.2 Animate Replace et Wan 2.2 Animate Animation, qui permettent de transférer des schémas de mouvement sur votre personnage ou de remplacer des personnages dans des séquences vidéo existantes.
💡 Pour les projets multi-scènes, la série Wan Animate vous permet de réutiliser une seule référence de personnage dans de nombreux scénarios vidéo différents, en conservant une identité visuelle cohérente même lorsque le décor change complètement.
Kling v2.6 et v3 pour une qualité cinématographique
Kling v2.6 et Kling v3 Video représentent l’état de l’art en matière de qualité vidéo cinématographique, avec une forte cohérence des personnages. Ces modèles gèrent les mouvements complexes, les clips plus longs et les éclairages difficiles tout en gardant les visages stables.
Kling v3 Motion Control ajoute une couche supplémentaire : la spécification précise du mouvement de caméra et du personnage, de sorte que vous ne vous contentez pas de maintenir la cohérence du personnage, vous contrôlez aussi la façon dont la scène évolue autour de lui.
Veo 3, Gen 4.5 et Hailuo 2.3
Veo 3 de Google atteint une bonne cohérence à l’intérieur d’un clip grâce à son entraînement à grande échelle et à son architecture de cohérence temporelle. Gen 4.5 de Runway met l’accent sur le mouvement cinématographique avec des sujets raisonnablement stables. Hailuo 2.3 de Minimax gère particulièrement bien les animations centrées sur le portrait, avec une stabilité du visage remarquable en 1080p.
| Modèle | Type de personnage | Cohérence | Meilleur cas d’usage |
|---|
| Kling Avatar v2 | Ancré sur le visage | ★★★★★ | Têtes parlantes, animation de portrait |
| Dreamactor M2.0 | Apparence + mouvement | ★★★★★ | Animation de personnage en pied |
| Wan 2.6 I2V | Basé sur l’image | ★★★★☆ | Animation de personnage générale |
| Kling v3 Video | Texte ou image | ★★★★☆ | Scènes cinématographiques |
| Veo 3 | Basé sur le texte | ★★★☆☆ | Cohérence sur un seul clip |
| Gen 4.5 | Basé sur le texte | ★★★☆☆ | Séquences à mouvement cinématographique |
Kling Avatar v2 est l’un des outils les plus accessibles pour une vidéo à personnage cohérent sur PicassoIA. Voici comment l’utiliser pour obtenir les meilleurs résultats.
Étape 1 : préparer votre portrait de référence
Votre image de référence est déterminante. Utilisez un portrait net, de face ou légèrement en trois quarts, avec :
- Un éclairage uniforme et neutre, sans ombres marquées sur le visage
- Une haute résolution (au moins 512 px sur le petit côté)
- Un arrière-plan uni ou légèrement flouté
- Un visage occupant au moins 40 % du cadre
Si vous n’avez pas de photo réelle à utiliser, générez-en une d’abord avec n’importe quel modèle texte vers image disponible sur PicassoIA. Plus la qualité de votre référence est élevée, plus le personnage généré sera stable.
Étape 2 : rédiger un prompt de mouvement
Votre prompt doit décrire ce que fait le personnage, et non qui il est. Kling Avatar v2 connaît déjà son identité grâce à l’image de référence. Concentrez-vous sur :
- Le type de mouvement : « tourne lentement la tête vers la gauche », « sourit chaleureusement », « parle à la caméra »
- L’éclairage de l’environnement si nécessaire : « lumière douce de jour en intérieur », « lueur de bougie le soir »
- Le comportement de la caméra : « caméra fixe », « léger rapprochement progressif »
Mauvais prompt : « Une belle femme brune aux yeux marron, en chemisier crème »
Bon prompt : « Tourne lentement la tête vers la caméra avec un sourire doux, lumière douce de l’après-midi venant de la fenêtre à gauche »
Étape 3 : régler la durée et la résolution
Pour un travail sur les personnages, les clips courts de 3 à 5 secondes tendent à produire une meilleure cohérence que les clips plus longs. Si vous avez besoin de 10 secondes ou plus avec le même personnage, générez plusieurs clips de 5 secondes et montez-les ensuite.
Sélectionnez la résolution 1080p pour le résultat final, ou 720p pour itérer plus vite pendant les tests.
Étape 4 : vérifier le visage
Avant d’utiliser le clip dans un projet, vérifiez :
Si l’un de ces points dérive, réduisez l’intensité du mouvement dans votre prompt ou essayez une image de référence légèrement différente, avec un éclairage plus propre.
Ce qui pose encore problème
Même avec les meilleurs modèles et les meilleurs flux de travail, la cohérence des personnages dans la vidéo par IA n’est pas un problème entièrement résolu. Voici les schémas d’échec auxquels vous devez vous préparer.
Les changements d’éclairage déforment les visages
La cause la plus fréquente d’échec de cohérence au milieu d’un clip est un changement d’éclairage brutal. Quand le modèle simule une source lumineuse qui se déplace, ou passe de l’intérieur à l’extérieur, le visage doit être reconstruit sous de nouvelles conditions lumineuses. C’est cette reconstruction qui peut faire dériver les traits de l’identité.
Solution : gardez des conditions d’éclairage stables dans votre prompt. Si vous avez besoin d’une transition d’éclairage, créez deux clips distincts avec des lumières différentes et faites un raccord entre eux, plutôt que d’essayer de générer la transition dans un seul clip.
Plusieurs coupes, même personnage
Générer votre personnage dans la scène A et dans la scène B sous forme de clips séparés produit presque toujours deux versions légèrement différentes de la même personne. C’est le plus grand défi non résolu de la production vidéo par IA. Les modèles ne partagent pas d’état entre des générations séparées.
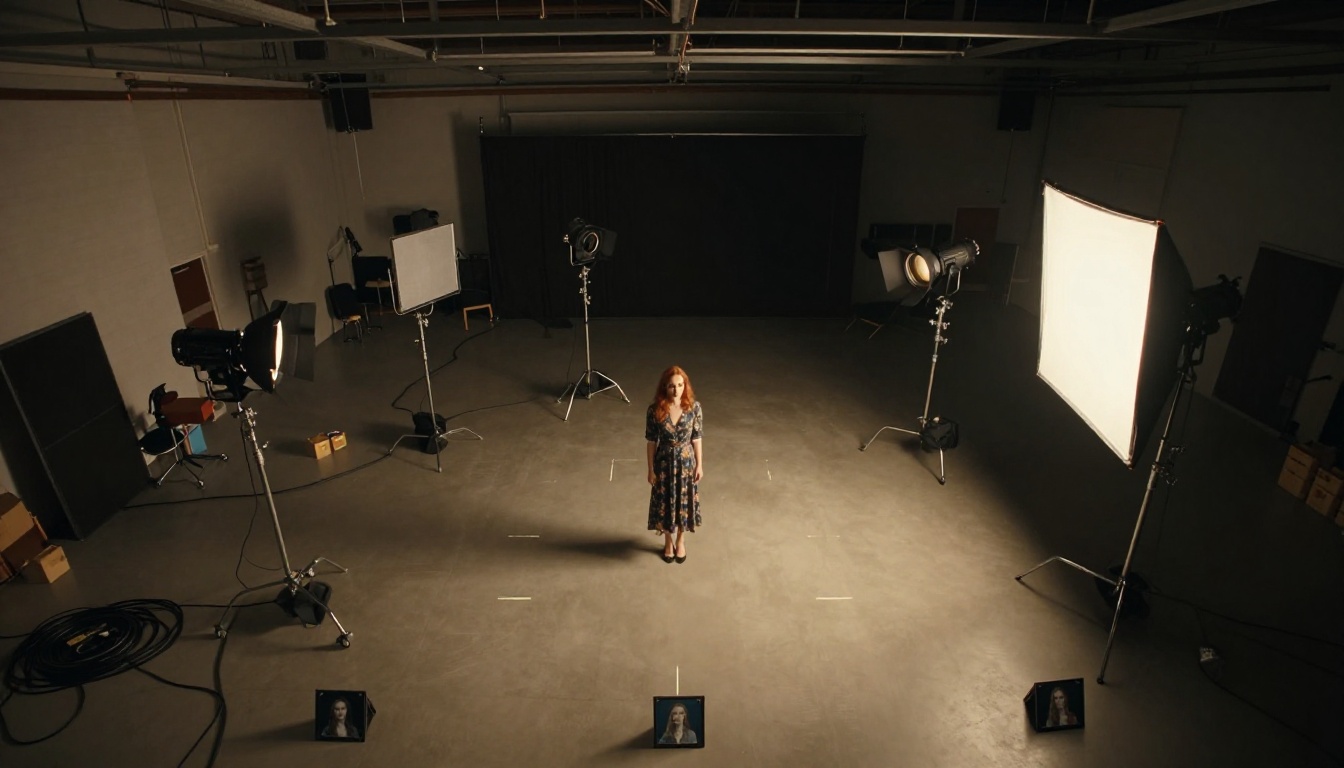
Solution : créez une planche de référence rigoureuse et maîtrisée, avec plusieurs angles de votre personnage (face, profil gauche, profil droit, léger angle vers le haut), tous photographiés sous le même éclairage. Utilisez la même image de référence pour chaque génération et gardez des prompts stylistiquement cohérents.
💡 Certains créateurs tiennent un « dossier du personnage », un petit ensemble d’images de référence issues d’une même séance photo standardisée, qu’ils injectent dans chaque génération pour maintenir l’identité d’un clip à l’autre.
Les accessoires et les détails dérivent
Les boucles d’oreilles disparaissent. Les colliers changent de forme. Les tatouages s’effacent ou se multiplient. Les petits détails sont les premiers à disparaître dans la vidéo par IA, car ils exigent que le modèle conserve une information à haute fréquence à travers le mouvement. Garder les accessoires minimaux sur votre image de référence améliore directement la cohérence globale.
Commencez à créer vos propres vidéos à personnage cohérent
La cohérence des personnages n’est plus un obstacle réservé aux studios disposant de budgets considérables et de mois de travail en effets visuels. Les outils disponibles aujourd’hui, de Kling Avatar v2 à Dreamactor M2.0 en passant par toute la famille Wan I2V, permettent de créer un contenu vidéo multi-scènes avec un personnage visuellement cohérent en un seul après-midi.
Le flux de travail est simple : partez d’un portrait de référence solide, choisissez le modèle I2V ou d’avatar adapté à votre usage, concentrez vos prompts sur le mouvement plutôt que sur l’apparence, puis générez de courts clips que vous assemblez en post-production. Chacun de ces modèles est disponible directement sur PicassoIA, sans matériel local ni configuration complexe.
Choisissez votre personnage. Donnez-lui un visage. Mettez-le en mouvement.
Essayez Kling Avatar v2, Dreamactor M2.0 ou Wan 2.6 I2V sur PicassoIA dès aujourd’hui, et voyez à quel point les personnages IA cohérents ont progressé.


