O problema não é fazer a IA gerar uma pessoa bonita. Essa parte hoje é quase fácil demais. O desafio real é fazer essa mesma pessoa aparecer na cena seguinte, e na que vem depois, sem que o nariz mude de formato, a cor dos olhos mude ou o rosto inteiro se transforme sutilmente em outra pessoa. Este é o problema central da consistência de personagens em vídeos com IA, e ele tem impedido que o conteúdo gerado por IA seja realmente útil para storytelling, marketing e produção de cinema.
Por que personagens consistentes são tão difíceis
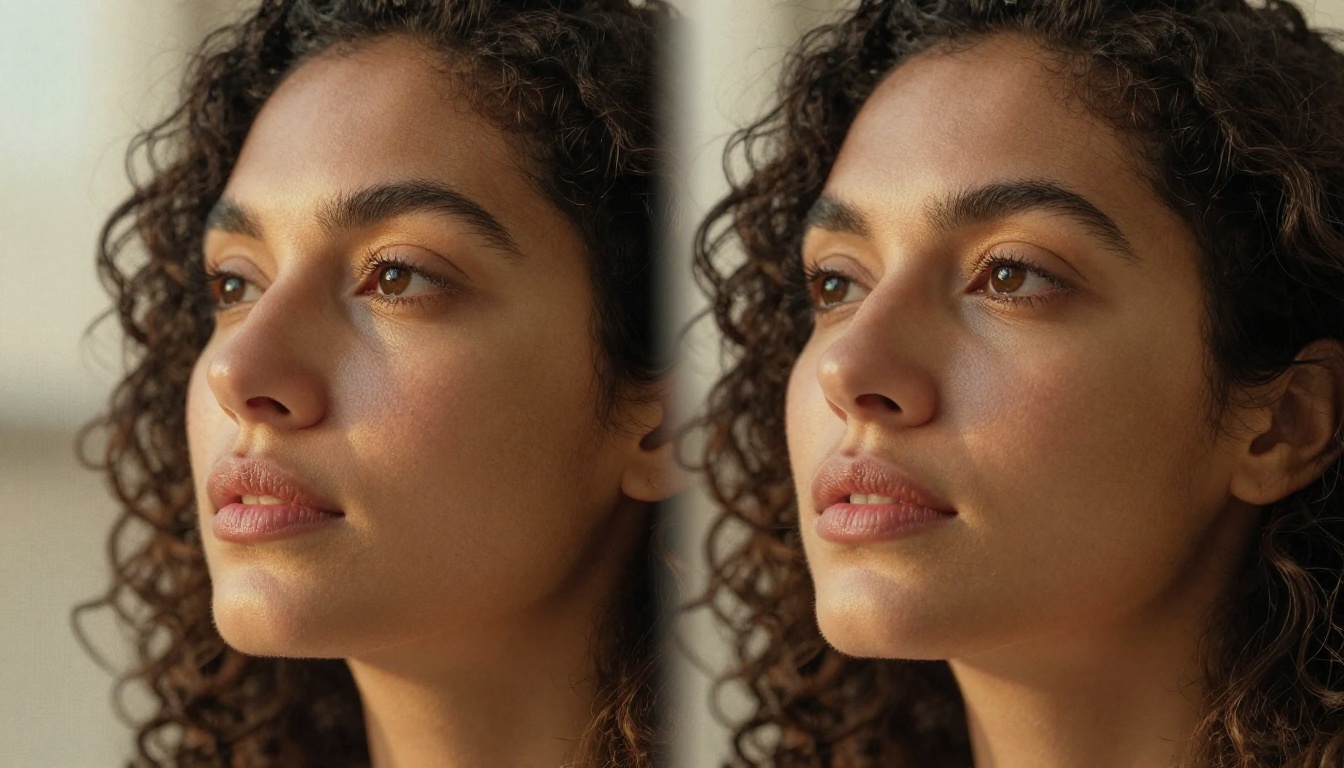
Os modelos de difusão de vídeo geram quadros em sequência, mas não "lembram" naturalmente como um personagem era três segundos antes. Cada quadro é sintetizado com base em probabilidades, não em memória. O resultado é o chamado problema do rosto que oscila: em poucos segundos, a linha da mandíbula do personagem muda, os olhos se deslocam levemente e o que deveria ser uma única pessoa vira um borrão estranho de várias pessoas misturadas.
O problema do rosto que oscila
Isso acontece porque os modelos padrão de texto para vídeo foram treinados para produzir cenas visualmente plausíveis, não para preservar a identidade de um indivíduo específico. Quando você escreve "uma mulher caminhando por um parque", o modelo recorre a milhares de rostos diferentes que viu no treinamento. Sem uma âncora de referência, nada indica a ele que o rosto do quadro 47 deve coincidir com o do quadro 12.
💡 A deriva de identidade do personagem é um dos pontos de falha mais comuns em vídeos com IA. Mesmo um clipe de 3 segundos pode mostrar mudanças sutis na largura do nariz, no tom de pele ou no espaçamento dos olhos, a menos que o modelo tenha sido projetado especificamente para evitar isso.
O que quebra entre os quadros
Vários fatores causam a deriva do personagem em vídeos com IA:
- Falta de condicionamento de identidade: o modelo não tem uma representação explícita do rosto do personagem para consultar
- Variância no espaço latente: pequenas variações aleatórias no processo de amostragem da difusão se acumulam com o tempo
- Mudanças de iluminação: mesmo pequenos ajustes na iluminação simulada podem alterar a estrutura aparente de um rosto
- Transições de ângulo de câmera: passar de uma visão frontal para uma de três quartos força o modelo a reconstruir traços que nunca viu naquele ângulo para aquele personagem
- Pontos de corte em vídeos longos: cada nova geração de clipe reinicia o contexto, apagando qualquer representação acumulada do rosto
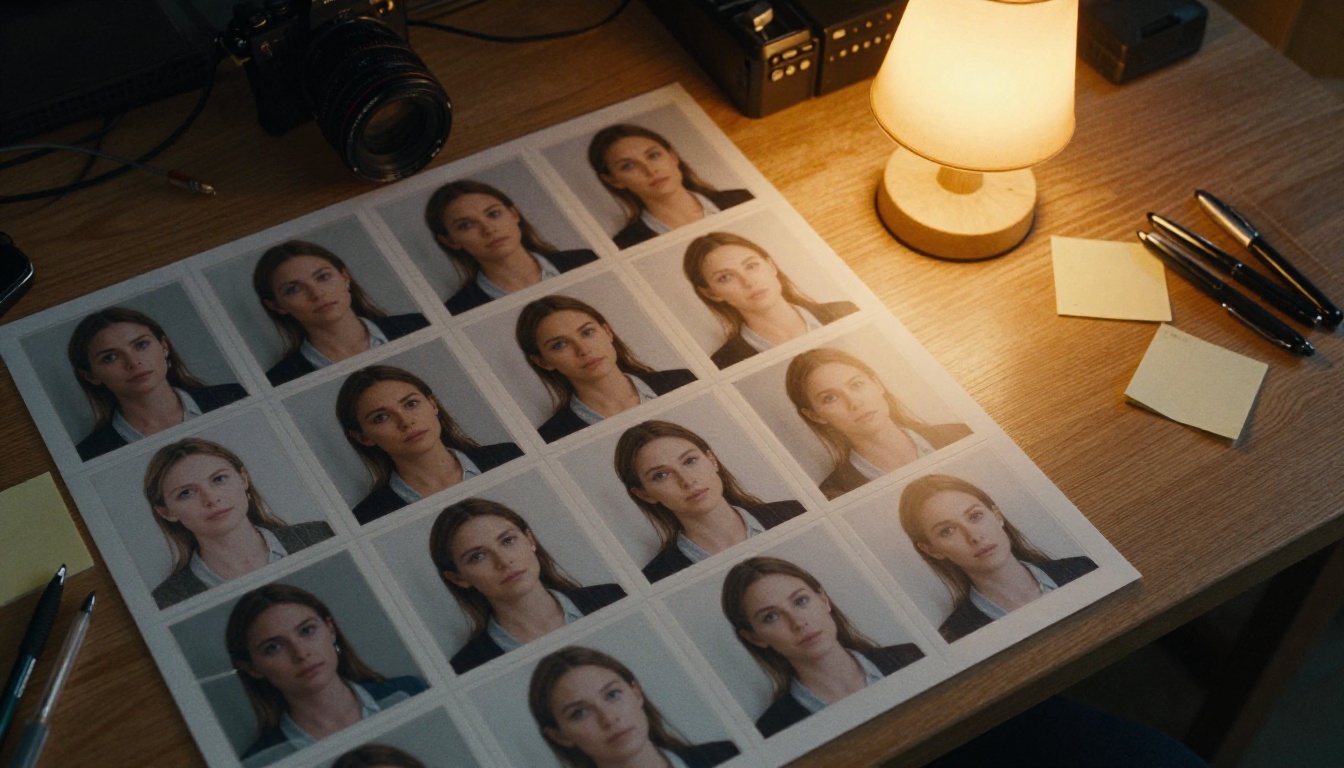
A tecnologia por trás do travamento de personagem
Os modelos modernos de vídeo com IA usam várias estratégias técnicas distintas para resolver esse problema. Entender essas estratégias ajuda a explicar por que alguns modelos têm desempenho melhor do que outros em conteúdos com muitos personagens.
Condicionamento baseado em referência
A solução mais direta é dar ao modelo uma imagem de referência do personagem antes de a geração começar. Essa referência é codificada nas camadas de atenção do modelo, basicamente dizendo a cada quadro: "o rosto deve parecer com isto". Modelos de imagem para vídeo como o Wan 2.6 I2V e o Wan 2.5 I2V são construídos inteiramente em torno desse princípio. Você fornece uma imagem estática, e o modelo a anima enquanto consulta continuamente aquele rosto original.
A vantagem é grande. A desvantagem é que você fica preso à pose e à iluminação que a imagem de referência contém. Afastar-se muito da referência sobrecarrega o mecanismo de consistência.
Como o LoRA trava a identidade
O treinamento LoRA (Low-Rank Adaptation) faz o fine-tuning de um modelo base com um pequeno conjunto de imagens de uma pessoa ou personagem específico. Em vez de retreinar o modelo inteiro, o LoRA injeta um conjunto leve de parâmetros que direciona o modelo para uma identidade específica. Quando aplicado à geração de vídeo, um LoRA de personagem funciona como um sinal de identidade persistente em todos os quadros gerados.
Essa abordagem é poderosa para criar personagens fictícios originais, sem nenhuma referência do mundo real. Você treina o LoRA com arte conceitual ou renderizações iniciais e depois usa esse LoRA para gerar sequências de vídeo em que o personagem aparece estável em diferentes cenas.
Atenção temporal na difusão de vídeo
A solução arquitetônica mais profunda envolve mecanismos de atenção temporal. Em transformers de difusão de vídeo, a atenção temporal permite que cada quadro observe os quadros vizinhos durante a geração. Isso cria uma forma de memória visual de curto prazo, em que os quadros se influenciam mutuamente nos dois sentidos.
Modelos como o Kling v3 Video e o Seedance 2.0 usam arquiteturas sofisticadas de atenção temporal que propagam as características de identidade ao longo de toda a duração do clipe, e não apenas entre quadros adjacentes. O resultado é um personagem que se mantém coeso mesmo em movimentos complexos.
💡 Quanto mais longo o clipe gerado, mais difícil fica a consistência. Um clipe de 3 segundos pode manter uma consistência quase perfeita. Um clipe de 10 segundos na mesma qualidade exige um suporte arquitetônico bem maior.
Imagem para vídeo ou texto para vídeo com personagens
Essa distinção importa muito quando a consistência do personagem é o objetivo.
Começando com um rosto que você controla
A imagem para vídeo oferece o caminho mais direto para um personagem consistente. Você cria ou encontra exatamente o rosto que quer em uma imagem estática e depois o anima. O modelo fica restrito àquele rosto desde o primeiro quadro. Modelos feitos para esse fluxo de trabalho incluem o Wan 2.2 I2V Fast e o Kling v2.1.
Esse fluxo combina naturalmente com a geração de imagens de alta qualidade a partir de texto. Você usa um modelo para criar o retrato de referência perfeito do seu personagem e depois o alimenta em um modelo de imagem para vídeo para colocá-lo em movimento.
| Método | Nível de consistência | Flexibilidade | Melhor para |
|---|
| Imagem para vídeo (I2V) | Muito alto | Média | Animar um personagem específico |
| Texto para vídeo (T2V) com prompt | Baixo a médio | Alta | Cenas gerais, sem personagem fixo |
| Modelos de avatar ou guiados por rosto | Quase perfeito | Baixa | Pessoas reais ou avatares prontos |
| Vídeo com condicionamento por LoRA | Alto | Alta | Personagens fictícios originais |
Quando só o texto não basta
O texto para vídeo puro é a abordagem mais fraca para a consistência de personagens. Não importa o quanto seu prompt seja detalhado, o modelo não tem como definir exatamente qual dos milhões de rostos possíveis em seus dados de treinamento deve usar. Dois clipes com o prompt "uma jovem morena de jaqueta vermelha" quase sempre produzirão duas pessoas diferentes.
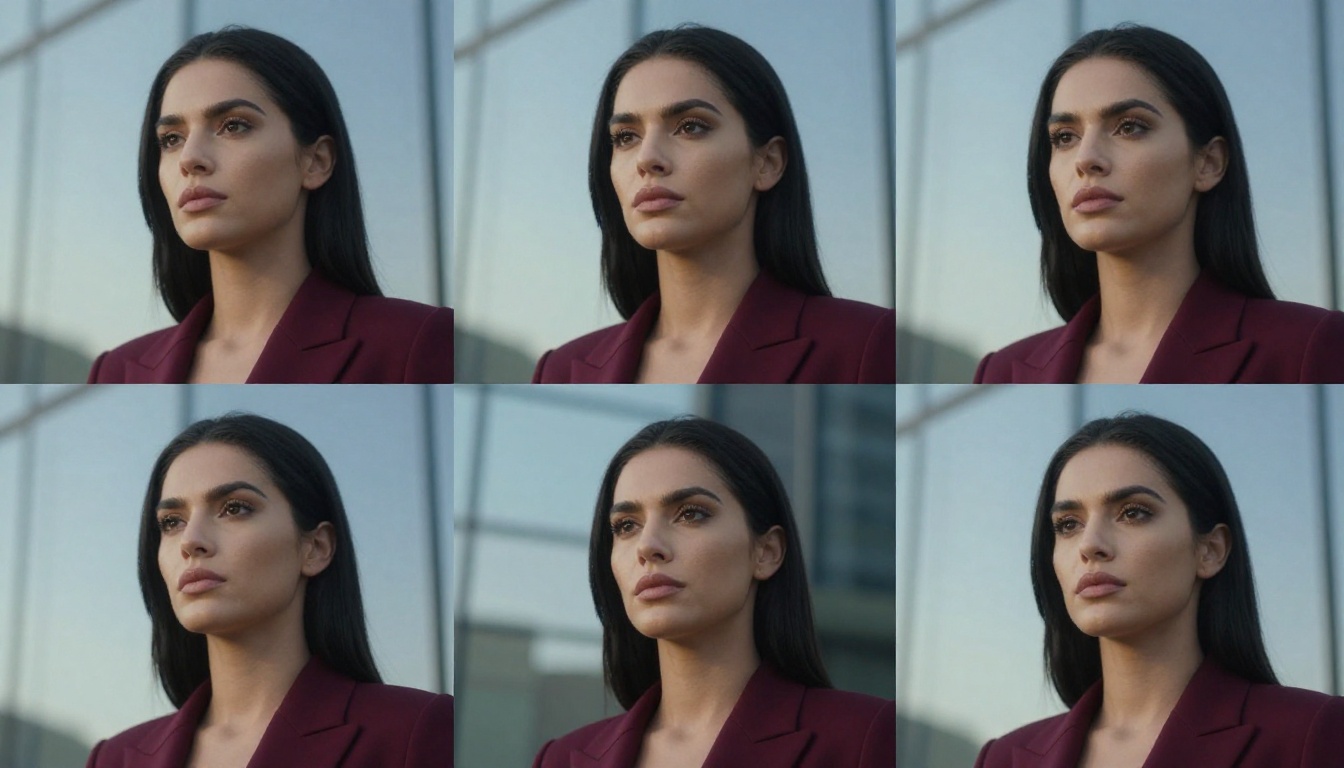
A exceção é quando os modelos foram projetados explicitamente com recursos de prompt em nível de personagem, como o Kling v3 Omni Video tenta fazer, mas mesmo assim uma imagem de referência quase sempre supera a descrição apenas em texto para manter uma identidade específica.
Modelos que realmente mantêm um personagem
Nem todo vídeo com IA é igual nesse aspecto. Aqui estão os modelos em que a consistência de personagem é realmente forte.
Kling Avatar v2
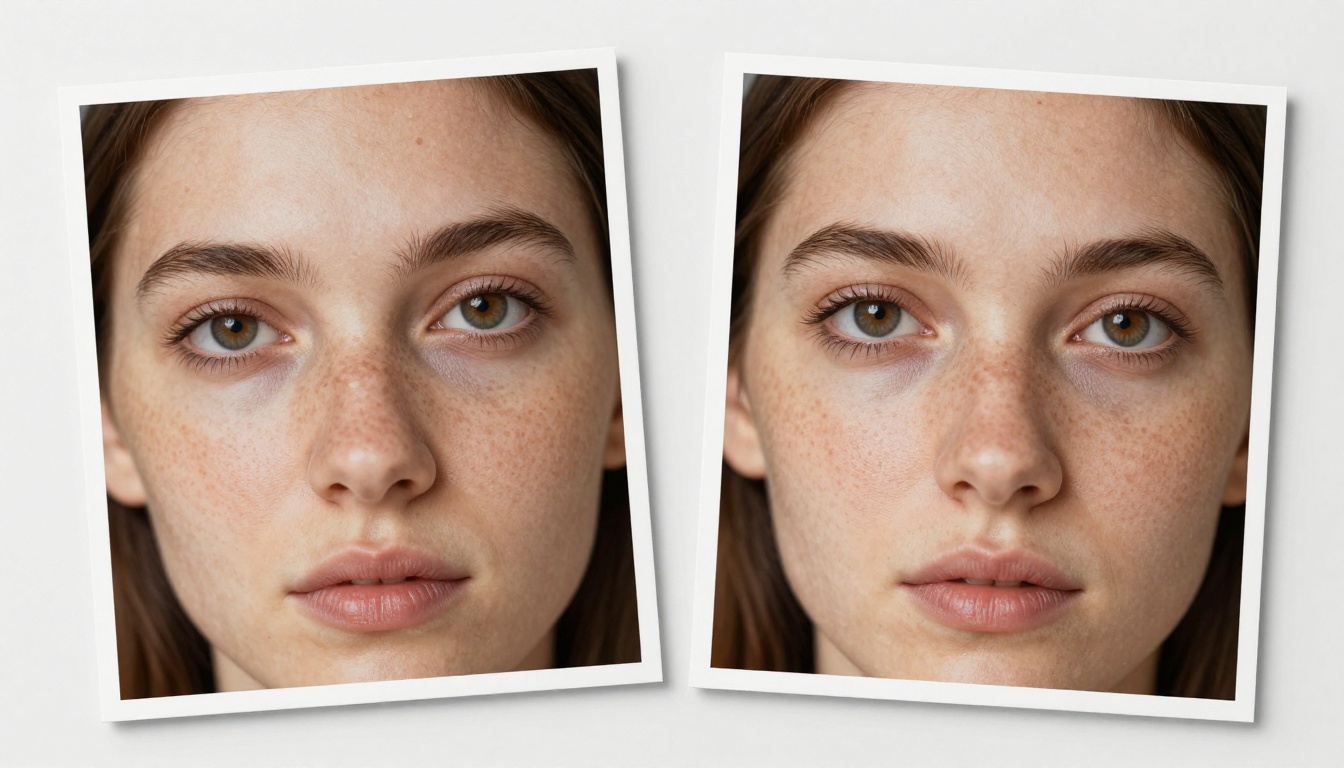
O Kling Avatar v2 foi criado especificamente para animação de vídeo guiada por rosto. Você fornece um retrato, e o modelo gera movimentos que mantêm esse rosto estável ao longo de todo o clipe. Ele lida com giros de cabeça, expressões sutis e mudanças de iluminação melhor do que a maioria dos modelos de uso geral.
O principal recurso arquitetônico é o condicionamento com travamento de rosto, em que o embedding de identidade do retrato de entrada é mantido com peso alto durante todo o processo de geração. Isso é diferente dos modelos gerais de I2V, que tratam a imagem de entrada como uma âncora de cena completa, em vez de isolar o rosto como a principal restrição.
Dreamactor M2.0 para controle de pose
O Dreamactor M2.0, da ByteDance, adota uma abordagem diferente. Ele separa a aparência (como o personagem é) do movimento (como ele se move). Você fornece uma imagem de referência para a aparência e uma sequência de movimento ou um esqueleto de pose para a movimentação. Essa separação é poderosa porque permite reutilizar o mesmo personagem em sequências de movimento completamente diferentes, sem precisar gerá-lo de novo.
Este é o modelo que você escolhe quando precisa que um personagem ande, gesticule ou dance parecendo exatamente com a sua referência. O rosto se mantém porque a camada de controle de movimento nunca toca na codificação da identidade.
Wan I2V e a série Animate
A família de modelos Wan oferece várias variantes de I2V adequadas para trabalhos com personagens. O Wan 2.6 I2V produz animações de alta qualidade a partir de retratos. Mas ainda mais interessantes para narrativas centradas em personagens são o Wan 2.2 Animate Replace e o Wan 2.2 Animate Animation, que permitem copiar padrões de movimento para o seu personagem ou substituir personagens em sequências de vídeo existentes.
💡 Para projetos com várias cenas, a série Wan Animate permite reutilizar uma única referência de personagem em muitos cenários diferentes, mantendo a identidade visual consistente mesmo quando o cenário muda por completo.
Kling v2.6 e v3 para qualidade cinematográfica
O Kling v2.6 e o Kling v3 Video representam o estado da arte em qualidade de vídeo cinematográfico, com forte consistência de personagens. Esses modelos lidam com movimentos complexos, clipes mais longos e cenários de iluminação difíceis, mantendo os rostos estáveis.
O Kling v3 Motion Control acrescenta uma camada extra: especificação precisa de movimento de câmera e de personagem, então você não apenas mantém o personagem consistente, mas também controla como a cena se move ao redor dele.
Veo 3, Gen 4.5 e Hailuo 2.3
O Veo 3, do Google, alcança forte consistência dentro do clipe graças ao seu treinamento em larga escala e à arquitetura de coerência temporal. O Gen 4.5, da Runway, enfatiza movimento cinematográfico com sujeitos razoavelmente estáveis. O Hailuo 2.3, da Minimax, lida bem com animações centradas em retratos, com estabilidade facial particularmente boa em resolução 1080p.
| Modelo | Tipo de personagem | Consistência | Melhor caso de uso |
|---|
| Kling Avatar v2 | Ancorado no rosto | ★★★★★ | Cabeças falantes, animação de retratos |
| Dreamactor M2.0 | Aparência + movimento | ★★★★★ | Animação de personagem de corpo inteiro |
| Wan 2.6 I2V | Baseado em imagem | ★★★★☆ | Animação geral de personagens |
| Kling v3 Video | Texto ou imagem | ★★★★☆ | Cenas cinematográficas |
| Veo 3 | Baseado em texto | ★★★☆☆ | Consistência em um único clipe |
| Gen 4.5 | Baseado em texto | ★★★☆☆ | Sequências de movimento cinematográfico |
Como usar o Kling Avatar v2 no PicassoIA
O Kling Avatar v2 é uma das ferramentas mais acessíveis para vídeo com consistência de personagem no PicassoIA. Veja como usá-lo para obter os melhores resultados.
Passo 1: prepare seu retrato de referência
Sua imagem de referência é tudo. Use um retrato claro, de frente ou levemente em três quartos, com:
- Iluminação uniforme e neutra, sem sombras fortes sobre o rosto
- Alta resolução (pelo menos 512 px no lado menor)
- Um fundo liso ou levemente desfocado
- O rosto ocupando pelo menos 40% do quadro
Se você não tiver uma foto real para usar, gere uma primeiro com qualquer modelo de texto para imagem no PicassoIA. Quanto maior a qualidade da sua referência, mais estável será o personagem gerado.
Passo 2: escreva um prompt de movimento
Seu prompt deve descrever o que o personagem faz, não quem ele é. O Kling Avatar v2 já sabe quem ele é pela imagem de referência. Concentre-se em:
- Tipo de movimento: "vira a cabeça lentamente para a esquerda", "sorri com carinho", "fala para a câmera"
- Iluminação do ambiente, se for relevante: "luz suave de dia dentro de casa", "luz de vela ao entardecer"
- Comportamento da câmera: "câmera parada", "aproximação suave"
Prompt ruim: "Uma mulher morena linda, de olhos castanhos, com uma blusa creme"
Prompt bom: "Vira lentamente a cabeça em direção à câmera com um sorriso suave, luz suave da tarde vinda da janela à esquerda"
Passo 3: defina duração e resolução
Para trabalhos com personagens, clipes mais curtos, de 3 a 5 segundos, tendem a produzir maior consistência do que clipes mais longos. Se você precisar de 10 segundos ou mais do mesmo personagem, gere vários clipes de 5 segundos e edite-os juntos depois.
Selecione a resolução 1080p para a saída final ou 720p para iterações mais rápidas durante os testes.
Passo 4: verifique o rosto
Antes de usar o clipe em um projeto, verifique:
Se algum desses pontos oscilar, reduza a intensidade do movimento no seu prompt ou experimente uma imagem de referência ligeiramente diferente, com iluminação mais limpa.
O que ainda dá errado
Mesmo com os melhores modelos e fluxos de trabalho, a consistência de personagens em vídeo com IA não é um problema totalmente resolvido. Estes são os padrões de falha para os quais você deve se preparar.
Mudanças de iluminação quebram rostos
A causa mais comum de falha de consistência no meio do clipe é uma mudança dramática de iluminação. Quando o modelo simula uma fonte de luz se movendo, ou faz a transição de um ambiente interno para um externo, o rosto precisa ser reconstruído sob novas condições de luz. É nessa reconstrução que os traços de identidade podem se deslocar.
Correção: mantenha as condições de iluminação estáveis no seu prompt. Se precisar de uma transição de iluminação, crie dois clipes separados com iluminações diferentes e faça o corte entre eles, em vez de tentar gerar a transição dentro de um único clipe.
Vários cortes, o mesmo personagem
Gerar seu personagem na cena A e na cena B como clipes separados quase sempre produz duas versões ligeiramente diferentes da mesma pessoa. Este é o maior desafio ainda não resolvido na produção de vídeo com IA. Os modelos não compartilham estado entre execuções de geração separadas.
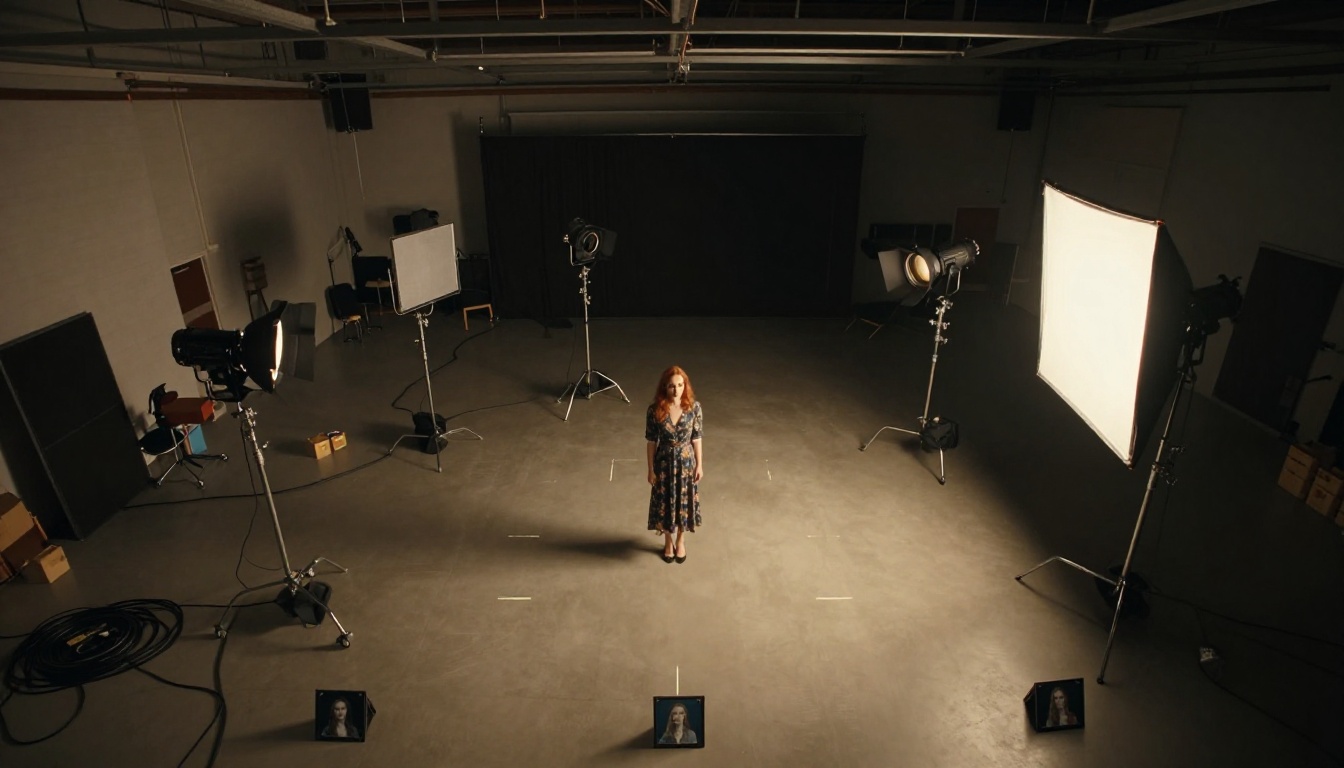
Correção: crie uma folha de referência rigorosamente controlada, com vários ângulos do seu personagem (frontal, perfil esquerdo, perfil direito, ângulo levemente de baixo para cima), todos fotografados sob a mesma iluminação. Use a mesma imagem de referência em todas as gerações e mantenha seus prompts coerentes em estilo.
💡 Alguns criadores mantêm uma "bíblia do personagem", uma pequena pasta com imagens de referência de um mesmo ensaio fotográfico padronizado, que eles alimentam em todas as gerações para manter a identidade entre clipes.
Acessórios e detalhes se desviam
Brincos desaparecem. Colares mudam de formato. Tatuagens desbotam ou se multiplicam. Os pequenos detalhes são os primeiros a se perder em vídeos com IA, porque exigem que o modelo mantenha informações de alta frequência durante o movimento. Manter os acessórios mínimos na imagem de referência melhora diretamente a consistência geral.
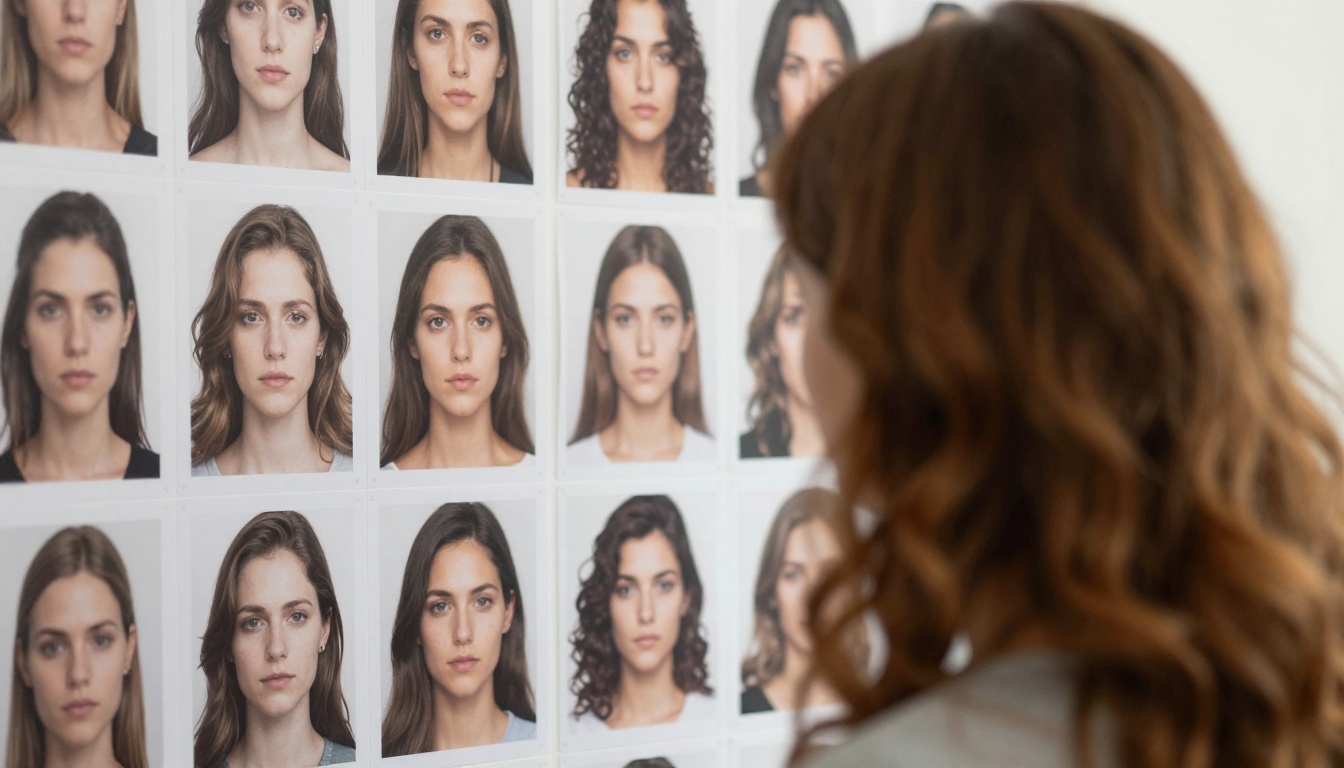
A consistência de personagens não é mais uma barreira reservada a estúdios com orçamentos enormes e meses de trabalho em VFX. As ferramentas disponíveis hoje, do Kling Avatar v2 ao Dreamactor M2.0 até toda a família Wan I2V, tornam possível criar conteúdo de vídeo com várias cenas e um personagem visualmente consistente em uma única tarde.
O fluxo de trabalho é simples: comece com um retrato de referência forte, escolha o modelo de I2V ou de avatar certo para o seu caso, mantenha seus prompts focados no movimento e não na aparência, e gere clipes curtos que você monta na pós-produção. Cada um desses modelos está disponível diretamente no PicassoIA, sem precisar de hardware local nem de configuração complexa.
Escolha seu personagem. Dê a ele um rosto. Coloque-o em movimento.
Experimente o Kling Avatar v2, o Dreamactor M2.0 ou o Wan 2.6 I2V no PicassoIA hoje e veja o quanto os personagens de IA consistentes evoluíram.


