كلما رفعت صورة وقام تطبيق فورًا بتسمية الأشياء الموجودة فيها، فقد حدث شيء مدهش دون أن يلاحظه أحد. آلة لا عيون لها ولا جهاز عصبي ولا خبرة حياتية نظرت إلى شبكة من الأرقام الملوّنة واستخرجت منها معنى. هذه العملية ليست سحرًا. إنها مجموعة محددة من العمليات الرياضية القابلة للتعلم، وقد أمضى الباحثون عقودًا في صقلها. فهم كيف يعرف الذكاء الاصطناعي شكل الأشياء يكشف أمرًا مفاجئًا: الرؤية تتعلق بالإحصاء أكثر بكثير مما تتعلق بالإدراك.
ماذا يعني "الرؤية" فعلًا بالنسبة للآلة
البكسلات مجرد أرقام
بالنسبة للحاسوب، الصورة ليست أكثر من شبكة مستطيلة من الأرقام. كل بكسل يحمل ثلاث قيم تمثل شدة اللون الأحمر والأخضر والأزرق على مقياس من 0 إلى 255. صورة فوتوغرافية بدقة 1920x1080 تحتوي على أكثر من ستة ملايين من هذه القيم. لا يوجد في أي منها مفهوم "قطة" أو "كرسي". يجب بناء المعنى من الصفر، طبقة تلو أخرى.
هذا هو التحدي الأساسي في الرؤية الحاسوبية: أخذ بيانات رقمية خام وتحويلها إلى فهم دلالي. لفترة طويلة، حاول المهندسون كتابة قواعد صريحة. "إذا رأيت شكلًا دائريًا فوق خطين عموديين بقاعدة مسطحة، فغالبًا هذا مصباح." لم ينجح الأمر. الأشياء الواقعية تتنوع بلا حدود في الزاوية والإضاءة والحجب والسياق. القواعد كانت تنهار دائمًا.
أنماط ظاهرة لكنها لا تُلاحَظ
جاء الاختراق حين توقف الباحثون عن كتابة القواعد وبدأوا بترك الآلات تجد الأنماط بنفسها. بدلًا من تحديد شكل الكلب، تعرض على شبكة عصبية عشرة ملايين صورة لكلاب موسومة، وتتركها تكتشف أي الأنماط العددية تتنبأ بموثوقية بالتسمية "كلب".
يبدو هذا بسيطًا، لكن تنفيذه ليس كذلك. تحتاج الشبكة إلى بنية تحترم البنية المكانية للصور، وبيانات تدريب بحجم هائل، واستراتيجيات تحسين تمنعها من حفظ الأمثلة ببساطة بدلًا من التعميم على أمثلة جديدة.
كيف تتعلم الشبكات العصبية التعرف على الصور
التدريب على ملايين الأمثلة
كلمة "التدريب" في تعلم الآلة مصطلح تقني دقيق. تعني تشغيل خوارزمية تحسين، عادةً شكلًا من الانحدار التدرّجي العشوائي، تعدّل تدريجيًا ملايين قيم الأوزان الداخلية حتى تتطابق مخرجات الشبكة مع التسميات الصحيحة في مجموعة التدريب. العملية تكرارية. تُغذّي الشبكة بصورة، وتقارن تنبؤها بالإجابة الصحيحة، وتقيس الخطأ، ثم تحدّث الأوزان لتقليله. تكرر ذلك مليارات المرات.
الحجم المطلوب مذهل. تحتوي ImageNet، وهي من مجموعات البيانات التدريبية الرائدة، على أكثر من أربعة عشر مليون صورة موسومة عبر واحد وعشرين ألف فئة. نماذج الرؤية الكبيرة الحديثة تتدرب على مجموعات بيانات أكبر بعدة مراتب من حيث الحجم، تُجمع من الويب وتُعالج عبر مسارات ترشيح آلية.
ما الذي تفعله الطبقة الالتفافية فعليًا
معظم أنظمة التعرف على الصور مبنية على الشبكات العصبية الالتفافية (CNN). الطبقة الالتفافية هي ابتكارها الأساسي. بدلًا من ربط كل بكسل بكل خلية عصبية (وهو أمر مرهق حسابيًا للصور الكبيرة)، تنزلق الطبقة الالتفافية مرشحًا صغيرًا، عادةً بحجم 3x3 أو 5x5 بكسلات، عبر الصورة، وتحسب الجداء النقطي عند كل موضع.
💡 فكّر في الأمر بهذه الطريقة: مرشح 3x3 ينشط عندما يرى حافة أفقية سيعطي استجابة قوية أينما ظهرت حواف أفقية في الصورة، واستجابة ضعيفة في أي مكان آخر. إذا كدّست مئات من هذه المرشحات، تحصل على خريطة غنية توضح أين يظهر كل نوع من الحواف والتدرجات والملمس.
الطبقات الأولى تكتشف أشياء بسيطة: حواف بتوجهات مختلفة، وتدرجات لونية، وأنسجة صغيرة متكررة. الطبقات الأعمق تجمع هذه الاكتشافات في تمثيلات أكثر تجريدًا. وبحلول الطبقات الأخيرة، تستجيب خلايا عصبية فردية لأنماط معقدة مثل "فرو مرقّط" أو "الشكل العام للأذن".
من الميزات منخفضة المستوى إلى الأشياء الكاملة
هذا الاستخلاص الهرمي للميزات هو سبب قدرة الشبكات العميقة على التعميم بهذه الجودة. التمثيل المتعلَّم في الطبقات الوسطى ليس خاصًا بمهمة واحدة. يمكن إعادة استخدام خرائط الميزات الخاصة بملمس الفرو و"شكل العين" لتصنيف السلالات، أو تحديد الأنواع، أو حتى توليد صور جديدة لحيوانات. هذا هو أساس نقل التعلّم، واحدة من أكثر الأفكار فائدة عمليًا في الذكاء الاصطناعي الحديث.
دور بيانات التدريب
لماذا يغيّر الحجم كل شيء
قبل نحو عام 2012، كانت معظم أدوات تصنيف الصور قادرة على التعامل مع عشرات الفئات بدقة متواضعة. عندما فاز AlexNet بمسابقة ImageNet في ذلك العام باستخدام شبكة CNN عميقة مدرّبة على وحدات GPU، انخفض معدل الخطأ في أفضل 5 توقعات بأكثر من عشر نقاط مئوية مقارنة بأقرب منافس. البنية كانت مهمة، لكن كذلك حجم أمثلة التدريب الهائل.
| المرحلة | حجم البيانات | متوسط خطأ Top-5 |
|---|
| ما قبل التعلم العميق (2010) | ~1 مليون صورة موسومة | ~28% |
| عصر CNN المبكر (2012) | 1.2 مليون (ImageNet) | ~17% |
| نماذج الرؤية الحديثة (2024+) | مليارات الصور | ~1-2% |
الحجم يُجبر الشبكة على مواجهة حالات نادرة وزوايا غير مألوفة وخلفيات متنوعة وأقصى درجات الإضاءة. نموذج مدرّب فقط على صور استوديو لقطط سيفشل أمام قطة تُرى من نافذة سيارة في المطر. الحجم ليس مجرد ميزة مريحة؛ إنه الآلية التي تنتج المتانة.
عندما يُفسد التحيّز النموذج
لبيانات التدريب نقطة ضعف عميقة: إنها تعكس من جمعها. إذا كانت مجموعة بيانات للتعرف على الوجوه تتكون في معظمها من وجوه فاتحة البشرة صُوّرت داخل المباني، فسيؤدي النموذج أداءً ضعيفًا مع درجات البشرة الداكنة وفي الظروف الخارجية. هذا ليس قلقًا فلسفيًا. إنه نمط فشل قابل للقياس وموثّق، وله عواقب حقيقية في أدوات التوظيف وأنظمة الأمن والتصوير الطبي.
المشكلة تتجاوز الديموغرافيا. النماذج المدرّبة على صور الويب ترث تحيزات ما يُصوَّر ويُشارَك. الكلاب تظهر أكثر من الفهود الثلجية. غرف المعيشة تظهر أكثر من ورش الحدادة. الإحساس الداخلي للنموذج بـ"شكل الأشياء" يتشكّل بالكامل بتوزيع مجموعة تدريبه.
كشف الأجسام مقابل تصنيف الصور
تسمية الشيء مقابل إيجاده
تصنيف الصور يجيب عن سؤال واحد: ما الموضوع المهيمن في هذه الصورة؟ المخرج تسمية فئة، غالبًا مع درجة ثقة. كشف الأجسام أصعب. يجيب: أين توجد كل الأجسام في هذه الصورة، وما هو كل منها؟
يتطلب الكشف أن يُخرج النموذج مربعات إحاطة إلى جانب التسميات. الكواشف الحديثة مثل YOLO (You Only Look Once) تنجز ذلك في تمريرة أمامية واحدة عبر الشبكة، ولهذا يمكنها العمل في الوقت الفعلي على تدفقات الفيديو.
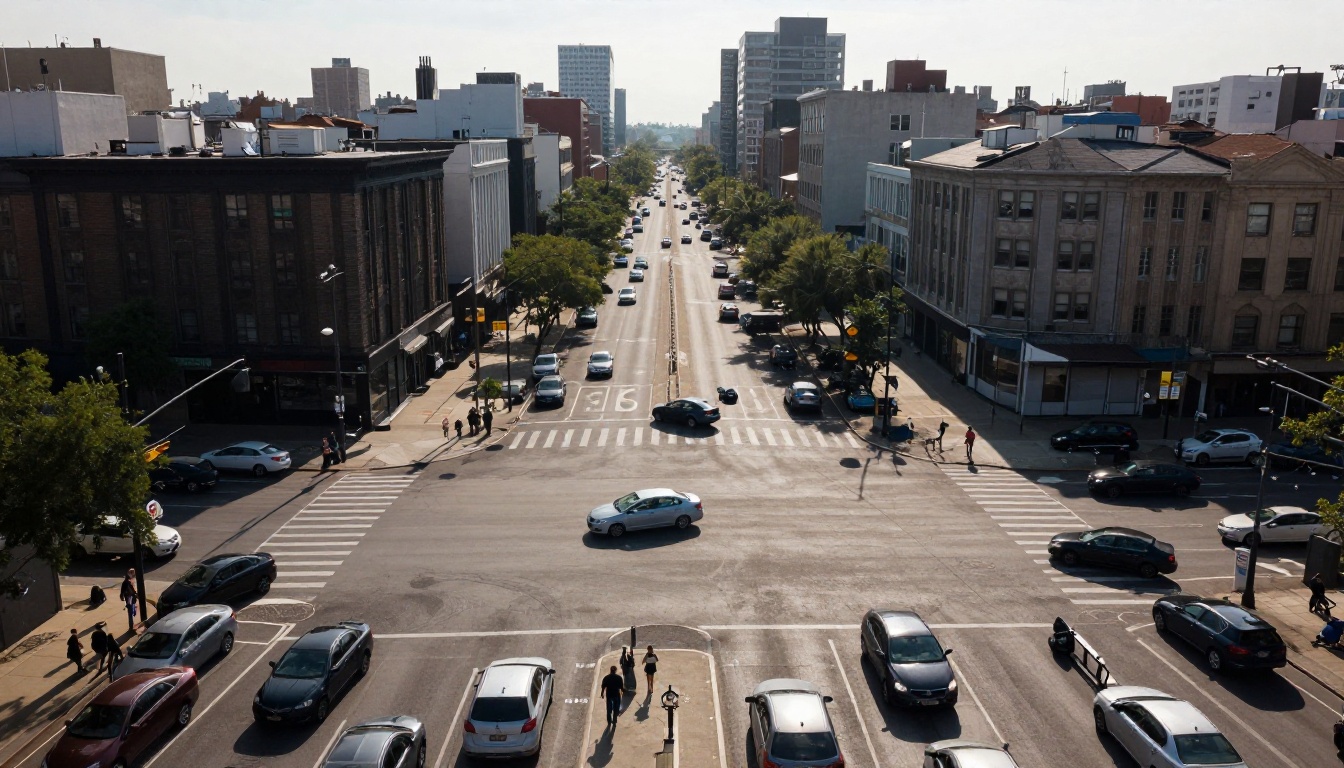
مشهد المدينة الجوي أعلاه يوضح التحدي. كل مشاة ومركبة وخط عبور سيحتاج نظام الكشف إلى تحديد موقعه وتسميته بشكل فردي، رغم الصور الظلية المتداخلة، واختلاف الأحجام، والظلال التي تحجب أجزاء من كل عنصر.
التعرف في الوقت الفعلي خارج المختبر
نشر أنظمة التعرف في العالم الحقيقي يضيف قيودًا تتجاهلها اختبارات المختبر. يجب أن يكون زمن الاستجابة منخفضًا بما يكفي للتطبيق: السيارة ذاتية القيادة تحتاج قرارات خلال أجزاء من الثانية. يجب أن تتسع الذاكرة لميزانية العتاد في الجهاز المستهدف. ويجب أن تظل الدقة ثابتة مع تغيّر الطقس والإضاءة غير المعتادة وتلف الكاميرا.
لهذا يتجه المجال نحو بنيات خفيفة مصممة للنشر على الأجهزة الطرفية، ولهذا أصبحت النماذج مكمَّمة بشكل متزايد، أي تُضغط قيم الأوزان من أعداد عشرية ذات 32 بت إلى أعداد صحيحة ذات 8 بت، لتقليل استهلاك الذاكرة وتسريع تشغيل النموذج دون خسارة كارثية في الدقة.
كيف تطبّق مولدات الصور بالذكاء الاصطناعي المعرفة البصرية
الرؤية بالعكس
يصبح فهم كيف يعرف الذكاء الاصطناعي شكل الأشياء مثيرًا للاهتمام بشكل خاص عند تطبيقه على النماذج التوليدية. نظام تحويل النص إلى صورة لا يكتفي بالتعرف على الأشياء؛ بل يعيد بناءها انطلاقًا من وصف. ولكي يفعل ذلك بإقناع، يجب أن يكون قد استوعب نموذجًا إحصائيًا عميقًا لشكل كل شيء، وكل سطح، وكل ظرف إضاءة، وكل تكوين فوتوغرافي.
لهذا تنتج النماذج المدرّبة على مجموعات بيانات أكبر وأكثر تنوعًا مخرجات أكثر واقعية كالصور الفوتوغرافية. تمثيلها الداخلي لمفهوم "شكل الأشياء" أغنى، لذلك تكون إعادة بنائها أدق عبر الموضوعات غير المعتادة وظروف الإضاءة المختلفة.
لماذا يُتقن Flux Pro الوجوه
خذ Flux Pro مثالًا ملموسًا. أداؤه القوي في الوجوه البشرية يعود جزئيًا إلى توزيع بيانات تدريبه. الوجوه من أكثر الموضوعات تصويرًا على الويب، مع تنوع هائل في الإضاءة والزاوية والتعبير ودرجة البشرة. رأى النموذج تنوعًا كافيًا ليبني نموذجًا إحصائيًا مفصلًا لهندسة الوجه وملمس البشرة وكيفية تفاعل الضوء مع البنى الوجهية المختلفة.
قارنه مع Stable Diffusion، وهو خط أساس أقدم ببيانات تدريب أصغر وبنية أقل تعبيرية. الوجوه تبدو أنعم بشكل ملحوظ، وغالبًا ما تفشل الأصابع في الإصدارات الأولى، لأن النموذج يملك تمثيلًا داخليًا أضعف لتشريح اليد والتفاصيل الدقيقة.
Flux 1.1 Pro Ultra يذهب أبعد، مُنتجًا مخرجات بدقة 4 ميجابكسل يصبح فيها ملمس المسام الفردية على الجلد معقولًا. هو لا يضيف تفاصيل عشوائيًا؛ بل يأخذ عينات من توزيعه المتعلَّم لشكل الجلد الفوتوغرافي بدقة عالية جدًا.
نماذج تستحق التجربة اليوم
عدة نماذج على المنصة تُظهر أوجهًا مختلفة من المعرفة البصرية للذكاء الاصطناعي:
| النموذج | نقطة القوة | الأفضل في |
|---|
| Flux Dev | الالتزام بالأمر النصي، التكوين | المشاهد المعقدة متعددة الأشياء |
| Flux Schnell | السرعة، توليد بأربع خطوات | التكرار السريع |
| Imagen 4 | الإضاءة الطبيعية، تفاصيل غنية | البورتريهات الواقعية كالصور الفوتوغرافية |
| SDXL | مرونة الأسلوب | التكوينات الفنية |
| Ideogram v3 Quality | تصيير النصوص، الواقعية | الصور التي تحتوي كلمات مقروءة |
| Recraft v4 | دقة جاهزة للطباعة | التصميم وأصول العلامة التجارية |
التعرف على الوجوه والأجسام
لماذا تكون الوجوه صعبة بشكل فريد
الوجوه هي في الوقت نفسه أكثر فئات الأجسام دراسةً في الرؤية الحاسوبية، وإحدى أكثرها تطلبًا تقنيًا. كل وجه بشري يشترك في البنية الأساسية نفسها (عينان فوق أنف فوق فم)، مما يعني أن الفروق الصغيرة تحمل معلومات هائلة. التعرف على شخص بعينه يتطلب من النموذج أن يكون حساسًا للفروق الدقيقة بين الأفراد، مع بقائه متينًا أمام التغيرات الكبيرة داخل الفرد الواحد (الشخص نفسه في أعمار مختلفة، وبتعابير مختلفة، وتحت إضاءة مختلفة).
الهندسة مهمة أيضًا. الوجه المرئي من زاوية 45 درجة يبدو مختلفًا تمامًا عن الوجه نفسه عند النظر إليه مباشرة. أنظمة التعرف المبكرة كانت تحتاج إلى منظور أمامي تقريبًا. الأنظمة الحديثة تتعامل مع أي وضعية بأن تقدّر أولًا نموذجًا ثلاثي الأبعاد للوجه من الصورة ثنائية الأبعاد، وهي عملية تعتمد بدورها على افتراضات مسبقة متعلَّمة عن هندسة الوجه اكتُسبت أثناء التدريب.
الوضعية والعمق والوعي المكاني
إلى جانب الوجوه، يتطلب فهم وضعية الجسم تحديد مواقع المفاصل (الكتفين والمرفقين والمعصمين والوركين والركبتين والكاحلين) واستنتاج تشكيلها ثلاثي الأبعاد من صورة ثنائية الأبعاد. هذا غامض جوهريًا من نقطة مشاهدة واحدة: الذراع المرفوعة والذراع المختصرة بفعل المنظور يمكن أن تبدوا متطابقتين من زوايا معينة. النماذج تحل هذا الغموض باستخدام افتراضات إحصائية متعلمة من آلاف أجساد البشر المسجلة بالتقاط الحركة.
تقدير العمق من صورة واحدة يعمل بالطريقة نفسها تقريبًا. لا توجد إشارات ستيريو ولا انزياح حركي. النموذج يستخدم اختصارات متعلمة: الأشياء الأعلى في الإطار تميل لأن تكون أبعد، والأشياء ذات الحجم المعروف مثل الأبواب والأشخاص تقدم معلومات ضمنية عن المقياس، والضباب الجوي يزداد مع المسافة. لا شيء من هذه الإشارات مبرمج يدويًا؛ بل تُستخلص من توزيع بيانات التدريب.
3 أماكن ما زال فيها الذكاء البصري يفشل
فخ الملمس
من أوائل حالات الفشل الموثقة: الملمسات العدائية. أظهر الباحثون أنه بطباعة نمط محدد على جسم ثلاثي الأبعاد يمكن جعل الشبكة العصبية تصنفه خطأً بثقة. سلحفاة مغطاة بالملمس المناسب صُنّفت كبندقية. النموذج كان يعتمد بشدة على إحصاءات الملمس بدلًا من الشكل، مما يكشف هشاشة لا تشاركها الرؤية البشرية.
عمليًا، يظهر هذا عندما يخطئ نموذج مدرّب أساسًا على الصور الفوتوغرافية في تصنيف المواد في اللوحات أو الأسطح الطبيعية غير المعتادة. جدار إسمنتي خشن مصوّر بزاوية ضيقة قد يُسمّى بثقة "لحاء شجر" لأن إحصاءات الملمس منخفضة المستوى تتطابق.
المدخلات خارج التوزيع
الشبكات العصبية مستكملات واثقة داخل توزيع تدريبها، ومستقرئات غير موثوقة خارجه. نموذج لم يرَ من قبل نوعًا معينًا من المعدات الصناعية سيظل يُنتج تسمية واثقة، عادةً شيئًا مشابهًا بصريًا من داخل مجموعة تدريبه. لا توجد آلية مدمجة للتعبير عن عدم اليقين في المصنّف القياسي.
💡 لهذا تهم المعايرة. الأنظمة الجيدة التنفيذ تقرن مخرج التصنيف بدرجة ثقة مُعايَرة، وتحوّل التنبؤات منخفضة الثقة إلى مراجعة بشرية بدلًا من التصرف بناءً عليها تلقائيًا.
كيف تتعلم النماذج التعافي
استجابة المجال لأنماط الفشل هذه هي في الغالب مزيد من البيانات وبيانات أكثر تنوعًا. زيادة البيانات (قلب الصور وقصها وتغيير ألوانها وإضافة ضوضاء عشوائيًا إلى صور التدريب) تجبر النموذج على تعلم ميزات تبقى مستقرة عبر التحويلات. Mixup وCutMix يمزجان صورتين تدريبيتين ويدرّبان الشبكة على التسمية الممزوجة، مما يُنعّم حدود القرار.
الأساليب الأحدث تستخدم التدريب المسبق ذاتي الإشراف، حيث يتعلم النموذج من صور غير موسومة عبر حل مهام بديلة، مثل التنبؤ بالمناطق المقنّعة. التمثيلات الناتجة أكثر متانة لأنها يجب أن تأخذ في الحسبان التوزيع الكامل لمحتوى الصورة، لا مجرد الميزات المرتبطة بالتصنيف.
جرّب إنشاء مخرجات الذكاء البصري الخاصة بك
الآن بعد أن فهمت ما يحدث فعلًا عندما يعالج الذكاء الاصطناعي مشهدًا بصريًا، يمكنك التفاعل مع مولدات الصور بقصدية أكبر. مخرجات النموذج ليست عشوائية؛ إنها تأخذ عينات من توزيع متعلَّم لشكل الأشياء. أمرك النصي مجموعة من القيود تضيّق ذلك التوزيع نحو الصورة التي في ذهنك.
وصف اتجاه الإضاءة ("ضوء خلفي دافئ من الصباح الذهبي من اليسار")، وخصائص العدسة ("85mm f/1.8 مع عمق ميدان ضحل")، والأسطح والملمس ("مسام طبيعية مرئية، وخصلات الشعر الفردية حادة") كلها تنشّط مناطق محددة من التمثيل البصري المتعلَّم للنموذج. كلما وصفت بدقة كيف تبدو الأشياء فيزيائيًا، استطاع النموذج الاستفادة من أكثر أجزاء توزيعه التدريبي كثافة وتفصيلًا.
Flux Dev و Flux Pro يستجيبان جيدًا للأوامر النصية المستندة إلى الواقع الفيزيائي. Imagen 4 قوي بشكل خاص في ظروف الإضاءة الطبيعية. للبورتريهات، Flux 1.1 Pro Ultra يُنتج أعلى جودة لملمس البشرة والشعر، مستفيدًا من نموذجه الداخلي الأغنى لمظهر الإنسان.
أفضل طريقة لبناء الحدس هي تشغيل الأمر النصي نفسه عبر عدة نماذج ومقارنة أين يضع كل نموذج تركيزه. الاختلافات تكشف شيئًا حقيقيًا عما "يعرفه" كل نموذج من بيانات تدريبه. توجّه إلى Picasso IA، واختر نموذجًا من مجموعة تحويل النص إلى صورة، وابدأ التجربة بأوامر نصية وصفية فيزيائيًا. ما تراه في المخرجات هو انعكاس مباشر لما تعلّمه النموذج عن العالم البصري.


